Barındırılan testlerde saniyede 280 token görmek mümkün; ancak ilk dizüstü bilgisayar denemelerinde donanım ve çalışma zamanına bağlı olarak 8 ila 220 tok/s arası sonuçlar alınıyor. Inkling 2 Mini, çevrimdışı kodlama ajanları için güçlü bir seçenek: yaklaşık 20 GB boyutunda, açık ağırlıklı ve 26,4 milyar parametreli bir model. Yine de indirmeden önce sohbet, olgusal doğruluk ve API tarafındaki eksiklerini bilmek gerekiyor.
Inkling 2 Mini kimlere yarar, kimler uzak durmalı?
Inkling 2 Mini belirli bir işte çok başarılı, ancak birkaç kullanım alanında beklentiyi karşılamıyor. Bu yüzden kararınızı benchmark tablosundan önce iş yükünüz belirlemeli. Araçlar ve aramayla çalışan çevrimdışı kodlama asistanları modelin güçlü olduğu alan; yoğun sohbet veya yalnızca API kullanımı ise değil.
| İş yükünüz | Mini için karar |
|---|---|
| 32 GB veya daha fazla belleğe sahip Mac ya da DGX Spark üzerinde çevrimdışı kodlama ajanı | Güçlü uyum: En iyi raporlanan sonuçlar burada |
| Özel ve uzun bağlamlı işler (kâğıt üzerinde 1 milyon tokene kadar) | Denemeye değer: Pratikte 32K bağlamla başlayın |
| Çok turlu sohbet veya katı talimat takibi | Geçin: Qwen3.8-27B bu alanda daha iyi ölçülüyor |
| Bugün barındırılan API kullanımı | Geçin: Henüz sunucusuz listeleme yok; yalnızca örnekleme ve ince ayar ücretleri açıklanmış durumda |
İncelemenin devamı bu ayrımın arkasındaki sayıları açıyor: döngü yapısı neyi değiştiriyor, hangi benchmark’lar gerçekten anlamlı, yerel kullanımda hız pratikte nasıl görünüyor ve ödenen ücret karşılığında ne alıyorsunuz?
Inkling 2 Mini nedir, döngü yapısı nasıl çalışır?
Thinking Machines Lab, Inkling 2 Mini’yi 20 Kasım 2026’da Apache 2.0 lisansı altında açık ağırlıklı bir model olarak yayımladı. Ağırlıklar Hugging Face üzerinde thinkingmachines/Inkling-2-Mini adıyla bulunuyor. Model metin ve görüntü girdilerini kabul ediyor, metin çıktısı üretiyor ve en fazla 1 milyon tokenlık bağlam sunuyor.
| Özellik | Inkling 2 Mini |
|---|---|
| Çıkış tarihi | 20 Kasım 2026, Thinking Machines Lab |
| Lisans | Apache 2.0 |
| Parametreler | Toplam 26,4 milyar / token başına 3,4 milyar aktif / döngülerle 5,4 milyar etkin |
| Katmanlar | 24 kayıtlı katman; ortadaki 12 katman token başına 3 kez çalışıyor (6 + 3x12 + 6 = 48 uygulama) |
| MoE yönlendirmesi | Her katmanda token başına 128 uzmandan 8’i |
| Hassasiyet | 20 katmanda NVFP4, son 4 katmanda MXFP8; yaklaşık 20 GB checkpoint (19,5 GB + 0,64 GB tahminleyici) |
| Bağlam / modaliteler | 1 milyon tokene kadar; metin + görüntü girişi, metin çıkışı |
| Yerel kullanım hedefleri | Ollama üzerinden 32 GB ve üzeri belleğe sahip Mac veya model kartına göre bir NVIDIA DGX Spark |
3,4 milyar rakamı, modelde kayıtlı aktif parametreleri ifade ediyor. Üç döngü geçişini de hesaba kattığınızda etkin hesaplama yaklaşık 5,4 milyar parametreye çıkıyor. Ağırlıkların yeniden kullanılması dosya boyutunu küçük tutuyor, ancak token başına düşen hesaplama yükünü artırıyor; Hugging Face’in teknik anlatımı da bunu ayrıntılı biçimde açıklıyor.
Döngü yapısı hesaplama gücünü artırıyor, modelin depoladığı bilgiyi değil. Çıkış duyurusunda Mini’nin olgusal hatırlama konusunda daha büyük Inkling modellerinin gerisinde kaldığı belirtiliyor; çünkü bilgi kapasitesi çoğunlukla toplam parametre sayısıyla büyüyor. Bu nedenle arama ve araç kullanımı bu model için özellikle önemli.
Güvenilir benchmark’lar ve fazla anlam yüklenmemesi gereken sonuçlar
Aşağıdaki skorların tamamı laboratuvarın kendi test düzeneklerinden ve Hugging Face model kartından geliyor. Mini; araç kullanan kodlama ve arama testlerinde öne çıkarken akıl yürütme, görüntü ve sohbet disiplini tarafında ya başa baş kalıyor ya da geride kalıyor.
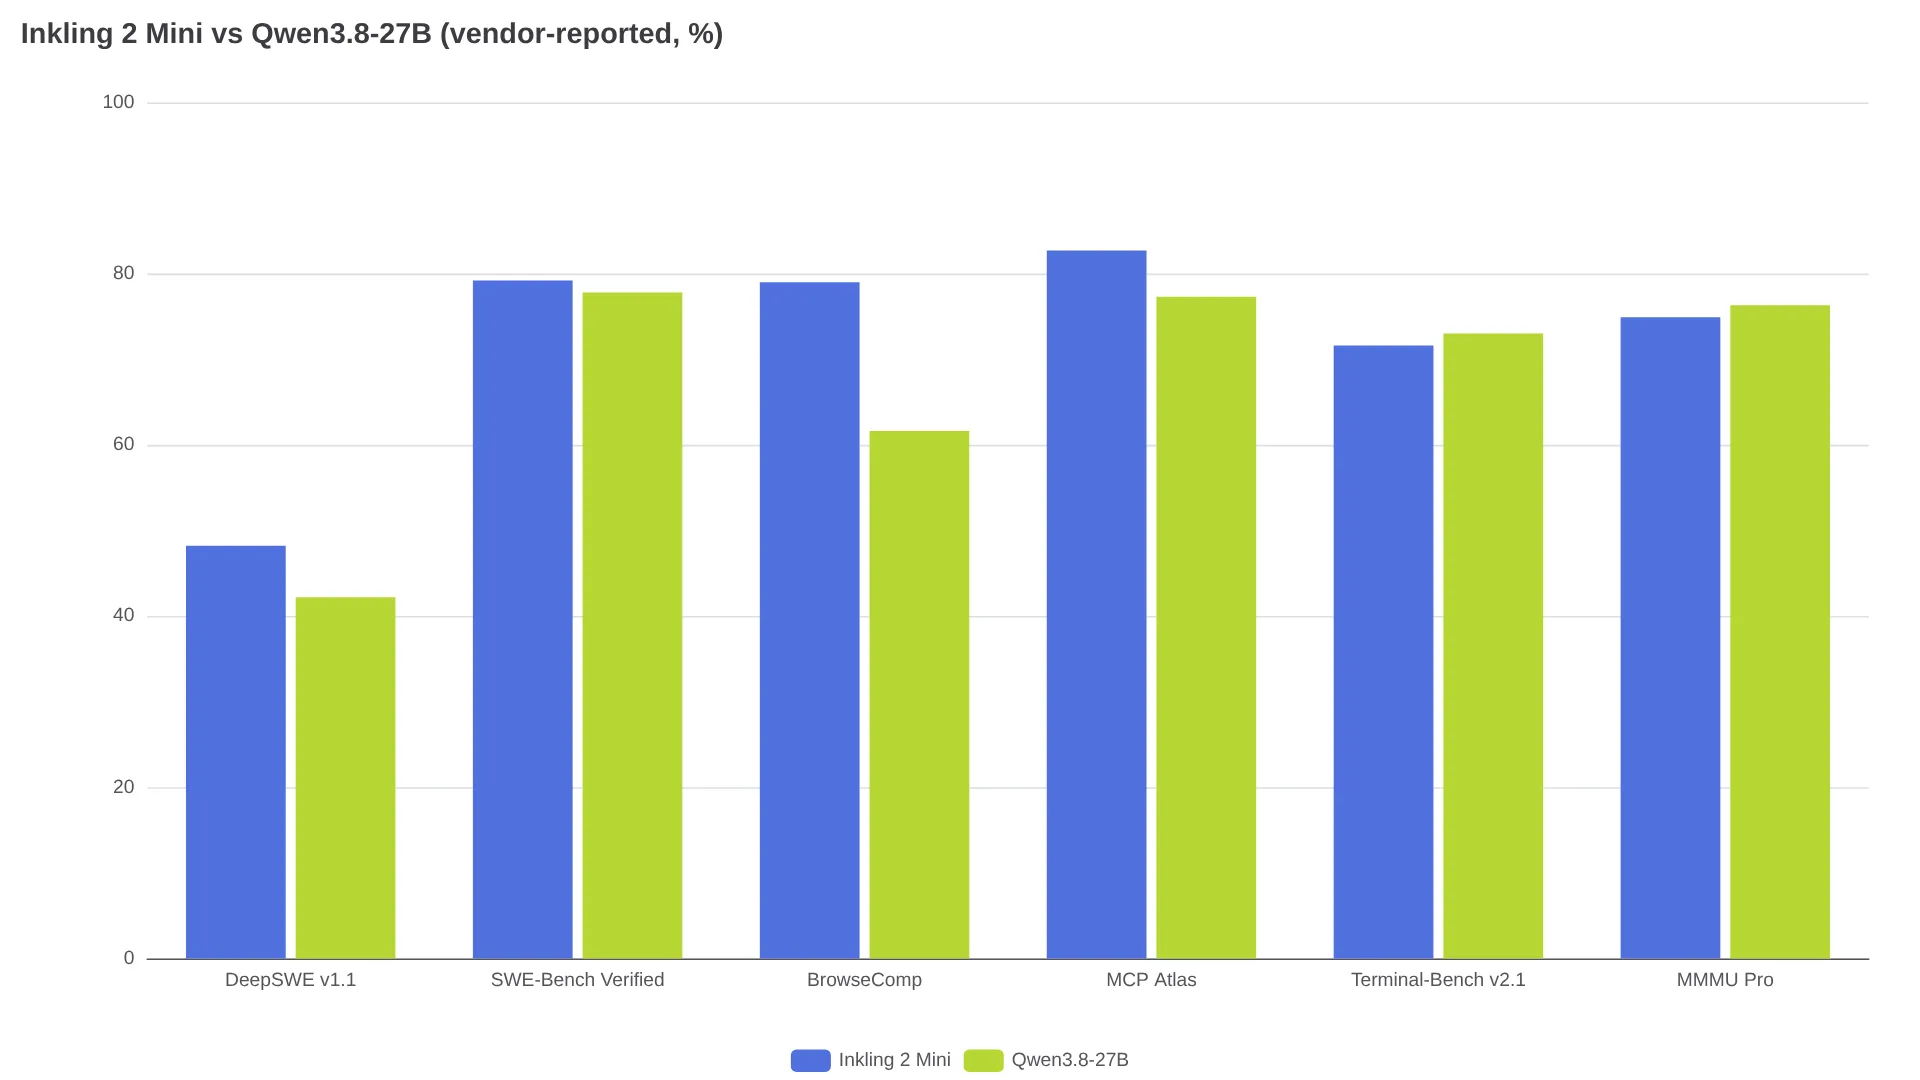
Mini, DeepSWE v1.1’de Qwen3.8-27B’nin %42,2’lik sonucuna karşı %48,2; SWE-Bench Verified’da %77,8’e karşı %79,2; BrowseComp’ta %61,6’ya karşı %79,0 ve MCP Atlas’ta %77,3’e karşı %82,7 skor alıyor. Artificial Analysis, Intelligence Index’te iki modele de 20,1 puan veriyor; ancak Mini, endeks testini Qwen’in 38,2 dakikasına karşı 9,0 dakikada tamamlıyor. ARC Prize ise en yüksek akıl yürütme ayarında ARC-AGI-1 için %84,5, ARC-AGI-2 için %49,3 bildiriyor.
Aynı model kartındaki diğer sonuçlar Mini’nin geride kaldığı alanları gösteriyor: HLE-Diamond’da %15,2’ye karşı %15,3, MMMU Pro’da %74,9’a karşı %76,3 ve Terminal-Bench v2.1’de %71,6’ya karşı %73,0. Olgusal doğruluk farkı daha belirgin: AA-Omniscience halüsinasyonsuz yanıt oranı Mini’de %63,4, Qwen’de %71,4. ComplexConstraints (%33,4) ve MultiChallenge (%50,0) sonuçlarında da Qwen önde.
Yerel kullanımda tek bir hız yok
Resmi Ollama listesi ve model kartı 32 GB belleğe sahip bir Mac’i veya DGX Spark’ı hedef gösteriyor. Ancak döngülü model desteği henüz erken aşamada olduğu için gerçek hız geniş bir aralıkta değişiyor. Barındırılan kullanımda Artificial Analysis tarafından ölçülen 280 tok/s, dizüstü bilgisayardaki performansı tahmin etmek için iyi bir gösterge değil.
| Kurulum | Raporlanan hız | Kaynak |
|---|---|---|
| Barındırılan test (Artificial Analysis) | 280 tok/s | Üçüncü taraf ölçümü |
| RTX 4090, yamalanmış vLLM + FP8/NVFP4 + taslak model | ~190-220 tok/s | Reddit kullanıcısı, yalnızca yama sonrası (117 başlangıç sonucu) |
| M5 Max MacBook Pro | ~125 tok/s | @alexocheema |
| M1 Max MacBook Pro 64 GB, 4 bit quant | ~20 tok/s | Hacker News kullanıcısı gregsadetsky, eesel’in çıkış incelemesi üzerinden |
| İlk llama.cpp sürümleri, çeşitli donanımlar | ~5-10 tok/s | r/LocalLLM başlığı |
"5 t/s hızına bile çıkaramadım." — u/KURD_1_STAN, r/LocalLLM karşılaştırma başlığı
Aradaki farkın önemli bir bölümünü çalışma zamanı desteği ve quantization seçimi açıklıyor. Güncel sürümler döngülü katmanları ilk günkü sürümlere göre daha iyi yönetiyor. Ayrıca quant seçimi, uzun bağlamların KV-cache yükü eklenmeden önce modelin kapladığı alanı değiştiriyor. Crewmark üzerinden Unsloth rehberine göre önerilen 4 bit kurulum yaklaşık 17,6 GB ve buna ek olarak 639 MB’lık görüntü projektörü kullanıyor.
Aynı gecikmeyle yapılan bir ödeme eşleştirme testinde Qwen, hiç yanlış eşleşme üretmeden %98,2 doğruluğa ulaşırken Mini %96,9 doğruluk ve beş yanlış eşleşme verdi:
"Gerçek ödeme eşleştirme iş yükümüzde Inkling 2 Mini ile Qwen3.8-27B’yi test ettik... Qwen: %98,2 doğruluk, 0 yanlış eşleşme... Inkling: %96,9, 5 yanlış eşleşme... Bu iş için Qwen ile devam ediyoruz." — @exebat3 (gönderi)
Pratik sonuç şu: 32K bağlamla başlayın, bellek baskısı oluşursa değeri düşürün ve kalite değerlendirmesi yapmadan önce kullandığınız çalışma zamanı sürümünün döngülü katmanları desteklediğinden emin olun.
Satın alma düğmesi olmayan fiyatlandırma
Artificial Analysis model sayfasında aktarılan Tinker ücretleri, milyon giriş tokenı başına 0,15 dolar, önbelleğe alınmış tokenlar için 0,015 dolar ve çıktı için 0,50 dolar. İnce ayar fiyatı ise 64K için 0,75 dolar, 256K için 1,50 dolar. Ölçülen token kullanımına uygulandığında bu rakamlar, Qwen3.8-27B için 3,53 dolara karşılık Mini’de endeks görevi başına 0,59 dolarlık bir maliyet çıkarıyor.
Ancak 0,59 dolar satın alınabilen, kesinleşmiş bir barındırma fiyatı değil; bu yalnızca bir tahmin. İncelemenin yapıldığı sırada Mini hiçbir sunucusuz çıkarım listesinde görünmüyordu. eesel’in incelemesi Tinker ve OpenRouter üzerinde yaptığı kontrolü de belgeliyor. Üstelik endeks çalışmasında Mini 161 milyon çıktı tokenı üretti; medyan değer 85,7 milyondu. Yani token başına indirim, modelin ayrıntılı yanıtlarıyla kısmen eriyor. Kendi donanımınızda çalıştırma kararı verirken donanım, elektrik ve kurulum maliyetlerini barındırılan bir Qwen veya frontier API seçeneğiyle birlikte değerlendirin.
İşe yarayıp yaramayacağını belirleyen iki ayar
Akıl yürütme seviyesi none (0,0), minimal (0,1), low (0,2), medium (0,7), high (0,9; varsayılan) ve xhigh/max (0,99) seçenekleri arasında değişiyor. Model kartına göre minimum seçeneği akıl yürütmeyi tamamen kapatmıyor.
Daha düşük seviye bazen daha iyi sonuç verebiliyor. r/LocalLLM’deki Terminal-Bench tartışmasında bir kullanıcı, 13 görevlik alt kümede low seviyesinde 10/13 skor aldığını; medium seviyesinde ise testin tekrar tekrar zaman aşımına uğradığını belirtti. Öte yandan eesel’in incelemesinde aktarılan bir Hacker News testinde model, araçlar olmadan 19.200 düşünme tokenı tüketti ve görevi tamamlayamadı. Arama etkinleştirildiğinde ise çözüm üretti, ancak yanlış hook adını kullandı.
Çıktı tokenlarını ve ajan turlarını sınırlandırın, dosya sistemi erişimini sandbox içine alın ve üretimde kullanmadan önce insan onayı isteyin. Model kartı, özellikle kod hata ayıklama sırasında onay almadan yıkıcı işlemler yapılabileceği ve akıl yürütme döngülerinin takılabileceği konusunda uyarıyor.
İndirmeden önce kabul etmeniz gereken bedel
Mini, orta katmanlarını yeniden kullanarak daha büyük bir checkpoint’e ihtiyaç duymadan daha fazla hesaplama yapıyor. Laboratuvar ayrıca bu davranışı araştırmak için değişken döngülü bir araştırma checkpoint’i yayımlıyor (anlatım). Raporda görülen sorunlar da oldukça somut: hata ayıklama sırasında döngüye girme, bir kullanıcının bildirdiği üzere yanıtın ortasında Japoncaya geçme ve kontrol altında tutulması gereken araç çağrıları. Güvenlik önlemleriyle birlikte çevrimdışı kodlama için indirilebilir; dikkatli sohbet veya tek tıkla çalışan bir API arıyorsanız beklemek daha doğru.
SSS
Inkling 2 Mini bir dizüstü bilgisayarda çalışır mı?
Evet, doğru kurulumla çalışır: Ollama veya güncel llama.cpp üzerinden 32 GB ve üzeri belleğe sahip Apple Silicon Mac yeterli. İdeal seçenek 4 bit quant’dır (yaklaşık 17,6 GB ve buna ek olarak projektör). Eski bir M1 Max’te yaklaşık 20 tok/s, M5 donanımında ise 100 tok/s üzeri bekleyebilirsiniz; yamalanmamış çalışma zamanlarında hız tek haneli değerlere kadar düşebilir (yukarıdaki tabloya bakın).
Inkling 2 Mini, Qwen3.8-27B’den daha mı iyi?
Kodlama ajanları için evet, sohbet için hayır. Yukarıdaki grafikte görüldüğü gibi Mini, DeepSWE, SWE-Bench Verified, BrowseComp ve MCP Atlas’ta önde. Qwen ise Terminal-Bench v2.1, MMMU Pro, olgusal doğruluk ve kısıtlı talimatlarda daha iyi. Tüm rakamlar model kartı üzerinden üretici tarafından raporlanmış sonuçlar.
Kaynaklar neden hem 3,4 milyar hem de 5,4 milyar aktif parametreden söz ediyor?
3,4 milyar, modelde kayıtlı aktif parametreleri ifade ediyor; 5,4 milyar ise yaklaşık 1 milyar parametreye denk gelen üç döngü geçişini de hesaba katıyor. Bellek hesabında 3,4 milyarı, hesaplama yükünü değerlendirirken 5,4 milyarı kullanın.
Inkling 2 Mini’yi bugün barındırılan bir API üzerinden çağırabilir miyim?
İncelemenin yapıldığı sırada birinci taraf sunucusuz endpoint bulunmuyordu. eesel’in kontrolüne göre Tinker örnekleme ve ince ayar ücretlerini açıklıyor, ancak Mini için sunucusuz bir listeleme sunmuyor. Hugging Face ağırlıklarını yerel olarak çalıştırmanız veya barındırılan desteğin gelmesini beklemeniz gerekiyor.
Akıl yürütme döngülerini nasıl durdurabilirim?
Model kartının önerdiği gibi önce low (0,2) seviyesini deneyin, çıktı tokenlarını ve ajan turlarını sınırlandırın, araçları sandbox içine alın.
İlgili okumalar: Mini’nin 594B’lik kardeşi için Inkling 2 Small incelemesi ve API fiyatlandırması; Mini’yi ajan seçenekleri arasında konumlandırmak için 2026’da kodlama ajanları için en iyi LLM; Mini’nin yerel kullanımda ihtiyaç duyduğu çalışma zamanı için llama.cpp v1.0 rehberi.