Gemini API'deki Tool Retrieval sayesinde ajanlar yüzlerce aracın adını taşıyabiliyor; ancak ayrıntılı parametre şemaları yalnızca o görev için gereken araçlarda bağlama ekleniyor. Bunun bir bedeli var: Her arama ek bir model geçişi çalıştırıyor. Dolayısıyla her turda arama yapan iş yüklerinde maliyet düşmek yerine artabiliyor.
Google'ın açıklamasına göre özellik, yalnızca Interactions API içinde olmak üzere 19 Kasım 2026'da önizleme olarak kullanıma açıldı. Yeni sistem, tool_search aracını ve defer_loading: true işaretini getiriyor. Ertelenen araçlarda ad ve açıklama görünür kalırken parametre JSON'u bağlamın dışında tutuluyor. Bunun için ayrıca bir ücret alınmıyor; standart girdi, önbelleğe alınmış girdi ve çıktı ücretleri geçerli.
200 araç, tek bir çağrı yapılmadan neden 164.000 token tüketebiliyordu?
İstem maliyetini asıl belirleyen araç sayısı değil, şemaların kapladığı alan. Bu yüzden geniş araç katalogları istemin büyük bölümünü tek başına kaplayabiliyor.
Google dokümanlarını inceleyen bağımsız teknik analiz, az sayıda aracın kullanıldığı 200 araçlık bir kütüphane için çarpıcı bir örnek veriyor: erteleme olmadan yaklaşık 164.000 girdi token'ı, Tool Retrieval ile ise yaklaşık 23.650 token. Bunlar analizdeki yuvarlatılmış örnek rakamlar, bir kıyaslama testi değil. Esas nokta, hiç kullanmadığınız şemalar için ödeme yapmayı bırakmanız.
Bir de doğruluk tarafı var. Bağlam içinde birbirine benzeyen onlarca şemanın yarışması, modelin yanlış aracı seçebileceği yolları artırıyor. Google, Tool Retrieval'ı hem token yükünü hem de seçim doğruluğunu iyileştiren bir yöntem olarak konumlandırıyor. Yayımlanmış bir doğruluk oranı bulunmadığından, bu kısmı kendi görevlerinizde sınanacak bir varsayım olarak görmek doğru olur.
Gemini Tool Retrieval nasıl çalışıyor: tool_search ve defer_loading
Kurulumda iki kısa bildirim parçası var: {"type": "tool_search"} değerini taşıyan bir tool_search girdisi ve ertelenecek her araçta "defer_loading": true. İstek yapısının tamamı doküman analizinde yer alıyor. Model, ertelenen her aracın adını ve açıklamasını görmeye devam ediyor. defer_loading açıklamasına göre short_description tanımlıysa model bunu; değilse tam açıklamanın ilk cümlesini görüyor.
Sunucu tarafındaki akışın tamamı tek istek içinde ilerliyor:
- Model, örneğin
issue_refundaracını isteyen birtool_search_callüretiyor. - API, tam şemayı içeren bir
tool_search_resultdöndürüyor. - Model gerçek
function_callçağrısını oluşturuyor (Google'ın iade örneğindegemini-4-hydrogenmodeliyleorder_id: "A-1042"veamount: 40kullanılıyor). - Kodunuz çağrıyı çalıştırıp
function_resultile sonucu geri döndürüyor.
Her şeyi interaction.steps içinde kayda alın. Yanlış araç yüklenirse önce iz kaydında belirsiz araç adları veya açıklamaları olup olmadığına bakın.
Sunucu tarafı mı, istemci tarafı mı: tek istek mi, ek tur mu?
| Mod | Aramayı yapan | Kurulacak dizin | Ek gidiş-dönüş | En uygun kullanım |
|---|---|---|---|---|
| Sunucu tarafı (varsayılan) | Gemini | Yok — "There's no index to build or host." | Yok, aynı istek içinde | Büyük ve çoğunlukla sabit kütüphaneler; tüm MCP sunucuları |
İstemci tarafı ("execution": "client") | Uygulamanız | Kendi kayıt defteriniz veya gömme dizininiz | Arama başına bir tane | Kullanıcı bazlı izinler, özel kayıt defterleri, konuşma ortasında eklenen araçlar |
Sunucu tarafı getirme için barındırılan bir dizin gerekmez ve işlem aynı yanıtta tamamlanır. Doküman analizine göre bir mcp_server aracında defer_loading: true kullanmak, o sunucunun sunduğu tüm araçları erteler.
İstemci tarafında "execution": "client" ile tool_search kullanılır (örnekte zorunlu query dizesine sahip search_tools adı yer alıyor). Uygulamanız eşleşmeleri bir function_result içinde döndürür; ardından previous_interaction_id taşıyan client.interactions.create çağrısı yapılır. Aynı analize göre istek başına yalnızca bir tool_search kullanılabilir ve iki mod birlikte kullanılamaz.
Yetkilendirme kullanıcı bazındaysa veya entegrasyonlar konuşma sırasında eklenebiliyorsa istemci tarafını seçin. Atıf yapılan analize göre, ortak bir katalog üzerinde çalışan sunucu tarafı arama, kullanıcıya özel izin filtrelemesini tek başına uygulamaz. Ayrıca, araçları baştan topluca bildirmeden konuşma ortasında eklemeyi destekleyen mod da istemci tarafıdır.
Gemini Tool Retrieval fatura hesabı: şimdi 26 token, sonra bir tam geçiş daha
Google'ın duyurusuna göre Tool Retrieval için ayrıca ücret alınmıyor: "Tool Retrieval has no separate charge." Ancak token ekonomisi analizine göre ücretlendirilmeye devam eden dört kalem var:
tool_search, her isteğe küçük ve sabit bir girdi-token bloğu ekler.- Atıf yapılan analiz, ertelenmiş her ad-açıklama satırı için yaklaşık 26 token öngörüyor.
- Sunucu tarafındaki her arama, mevcut bağlam üzerinde ek bir model geçişi çalıştırır; analize göre bu, önbellek isabetleri çıkarıldıktan sonra yaklaşık istemin girdi hacmi üzerinden
total_tool_use_tokenskapsamında ücretlendirilir. - Yüklenen her şema, konuşmanın geri kalanında girdi olarak ücretlendirilir ve kaldırılamaz.
| İş yükü (atıf yapılan analizden örnek tahminler) | Getirme olmadan | Getirme ile | Sonuç |
|---|---|---|---|
| 200 araç, görev başına az sayıda kullanım | ~164.000 token | ~23.650 token | Tasarruf sağlar |
| 10 araç, 30k bağlam, neredeyse her tur arama | ~68.000 token | ~92.830 token | Daha pahalı |
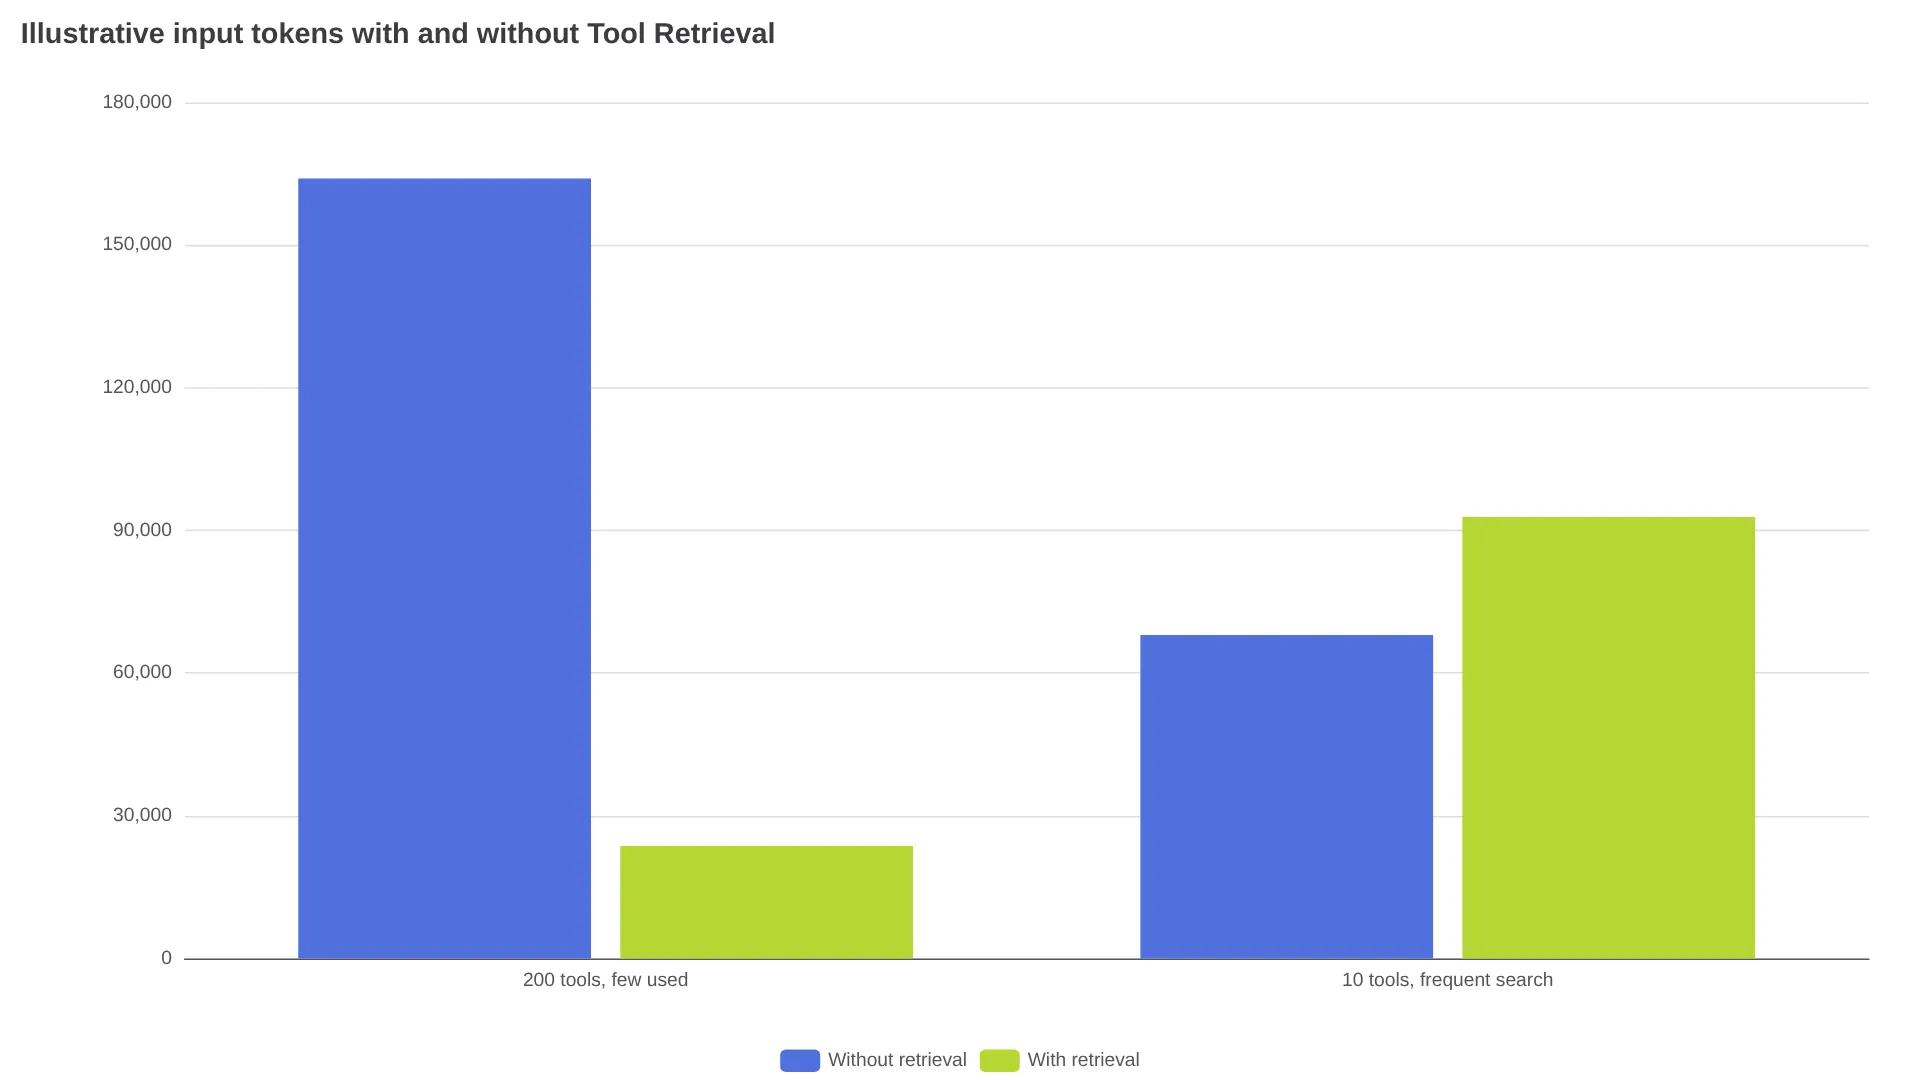
Google'ın aynı duyurudaki tavsiyesi net: "Measure it against your own traffic."
"Sunucu tarafı modunda... her sunucu tarafı arama, mevcut bağlam üzerinde bir model geçişi daha ekler... Bu nedenle her görevde birkaç aracın kullanıldığı büyük bir kütüphane avantaj sağlayabilir. Uzun konuşmaları ve sık aramaları olan küçük bir kütüphane ise daha pahalıya gelebilir." — @tekroch
Erteleme, önbelleğe alınmış ön eki daha stabil hâle getirebilir; ancak istemi önbellek boyutu eşiğinin altına da indirebilir. Bu nedenle, atıf yapılan analizin önerdiği gibi önbellek isabet oranını girdi token'larıyla birlikte takip edin.
Hangi araçları ertelemeli, hangilerini yüklü bırakmalısınız?
Küçük kütüphanelerde önce statik yüklemeyi kıyaslayın; araç sayısından çok arama sıklığı ve şema boyutu önemlidir. Her görevde 1–3 araç kullanılan büyük kataloglarda, uzun kuyruğu sunucu tarafında erteleyin ve sık kullanılan araçları, yani isteklerin çoğunda çağrılanları ertelenmeden bırakın. Kullanıcıya özel veya sohbet ortasında ortaya çıkan araçlarda istemci tarafını kullanın ve her arama için bir gidiş-dönüş bütçesi ayırın.
Atıf yapılan uygulama notları, önlem almanız gereken üç hata senaryosu sıralıyor:
- Sistem talimatlarında veya başka bir aracın çıktısında adı geçen bir aracı ertelemeyin; model arama yapmadan çağrı üretmeye çalışabilir ve sonraki tur başarısız olabilir.
- Ertelenen işlevlerin istekte yine de eksiksiz
parameterstanımı bulunmalı; yalnızca ad ve açıklama vermek, boş ve çağrılamayan bir şema döndürebilir. - Durumsuz uygulamalarda
tool_search_call,tool_search_result, imzalar ve tamtoolsdizisini her turda değiştirmeden yeniden gönderin.
Getirme başarısını açıklamanın kalitesi belirler: Model herhangi bir şemayı görmeden önce adlar ve açıklamalar arasından seçim yapar. "Search customer invoices by date range" kolayca bulunur; "Invoice helper" ise başka araçlarla çakışır. Erteleme bir güvenlik sınırı değildir — ertelenmiş MCP adları ve açıklamaları istem girdisi olarak görünür kalır; yüklenen araçlar da verdiğiniz izinlerle çalışır. Bu, güvenlik analizinde özellikle vurgulanıyor.
Önizleme sürümünün henüz sunmadıkları
Bu özellik yalnızca önizlemede, yalnızca Interactions API'de ve v1beta yüzeyinde çalışıyor. generateContent desteği yok; doküman analizine göre desteklenmeyen bir modelde defer_loading kullanmak HTTP 400 döndürüyor.
Model kapsamı, başlıktan anlaşıldığından daha dar olabilir: Duyuru, tüm Gemini 4 modelleri dahil Gemini 3.6 ve sonrasını işaret ediyor. Ancak atıf yapılan analizde, canlı dokümanların şu anda gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash ve gemini-3.6-flash modellerini listelediği belirtiliyor. Aynı ailedeki modellerin otomatik olarak desteklendiğini varsaymadan önce dokümanlardan doğrulama yapın. GA için herhangi bir tarih açıklanmadı. Lansman haberine göre Anthropic, aynı defer_loading yaklaşımını Kasım 2025'te beta olarak sunmuştu; Google'ın farkı ise sunucu tarafı MCP ertelemesi ve istemci tarafı mod.
| Araç kütüphanenizin yapısı | Tercih edilecek mod | İlk adım |
|---|---|---|
| Küçük, stabil | Statik yükleme | Karmaşıklık eklemeden önce şema token'larını ölçün |
| 50–200 araç, görev başına az sayıda kullanım | Sunucu tarafı erteleme | Uzun kuyruğu erteleyin, sık kullanılan araçları yüklü tutun |
| Kullanıcıya özel veya sohbet ortası araçlar | İstemci tarafı getirme | İzin farkındalığı olan bir arama sistemi kurun |
| Her araç her turda kullanılıyor | Statik yükleme | Arama ek yükü muhtemelen tasarrufu aşar |
Önce uzun kuyruğun tek bir dilimini yayına alın. Ardından aynı görevlerde, erteleme açık ve kapalıyken girdi token'larını, total_tool_use_tokens değerini, gecikmeyi ve görev başarısını karşılaştırın.
Sık sorulan sorular
Tool Retrieval, generateContent ile çalışıyor mu?
Hayır. Yalnızca v1beta üzerindeki Interactions API'de kullanılabilir.
Hangi modeller destekleniyor?
Gemini 4 dahil Gemini 3.6 ve sonrası için duyuruldu. Ancak atıf yapılan analiz, canlı dokümanların kapsamı şu an gemini-4-hydrogen ve gemini-3.6-flash dahil belirli modellerle sınırladığını aktarıyor. Kullandığınız modeli mutlaka dokümanlardan kontrol edin.
Faturamı artırabilir mi?
Evet. Atıf yapılan örnek 10 araçlık iş yükünde, aramalar neredeyse her tur çalıştığında tüketim ~68.000 token'dan ~92.830 token'a yükseliyor.