Yanlış cevap oranının düşük kalması önemliyse, uzun bağlamlı ajanlarda high seviyesindeki Neon en iyi fiyat/performans seçeneği. Ancak görev başına maliyette Astra ve Sol daha ucuz. Bu yazı; resmi teknik özellikler, sıralamalar ve bağımsız testlerden oluşan lansman günü derlemesidir. Neon'u bizzat test etmedim.
Neon, ajanlar için daha hızlı bir Carbon; ancak belirgin bir ödün var
Gemini 4 Neon, 18 Kasım 2026'da gemini-4-neon adıyla, Google'ın ve 9to5Google'ın aktardığı üzere Hydrogen ile Carbon arasındaki orta seviye Gemini 4 modeli olarak kullanıma sunuldu. Google, Carbon'a kıyasla uçtan uca daha hızlı tamamlanma ve görev başına daha düşük maliyet vadediyor. DeepMind çalışanları da Neon'u Carbon'dan daha ucuz ve hızlı olarak tanımlıyor (@_mohansolo). Model, Artificial Analysis Index'te xhigh seviyesinde 61 puanla 3. sırada; Agent Arena'da ise 4.200'den fazla oturum üzerinden 1336 puanla 2. sırada. İncelediğim lansman materyallerinde Opus 5.5 ve Fable 5.2'nin aynı Arena panosundaki skorları yayımlanmadı. Bu nedenle aşağıdaki doğrudan karşılaştırma, indeks sıralamalarıyla aynı görevlerdeki testleri birlikte kullanıyor.
Fiyatı, bağlam penceresi ve erişilebildiği yerler
Google'a göre Neon'un fiyatı 1 milyon giriş token'ı için $3, çıkış token'ı için $15 ve önbelleğe alınmış giriş token'ları için $0.15. Bağlam penceresi 1.048.576 token; tek yanıt sınırı ise 65.536 token. Düşünme seviyeleri low / medium / high (varsayılan) / xhigh olarak sunuluyor ve çıktı üzerinden ücretlendiriliyor. Daha yüksek seviyeler daha fazla akıl yürütme token'ı tüketebileceği için fatura da artabiliyor. Varsayılan high seviyesi, DataCamp'in seviye açıklamasında ve SpringPrompt'un API notlarında belgelenmiş durumda.
eesel'in API incelemesine göre Neon yalnızca ücretli kullanıma açık; ücretsiz katmanı yok. Google ve 9to5Google'ın aktardığı erişim noktaları şöyle: AI Studio'da ücretli API, Gemini for business, Antigravity (Pro/Ultra), Argon'un yerini alan Gemini uygulaması (Pro/Ultra), Android Studio ve Cursor. Cursor tarafında varsayılan eforla CursorBench skoru %63,7; Hydrogen'ın skoru ise %57,3 (Cursor).
| Model | 1 milyon token başına giriş / çıkış | Varsayılan düşünme seviyesi |
|---|---|---|
| Gemini 4 Neon | $3 / $15, önbelleğe alınmış $0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | 30 Kasım'a kadar $2 / $10, sonrasında $4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20, test edilen en yüksek ayar | test edilen en yüksek |
| GPT-6.2 Sol | $2 / $10, test edilen en yüksek ayar | test edilen en yüksek |
Rakip fiyatları ve en iyi ayar etiketleri, eesel'in karşılaştırma tablosunda derlenmiş. 1 Aralık'tan itibaren Neon, token başına Carbon'dan %25 daha ucuz olacak. Ayrıntılar için: Neon fiyatlandırması.
Düşünme seviyelerini sabitlemek için API'yi, yönetilen kota kullanımı içinse uygulamayı veya Antigravity'yi tercih edin. Kota verileri yalnızca planlama açısından fikir veren, anekdot niteliğinde göstergeler: kullanıcı raporlarına göre sohbet başına Pro kotasının yaklaşık %1–3'ü, 10 dakikalık 3 alt ajanlı bir çalıştırma içinse yaklaşık %5'i tüketiliyor (kullanıcı raporları).
Opus 5.5, Fable 5.2 ve Sol karşısında kıyaslamalar
Skorlar Google tarafından bildirildi; eesel ve DataCamp tarafından derlendi.
| Test | Neon | Rakip | Sonuç |
|---|---|---|---|
| Vals Index | %70,9, 2. sıra | Fable yaklaşık %71,3 | Zirveye çok yakın |
| AutomationBench | %56,3, 1. sıra | Opus %42,5, Sol %41,3 | Ajan performansında lider |
| GraphWalks 256K–1M | %95,2 | Opus %66,8, Sol %80,1 | Uzun bağlamda lider; bazı Argon kullanıcıları aşırı özetleme bildirdiği için önce en uzun dosyanızı yeniden oynatın (tartışma) |
| Terminal-Bench 4.1 | %65,2 | Opus %65,8 | Başa baş; Opus +0,6 |
| FrontierCode 2.0 | %46,2 | Opus %47,3 | Opus +1,1 |
| CursorBench 4.1 | %63,7–65,4 | Opus %58,1 | Varsayılan eforla Neon önde |
eesel'in aktardığı Artificial Analysis verilerine göre görev başına maliyet, token fiyatlarının tek başına anlattığı tabloyu değiştiriyor:
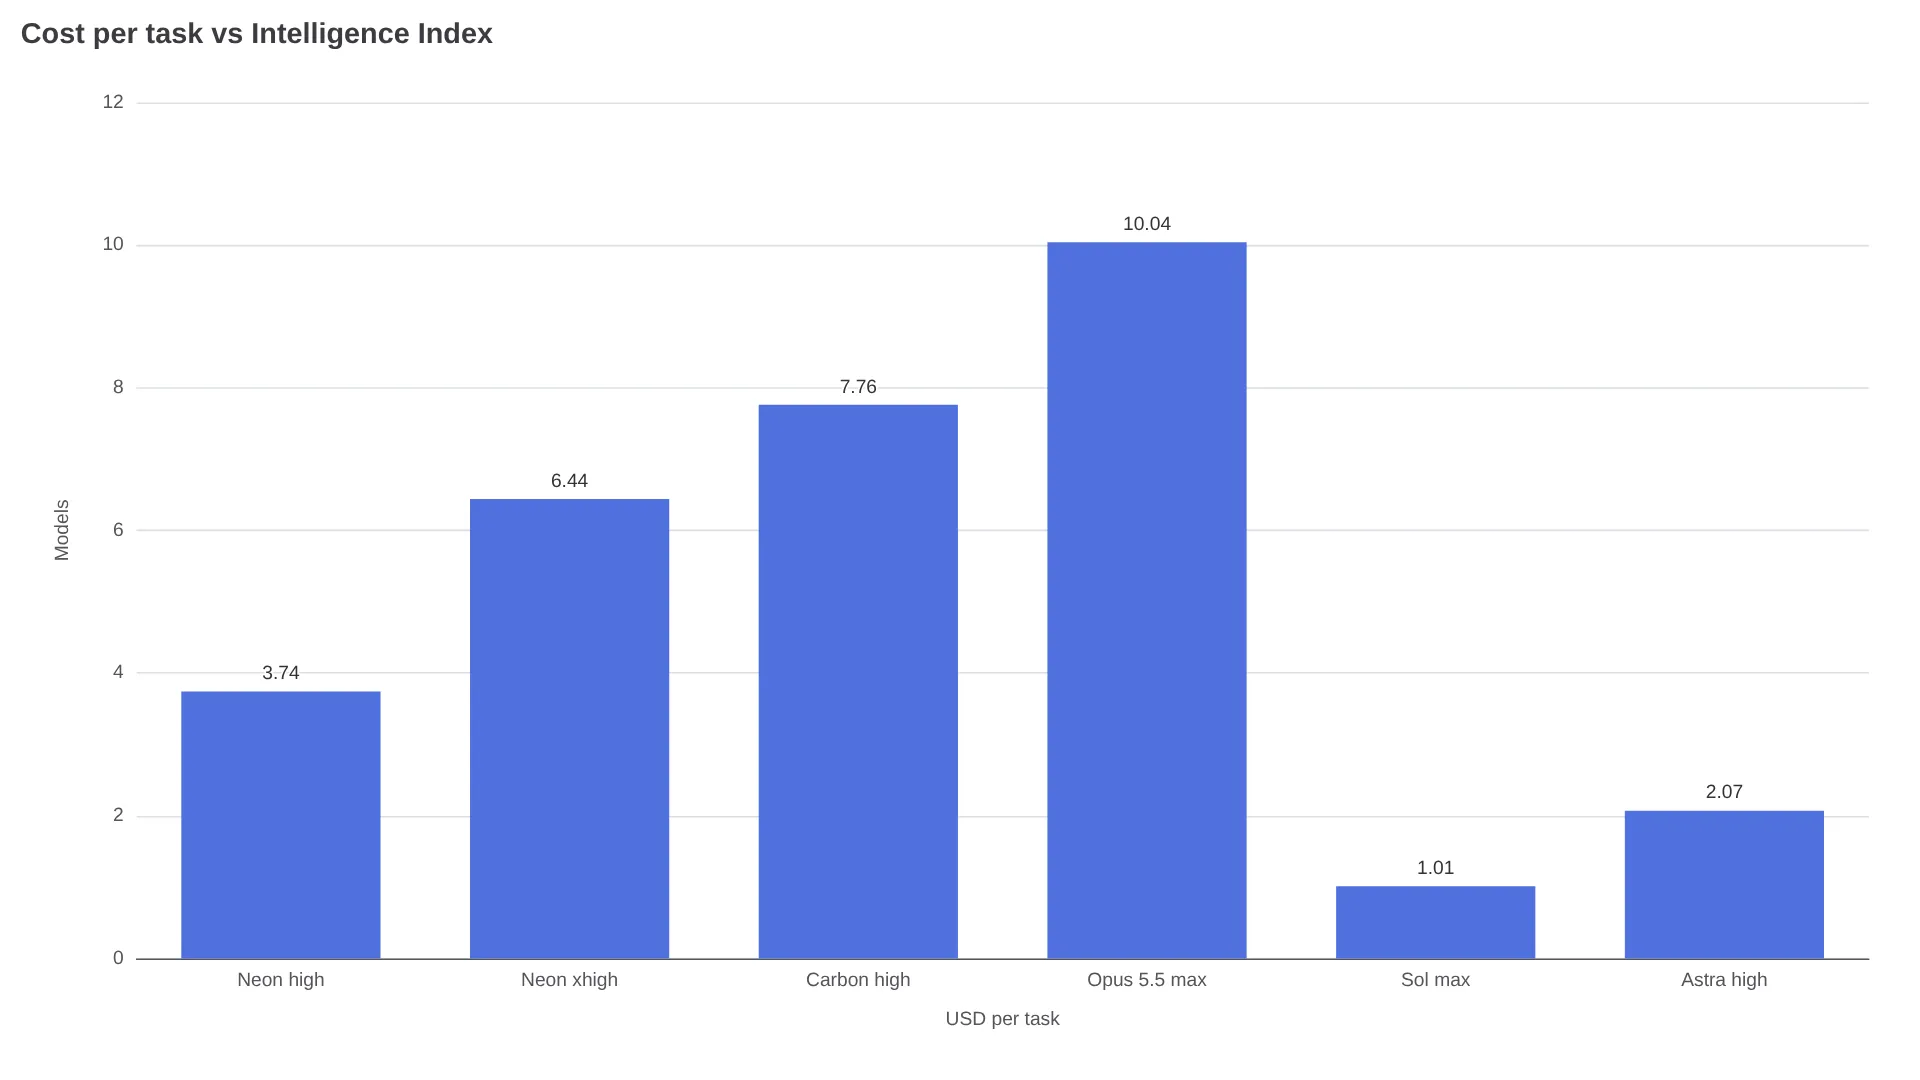
Neon high, 14,8 dakikada $3,74 karşılığında 59,6 puan alıyor; Carbon high, 37,2 dakikada $7,76 karşılığında 60,0 puana ulaşıyor. Opus max ayarında 59,1 puan için $10,04 harcıyor. Astra high 60,1 puanı $2,07'ye, Sol max ise 57,3 puanı $1,01'e veriyor. Neon xhigh ile 21,5 dakikada 61,4 puana ve $6,44 maliyete çıkıyor. 1,8 puanlık fark için $2,70 ve 6,7 dakika ödemeye değmeyecekse high seviyesinde kalın.
Neon ve Fable 5.2: İlk raporlar görev paylaşımını işaret ediyor
Sağlayıcıya özel harness ile yapılan SWE-sweep testinde (Antigravity harness) sonuç Neon için %39,0; Opus için %10,1 ve Sol için %8,3 oldu. Paylaşılan mini-SWE harness'ta ise skorlar Neon %12,8, Sol %11,6 ve Opus %3,6 olarak ölçüldü (DataCamp). Başlıklarda öne çıkan farkın önemli bir bölümü saf model performansından değil, kullanılan harness'tan kaynaklanıyor.
"Fable 5.2'yi orkestratör ve geliştirici, Neon'u ise kodlama ajanı olarak çalıştırıyorum; şimdiye kadar kullandığım en iyi sistem bu." — u/1969Stingray (tartışma)
Kullanıcı deneyimleri genel olarak orkestrasyon için Fable'ı, uygulama tarafı içinse Neon'u öne çıkarıyor; yine de kendi deponuzda doğrulama yapın. AA-Omniscience testinde Neon'un yanlış cevap verip geri çekilmeme oranı %14. Opus'ta bu oran %50, Sol'da %55, Astra ve Fable'da %58. Buna karşılık doğru cevap kapsaması Neon'da %59–60 seviyesinde kalıyor; Astra %66, Fable ise %77'ye ulaşıyor (eesel).
Pratik testler: satranç, ürün listeleri ve 105 gerçek hata
| Test | Sonuç | Sınır |
|---|---|---|
Satranç sayfası, medium ile 3 çalıştırma (DataCamp) | Neon $0,83–$1,06 maliyetle 3/3; Carbon 1/3, iki denemede 65K sınırına ulaştı; 16 oyunda sıfır geçersiz hamle | Tek görev; Carbon'un arka plan moduyla tamamlanması muhtemel |
| CatalogBench olgusal doğruluk (SpringPrompt) | Yayınlanmaya hazır sonuçta %78,6 x3, 35 model arasında 1. sıra; ambalaj üzerindeki teknik özellikleri okuyabiliyor | Satış %32,1, sunumlar 24. sıra, anketler bütçe kategorisinde 22. sıra |
| Yeniden eklenen 105 hata (@PawelHuryn) | Neon xhigh 63; Astra 62,7, Fable 58, Carbon 57,3 | Tek test uzmanı |
SpringPrompt, Google API'sinin varsayılan high seviyesi yerine OpenRouter üzerinden medium kullandı; bu nedenle yanıtların ayrıntı düzeyi farklı. AI Studio'da izole sızıntı bildirimleri de mevcut (tartışma). Sohbet tarafında eesel'in ölçümüne göre Neon xhigh seviyesinde ilk token için 56,5 saniye bekletiyor. Etkileşimli yanıtlar için medium veya Hydrogen daha mantıklı.
İş yükünüze göre seçim yapın
| İş yükü | Seçim | Nedeni |
|---|---|---|
| Zorlu ajanlar, uzun belgeler, refactor işlemleri | Neon high | $3,74 maliyetle 59,6 puan, Agent Arena'da 2. sıra, satrançta 3/3 |
| En uzun süren ve en karmaşık projeler | Google'ın aile konumlandırmasına göre Carbon | Google, Carbon'u en zorlu projeler için ayırıyor; burada aynı görevde yapılmış doğrulayıcı bir test yok |
| Orkestrasyon + kodlama | Fable lider + Neon kodlama ajanları | Yukarıdaki anekdot niteliğindeki hibrit kullanım; önce doğrulayın |
| En düşük görev maliyeti | Sol max $1,01; Astra high $2,07 ile daha yüksek skor alıyor | AA-Omniscience testinde her ikisinin de yanlış cevap oranı daha yüksekti |
| Etkileşimli sohbet | Hydrogen veya Neon medium | xhigh seviyesinde ilk token gecikmesi sohbet için fazla yüksek |
| Regülasyona tabi kullanım | Belgeler gelene kadar bekleyin | 19 Kasım itibarıyla kapsamlı güvenlik raporu hâlâ beklemede; yalnızca ihtiyaç duyduğunuz belgeler karşılanıyorsa onaylayın |
Bir öğleden sonra kendi testinizi yapın
Aynı komutu, aynı dosyaları ve aynı düşünme bütçesini Neon high, mevcut varsayılan modeliniz ve daha ucuz bir alternatif üzerinde çalıştırın. Başarı oranını, maliyeti, süreyi ve yanlış cevapları kaydedin. Kendi iş kuyruğunuz için bu tek karşılaştırma, herhangi bir sıralama tablosundan daha anlamlı olacaktır. Opus tarafındaki hesaplamalar için: Opus 5.5 incelemesi, Fable 5.2 incelemesi.