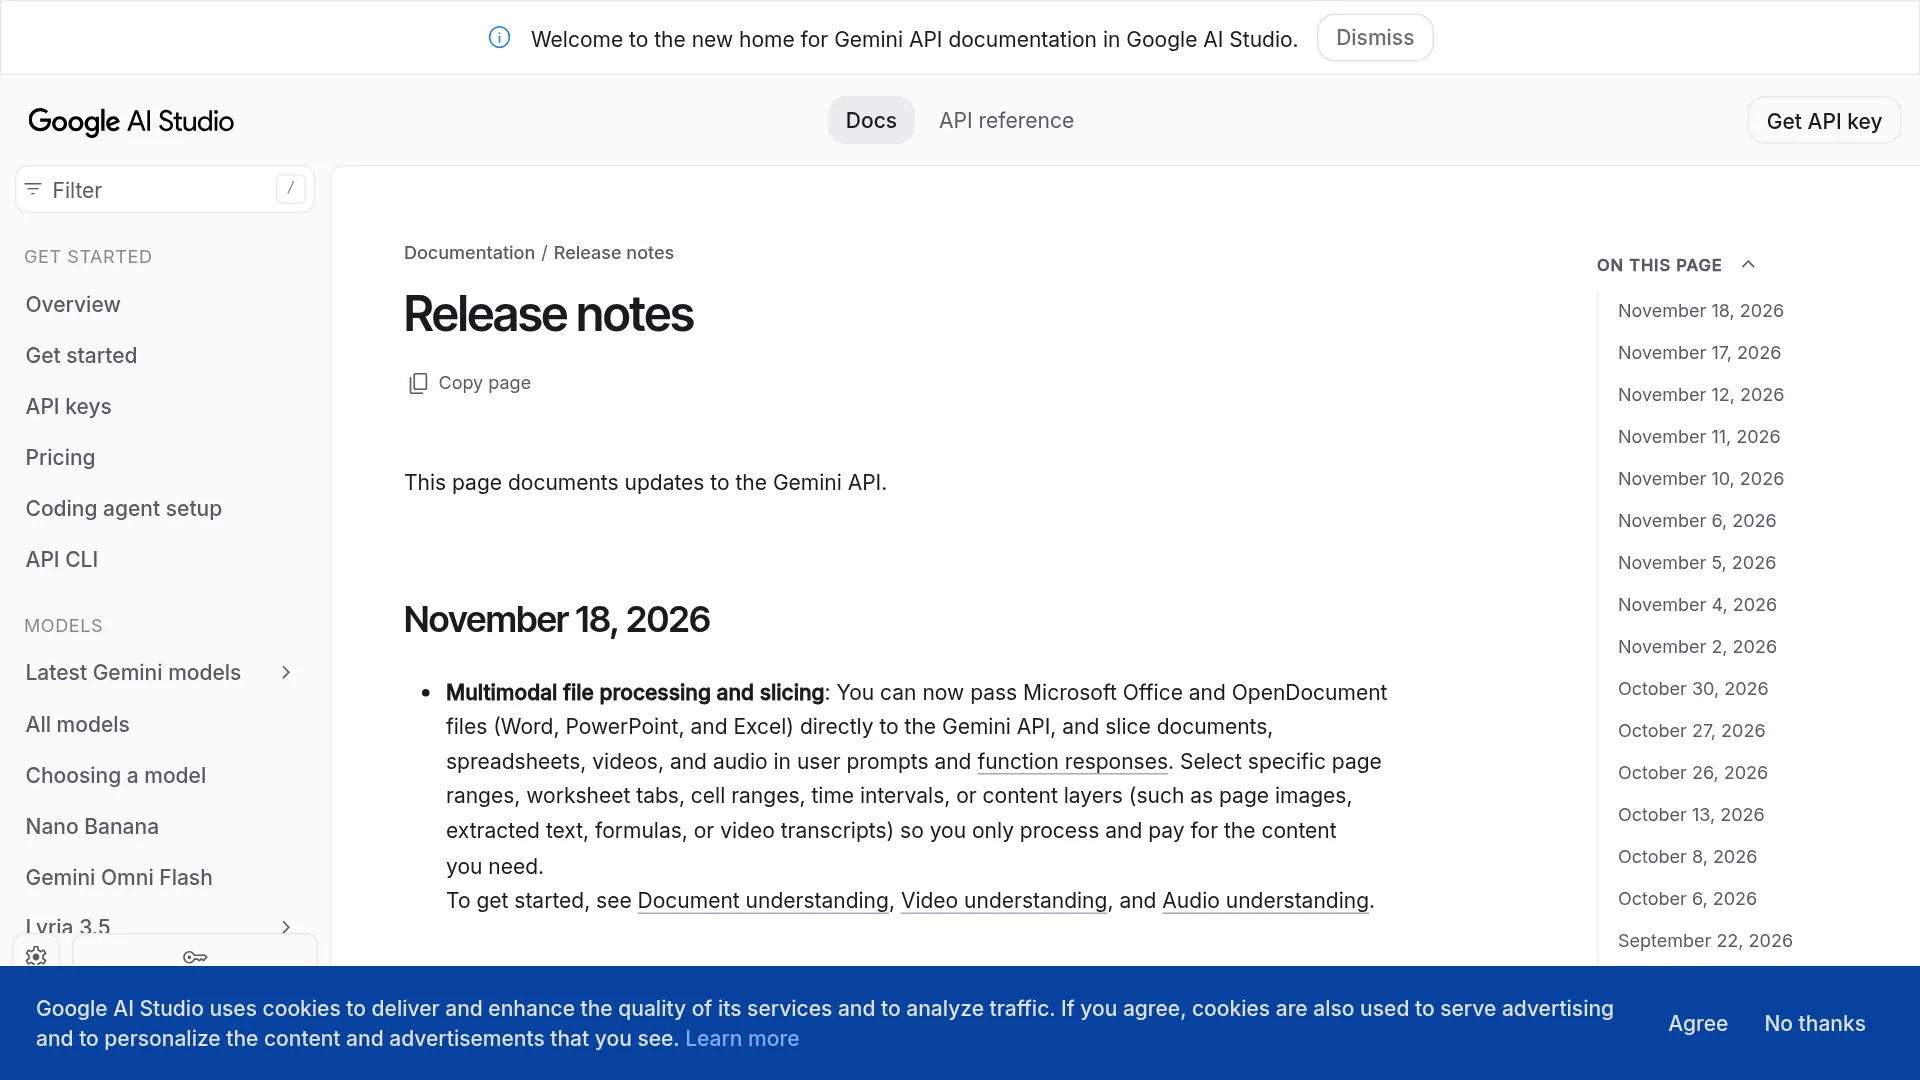
Gemini API'ye göndermeden önce her çalışma kitabını CSV'ye dönüştürüyorsanız artık buna gerek yok. 18 Kasım 2026'dan itibaren Gemini API, Word, Excel ve PowerPoint dosyalarını doğrudan kabul ediyor. Google'ın ifadesiyle, seçtiğiniz dilimi "işleyip yalnızca bunun için ödeme" yapabiliyorsunuz (Google AI Studio değişiklik günlüğü).
Ancak tasarruf için dilim seçicilerini açıkça belirtmeniz gerekiyor; aksi halde dosyanın tamamı yine işlenebilir. Okuyucu @zg0820 de bu noktaya dikkat çekiyor.
Eski Excel yöntemi neden yetersiz kalıyordu?
Önceki belgelenmiş davranış, yalnızca ilk çalışma sayfasını CSV olarak okuyordu. Bu da kullanıcıları sayfaların sırasını değiştirmeye veya çalışma kitaplarını bölmeye zorluyordu:
"Belgelerde hâlâ bir XLSX dosyasının yalnızca ilk sayfasının CSV olarak okunduğu yazıyor." — @aitrackerbot
18 Kasım tarihli kayıt, bu geçici çözümün yerini doğrudan Office ve OpenDocument girdilerine bırakıyor. Ayrıca istemlerde ve işlev yanıtlarında içerik dilimleme desteği geliyor (DocsWatch analizi).
18 Kasım güncellemesi gerçekte neyi değiştiriyor?
Bu kayıt, 5 Kasım'da PPT, ODP ve ODS için yapılan genişlemenin üzerine iki önemli özellik ekliyor:
- Office ve OpenDocument dosyalarını doğrudan gönderme. Word, PowerPoint ve Excel dosyaları artık PDF'ye veya metne dönüştürülmeden kullanılabiliyor.
- İçerik dilimleme. Sayfa aralıklarını, çalışma sayfası sekmelerini, A1 hücre aralıklarını, zaman aralıklarını veya sayfa görselleri, çıkarılmış metin, formüller ve transkriptler gibi içerik katmanlarını seçebiliyorsunuz.
Dilimleme hem istemlerde hem de FunctionResponse parçalarında çalışıyor. Böylece bir araç, çalışma kitabının tamamı yerine tek bir sayfa aralığı döndürebiliyor (AI Index özeti).
Artık hangi dosyaları, hangi modellerle gönderebilirsiniz?
18 Kasım 2026 UTC tarihinde güncellenen Firebase girdi gereksinimleri sayfası, Office desteğini Gemini 4.x modelleriyle ilişkilendiriyor (Firebase AI Logic belgeleri):
| Aile | Uzantılar | MIME türü |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Temel destek | .pdf, .txt | application/pdf, text/plain |
Resmî sınırlar şöyle; dilimleme bu sınırları artırmıyor:
- Dosya başına 50 MB, dosya başına 1.000 sayfa ve istek başına 3.000 belge dosyası.
- Satır içi base64 verisi için toplam istek boyutu 20 MB; daha büyük dosyalar için Cloud Storage URL'leri gerekiyor.
Doğrulanmamış topluluk notu: Bir değişiklik günlüğü okuyucusu, Office dosyaları için yaklaşık 2.000 sayfa veya slaytlık ayrı bir sınır bulunduğunu bildiriyor (@lawson_ste3476). Google bunu belgelememiş durumda; tasarımınızı bu sınıra göre yapmayın.
Word ve PowerPoint: sayfa aralığı ve içerik katmanı seçimi
DocumentMetadata, herkese açık v1beta/v1alpha Discovery belgelerinde gözlemlendi; kararlı v1 sürümünde bulunmuyor (ORIENS şema raporu):
startPage: ilk sayfa; 1 tabanlı ve dahil.endPage: son sayfa; 1 tabanlı ve dahil.contentLayers:PAGE_IMAGE(oluşturulan görsel; metadata mevcut olup katmanlar boş bırakıldığında bildirilen varsayılan) veyaPAGE_TEXT(çıkarılan metin).
Düzen, slaytlar ve taranmış sayfalar için PAGE_IMAGE; sözleşmeler gibi aranabilir metinler için PAGE_TEXT seçin. Firebase'in belgelediği temel modele göre PDF'ler görsel olarak ele alınıyor; bir sayfa bir görsel sayılıyor ve her iki kenarı da 384 piksel veya daha küçük görseller 258 token'a mal oluyor (Firebase AI Logic belgeleri).
Excel: sayfalar, hücre aralıkları ve üç katman modu
SpreadsheetMetadata, Discovery şemasına göre inline_data veya file_data üzerinden sağlanan dosya parçasına, bir giriş Part'ına ya da FunctionResponsePart'ına ekleniyor (ORIENS şema raporu):
sheetIndex: çalışma kitabındaki sırayı belirtir ve 1 tabanlıdır. Discoveryv1betametni bu alan belirtilmezse tüm sayfaların kullanılacağını söylüyor; Python ve JavaScript SDK metinleri ise ilk sayfayı işaret ediyor. Bu yüzden her seferinde açıkça ayarlayın.visibleCells:A1:G35gibi bir A1 aralığıdır; belirtilmezse seçilen sayfanın dolu alanı kullanılır.contentLayers:DATA(değerler, birleştirmeler, biçimlendirme),FORMULAS(ifadeler ve hesaplanmış sonuçlar),VISUAL(oluşturulan görsel). Bildirilen varsayılan değer[DATA, FORMULAS].
Denetimler için DATA ile FORMULAS'ı birlikte kullanın. Düzen ve birleştirilmiş hücre bağlamı gerekiyorsa VISUAL katmanını ekleyin; tek bir değer arıyorsanız visibleCells aralığını olabildiğince dar tutun.
Yalnızca gerekli dilimi gönderin: Python REST örneği
Aşağıdaki alan adları Discovery 20261116 revizyonuyla eşleşiyor. Yapı beta aşamasında ve kararlı v1 sürümünde bulunmuyor; üretime almadan önce kurulu SDK'nızla doğrulayın.
import os
from google import genai
import requests

client = genai.Client()  # GEMINI_API_KEY değerini okur
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Word için .docx MIME türüyle birlikte "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} kullanılır. PowerPoint'te de aynı documentMetadata yapısı geçerlidir; yalnızca .pptx MIME türünü ve slayt sayfa numaralarını kullanmanız gerekir.
Maliyet hesabı: dilimleme ne zaman gerçekten tasarruf sağlar?
Değişiklik günlüğünde veya Firebase fiyatlandırma notlarında dilimlemeye özel ayrı bir SKU bulunmuyor. Tasarruf, standart ücretlendirme üzerinden kaçınılan giriş token'larına eşit. Değişiklik günlüğünde gemini-4-hydrogen için 1 milyon giriş token'ı başına 1,50 dolar fiyat veriliyor.
Yalnızca 12–18. sayfaların önemli olduğu 200 sayfalık bir rapor için örnek hesap aşağıdaki gibi. Metin sayfası başına 800 token değeri belgelenmiş bir oran değil, bu örneğe ait bir varsayımdır:
- Önce: Sayfa başına minimum 258 token üzerinden görsel olarak işlenen 200 sayfa x 258 token = 51.600 giriş token'ı. Maliyet: 51.600 / 1.000.000 x 1,50 dolar = 0,0774 dolar.
- Sonra: Çıkarılmış metin olarak alınan 7 sayfa x varsayılan 800 token = 5.600 giriş token'ı. Maliyet: 5.600 / 1.000.000 x 1,50 dolar = 0,0084 dolar.
- Tasarruf: Çıktı token'ları hesaba katılmadan, bu istek için giriş maliyetinde yaklaşık %89. Kendi ölçtüğünüz sayfa yoğunluğunu kullanın.
Kendi çalışma kitabınızda aralık boyutlarını kıyaslayın: Çok sayıda küçük dilimlenmiş istek, iyi seçilmiş tek bir aralıktan daha yüksek toplam maliyet çıkarabilir (@zg0820).
Sorunsuz geçiş için doğrulama ve taşıma listesi
Bir dosyanın başarıyla yüklenmesi, ayrıştırmanın da başarılı olduğu anlamına gelmez. Her işlem hattını ayrıca doğrulayın:
- Ayrıştırmayı kanıtlayın. Satır sayısını, sayfa adını veya sayfa sayısını geri döndürmesini isteyin ve kaynak dosyayla karşılaştırın.
- Tüm seçicileri ayarlayın.
sheetIndex,visibleCellsveya sayfa aralığı vecontentLayersalanlarını belirtin. - Katmanı soruya göre seçin. Grafikler ve düzen için
VISUALveyaPAGE_IMAGE; denetimler içinDATAileFORMULAS; arama içinPAGE_TEXTkullanın. - Aralık dışı davranışı hazırlık ortamında test edin. Şema, geçersiz bir sayfa veya aralık verildiğinde hata mı döndürüleceğini, değerin sınırlar içine mi çekileceğini ya da boş sonuç mu alınacağını belirtmiyor.
- Yükleme sınırlarını aşmayın. 60 MB'lık bir dosya, 50 MB sınırında yine başarısız olur. 20 MB üzerindeki satır içi veriler için Cloud Storage URL'leri kullanın.
- Taşımayı şu sırayla yapın. Excel bölücülerini
sheetIndexvevisibleCellskullanımına geçirin; rapor rasterleştiricilerinde sayfa aralıklarıylaPAGE_TEXTkullanın,PAGE_IMAGE'ı düzen gerektiğinde ayırın; dosyanın tamamını döndüren araç yanıtlarını dilimlenmiş işlev yanıtlarına taşıyın.
Kaynakların açıkta bıraktığı noktalar da var: Gizli satırlar, birleştirilmiş hücreler, grafikler, gömülü görseller ve parola korumalı, makro etkin veya bozuk dosyaların nasıl işlendiği, yukarıda bağlantısı verilen dilimleme duyurusunda ya da Firebase girdi gereksinimleri sayfasında belirtilmiyor. Bunları kendi şablonlarınızla test edin.
Sık sorulan sorular
FunctionResponse içinde de içerik dilimleyebilir miyim?
Evet. Araçlar, bir dosya URI'siyle birlikte SpreadsheetMetadata veya DocumentMetadata döndürebilir. Böylece model yalnızca ilgili alıntıyı görür; bu da aracıların belge iş akışları için uygun bir yapı sunar.
Dilimleme hangi API sürümünde destekleniyor?
Discovery 20261116 revizyonunun v1beta ve v1alpha sürümlerinde gözlemlendi; kararlı v1 sürümünde bulunmuyor. Sürümleri sabitleyin ve üretime geçmeden önce hedef modelinizde test edin.
Gemini neden yüklediğim dosyayı göremediğini söylüyor?
MIME türünü, dosya boyutunu ve açıkça belirtilmiş seçicileri yukarıdaki tablo ve sınırlarla karşılaştırarak kontrol edin. Ardından ayrıştırmanın başarılı olduğunu doğrulamak için modelden sayfa adlarını veya sayfa sayılarını tekrarlamasını isteyin.
İlgili içerik: Office işlem hattınızın arkasında hangi modeli kullanacağınızı seçmek için Gemini 4 Carbon ve Hydrogen API rehberi.