 AIREITER
Toplamda 594B parametre taşıyıp token başına yalnızca 17B parametreyi etkinleştiren bir model, kâğıt üzerinde oldukça cazip görünüyor. Inkling 2 Small, 1 milyon giriş tokenı için 0,30 $ ile ucuz bir seçenek; ancak bugün yalnızca Tinker üzerinden erişilebiliyor ve kodlama liderliğini DeepSeek-V4.1-Flash-1017'ye bırakıyor. Dolayısıyla kullanım gerekçesi, lansman duyurusunun ilk bakışta verdiği izlenimden daha dar. Bu değerlendirme lansman raporu ve Tinker fiyatlandırmasına dayanıyor; henüz bağımsız gecikme ve çıktı testleri yapmak mümkün değildi.
Inkling 2 Small tam olarak ne sunuyor?
Thinking Machines Lab'in 5 Kasım 2026'da duyurduğu Inkling 2 Small, ikinci nesil küçük Mixture-of-Experts modeli. Model; 594B toplam parametreyi 17B etkin parametreyle bir araya getiriyor, metin ve görsel girdileri kabul ediyor ve uzun soluklu ajan görevlerinde değişken muhakeme eforu sunuyor (Thinking Machines Lab).
| Özellik | Inkling 2 Small |
|---|---|
| Mimari | Mixture-of-Experts |
| Toplam / etkin parametre | 594B / 17B |
| Girdi türleri | Metin + görsel (ses yok) |
| Muhakeme kontrolü | Değişken efor (0.99 / xhigh ile benchmarklandı) |
| Görüntü kodlayıcı | 292M parametre, 20x20 patch, 2x2 pooling |
| Sayı formatı | NVIDIA GB300 NVL72 üzerinde NVFP4 |
| Eğitim bağlamı | Compaction ile 256K token (benchmark rotaları 1M'e kadar) |
| Artificial Analysis Index | 31 (duyuruya göre) |
Tinker, 594B'lik toplam ağırlık boyutuna rağmen modeli küçük model fiyatlandırmasıyla sunuyor.
Bugün nasıl denenir: yalnızca Tinker, ağırlıklar gelecek hafta
Inkling 2 Small şu anda yalnızca Thinking Machines Lab'in Tinker platformunda kullanılabiliyor: Playground, fine-tuning ve sampling erişimi var. İndirilebilir ağırlıklar henüz yayınlanmadı; tam checkpoint'lerin, harici güvenlik testleri ve red-teaming sürecine bağlı olarak gelecek hafta Apache 2.0 lisansıyla gelmesi planlanıyor (Thinking Machines Lab).
Pratikte bunun üç sonucu var:
- Lansman duyurusu yalnızca Tinker erişimini kapsıyor; resmi bir Hugging Face veya GGUF sürümü ile üçüncü taraf sağlayıcı rotası duyurulmuş değil.
- İlk checkpoint'ler OpenCode üzerinden Fledge-Alpha adıyla herkese açık biçimde test edildi (Thinking Machines Lab). Bu nedenle Fledge-Alpha etiketli topluluk kayıtları bu model ailesine işaret ediyor.
- Kendi altyapısında çalıştırmayı planlayanların beklemesi gerekiyor: lansman materyallerinde throughput veya ilk tokena kadar geçen süre verisi yok; resmi VRAM tavsiyesi ya da quantization tarifi de paylaşılmış değil.
Tinker fiyatları ve asıl önemli karşılaştırma
Inkling 2 Small için serverless inference, 256K bağlamda 1 milyon giriş tokenı başına 0,30 $, önbellekten gelen giriş için 0,03 $ ve çıkış için 1,00 $ tutuyor. Thinking Machines Lab'in barındırılan üç modeli arasında bunlar en düşük serverless çıkış ve önbellekli giriş fiyatları (Thinking Machines Lab).
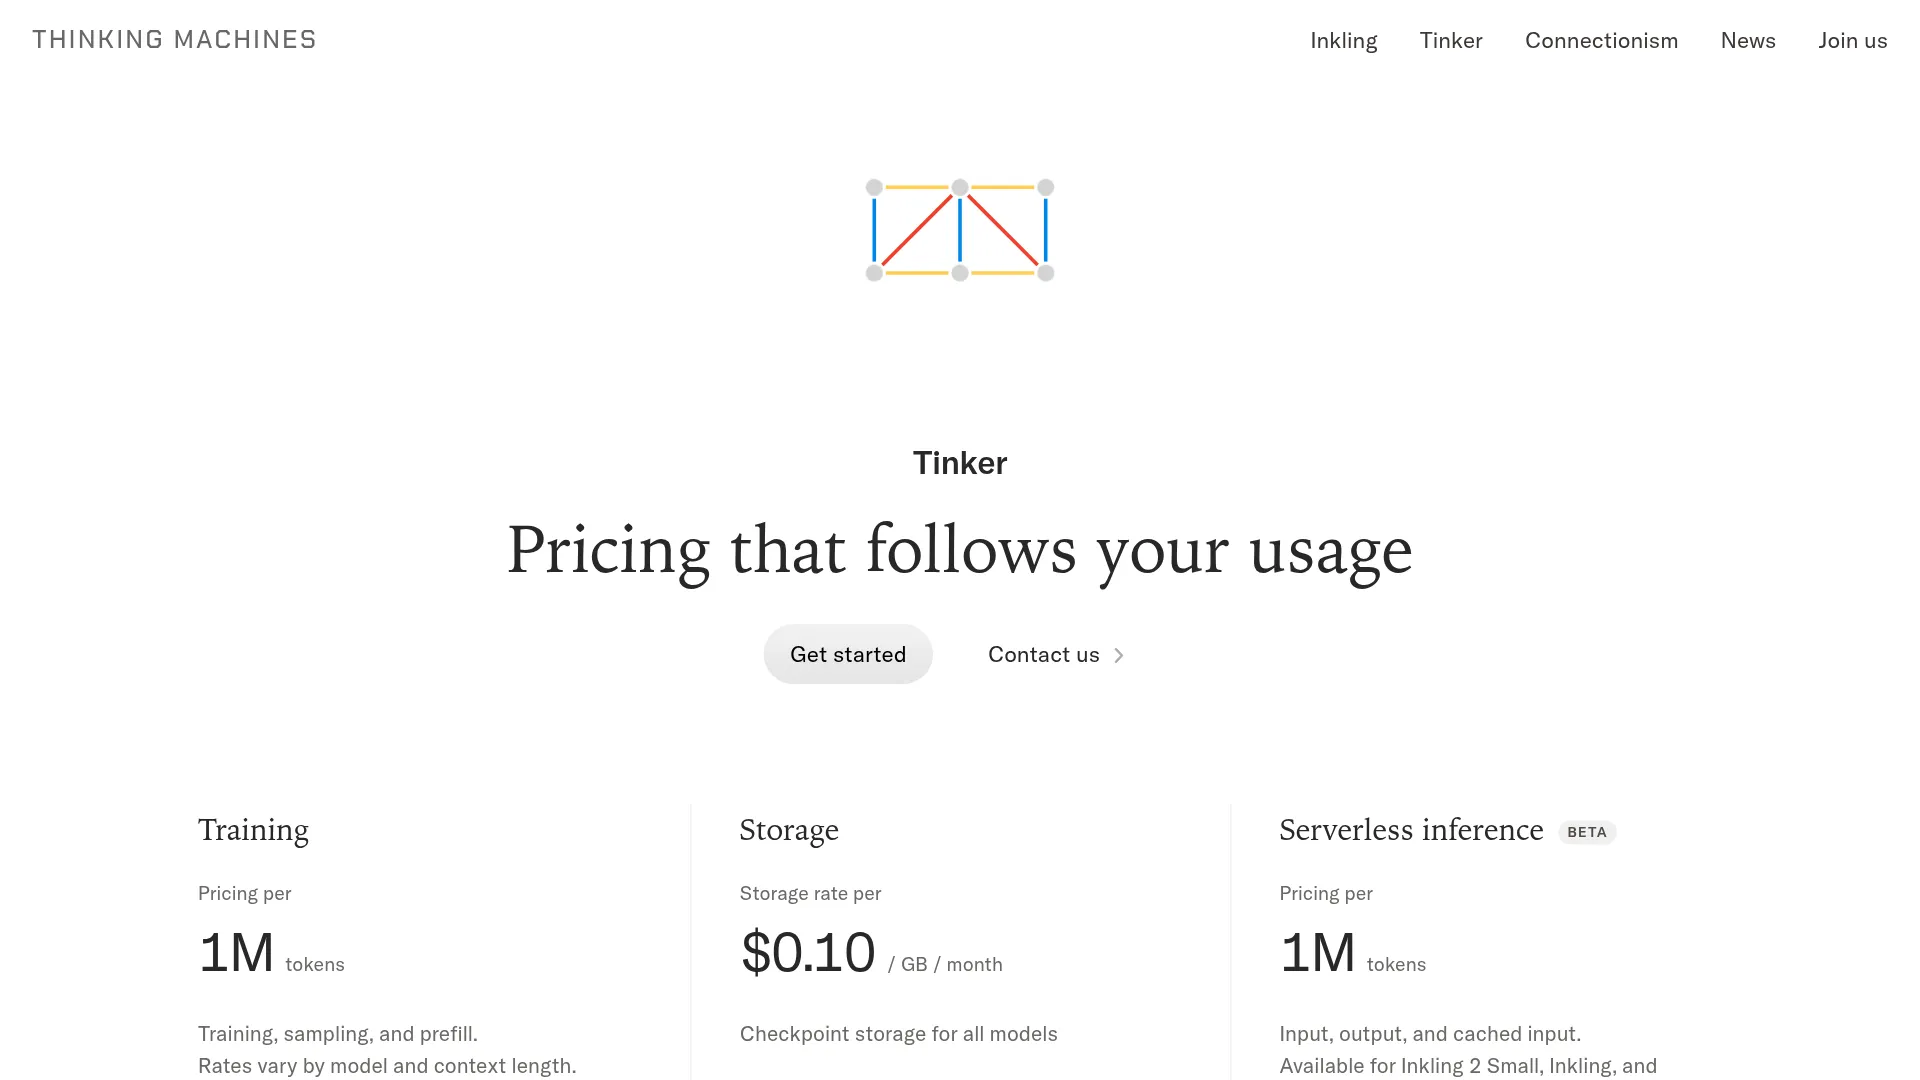
| Model (serverless, 256K) | Giriş / 1M | Önbellekli / 1M | Çıkış / 1M |
|---|---|---|---|
| Inkling 2 Small | $0.30 | $0.03 | $1.00 |
| Inkling-Small (gen 1) | $0.30 | $0.06 | $1.20 |
| Inkling (flagship) | $1.00 | $0.17 | $4.05 |
Önbellek isabet oranı %80 olduğunda, 1 milyon giriş tokenının maliyeti yaklaşık 0,084 $ oluyor: 200K x 0,30 $ artı 800K x 0,03 $. Bu yapıdan en çok uzun compaction rotaları faydalanıyor; sağlayıcının bildirdiği verilere göre bu eğitim düzeninde medyan rota 43K token, p99 ise 1,5M token seviyesinde (Thinking Machines Lab).
Benchmark sonuçları: güçlü olduğu alanlar ve DeepSeek Flash'ın öne geçtiği yerler
Aşağıdaki skorlar, kazanımların yanında kayıpları da açıklayan sağlayıcının rapor kartından alındı (Thinking Machines Lab).
| Benchmark | Inkling 2 Small | Tablodaki en iyi rakip |
|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72.1% | 77.0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86.3% | 88.2% Kimi K3 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28.7% | Grubun lideri (Kimi K3 26.9%) |
| LongBench v2 | 70.6% | Grubun lideri (Kimi K3 69.0%) |
| AA-Omniscience (skor / halüsinasyon yapmama) | 16.1 / 73.3% | Gruptaki en yüksek halüsinasyon yapmama oranı |
| DesignArena Web snapshot | 1,340 (3.) | 1,366 Muse Wonder (lider) |
| JobBench / Vals Legal / Vals Finance | 70.5% / 73.9% / 61.5% | Gösterilen grupların lideri |
| Terminal Bench Science | 5.7% | 12.9% DeepSeek-V4.1-Flash-1017 |
LongBench v2'deki %70,6'lık sonuç uzun bağlam iddiasını desteklerken, HLE-Diamond'daki %28,7 zor muhakeme senaryolarında liderliği gösteriyor. CoreCraft'ta %71,8 ve DAYJOB Finance'te %14,3 alan model; JobBench ve Vals ile birlikte kurumsal kategorilerde de gösterilen gruplara liderlik ediyor. Buna karşılık bazı önemli çekinceler var: DiligenceBench'te %58,1 ile Muse Spark Open'ın %59,0'ının gerisinde; kernel autoresearch'te Claude Opus 5.5'in 18.80x sonucuna karşı 6.02x elde ediyor. Laboratuvar ayrıca ayrıntıcılık, tutarsız organizasyon, kusurlu araç seçimi ve aşırı ret eğilimini de kabul ediyor; FORTRESS sonucu 20.4 iken GLM-5.3'te bu değer 3.2.
Inkling-Small'dan neler değişti?
Toplam parametre sayısı 276B'den 594B'ye, etkin parametre sayısı ise 12B'den 17B'ye çıkarak iki katın üzerine geçti. Halüsinasyon davranışı iyileşti, ancak ses girdisi kaldırıldı. Yeni model yalnızca metin ve görsel alıyor; ilk nesil ise 16 kHz WAV kabul ediyordu (Thinking Machines Lab).
Sağlayıcının verilerine göre olgusallık tarafı daha iyi görünüyor, fakat iki nesil farklı metrikler raporluyor. İlk nesil, negatif Omniscience skoru ile birlikte yaklaşık %20,6 SimpleQA Verified sonucu vermişti (eesel AI). Inkling 2 Small'ın %73,3'lük halüsinasyon yapmama oranı kendi grubunda lider; buna rağmen laboratuvar, ayrıntıcılık ve aşırı ret sorunlarının sürdüğünü belirtiyor (Thinking Machines Lab).
İlk nesle ilişkin self-hosting raporları, v2 için değil yalnızca bağlam için değerlendirilmeli:
"Gave it a try in Unsloth Studio, at Q4K_XL. It's doing very well in multi-lingual conversation." — İlk nesil Inkling-Small yayın başlığında u/VotZeFuk (Reddit)
İlk neslin 89 GB'lik 2-bit tabanı, topluluğun Unsloth derlemelerinden geliyordu (eesel AI). Toplam 594B parametreli v2 için gereksinimler, ağırlıklar ve tarifler yayınlanana kadar bilinmiyor.
Ajanınız Inkling 2 Small'ı çağırmalı mı?
Yönlendirme kararı, toplam benchmark sıralamasından çok iş yükünün yapısına bağlı.
| İş yükünüz | Inkling 2 Small çağrılmalı mı? | Neden? |
|---|---|---|
| Görsel geri bildirimli, uzun soluklu kodlama ajanları | Tinker üzerinden deneyin | Compaction eğitimi ve görsel iterasyon döngüleri bu iş yüküyle örtüşüyor |
| Retrieval kullanan kurumsal araştırma, finans ve hukuk taslakları | Önce deneyin | Sağlayıcı tablolarında JobBench, Vals Legal/Finance ve DAYJOB Finance lideri; kendi dokümanlarınızda doğrulayın |
| Özetleme benzeri görevlerde fine-tuning | Deneyin (yalnızca sağlayıcı testi) | Sağlayıcının 200 adımlık testinde, ilk neslin nihai kalitesine 75 adımda ulaştı (Thinking Machines Lab) |
| En düşük hata oranıyla, yalnızca SWE-bench tarzı kodlama | Hayır, DeepSeek-V4.1-Flash-1017 | DeepSWE'de %72,1'e karşı %77,0; FrontierCode'da %25,4'e karşı %28,5 |
| Retrieval veya güvenlik katmanı olmadan olgusal soru-cevap | Hayır, henüz değil | Toplam 16.1 Omniscience skoru en iyi rakibin gerisinde; RAG ve güven düzeyine göre yönlendirme kullanmaya devam edin |
| Çok sağlayıcılı failover gereksinimleri | Hayır, bekleyin | Tek sağlayıcılı Tinker rotası var; üçüncü taraf rotaları duyurulmadı |
Uyumluluk skorları önceki modellerden iyileşmiş durumda: dahili kötü davranış skoru 66.8-75.2 aralığından 14.9'a indi ve düşük değer daha iyi. Ancak GPT-6.1 Sol'un 0.8 sonucunun gerisinde kalıyor (Thinking Machines Lab).
Inkling 2 Small hakkında sık sorulanlar
Inkling 2 Small'ın açık ağırlıkları yayınlandı mı?
Hayır. 5 Kasım 2026 itibarıyla ağırlıklar kapalı ve model Tinker üzerinden sunuluyor; güvenlik testlerinin ardından Apache 2.0 ağırlıklarının gelecek hafta gelmesi planlanıyor.
Inkling-Small'dan farkı ne?
594B/17B'ye karşı 276B/12B parametre yapısı, ses girdisinin kaldırılması, %73,3 halüsinasyon yapmama oranı ve 1 milyon token başına 1,20 $ yerine 1,00 $ çıkış fiyatı başlıca farklar.
API'nin 1 milyon token başına maliyeti ne kadar?
Tinker serverless'ta 256K bağlam için giriş 0,30 $, önbellekli giriş 0,03 $, çıkış ise 1,00 $.
Yerel olarak çalıştırabilir miyim?
Henüz hayır; ağırlıklar, çalışma tarifleri ve VRAM tavsiyeleri yayınlanmış değil.
İlgili okumalar: DeepSeek-V4.1-Flash-1017 kodlama incelemesi ve Kimi K3.1 Pro API fiyatlandırması.