 AIREITER
Dosyaları okuyup test çalıştıran, ardından sonucu iyileştirerek tekrar deneyen bir kodlama ajanı, çözülen her issue için 50.000 ila 200.000 token harcar. GPT-5.6 Sol'un milyon output token başına $30 fiyatıyla, yalnızca output token maliyeti görev başına $1.50 ile $6 arasına çıkabilir. DeepSeek V4 Pro ise output için $0.87/M listeliyor; yani yaklaşık 1/34 maliyetle çalışıyor. Ancak çok adımlı görevlerdeki güvenilirliği, Claude veya GPT kadar kapsamlı ve bağımsız biçimde henüz değerlendirilmiş değil. Aşağıda altı model; yayımlanmış kodlama benchmark'ları, doğrulanmış API ücretleri, bağlam sınırları ve en uygun ajan iş akışları üzerinden karşılaştırılıyor.
2026'da Kodlama Ajanları için Öne Çıkan Altı Model
Her model için resmi kaynaklardan veya leaderboard'lardan alınan benchmark verileri, Ağustos 2026'da doğrulanan API fiyatlarıyla birlikte ele alındı. Sıralanan modelin doğrudan yayımlanmış bir skoru yoksa, en yakın varyantın sonucu proxy olarak açıkça belirtiliyor.
1. Claude Opus 5 — Kalite Çıtasını Belirleyen Model
Claude Opus 5, Claude ailesinin resmi SWE-bench Verified leaderboard'ındaki liderliğini sürdürüyor. Önceki model Claude 4.5 Opus, mini-SWE-agent harness'iyle %76.8 elde etti. Opus 5'e özgü SWE-bench Verified sonuçları henüz yayımlanmadığı için bu skor, beklenen seviye açısından yararlı bir proxy niteliğinde. Opus 5, 1 milyon token bağlam penceresi ve en fazla 128K token output sunuyor. Milyon input token için $5, milyon output token için $25 ile bu listedeki ana akım seçeneklerin en pahalısı. Başarısız bir çok dosyalı refactor'ın insan emeği maliyeti token harcamasını aşıyorsa doğru tercih Opus 5'tir. Yüksek hacimli, rutin düzenlemeler içinse uygun değildir.
2. GPT-5.6 Sol — Terminal Odaklı Görevlerin Uzmanı
GPT-5.6 Sol (model ID gpt-5.6-sol), 1.05 milyon token bağlam penceresiyle milyon input token başına $5, milyon output token başına $30 fiyatlandırılıyor. xAI'ın yayımladığı benchmark karşılaştırmasına göre GPT-5.6 Sol Max, Terminal-Bench v3.0'da %34.6 ile lider konumda; Grok 4.6'nın skoru %26. DeepSWE v1.1'de de %73 elde ediyor. Bunlar, terminal üzerinden çalışan ajan döngüleri açısından en ilgili benchmark'lar. Bunun karşılığında Sol, $30/M output fiyatıyla listedeki en pahalı model. OpenAI ayrıca Sol için %64.6, orta seviye varyant Terra içinse %63.4 SWE-bench Pro skoru bildiriyor. Daha az zorlayıcı işler için daha uygun fiyatlı bir OpenAI seçeneği arayanlar açısından bu veriler yararlı olabilir.
3. Grok 4.6 — Uzun Süren Ajan İşlerinde Fiyat/Performans Seçeneği
Grok 4.6, 12 Ağustos 2026'da yayımlandı ve uzun soluklu ajan iş akışları için tasarlandı. xAI duyurusuna göre Artificial Analysis Intelligence Index'te 61 puanla GPT-5.6 Sol Max ile eşit durumda. CursorBench v3.2'de (%69.9'a karşı %67.2), FrontierCode v1.1'de (%61.3'e karşı %60.6) ve APEX-Agents'ta (%57.5'e karşı %56.7) ise onu geride bırakıyor. Milyon input token başına $2 ve milyon output token başına $6 fiyatıyla, GPT-5.6 Sol Max'e yakın benchmark performansını output maliyetinin yaklaşık beşte biriyle sunuyor. Zayıf noktası ham terminal yürütme performansı: Terminal-Bench v3.0'da %26 alıyor; Sol Max'in %34.6'sının belirgin biçimde gerisinde. Ajan iş akışınız terminal öncelikli değil de IDE merkezliyse (Cursor, Grok Build), Grok 4.6 bu listedeki en güçlü kalite/fiyat seçeneği. Daha düşük gecikme sunan "fast" varyantı, fiyatı $4/$12'ye çıkarıyor. Bağlam penceresi 500K token.
4. DeepSeek V4 Pro — Bütçe Dostu İş Yükü Modeli
DeepSeek V4 Pro, API üzerinden sunulan frontier seviyesindeki en ucuz model: milyon input token için $0.435, milyon output token için $0.87. Önbellekten gelen input'ta fiyat $0.003625/M seviyesine iniyor. 1 milyon token bağlam penceresi ve 384K token maksimum output kapasitesi, modeli repo ölçeğindeki işler için kullanılabilir kılıyor. DeepSeek V4 Pro'yu Claude veya GPT ile aynı harness derinliğinde değerlendiren yayımlanmış bir çok adımlı ajan benchmark'ı bulunmadığından, uzun oturumlardaki tool-call güvenilirliğini karmaşık refactor'larda kullanmaya karar vermeden önce kendi ortamınızda doğrulamalısınız. Bütçesi sınırlı ekipler veya yönlendirmeli bir kurulumda ilk geçiş modeli arayanlar için ekonomik tarafı oldukça güçlü. Token maliyetinden çok güvenilirliğin önem taşıdığı en zorlu çok dosyalı refactor'larda ise daha üst bir modele geçmeniz gerekebilir.
5. Gemini 3.1 Pro — Büyük Bağlamda Kod Okuma İçin
Google'ın Gemini 3.1 Pro Preview modeli, 200K token'ın altındaki prompt'lar için milyon input token başına $2, milyon output token başına $12 fiyatla sunuluyor; bu eşik aşıldığında fiyat $4/$18'e yükseliyor. Modelin öne çıkan yanı bağlam kapasitesi: Gemini'nin 2 milyon tokenlık bağlam penceresi, burada listelenen modeller arasındaki en büyük değer. Bu sayede tüm kod tabanını tek seferde yükleyerek repo genelinde okuma yapılacak işler için uygun. Tembo'nun Haziran 2026 tarihli incelemesinde, 3.1 Pro'nun beklenen seviyesine proxy olarak Gemini 3 Flash, SWE-bench Verified'da %75.8 ile Claude 4.5 Opus'un ardından ikinci sırada yer aldı. Gemini'nin uzun ajan döngülerindeki tool-calling tutarlılığı, Claude veya GPT seviyesinde derinlikte benchmark'lanmış değil; çok adımlı iş akışlarında kullanmadan önce kendi harness'inizde test etmeniz gerekir.
6. Kimi K3 — Open-Weight Ajan Alternatifi
Moonshot AI'ın Kimi K3 modeli, aynı Haziran 2026 incelemesinde SWE-bench Verified'da %70.8 aldı. Bu skor, open-weight modeller arasında GLM-5'in (%72.8) ve MiniMax M2.5'in (%75.8) altında kalıyor. Open-weight bir model olduğu için kodunu ağ dışına çıkaramayan ekipler tarafından self-host edilebilir. Moonshot'ın barındırılan API'si de K3 sunuyor; net fiyatlandırma seçilen dağıtım yapılandırmasına bağlı. Yeterli GPU donanımına sahip yerel ajan kurulumlarında, Kimi K3'ü OpenCode gibi hafif bir harness ile eşleştirmek, token başına API maliyeti olmadan yetenekli bir kodlama ajanı sağlar.
API Fiyatları ve Tamamlanan Görev Başına Maliyet
Token başına fiyatlar tablonun yalnızca bir kısmını gösterir. Esas metrik, bir ajan döngüsüyle gerçek bir GitHub issue'sunu çözmek için harcadığınız tutar, yani tamamlanan görev başına maliyettir.
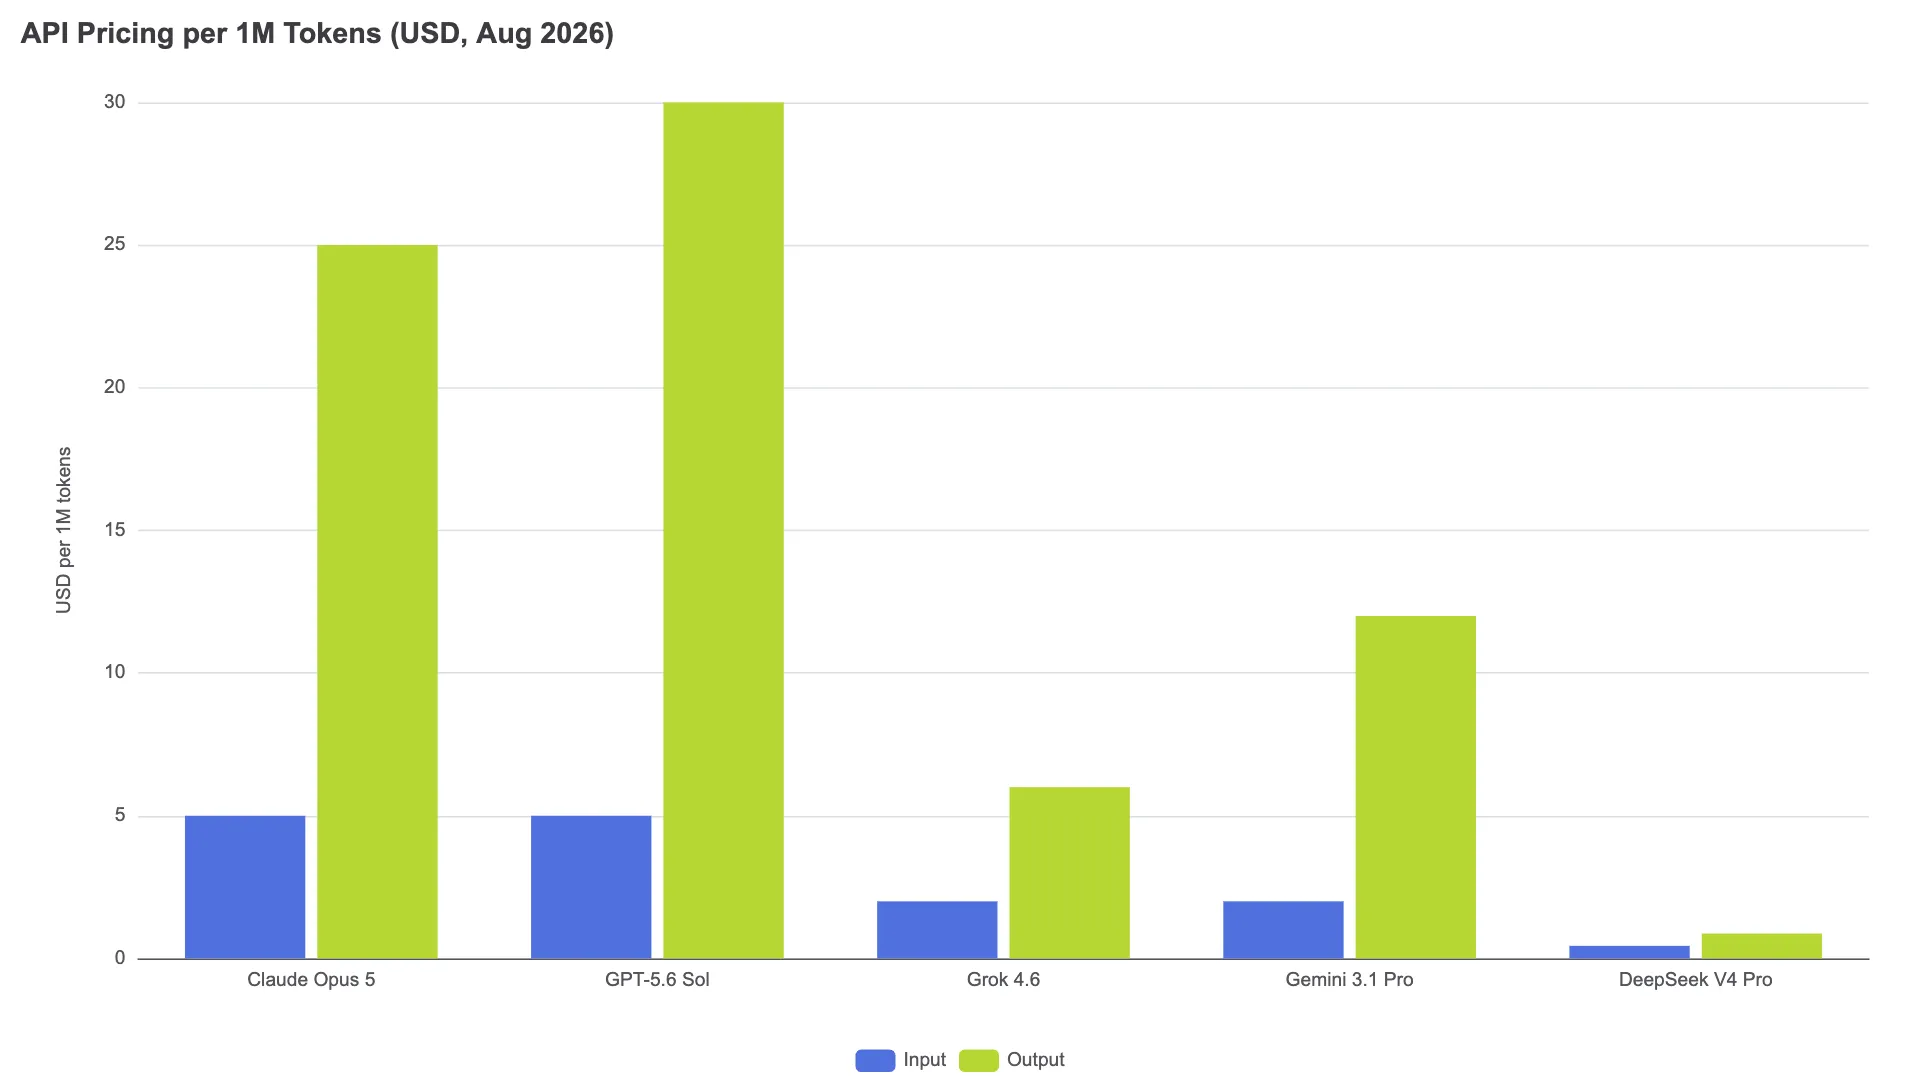
Tipik bir ajan döngüsü; dosyaları okuma, planlama, düzenleme, testleri çalıştırma ve başarısızlıkları düzeltme aşamalarında çözülen issue başına yaklaşık 50K–200K token tüketir. Output, toplam token miktarının %30–50'sini oluşturur. Bu değerler, Tembo'nun ajan döngüsü analizleri ve diğer kaynaklardan alınan sektör tahminleridir; gerçek tüketim repo boyutuna, test paketinin uzunluğuna ve harness verimliliğine bağlıdır. Toplam 125K tokenlık orta noktayı baz alırsak (75K input, 50K output), çözülen tek bir issue'nun model başına maliyeti şöyle:
| Model | Input Maliyeti | Output Maliyeti | Görev Başına Toplam |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3, maliyeti tamamen Moonshot'ın barındırılan API'sini kullanıp kullanmadığınıza veya kendi GPU'larınızda self-host edip etmediğinize bağlı olduğu için bu tabloya dahil edilmedi. Karşılaştırılabilecek tek bir liste fiyatı yok. Grok 4.6, $0.45 ile dengeli bir noktada konumlanıyor: GPT-5.6 Sol Max ile aynı Artificial Analysis Intelligence Index skorunu, Sol'un görev başına maliyetinin yaklaşık dörtte biriyle yakalıyor.
Bu tahminlere yeniden denemeler, önbelleğe alınmış token indirimleri, tool-call ek yükü ve altyapı maliyetleri dahil değil. Daha fazla yeniden deneme veya insan düzeltmesi gerektiren bir model, token başı fiyatının gösterdiğinden pratikte daha pahalıya gelir. Bu nedenle rutin işleri DeepSeek veya Grok'a gönderip zor refactor'ları Opus'a yükselten bir yönlendirme yaklaşımı, tek modele bağlı kalmaktan daha iyi sonuç verebilir.
Hangi Kodlama Ajanı İş Akışında Hangi Model Kullanılmalı?
Her iş akışına uyan tek bir model yok. Aşağıdaki öneriler, farklı ajan görevleri için doğru modeli seçmenize yardımcı olur.
Hızlı döngüler ve rutin düzenlemeler. Hata açıklamaları, küçük fonksiyon eklemeleri, test taslakları ve dokümantasyon güncellemeleri gibi yüksek frekanslı, düşük riskli işler için Gemini 3.5 Flash ($1.50/$9 per M tokens) veya Claude Sonnet 5 kullanın.
Derin refactor ve mimari kararlar. Çok dosyalı değişiklikler, modüller arası bağımlılıklar ya da yanlış bir varsayımın saatlerce debug süresine mal olacağı mimari kararlar söz konusuysa Claude Opus 5 öne çıkar. Uzun oturumlarda talimatlara hassas uyumu ve bağlam tutarlılığını koruması, temel fark yaratan özelliğidir.
Uzun süre çalışan otonom ajanlar. Grok 4.6 tam olarak bu kullanım senaryosu için geliştirildi. xAI duyurusuna göre geliştirme sürecinde, kendi kendini kontrol eden davranışlarla sürdürülebilir ajan rotalarına odaklanıldı. Görev başına $0.45 maliyet, GPT-5.6 Sol'un görev başına $1.88 fiyatının yarattığı baskı olmadan ajanın daha uzun çalışmasına olanak tanır. Terminal ağırlıklı iş akışlarında ise GPT-5.6 Sol'un Terminal-Bench liderliği (%34.6), onu daha güvenli seçenek haline getiriyor.
Bütçe odaklı ve self-hosted kurulumlar. Maliyet hassasiyeti yüksek ekipler için API üzerinden DeepSeek V4 Pro, görev başına $0.077 ile varsayılan tercih. Kodlarını harici API'lere gönderemeyen kurumlar ise Kimi K3 (%70.8 SWE-bench Verified) veya MiniMax M2.5 (%75.8) gibi open-weight bir modeli self-host edebilir. Open-weight alanı, SWE-bench Verified'da closed-weight liderlerle arasındaki farkı birkaç yüzde puana kadar indirmiş durumda.
Harness Etkisi: Ajan Aracı Modeli Sınırlayabilir
Ajanınızın kullandığı harness — Claude Code, Codex CLI, Cursor veya OpenCode gibi açık kaynaklı bir araç — modelin kontrol edemediği dört unsuru belirler: bağlam yönetimi, yani ne zaman sıkıştırma yapılacağı ve nelerin saklanacağı; tool tanımları ve yönlendirme; hata kurtarma kalıpları; inceleme/onay akışları. Tembo analizinin de belirttiği gibi, mini-SWE-agent gibi kontrollü bir harness altında elde edilen benchmark skoru, farklı yapılandırılmış gerçek bir ortamda aynı modelin issue çözme oranını yansıtmayabilir. Bu yüzden harness'i sabit tutan benchmark'lar, model ve harness kazanımlarını birbirine karıştıran üretici kaynaklı skorlarla kıyaslandığında modelleri karşılaştırmak için daha değerlidir.
Model değiştirmeden önce harness'inizi denetleyin. Ajanınızın bağlamı etkili biçimde sıkıştırıp sıkıştırmadığını, tool tanımlarının temiz olup olmadığını ve hata kurtarma mekanizmasının döngüye girmek yerine mantıklı şekilde yeniden deneyip denemediğini kontrol edin.
Sık Sorulan Sorular
Kodlama ajanları için en ucuz LLM hangisi?
Milyon input token başına $0.435 ve milyon output token başına $0.87 fiyatıyla DeepSeek V4 Pro, frontier seviyesindeki en ucuz seçenek. Çözülen bir ajan görevi için maliyet yaklaşık $0.08.
Kodlama ajanı modellerini kendi repomda nasıl test ederim?
Gerçek backlog'unuzdan hata düzeltmeleri, özellik geliştirmeleri ve refactor işleri içeren 20–30 temsilî issue seçin. Her modeli, tercih ettiğiniz harness üzerinden aynı görevlerde çalıştırın. Üç metriği takip edin: çözüm oranı (ajanın ürettiği patch testlerinizi geçti mi?), görev başına token tüketimi ve tamamlanma süresi. Repoya özgü bu değerlendirme, herkese açık herhangi bir benchmark'tan daha öngörücüdür.