 AIREITER
Liquid AI'nin barındırılan API'si, milyon giriş token'ı başına 0,04 $ fiyatıyla hâlâ en zahmetsiz seçenek. Ancak yeni açık ağırlıklı kontrol noktaları, modelleri yerelde çalıştırmayı da gerçekçi kılıyor. Buradaki kritik nokta, 3B ve 600M modelleri arasındaki kalite farkının oldukça belirgin olması.
Üç Liquid d1 seçeneği aynı iş için bire bir alternatif değil
Liquid AI şu anda üç önemli seçenek sunuyor: mülkiyeti şirkete ait barındırılan d1 hizmeti, açık ağırlıklı d1-3B ve deneysel açık ağırlıklı d1-omni-600M. Liquid AI, barındırılan modelinin indirilebilen iki kontrol noktasından biriyle aynı olduğunu belirtmiş değil. Bu nedenle kıyaslama ve gecikme verilerini, mutlaka elde edildikleri modelle birlikte değerlendirmek gerekiyor.
| Seçenek | Erişim ve fiyat | Girdiler | Açıklanan bağlam | En uygun kullanım |
|---|---|---|---|---|
Barındırılan d1 | Liquid API; 1M giriş token'ı için 0,04 $, çıkış token'ı ücreti yok | Liquid üzerinden doğrudan metin ve görsel | Vercel tarafından 66K olarak listeleniyor | Hızlı entegrasyon, ihmal edilebilir çıkarım maliyeti, model operasyonu yok |
d1-3B | İndirilebilir ağırlıklar; token başına model ücreti yok | Metin, JSON ve görseller | 32.768 token | En yüksek yerel kalite, görüntü desteği, üretim değerlendirmesi |
d1-omni-600M | İndirilebilir deneysel ağırlıklar; token başına model ücreti yok | Metin + görsel veya metin + ses | 16.384 token | Küçük ayak izi, sesli komut denemeleri, kısıtlı uç cihazlar |
Üç model de serbest biçimli metin üretmek yerine yazılı sorulara yanıt veriyor. noul evet olasılığı döndürüyor; choice, adlandırılmış seçenekler için olasılıklar sağlıyor; score ise sıralı bir değerlendirme ölçeğindeki olasılık ağırlıklı konumu veriyor. Bu modeller yönlendirme, moderasyon, denetim, güvenlik katmanları ve puanlama için uygun; sohbet veya kodlama modellerinin yerini tutmuyorlar.
Öneri net: bir pilot çalışma için barındırılan d1 kullanın. Verinin yerelde kalması gerekiyorsa ya da ağ gecikmesini ortadan kaldırmak istiyorsanız d1-3B'yi seçin. Ses desteği veya küçük ayak izi belirleyici bir gereksinim değilse, d1-omni-600M'yi deneysel bir seçenek olarak görün.
API ücreti mi, yerel çalıştırma maliyeti mi?
Liquid AI d1 API, milyon giriş token'ı başına 0,04 $ ücretlendiriliyor. Hizmet metin üretmek yerine karar döndürdüğü için çıkış token'ı ücreti bulunmuyor. 100 milyon giriş token'lık bir iş yükü, ağ geçidi ücretleri hariç 4 $ tutuyor; bir milyar giriş token'ı ise 40 $ maliyet çıkarıyor.
Token başına 0,04 $ seviyesinde, yalnızca çıkarım maliyeti açısından bakıldığında kendi altyapınızda barındırmak nadiren avantajlı olur. Yerel kurulumu gizlilik, çevrimdışı kullanım, cihaz üzerindeki gecikme, özelleştirme veya sürekli yüksek kullanım için tercih etmek daha mantıklı.
İki açık kontrol noktası için resmî bir barındırılan token fiyatı yok. İnceleme sırasında Hugging Face sayfalarında bir çıkarım sağlayıcısı görünmüyordu. Dolayısıyla barındırılan d1 fiyatı, d1-3B veya d1-omni-600M fiyatı gibi sunulmamalı.
Barındırılan hizmette görseller de giriş olarak ücretlendiriliyor. Liquid AI, her 32×32 piksellik parça için 1,5 token hesaplandığını belirtiyor; bu da 1024×1024 piksellik bir görseli, soru metninden önce 1.536 token'a getiriyor. 0,04 $/M fiyatla görsel kısmının maliyeti yaklaşık 0,00006144 $ oluyor. Her soru ayrı bir istem olarak ücretlendiriliyor ve ilişkili görselini de içeriyor.
Açık ağırlık, sınırsız kullanım veya sıfır maliyet anlamına gelmiyor
Her iki depo da Apache 2.0 ya da MIT yerine Liquid AI'nin lfm1.0 lisansını kullanıyor. Liquid AI'nin genel fiyatlandırma koşulları, indirilebilir modellerin yıllık şirket geliri 10 milyon $'ın altında olan işletmeler için ticari kullanımda ücretsiz olduğunu söylüyor. Daha büyük kuruluşlar, “açık ağırlıklı” ifadesinden izin çıkarımı yapmak yerine güncel ticari koşulları doğrulamalı.
Yerel bütçeyi hesaplarken GPU veya cihaz alımı, atıl kapasite, izleme, güncellemeler ve ekip zamanını da dahil edin. Barındırılan hizmetin faturası değişken ve çok düşük; yerel çözümün maliyeti ise ağırlıklı olarak sabit.
Kalite için d1-3B, küçük ayak izi için omni
Resmî Open d1 duyurusunda, Decision Index v0.2.1 skoru d1-3B için 48,57, d1-omni-600M için ise 15,95 olarak veriliyor. Liquid AI iki modeli de resmî değerlendiriciyle çalıştırdı; ancak sonuçlar resmî liderlik tablosu başvuruları değildi.
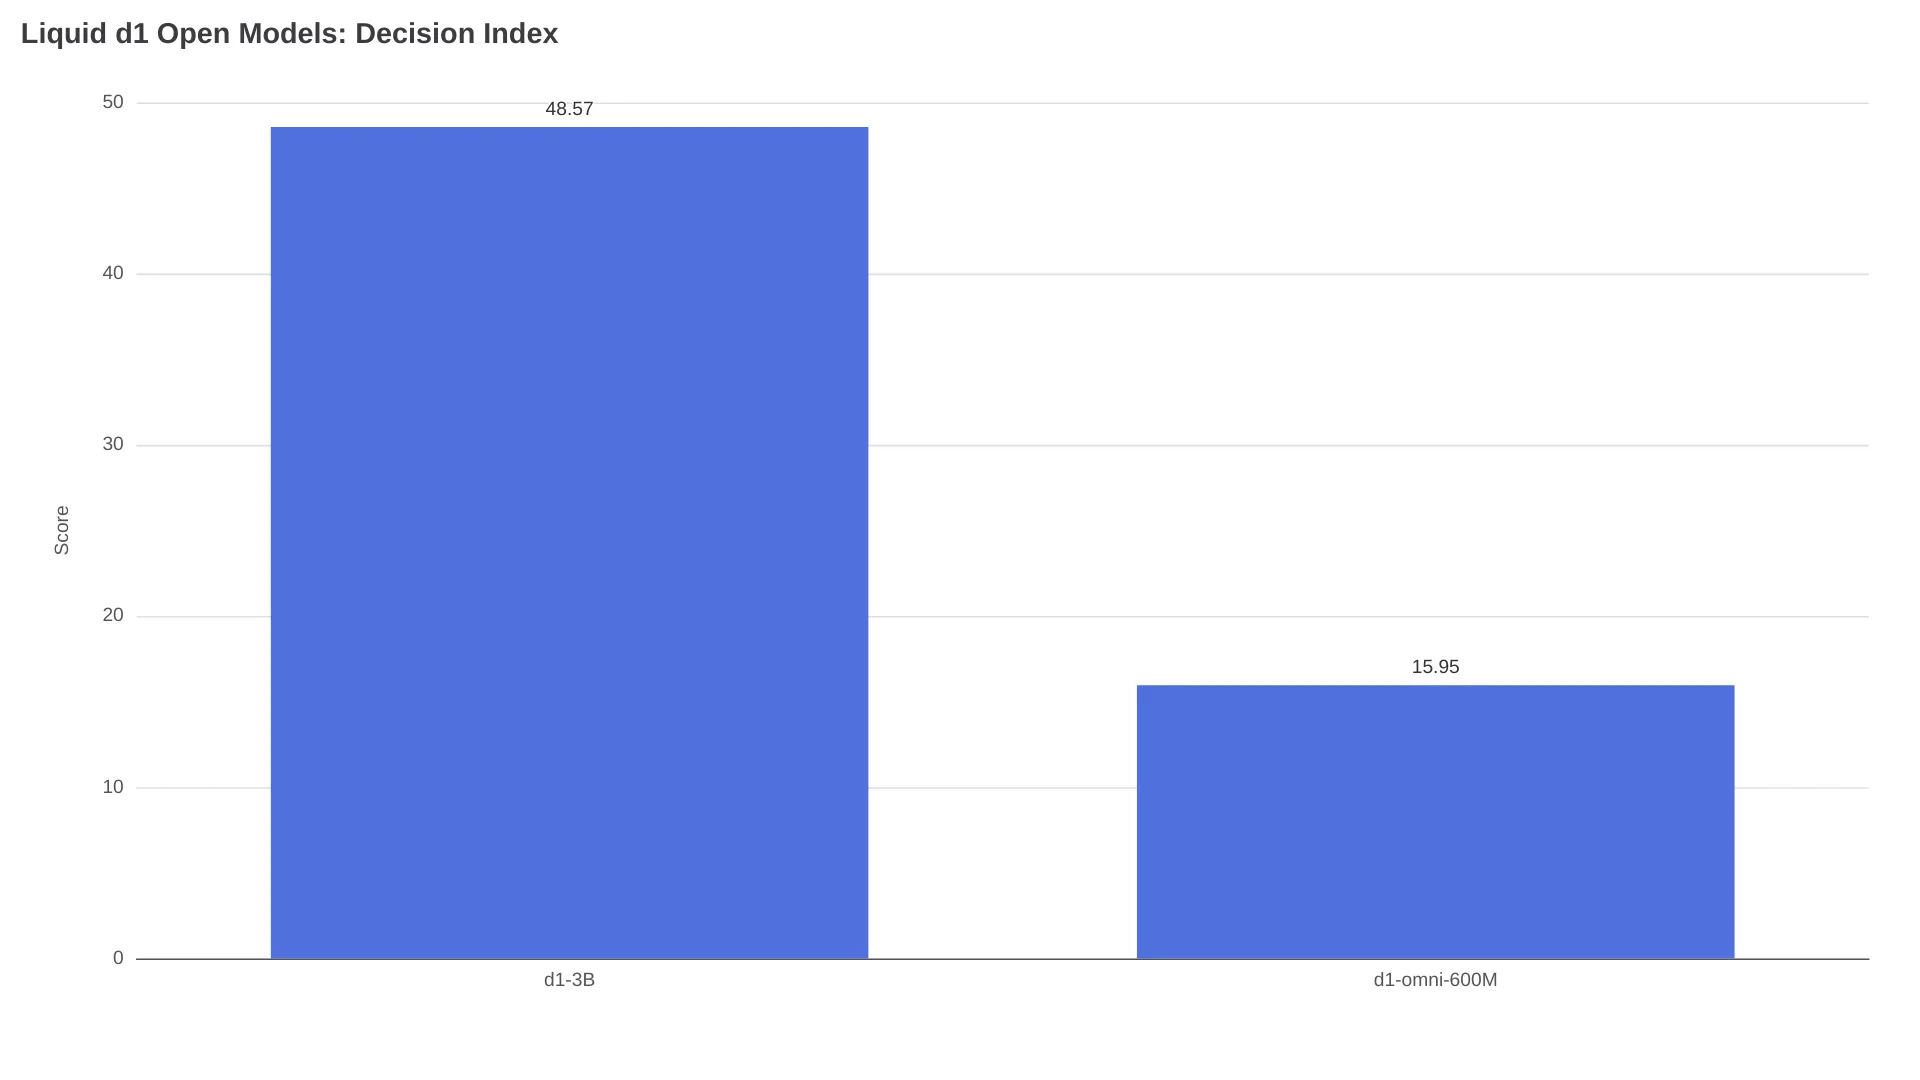
Küçük model her alanda zayıf değil. Liquid AI, yedi açık metin kıyaslamasında d1-3B için 82,9; d1-omni-600M için 78,4 ortalama raporluyor. Omni, Civil Comments'te 95,8'e 93,0 ve PAWS-X'te 79,5'e 76,9 ile öne çıkarken; 3B, listelenen diğer beş görevde lider. Decision Index'teki çok daha geniş fark, belirli sınıflandırma kesitlerindeki güçlü sonuçların 600M kontrol noktasını 3B'nin genel amaçlı alternatifi yapmadığını gösteriyor.
| Özellik | d1-3B | d1-omni-600M |
|---|---|---|
| Ayrıntılı parametre sayısı | 3,12B | 587M |
| Tam hassasiyetli depo/ağırlık boyutu | 6,27 GB depo; 6,25 GB ağırlık | F32 model, yaklaşık 0,6B parametre |
| Bağlam | 32.768 | Modeller arasında paylaşılan 16.384 |
| Görselle birlikte metin sınırı | Model bağlamı içinde | Görsellerle birlikte durum ve soru metni 896 token'a kesiliyor |
| Ses | Yok | En fazla 30 saniyelik, 16 kHz mono tek klip |
| Görsel + sesi birlikte kullanma | Uygulanamaz | Desteklenmiyor; ValueError oluşturuyor |
| Resmî hız tablosu | Evet | Hayır; erken araştırma sürümü |
d1-omni-600M model kartı, modelin float32 ile eğitildiğini belirtiyor. Float16, 243 metin, 214 görsel ve 416 ses satırında en üstteki yanıtı korurken; bfloat16, metin satırlarının %0,8'inde ve ses satırlarının %1,7'sinde en üstteki yanıtı değiştirdi. Bu da veri türünü yalnızca bir optimizasyon tercihi değil, doğrulanması gereken bir değişken hâline getiriyor.
Yerel kurulum kısa sürüyor, doğrulama süreci ise uzun
Her iki model kartında da tek durum için system_one, paketlenmiş istekler içinse system_one_batch sunuluyor. d1-3B için en kısa yol; Transformers 5.14 veya üzeri, PyTorch, TorchVision, Pillow ve depoda sağlanan özel kodu kullanıyor.
- Belgelerdeki bağımlılıkları yükleyin:
pip install "transformers>=5.14" torch torchvision pillow- Uzak depodaki kodu etkinleştirerek modeli yükleyin:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Sohbet istemi yerine adlandırılmış kararlar gönderin:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Bu talebi hangi ekip ele almalı?",
        "criteria": {
            "billing": "Ücretlendirmeler, faturalar ve iadeler",
            "technical": "Uygulama veya web sitesi arızaları",
            "fraud": "Şüpheli yetkisiz kullanım",
        },
    }
}

result = model.system_one(
    "Bu ay hesabımdan iki kez ücret alındı; birini iade edin.",
    questions,
)
print(result["answers"]["queue"])trust_remote_code=True, deponun Python kodunun sunum sürecinde çalıştırılması demek. Üretimde hareketli bir dalı yüklemek yerine, gözden geçirilmiş bir commit'i sabitleyin. d1-3B deposu ayrıca llama.cpp, Ollama ve LM Studio uyumlu çalışma zamanları için kuantizasyonlara bağlantı veriyor. Topluluk tarafından oluşturulmuş kuantize bir paket, resmî BF16 ağırlıklardan ayrı bir tedarik zinciri ve doğruluk kararıdır.
d1-3B model kartı, bir soru için ısınmış çağrı sürelerini RTX 4090'da 8 ms, Apple M5 Pro'da 30 ms ve Jetson Orin Nano'da 50 ms olarak bildiriyor. 3,4K token'lık bir durum, aynı cihazlarda sırasıyla 102 ms, 640 ms ve 1.640 ms sürdü. GPU değerleri 20 çalıştırmanın medyanı; 4090'daki 8 ms sonucu derlenmiş CUDA grafikleriyle alındı ve yeni bir giriş şekli derleme veya çekirdek seçimi ek yükü getiriyor.
d1-omni-600M için resmî bir hız tablosu bulunmuyor. Bir tarayıcı portu, dört karar için yorum başına yaklaşık 180 ms bildirdi:
“Henüz başka makinelerde test etmedim, yalnızca MBP M4 Pro'mda denedim.” — Reddit'te u/FinancialAd1961
Bu tek cihaz sonucu, tarayıcıda çalışmanın mümkün olduğunu gösteriyor; farklı tarayıcılar, GPU'lar, kuantizasyonlar veya toplu istek boyutları için performans kanıtı sunmuyor.
API kullanımı kolay, ancak model kimliği yine önemli
Doğrudan barındırılan erişimde d1 modeli, https://api.liquid.ai/decisions/v1/systemone adresinden kullanılıyor. Vercel tarafındaki model kimliği liquid/d1; sayfada 66K bağlam ve aynı 0,04 $/M giriş ücreti listeleniyor. Liquid'in 5 Ekim duyurusu, o noktada Vercel ve OpenRouter'ın yalnızca metni desteklediğini; doğrudan Liquid API'nin ise görsel kabul ettiğini söylüyordu.
Açık kontrol noktaları aynı karar kavramlarını kullanan yerel Python yöntemleri sunuyor, ancak arayüz benzerliği davranış eşdeğerliğini kanıtlamaz. Olasılıkları, bir vakayı otomasyon eşiğinin bir tarafından diğerine taşıyacak kadar farklı olabilir. Değerlendirilen her dal için tam model kimliğini, revizyonu, veri türünü, olasılığı ve eşiği kaydedin.
Bu nedenle geçiş süreci dört adımdan oluşmalı:
- Belirsiz ve maliyetli hataları da içeren, gerçek üretim dağılımından etiketlenmiş bir veri kümesi oluşturun.
- Aynı durumları, soru şemasını ve kriterleri her aday modelde çalıştırın.
- Eşikleri genel kıyaslama skoruna göre değil, yanlış pozitif ve yanlış negatif maliyetlerine göre belirleyin.
- Yıkıcı, finansal, erişim denetimiyle ilgili veya güvenliği etkileyen eylemlere izin vermeden önce kazanan modeli gölge modunda çalıştırın.
Hangi Liquid d1 modelini seçmelisiniz?
Çoğu ekip için varsayılan öneri barındırılan API. Token fiyatı, küçük bir pilot çalışma için yerel sunum projesini haklı çıkarmayacak kadar düşük; ayrıca sürücü, kuantizasyon, ısınma ve kapasite planlama yükünü ortadan kaldırıyor.
| Gereksinim | Tercih | Neden |
|---|---|---|
| Üretime en hızlı geçiş | Barındırılan d1 | Yönetilen uç nokta ve açık giriş fiyatlandırması |
| Veri cihazdan veya ağdan çıkmamalı | d1-3B | En güçlü açık kontrol noktası ve yerel çalıştırma |
| Açık modellerde açıklanan en iyi karar kalitesi | d1-3B | 15,95'e karşı 48,57 Decision Index |
| Sesli komut sınıflandırması | d1-omni-600M | Buradaki ses destekli tek seçenek; 30 saniyeyle sınırlı |
| En küçük deneysel ayak izi | d1-omni-600M | 587M parametre, ancak resmî gecikme tablosu yok |
| Açık uçlu açıklamalar veya üretilen eylemler | Hiçbiri | Karar aşamasından sonra üretken bir model ekleyin |
600M ayak izi ya da ses yolu vazgeçilmez değilse omni yerine d1-3B'yi seçin. Parametre sayısını beşte bire indirmek cazip görünüyor, ancak bu durum 32,62 puanlık Decision Index farkını veya omni'nin deneysel statüsünü ortadan kaldırmıyor.
Liquid AI d1 hakkında sık sorulanlar
Liquid AI d1 ücretsiz mi?
Barındırılan d1 hizmeti, milyon giriş token'ı başına 0,04 $ olarak fiyatlandırılıyor ve çıkış token'ı ücreti bulunmuyor. Açık kontrol noktaları token başı ücret olmadan indirilebilir; ancak LFM 1.0 ticari koşulları ve yerel hesaplama maliyetleri yine geçerli.
d1-3B ve d1-omni-600M, barındırılan d1 API modeli mi?
Liquid AI, iki kontrol noktasından herhangi birinin barındırılan d1 ile aynı olduğunu belgelemedi. Bunları farklı model kimlikleri, bağlamları, kıyaslamaları ve dağıtım yolları olan ilişkili ürünler olarak değerlendirin.
Liquid d1'i Ollama ile çalıştırabilir miyim?
d1-3B model sayfası, llama.cpp, Ollama, LM Studio ve uyumlu uygulamalar için hazırlanmış kuantizasyonlara bağlantı veriyor. Resmî Transformers yolunun yerine geçmeden önce kuantizasyonu yapan tarafı, kaynak revizyonunu, karar API desteğini ve doğruluğu doğrulayın.
d1-3B ses desteği sunuyor mu?
Hayır. d1-3B; metin, JSON ve görselleri kabul ediyor. d1-omni-600M, metinle birlikte görselleri veya en fazla 30 saniyelik tek ses klibini kabul ediyor; ancak aynı istekte hem görseli hem sesi işleyemiyor.
Yerelde d1 çalıştırmak için ne kadar VRAM gerekir?
Liquid, d1-3B için 6,25 GB'lık bir BF16 ağırlık dosyası yayımlıyor ancak evrensel bir VRAM gereksinimi vermiyor. Çalışma zamanı ek yükü, görüntü kodlayıcı durumu, bağlam uzunluğu, toplu iş boyutu, hassasiyet ve kuantizasyon toplam gereksinimi değiştiriyor. Dosya boyutunu tepe VRAM kullanımıyla eşitlemek yerine hedef yapılandırmayı ölçün.
Hangi yolu seçerseniz seçin, sonuç doğuran kararları otomatikleştirmeden önce olasılık eşiklerini etiketlenmiş üretim verisi üzerinde doğrulayın.
İlgili okuma: barındırılan Liquid AI d1 API incelemesi, doğrudan uç noktayı, görsel ücretlendirmesini ve türü belirlenmiş istek sözleşmesini daha ayrıntılı ele alıyor.