 AIREITER
У OpenAI теперь есть три предложения со словами «fast» и «ultra» — но скорость 750 токенов в секунду относится лишь к одному из них. Анонсированный 13 августа 2026 года режим OpenAI Ultrafast — это новый уровень API-сервиса для GPT-5.6 Sol на ваферных чипах Cerebras: заявлено до 14 раз больше скорости, чем у Standard. Пока есть важное ограничение: доступ предоставляют только по приглашениям, а цены OpenAI не назвала. Поэтому самый быстрый тариф, который можно купить уже сегодня, — Fast mode за $10/$60 за миллион токенов.
Не путайте ultra, Fast mode и Ultrafast
У пользователей GPT-5.6 Sol сейчас три похожих по названию опции, но каждая означает совершенно разное. Сводим различия в одну таблицу.
| Название | Что это | Как получить | Цена Sol (за 1 млн токенов) | Заявленная скорость |
|---|---|---|---|---|
Настройка рассуждений ultra | Режим работы, в котором для одной задачи задействуются субагенты и дополнительные вычисления | Настройка Codex, а не отдельный платный уровень API | Отдельного тарифа нет; быстро расходует лимиты использования | Медленнее по замыслу |
| Fast mode | Уровень обработки API, переименованный из Priority 30 июля 2026 года | service_tier="fast" в любом API-запросе | $10 за вход / $60 за выход (короткий контекст) | До 2,5x Standard |
| Ultrafast mode | API-уровень для GPT-5.6 Sol на базе Cerebras, представленный в превью 13 августа 2026 года | Ограниченное превью только для отдельных клиентов | Не раскрыта | До 14x Standard |
По сути, эти режимы направлены в разные стороны. ultra — это режим работы с субагентами, где скорость обменивают на тщательность. Ultrafast mode, напротив, ускоряет генерацию того же самого модели. Fast mode находится между ними: это доступное за деньги улучшение задержки, которое OpenAI описывает отдельно на странице Fast mode.
Что именно даёт превью от 13 августа
В официальном анонсе зафиксированы пять конкретных пунктов. Ultrafast сначала выходит в OpenAI API, работает только с GPT-5.6 Sol, обещает до 14 раз больше скорости Standard и до 750 выходных токенов в секунду, использует Cerebras и запускается как ограниченное превью для избранной группы клиентов, среди которых Jane Street, Podium, Basis и Rogo.
При этом в анонсе нет четырёх вещей, критичных для покупателя: цены за токен, ID модели, лимитов запросов и SLA по задержке. Именованных бенчмарков тоже не приводится.
В качестве демонстрации OpenAI показывает, как Ultrafast и Standard Sol по одному промпту создают 3D-симулятор склада. Суть предложения хорошо передаёт цитата Алекса Вана из Rogo: «С Ultrafast сложные финансовые исследования ощущаются как работа в реальном времени».
Что дают 14x скорости вместо 2,5x
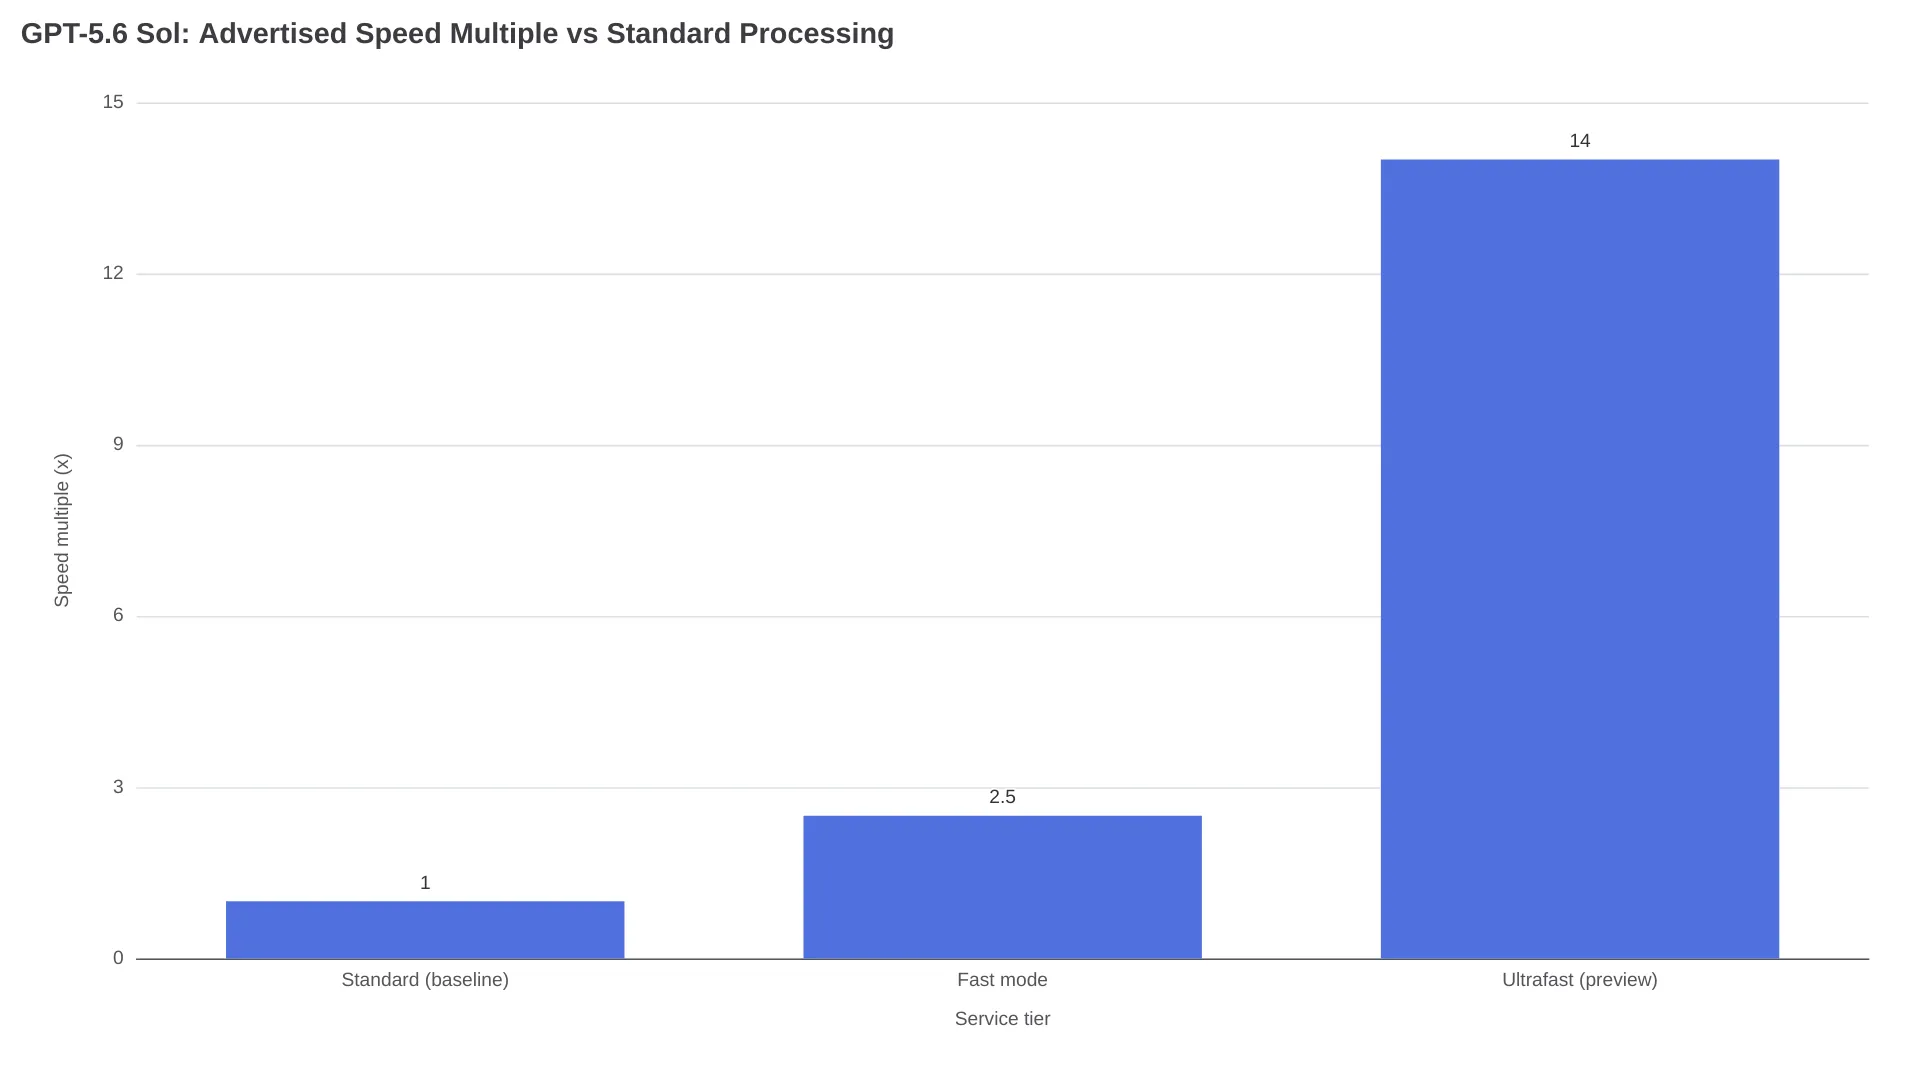
Сначала важная оговорка о метриках. 750 токенов в секунду — заявленная пропускная способность на выходе, тогда как показатель Fast mode — нижняя граница SLA. Это связанные, но не идентичные величины. Если разделить 750 на 14, получится, что Standard Sol генерирует примерно 54 токена в секунду. Тогда ответ на 10 000 токенов займёт около 186 секунд на Standard, до 125 секунд при SLA Fast mode для Enterprise в 80 токенов/с и примерно 13 секунд на Ultrafast.
| Нагрузка | Standard (~54 ток/с, расчётно) | Fast mode (SLA ≥80 ток/с) | Ultrafast (заявлено 750 ток/с) |
|---|---|---|---|
| Генерация на 10 000 токенов | ~186 с | ≤125 с | ~13 с |
| Цикл агента из 5 шагов, по 1 000 токенов на шаг | ~93 с | ≤63 с | ~7 с |
Цифры, распространяемые в r/AIToolsPerformance, приписывают эти сравнения Artificial Analysis и Cerebras: Ultrafast в 11 раз быстрее Claude Fable 5 и в 5 раз быстрее Opus 4.8 в Fast mode. Полный прогон Humanity's Last Exam из 2 500 вопросов якобы занял 11 часов 11 минут против 78 часов 27 минут у Fable 5. Все эти данные предоставлены вендорами; независимого воспроизведения пока нет.
Цена Ultrafast пока известна только участникам превью
Публичной цены Ultrafast не существует. В анонсе нет ни одного тарифа, и сообщество сразу обратило внимание на этот пробел. Как написал один из участников r/AIToolsPerformance: «В блоге не сказано главное — цена. Никто за пределами превью не знает, сколько это стоит».
Сейчас можно ориентироваться только на известную тарифную сетку GPT-5.6 Sol — все цены указаны за миллион токенов:
| Уровень | Вход (короткий контекст) | Выход (короткий контекст) | Вход (длинный контекст >272k) | Выход (длинный контекст) | Кэшированный вход |
|---|---|---|---|---|---|
| Standard | $5.00 | $30.00 | $10.00 | $45.00 | $0.50 |
| Fast mode | $10.00 | $60.00 | $20.00 | $90.00 | $1.00 |
| Ultrafast | не раскрыта | не раскрыта | не раскрыта | не раскрыта | не раскрыта |
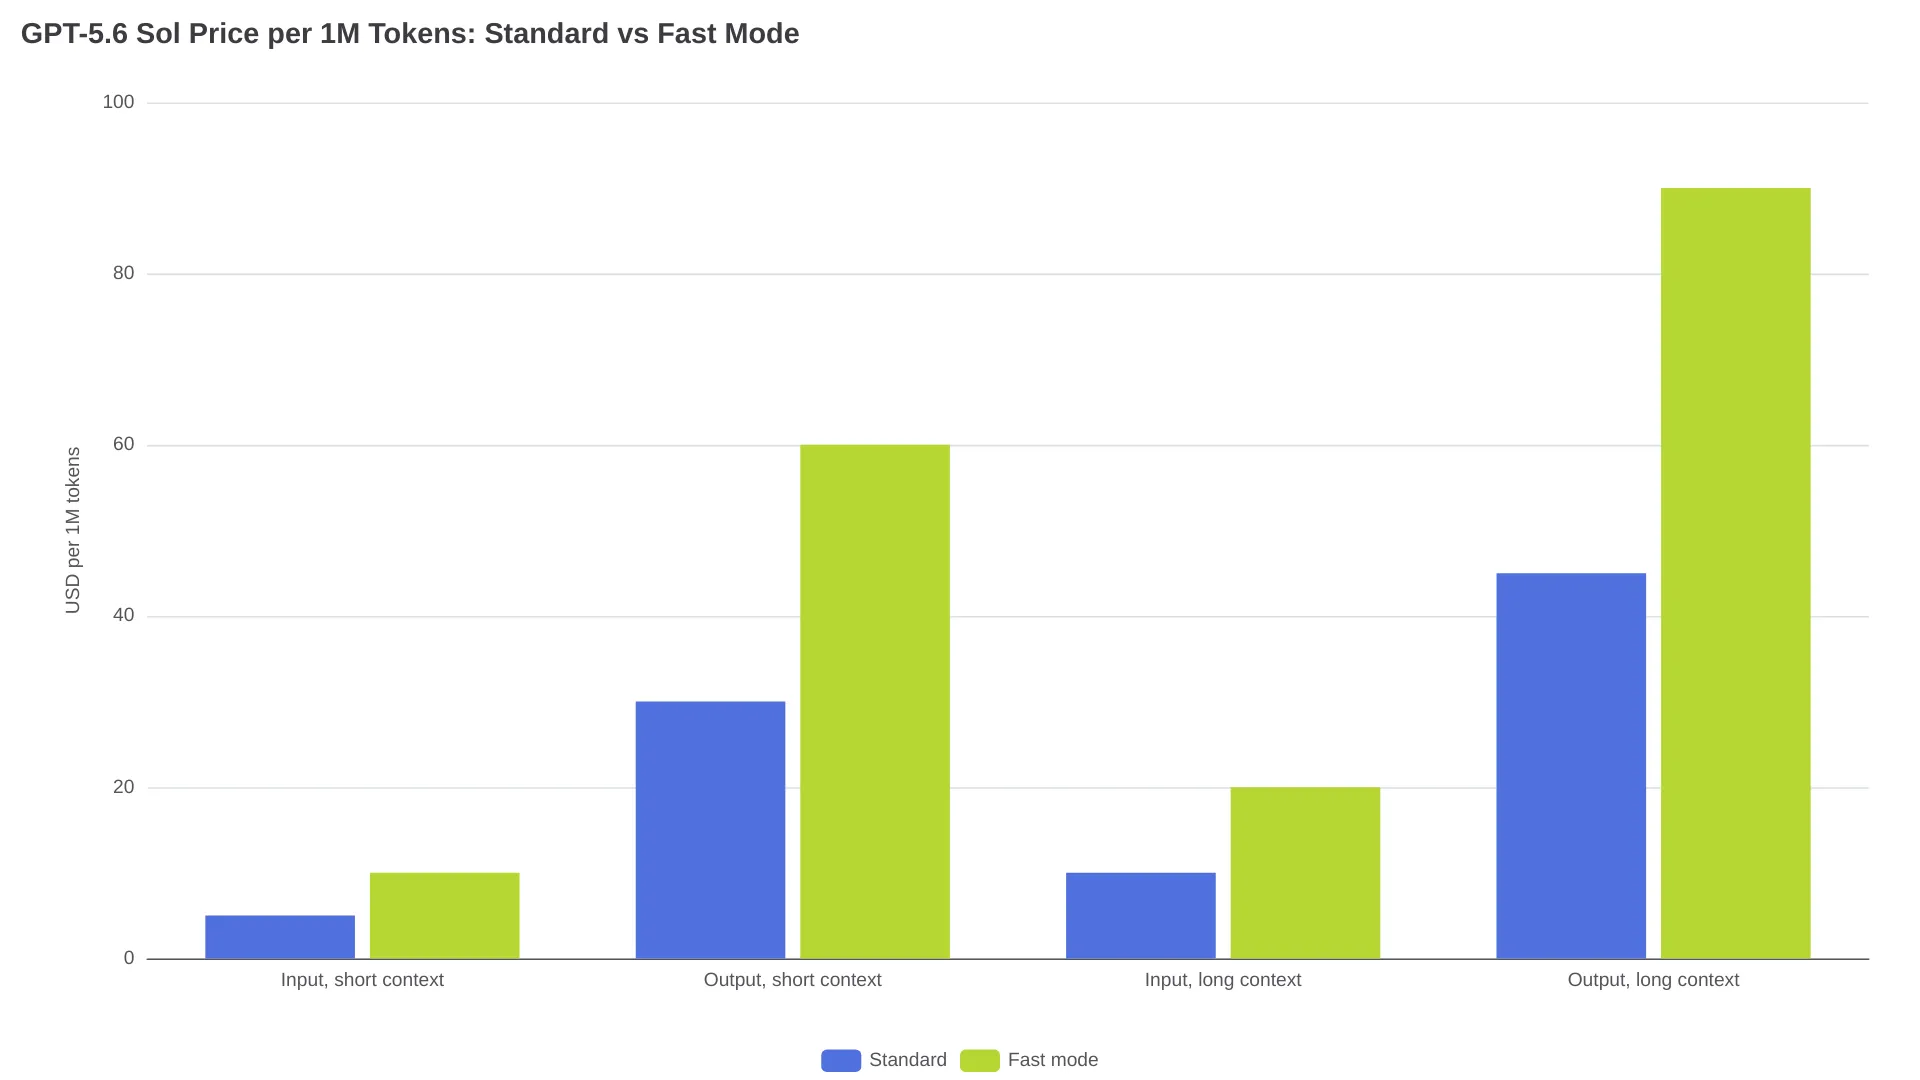
Для Sol Fast mode стоит ровно в 2 раза дороже Standard, но по этому множителю нельзя оценить цену Ultrafast: публичных данных для такого расчёта нет, а тарифы могут меняться в обе стороны — например, 30 июля OpenAI снизила цены Terra/Luna. В бюджете на задержки стоит учитывать и условие Fast mode: если превысить 1 миллион токенов в минуту и нарастить трафик более чем на 50% менее чем за 15 минут, избыточные запросы без уведомления переключаются на Standard, возвращают service_tier="Default" и тарифицируются по ставкам Standard.
Как получить доступ сегодня
В Ultrafast попадают по приглашениям, публичного листа ожидания нет. OpenAI говорит, что превью расширится «по мере роста доступных мощностей», и предлагает подписаться на обновления о доступе на странице анонса. Согласно июльским сообщениям, на раннем этапе доступ к Sol был примерно у 20 организаций.
У этой инфраструктуры уже есть история: партнёрство OpenAI с Cerebras началось 14 января 2026 года и резервирует 750 МВт ваферных мощностей. А GPT-5.3-Codex-Spark уже превысил 1 000 токенов в секунду на том же оборудовании.
Как ускорить ответы, не дожидаясь приглашения
Fast mode уже доступен всем API-клиентам, а для его включения достаточно одного параметра:
- Добавьте
service_tier="fast"в запрос к/v1/responsesили/v1/chat/completions. - Устаревшее значение
service_tier="priority"по-прежнему работает: существующие модели продолжают показыватьpriorityв дашбордах использования, а модели после GPT-5.6 будут отображатьfast. - Чтобы включить режим по умолчанию для всего проекта, откройте Project settings -> Default Service Tier -> Fast.
| Модель с Fast mode | Цена за 1 млн (вход / выход) | SLA по задержке |
|---|---|---|
| GPT-5.6 Sol | $10 / $60 | >80 ток/с |
| GPT-5.6 Terra | $4 / $24 | >70 ток/с |
| GPT-5.6 Luna | $0.40 / $2.40 | >100 ток/с |
У Luna самая высокая нижняя граница SLA из трёх моделей. Чтение из кэша снижает цену входных токенов на 90%: для Standard Sol это $0.50/M при TTL примерно 30 минут. Поэтому длительная сессия выгоднее новых запросов на любом уровне. Проверить эти уровни на реальном трафике можно через GPT-5.6 API endpoint, где все три модели доступны через единый интерфейс.
FAQ
Ultrafast mode доступен в ChatGPT или Codex?
Нет. Ultrafast сначала запускается в OpenAI API, а даты появления в ChatGPT или Codex в анонсе нет.
Меняется ли качество ответов GPT-5.6 Sol при работе на Cerebras?
OpenAI позиционирует Ultrafast как тот же GPT-5.6 Sol с более быстрой обработкой, а не как другую модель. Пока есть только заявление Cerebras об ускорении GDP-Val в 5,6 раза без потери качества; независимые бенчмарки этого не подтвердили.
Есть ли у Ultrafast mode SLA по задержке?
Опубликованного SLA нет. Для Fast mode заявлены p50 SLA >80 токенов/с и доступность 99,9% для Enterprise-клиентов; для Ultrafast на этапе превью SLA не указан.
Какие модели поддерживают Ultrafast mode?
Только GPT-5.6 Sol. Terra и Luna поддерживают Fast mode, но в превью Ultrafast не участвуют.
Сколько будет стоить Ultrafast mode?
Официальной цифры нет. Единственный ориентир — опубликованная для Fast mode наценка 2x относительно Standard Sol.