 AIREITER
Для кодового агента, который редко выходит за пределы примерно 150K токенов контекста, Hy3 выглядит более разумным выбором: он чуть сильнее в рассуждениях, а входные токены стоят примерно столько же. Но для долгих сессий, крупных репозиториев и высоконагруженного продакшена преимущество у DeepSeek V4 Flash. У него есть три недоступных Hy3 козыря: контекстное окно на 1M токенов, документированная цена $0.0028 за кэш-попадание и лимит в 2,500 одновременных запросов. Такой получается краткий вывод в сравнении hy3 vs deepseek v4 flash. Ниже — данные, проверенные 14 июля 2026 года по официальной документации DeepSeek и актуальным листингам OpenRouter, независимым бенчмаркам и отзывам тех, кто ежедневно работает с обеими моделями на Hacker News и Reddit.
Hy3 и Flash: разные приоритеты
Tencent выпустила финальную версию Hy3 6 июля 2026 года. Она сменила превью, доступное с 23 апреля. Согласно анонсу, это Mixture-of-Experts-модель с 295B параметров всего и 21B активных. В ее основе — подход, который Tencent называет гибридным быстрым и медленным мышлением: модель сама определяет, сколько ресурсов на рассуждение требуется конкретному запросу. Максимальный контекст — 256K токенов. Веса открыты по лицензии Apache 2.0, API работает через Tencent Cloud TokenHub.
DeepSeek V4 Flash вышла в апреле 2026 года как быстрая модель семейства V4. Это тоже MoE с открытыми весами — 284B параметров всего и 13B активных, по данным Artificial Analysis, — однако под лицензией MIT. Ее проектировали под другую задачу: недорого обслуживать контекст до 1M токенов. Доступны режимы thinking и non-thinking, причем thinking включен по умолчанию; максимальный объем вывода составляет 384K токенов.
По числу параметров модели близки, но оптимизированы они для разного. Hy3 вкладывает бюджет в качество рассуждений на токен, а Flash — в длину контекста, эффективность кэша и пропускную способность. Почти все практические различия далее следуют именно из этого.
| Характеристика (проверено 2026-07-14) | Hy3 | DeepSeek V4 Flash |
|---|---|---|
| Параметры | 295B всего / 21B активных | 284B всего / 13B активных |
| Контекстное окно | 256K | 1M (до 384K на вывод) |
| Рассуждения | Гибридное быстрое/медленное мышление | Режимы thinking + non-thinking |
| Лицензия | Apache 2.0 | MIT |
| Дата релиза | 6 июля 2026 (превью — 23 апр.) | Апрель 2026 |
| Официальный API | Tencent Cloud TokenHub | api.deepseek.com (форматы OpenAI + Anthropic) |
Что говорят независимые бенчмарки
В индексе Artificial Analysis Intelligence Index v4.1 Hy3 набирает 41 балл против 37 у DeepSeek V4 Flash в reasoning-режиме с высоким усилием. Разрыв в четыре пункта вполне реален — примерно такая же дистанция отделяет Flash от моделей уровнем ниже, — но это не разница между классами. Обе модели находятся в категории «очень способные, но не передовые».
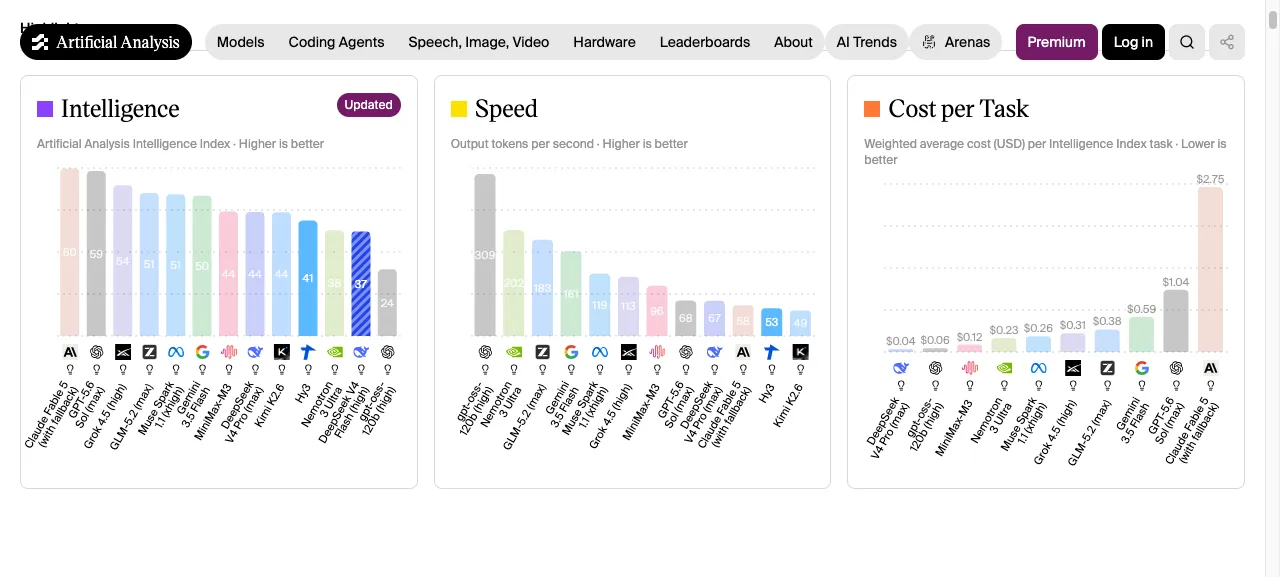
Прежде чем придавать этой оценке слишком большой вес, стоит учесть два нюанса.
Во-первых, агентные бенчмарки программирования рисуют для обеих моделей более суровую картину. Комментатор в ветке запуска на Hacker News нашел результат Hy3 в DeepSWE: 28% против 52% у GPT-5.4 на максимальном уровне усилия. Ни одна из двух китайских моделей не приближается к лидерам в агентном программировании: они соперничают между собой, а не с вершиной рейтинга.
Во-вторых, к бенчмарк-таблицам, опубликованным самими вендорами, в обоих случаях стоит относиться со здоровым скепсисом. Цифры из анонса Hy3 сразу вызвали в ветке HN обвинения в «benchmaxxed», а таблицы DeepSeek охватывают только те оценки, которые компания решила провести. Я бы опирался на приведенные выше независимые данные: Hy3 немного умнее, но разрыв достаточно мал, чтобы цена и контекст перевесили чашу в другую сторону.
Цена: важнее не тариф на витрине
Здесь есть две тарифные сетки, проверенные 14 июля 2026 года, и смешивать их не стоит. DeepSeek публикует точные цены за токены для собственного API. Tencent не выпустила сопоставимую англоязычную тарифную таблицу для финальной Hy3: в пресс-релизе вход для Hy3 preview на TokenHub указан как примерно $0.18 за миллион токенов. Поэтому для Hy3 ниже использованы тарифы OpenRouter — это цена маркетплейса, а не первого поставщика.
| За 1M токенов | Hy3 (маркетплейс OpenRouter) | DeepSeek V4 Flash (собственный API) |
|---|---|---|
| Вход | $0.14 | $0.14 (промах кэша) |
| Вход из кэша | $0.035 | $0.0028 (попадание в кэш) |
| Выход | $0.58 | $0.28 |
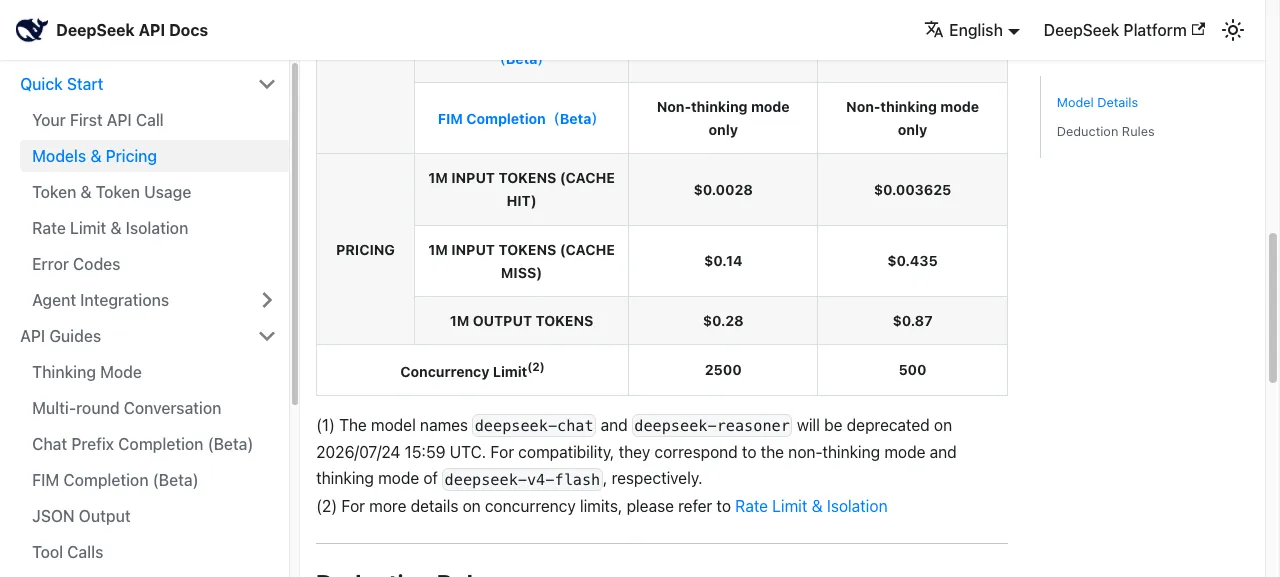
Базовая цена входа одинаковая. Решение определяют две другие строки.
Почему кэш меняет всю экономику
Тариф DeepSeek при попадании в кэш в 50 раз ниже цены при промахе и в 12.5 раза ниже кэш-тарифа Hy3 на OpenRouter. Эти ставки не полностью сопоставимы: DeepSeek указывает цену собственного API, а Hy3 на OpenRouter зависит от стоимости чтения кэша у базовых провайдеров. Но именно такие суммы вы заплатите сейчас. Для агентов это важнее любого другого числа в статье. На каждом шаге агент снова отправляет растущий контекст: системный промпт, определения инструментов, содержимое файлов и историю диалога. В сессии из 40 шагов подавляющая часть входных токенов повторяется. При 90% попаданий в кэш эффективная цена входа Flash снижается с $0.14 примерно до $0.017 за миллион токенов. У Hy3 она опускается примерно до $0.045: тоже недорого, но почти в 3 раза больше. И чем длиннее сессия, тем заметнее разница.
У Hy3 особенно дорогой вывод
Обе модели умеют рассуждать, а значит, обе тарифицируют токены thinking как выходные. Выход у Hy3 стоит $0.58 против $0.28 у Flash, то есть каждая длинная цепочка рассуждений обходится пользователю Hy3 примерно вдвое дороже. У Flash есть и недоступный Hy3 способ сэкономить: для механических задач — форматирования, извлечения данных, простых правок — можно включить non-thinking и не платить за ненужные рассуждения. О том, как этот переключатель работает на практике, подробнее рассказано в сравнении deepseek-v4-flash-vs-deepseek-v4-pro.
Бесплатный уровень
У Hy3 есть одно настоящее преимущество: OpenRouter предлагает вариант tencent/hy3:free с нулевой ценой. Он ограничен по скорости, но это реальный бесплатный доступ. Для знакомства с моделью перед выбором это лучше Flash, у которой бесплатного API-уровня нет. Hy3 preview также остается в листинге по $0.063/$0.21 — дешевле финального релиза, — если вас устраивает апрельский чекпойнт.
Налог на ограниченный контекст
Контекст Hy3 на 256K кажется более чем достаточным, пока агент не начинает работать с настоящим кодовым репозиторием. Пользователь r/hermesagent на Reddit, запускавший обе модели в одном окружении, назвал Hy3 «почти идентичной, если не считать размера контекста, поэтому приходится часто делать компакцию». Компакция — не просто неудобство. Каждый такой цикл тратит выходные токены на суммаризацию, отбрасывает детали и инвалидирует кэш промпта. После этого контекст приходится собирать заново по цене промаха кэша.
При самостоятельном хостинге различие становится архитектурным. Разреженное внимание V4 — механизм, который DeepSeek называет lightning indexer, — делает ее KV-кэш намного легче, чем при традиционном внимании Hy3. Это не бенчмарки, а единичные пользовательские отчеты, но цифры в ветке HN впечатляют. Один комментатор, запускавший обе модели на паре DGX Spark, сообщил, что вместе с DeepSeek V4 Flash ему удалось разместить 3M токенов KV-кэша, тогда как Hy3, квантованная в FP4, вместила примерно 130K токенов. Другой оценил, что после полной поддержки indexer в llama.cpp полный контекст Flash на 1M должен требовать всего около 6GB RAM. Flash также успела показать устойчивость к агрессивной квантизации: несколько пользователей в той же ветке утверждают, что она сохраняет связность даже при 2-битной квантизации. Для Hy3 такого результата пока не продемонстрировано.
Если ваш сценарий уверенно укладывается в 200K токенов, этот раздел ничего вам не стоит, а дополнительные четыре балла Hy3 по интеллекту достаются бесплатно. В противном случае налог на контекст накапливается: больше компакции, больше сбросов кэша, больше памяти на сессию.
Что рассказывают разработчики после релиза
Самый полезный сигнал нашелся не в бенчмарк-таблицах, а в том, как разработчики описывают характер моделей при работе с ними внутри кодовых агентов.
Пользователь из той же ветки Hacker News, который после отмены подписки Anthropic перешел на DeepSeek V4 Flash и Pro как ежедневные рабочие модели, а затем попробовал Hy3, описал Flash так: скорость отличная, но она «часто строит совершенно неверную ментальную модель и устремляется по неправильному пути», поэтому ее регулярно приходится корректировать и сжимать историю. По его опыту, Hy3 «не так быстра, но пока гораздо надежнее держит курс» и меньше деградирует при росте контекста. Другие участники той же ветки также хвалили знания о мире и качество текста Hy3, считая их лучшими для модели такого размера, чем у Flash.
На Reddit картина для чистого кодинга скорее склоняется к Flash. В сравнении одной и той же задачи в r/LLMDevs модели расположили так: «DeepSeek V4 Flash > Hy3 > GLM», хотя Hy3 все равно назвали «перспективной для практических рабочих процессов программирования». В r/opencode регулярно повторяется мнение, что Flash «более чем достаточно» для повседневной агентной работы.
Стоит учитывать и эксплуатационную историю. Спрос на Hy3 после запуска превысил возможности Tencent по обслуживанию: пользователи в ветке HN сообщали о жестких ограничениях по частоте, а один из тех, кто следит за публичным рейтингом использования OpenRouter, отметил, что модель за месяц опустилась с первого места на 8–9-е, прямо связав это с лимитами. DeepSeek, напротив, документирует для Flash лимит в 2,500 одновременных запросов в официальном API — в пять раз больше, чем для V4 Pro. Для продакшен-трафика у одного поставщика есть опубликованные гарантии емкости, а у другого — история перегрузок.
Какую модель выбрать
- Кодовые агенты и сессии до ~150K токенов: Hy3. Она сильнее в рассуждениях, надежнее удерживает задачу, а базовая цена входа совпадает с Flash. Выбран порог 150K, а не полные 256K, поскольку агентный контекст растет быстро и нужен запас до начала компакции.
- Длинные сессии, большие репозитории, RAG по крупным документам: обычно лучше подойдет Flash. Окно на 1M и 50-кратная скидка на кэш выводят ее в другой ценовой класс, а накладные расходы Hy3 на компакцию съедают преимущество в интеллекте.
- Высоконагруженные production API: Flash. Документированный лимит 2,500 одновременных запросов, стабильная история обслуживания и non-thinking для недорогих массовых вызовов.
- Тексты, исследования, задачи на знания о мире: Hy3. В ее пользу говорят и отзывы сообщества, и оценки знаний AA для моделей этого размера.
- Локальный запуск: Flash для большинства конфигураций. По эффективности KV-кэша и устойчивости к квантизации для нее гораздо больше практических свидетельств; собственные рекомендации Tencent по обслуживанию Hy3, процитированные в ветке запуска, предполагают восемь GPU уровня H20.
- Проверка перед выбором: бесплатный уровень Hy3 на OpenRouter можно попробовать без затрат. Прогоните через него собственные задачи, прежде чем верить любой бенчмарк-таблице — включая эту.
Где запускать модели
DeepSeek V4 Flash: официальный API поддерживает endpoint в формате OpenAI (api.deepseek.com) и Anthropic (api.deepseek.com/anthropic), поэтому модель легко подключить к инструментам, совместимым с Claude: достаточно изменить base URL. На той же странице с ценами указан срок миграции: старые имена моделей deepseek-chat и deepseek-reasoner будут упразднены 24 июля 2026 года; им соответствуют non-thinking и thinking режимы Flash. OpenRouter предлагает ее за $0.09/$0.18, немного дешевле официального тарифа, но без цены за кэш-попадания из официального API.
Hy3: основной вариант от первого поставщика — Tencent Cloud TokenHub. На OpenRouter доступны финальный релиз, более дешевый превью-чекпойнт и бесплатный уровень. SiliconFlow предлагал акции к запуску. Самостоятельный хостинг возможен по Apache 2.0, если у вас есть нужные GPU. В руководстве по настройке Hy3 API показано, как получить ключ и выполнить первый запрос.
FAQ
Hy3 можно использовать бесплатно?
Частично. OpenRouter предлагает бесплатный, но ограниченный по скорости уровень tencent/hy3:free, а потребительские продукты Tencent — Yuanbao и ima — используют Hy3 без оплаты. Доступ к production API через TokenHub либо платный уровень OpenRouter тарифицируется по токенам.
Hy3 — это то же самое, что Tencent Hunyuan?
Да. Hy3 — третье поколение линейки Tencent Hunyuan, которую компания теперь называет «Tencent Hy». Превью вышло 23 апреля 2026 года, финальный релиз — 6 июля 2026 года.
Что лучше для программирования: Hy3 или DeepSeek V4 Flash?
Отзывы сообщества расходятся в зависимости от типа задачи. В Reddit-сравнениях на одинаковых задачах чистый результат Flash оценивали выше Hy3, но пользователи агентов в долгих сессиях сообщают, что Hy3 надежнее держится выбранного направления. Для коротких и хорошо очерченных задач выгоднее скорость Flash; для многочасовых агентных сессий, где дорого обходится уход не туда, предпочтительнее Hy3 — при условии, что контекст уверенно помещается в ее окно 256K.
Можно ли запустить DeepSeek V4 Flash локально?
Да, и это практичнее, чем с Hy3. Веса доступны по MIT, KV-кэш у архитектуры необычно легкий, а пользователи сообщают о приемлемом качестве даже при 2-битной квантизации на машинах примерно с 96GB RAM.
Почему сравнение цен hy3 vs deepseek v4 flash настолько запутанное?
Потому что существует как минимум четыре тарифные сетки: Tencent TokenHub, листинги финальной и превью-версии Hy3 на OpenRouter, а также официальный API DeepSeek с отдельной ценой за кэш-попадание. Сравнивайте эффективную стоимость для собственного профиля нагрузки: в агентных задачах преобладает кэшированный вход, и здесь тариф DeepSeek $0.0028 сложно превзойти.
Итог
По доступным независимым данным Hy3 — более сильная модель, а DeepSeek V4 Flash — более сильный сервис. Для production API-нагрузок Flash остается моим выбором по умолчанию: ее экономика кэша, контекстное окно и опубликованный лимит одновременных запросов дают накопительный эффект, который преимущество в четыре балла на бенчмарке не компенсирует. Hy3 стоит выбирать, когда качество рассуждений на один промпт важнее масштаба, — и сначала попробовать ее бесплатный уровень: проверить на своих задачах можно без затрат.