 AIREITER
Для нативной работы с визуальными данными выбирайте GLM-5.3-Flash; для текстовых и кодовых нагрузок с интенсивным использованием кеша — DeepSeek V4 Flash. Важнее не один бенчмарк, а конкретный сценарий и схема биллинга.
Сначала уточним, какие именно модели сравниваются
Здесь сопоставляются GLM-5.3-Flash (glm-5.3-flash) и продакшен-модель DeepSeek deepseek-v4-flash, которая на официальной странице цен обозначена как DeepSeek-V4-Flash-0731. DeepSeek V4 Pro и отдельный endpoint deepseek-v4-flash-vision-exp не являются заменой основной Flash-модели в этом сравнении. О происхождении Ox Alpha, аппаратных ограничениях и нюансах превью-версии читайте в обзоре AIReiter на GLM-5.3-Flash.
Быстрый выбор по типу задачи
| Если в приоритете… | Выбирайте | Почему |
|---|---|---|
| Преобразование скриншотов в код, проверка UI, ввод видео или файлов | GLM-5.3-Flash | Нативная поддержка изображений, видео и файлов в одной модели |
| Массовая обработка только текста с высокой долей попаданий в кеш | DeepSeek V4 Flash | Ниже официальная цена кешированного ввода, особенно вне пиковых часов |
| Новые входные данные и большой объём генерации во время акции GLM | GLM-5.3-Flash | Акционные ставки на ввод и вывод ниже официальных ставок DeepSeek для cache miss и генерации |
| Терминальные coding-агенты, где нужен консервативный выбор для продакшена | DeepSeek V4 Flash | Версионированный публичный beta-маршрут и официальные результаты оценки Flash |
| Визуальные браузерные агенты и computer use | GLM-5.3-Flash | Визуальная обратная связь остаётся внутри цикла написания кода или вызова инструментов |
| Текстовый контекст на 1M токенов | По умолчанию — ни одну | Обе заявляют контекст класса 1M; проверяйте retrieval на реальном размере промптов |
| Одна модель для текста, кода и изображений | GLM-5.3-Flash | Для основного мультимодального сценария не нужен отдельный vision endpoint |
Что заявлено в официальных спецификациях
Документация по моделям Z.AI и страница цен Z.AI описывают GLM и её биллинг. Соответствующие сведения о Flash у DeepSeek приведены в документации Models & Pricing и журнале изменений.
| Характеристика | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| API model ID | glm-5.3-flash | deepseek-v4-flash |
| Опубликованная версия | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Контекстное окно | 1M токенов | 1M токенов |
| Максимальный вывод в официальной документации | 128K токенов | 384K токенов |
| Основные типы ввода | Текст, изображения, видео и файлы | Текст и код; зрение доступно в отдельной экспериментальной модели |
| Вывод | Текст | Текст |
| Управление рассуждениями | Thinking включён; поддерживается reasoning_effort | Режимы thinking и non-thinking; уровни effort: low, high и max |
| Инструменты и структурированный вывод | Function calling, streaming, context caching и JSON output | Tool calls, JSON output, Responses API и совместимость с Anthropic API |
| Веса | Провайдер опубликовал открытые веса | Провайдер опубликовал открытые веса |
Указанные для GLM 320B общих параметров и 18B активных параметров описывают разреженную экспертную архитектуру, а не локальный checkpoint на 18B. На официальной странице цен DeepSeek для Flash сопоставимое число параметров не приводится.
GLM принимает визуальные данные через основной маршрут модели. У DeepSeek для этого существует отдельная deepseek-v4-flash-vision-exp, что меняет логику роутинга и тестирования.
Для coding-агентов важны два разных сценария
Терминальные агенты проверяют работу с репозиторием и исполнение инструментов. Визуальные агенты должны ещё и понимать отрендеренные интерфейсы и состояния GUI.
Терминал, репозитории и инструменты
В таблице запуска Z.ai и официальном обновлении DeepSeek от 31 июля приведены следующие результаты:
| Бенчмарк | GLM-5.3-Flash | DeepSeek V4 Flash | Статус данных |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Раздельные оценки, заявленные провайдерами |
| DeepSWE | 63.4 | 54.4 | Раздельные оценки, заявленные провайдерами |
| Toolathlon Verified | 78.4 | 70.3 | Раздельные оценки, заявленные провайдерами |
| AutomationBench | 48.8 | 25.1 | Раздельные оценки, заявленные провайдерами |
| Agents’ Last Exam | 26.3 | 25.2 | Раздельные оценки, заявленные провайдерами |
В этих заявленных провайдерами бенчмарках впереди GLM, однако разные тестовые обвязки позволяют использовать результаты лишь для составления шорт-листа, а не для окончательного выбора.
Независимые данные делают картину менее однозначной. В тесте Composio от 27 августа на 30 многошаговых агентных задачах GLM-5.3-Flash завершила 21/30 задач, а DeepSeek V4 Flash — 20/30. DeepSeek оказалась самой быстрой в 19 из 30 задач, а заявленная стоимость одной успешно выполненной задачи составила около $0.028 у DeepSeek против примерно $0.06 у GLM. Эти цифры взяты из теста Composio, а не у провайдеров моделей.
Для агентов с упором на терминал начните с DeepSeek V4 Flash, если критичны скорость, воспроизводимость и аргументированный стартовый выбор. GLM стоит добавить в сравнение, если качество исправлений с первой попытки или более широкое поведение с инструментами оправдывают измерение относительно этой более низкой стоимости.
Инструменты, браузер и визуальная обратная связь
GLM лучше вписывается в продукт, если агенту нужно увидеть результат собственного кода. Z.ai описывает цикл, в котором модель читает скриншоты или отрендеренные интерфейсы, меняет реализацию и снова проверяет итог. Это полезно для screenshot-to-code, отладки фронтенда, работы с браузером, документами и некоторых 3D-сценариев.
DeepSeek справляется с текстовыми и кодовыми агентными задачами через deepseek-v4-flash, но визуальный ввод требует отдельного маршрута deepseek-v4-flash-vision-exp. Для уже существующего пайплайна с роутингом vision это может быть приемлемо. Но если агент переходит между исходным кодом, скриншотом браузера и видео без смены endpoint, GLM выглядит более цельным вариантом. Этот альтернативный путь разобран в гайде по DeepSeek V4 Flash Vision Exp API.
Что говорят пользователи за пределами бенчмарков
Отзывы сообщества указывают скорее на компромисс, чем на безоговорочного лидера. В отчёте пользователя после двух дней работы с GLM она названа способной на небольших контекстах, но менее собранной по мере роста промпта — при этом автор отметил поддержку изображений:
«Когда контекст становится больше, она начинает вести себя нервно и небрежно». — @XBToshi, два дня активно использовавший GLM-5.3-Flash и опубликовавший сравнение
Это единичное наблюдение, а не показатель частоты сбоев. Но оно подсвечивает проблему, которую не видно в таблицах бенчмарков: большой лимит контекста не гарантирует стабильного поведения многошагового агента.
Небольшой эксперимент в Ollama тоже отдал предпочтение DeepSeek по специфическим для провайдера единицам квоты, но автор не приравнивал эти единицы к долларовой стоимости API.
Почему данные о скорости могут изменить выбор
Для этих точных моделей нет опубликованного сравнения p50-латентности или пропускной способности в едином тестовом контуре. Не переносите сюда результаты Pro, Vision-Exp или других маршрутов. Composio назвал DeepSeek самой быстрой в 19/30 агентных задач: это полезный, но не эквивалентный throughput-сигнал. Для интерактивных ассистентов измеряйте время до первого полезного вызова инструмента, а для пакетных задач — полное время до принятого результата.
Цена токена — не то же самое, что цена выполненной задачи
Официальные тарифы дают более сложную картину, чем формула «DeepSeek дешевле». Z.AI предлагает скидку 50% на GLM-5.3-Flash до September 9, 2026 at 24:00 UTC+8. У DeepSeek отдельно тарифицируются cache hit и cache miss, причём ставки различаются в пиковое и непиковое время.
Все суммы ниже указаны в долларах США за 1 миллион токенов.
| Статья биллинга | GLM-5.3-Flash по акции | GLM-5.3-Flash по прайсу | DeepSeek V4 Flash вне пика | DeepSeek V4 Flash в пик |
|---|---|---|---|---|
| Новый ввод / cache miss | $0.075 | $0.15 | $0.22 | $0.44 |
| Кешированный ввод | $0.015 | $0.03 | $0.007 | $0.014 |
| Вывод | $0.25 | $0.50 | $0.66 | $1.32 |
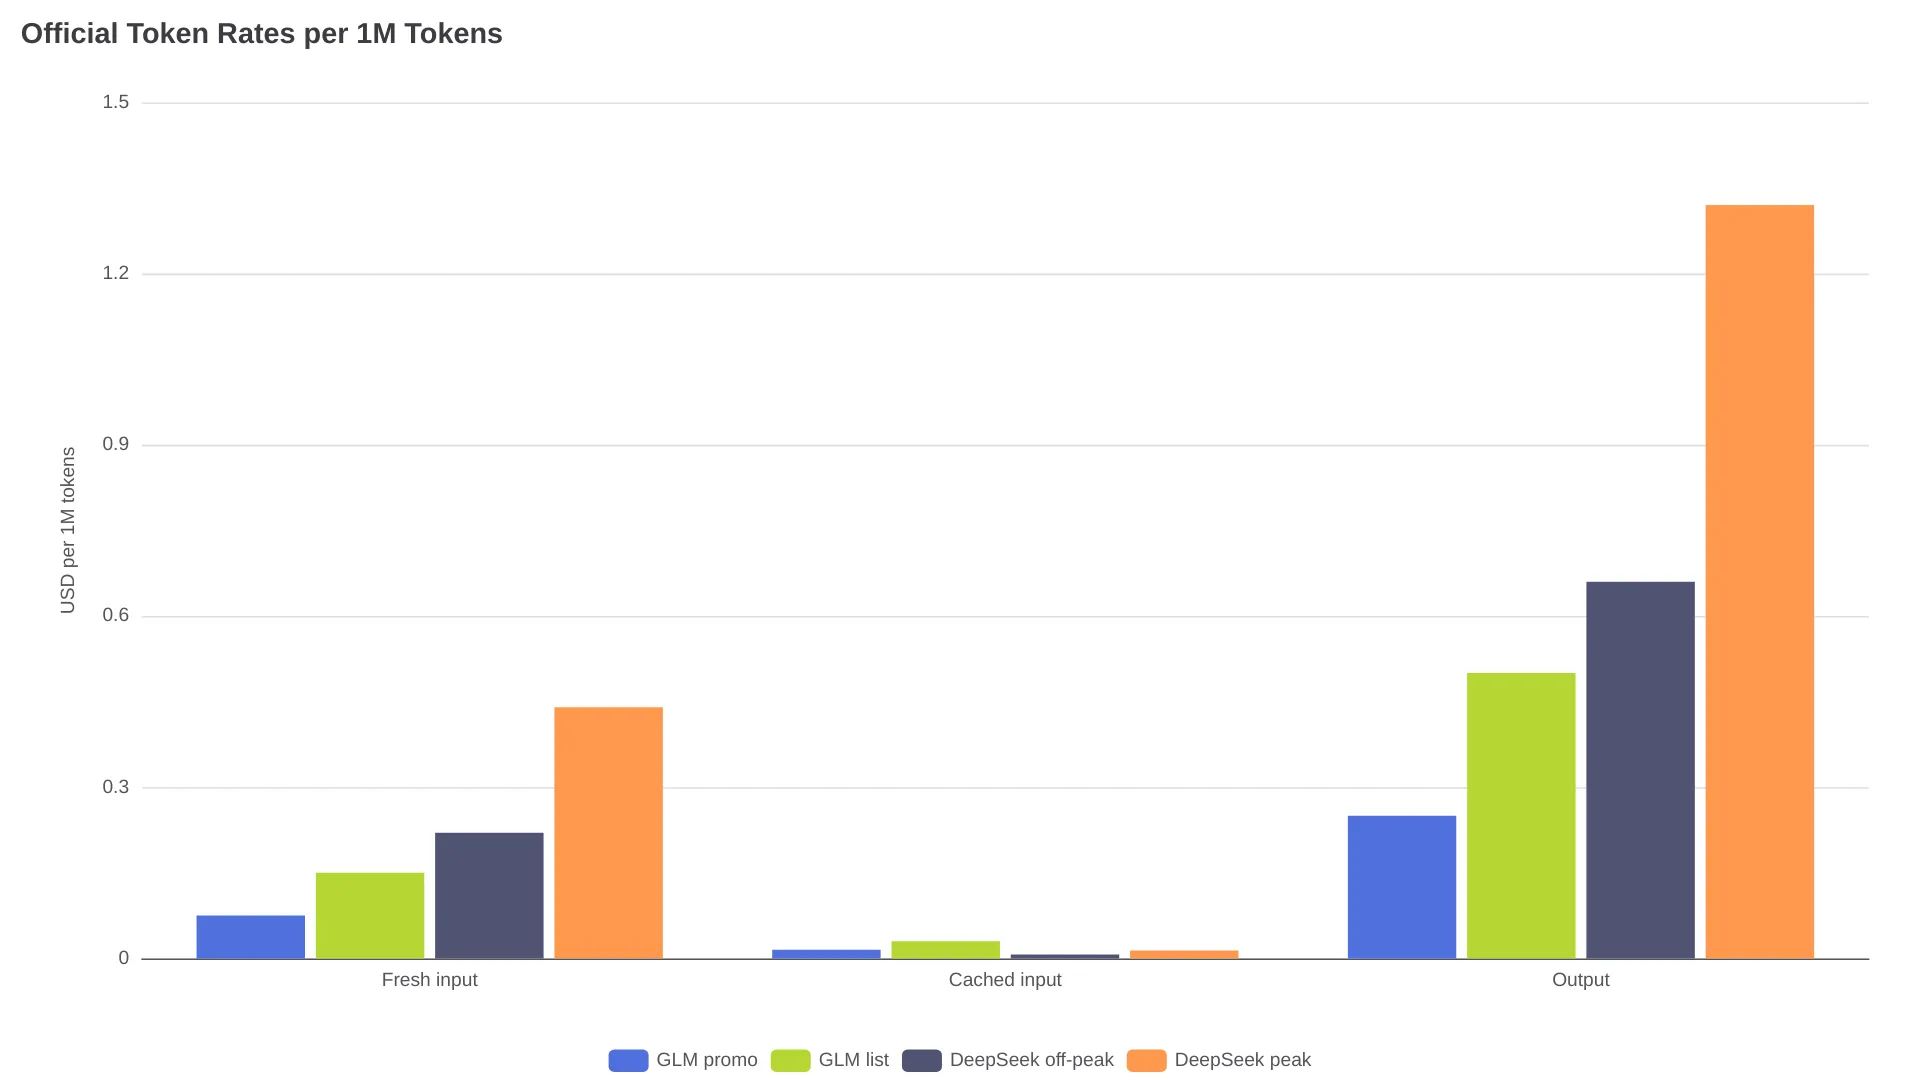
Пиковые интервалы DeepSeek: 01:00–04:00 UTC и 06:00–10:00 UTC с понедельника по пятницу; всё остальное время считается непиковым. В официальной таблице также указана конкурентность 2,500 для V4 Flash. На странице цен GLM заявлено ограниченное по времени бесплатное хранение кешированного ввода, но универсального лимита конкурентности там нет.
- DeepSeek дешевле для кешированного ввода во всех соответствующих периодах.
- Акционная цена GLM выгоднее для нового ввода и вывода по сравнению с официальными ставками DeepSeek на cache miss и генерацию.
- После завершения акции обычные ставки GLM на новый ввод и вывод всё равно ниже указанных непиковых ставок DeepSeek.
- Самый сильный ценовой сценарий DeepSeek — нагрузки с интенсивным кешированием, преобладанием ввода и коротким выводом, особенно при запуске вне пиковых часов.
Пример: 10M токенов ввода и 2M токенов вывода
Предположим, есть 10 миллионов новых входных токенов и 2 миллиона выходных, без платы за инструменты и без повторных попыток:
| Модель и путь биллинга | Расчёт | Итого |
|---|---|---|
| GLM по акции | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM по прайсу | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek вне пика, cache miss | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek в пик, cache miss | 10 × $0.44 + 2 × $1.32 | $7.04 |
Если все 10 миллионов входных токенов попадут в кеш, итог для DeepSeek вне пика составит $1.39 (10 × $0.007 + 2 × $0.66), а для GLM по акции — $0.65 (10 × $0.015 + 2 × $0.25). Преимущество DeepSeek на кеше становится существеннее при гораздо более высоком соотношении ввода к выводу и короткой генерации.
Когда низкий счёт DeepSeek решает всё
Выбирайте DeepSeek V4 Flash, если большинство запросов повторно используют длинный стабильный системный промпт или префикс репозитория, выдают короткие ответы и могут выполняться вне пиковых часов. К такому профилю ближе классификация, извлечение данных, суммаризация и рутинная автоматизация только с текстом, чем агенты на основе скриншотов.
Когда дополнительные возможности GLM обходятся дешевле
GLM может сократить стоимость пайплайна, если изображение, документ или видео в противном случае потребовали бы отдельного vision-запроса. Акционная стоимость вывода также важна для агентов, генерирующих длинные патчи кода. Проверяйте эту гипотезу по тарифицируемым токенам, циклам исправлений и доле принятых задач, а не исходите из универсального преимущества по стоимости задачи.
Длинный контекст — это лимит ёмкости, а не гарантия качества
Обе официальные документации указывают контекстное окно на 1M токенов, поэтому по размеру контекста здесь ничья. DeepSeek заявляет максимальный вывод 384K, а документация Z.AI для GLM-5.3-Flash — 128K. Эта разница важна только для приложений, допускающих необычно длинную генерацию.
Z.ai заявляет в 3.01× меньшие вычисления attention и в 4.44× меньший размер KV-cache, чем у GLM-5.3, отмечая, что KV cache GLM всё ещё немного больше, чем у DeepSeek V4 Flash. Эти утверждения вендора не доказывают преимущества GLM над DeepSeek ни по задержке, ни по качеству retrieval.
Проверяйте retrieval, выполнение инструментов и долю принятых задач на 50K, 200K и вашем реальном максимальном размере промпта, используя критерий приёмки из блока ниже.
Выберите модель по умолчанию или настройте роутинг
| Нагрузка | Первая модель для теста | Резервный вариант или эскалация |
|---|---|---|
| Классификация и извлечение данных только из текста | DeepSeek V4 Flash | GLM, если не проходит форматирование или качество |
| Чат по репозиторию с высокой долей кеша | DeepSeek V4 Flash | GLM для сложных итераций исправления |
| Терминальный coding-агент | DeepSeek V4 Flash | GLM там, где важен результат с первой попытки |
| Screenshot-to-code | GLM-5.3-Flash | DeepSeek для последующей работы только с текстом |
| Браузерный агент или computer use | GLM-5.3-Flash | DeepSeek для невизуальных этапов планирования |
| Анализ с опорой на видео, изображения или файлы | GLM-5.3-Flash | DeepSeek Vision Exp, если отдельный маршрут приемлем |
| Длинный текст и короткий вывод | DeepSeek V4 Flash | GLM, если ухудшается retrieval |
| Генерация длинного кода во время акции | GLM-5.3-Flash | DeepSeek, когда решающей становится экономика cache hit |
Перед переключением продакшен-нагрузки проведите небольшой тест в едином контуре:
- Зафиксируйте точные ID:
glm-5.3-flashиdeepseek-v4-flash. Не позволяйте роутеру незаметно подменять их на Pro или Vision-Exp. - Возьмите 20–50 реальных задач, включая успешные кейсы и недавние сбои. Если продукт агентный, добавьте не менее пяти задач с использованием инструментов.
- Записывайте pass rate, число циклов исправления, пропущенные tool calls, время до первого полезного действия, суммарные входные и выходные токены, а также cache-hit ratio.
- Сравните стоимость одной принятой задачи, а вторую модель оставьте в резерве, пока показатели таймаутов и ошибок не стабилизируются.
Быстрый старт Z.AI и гайд DeepSeek по первому API-вызову описывают OpenAI-совместимый доступ, но управление рассуждениями, vision-маршруты и семантика биллинга у сервисов различаются.
Частые вопросы перед покупкой
GLM-5.3-Flash — это та же модель, что Ox Alpha?
Z.ai официально подтвердила, что GLM-5.3-Flash — это модель, которую компания анонимно тестировала как Ox Alpha. Роутинг в превью, квоты и поведение endpoint не стоит считать постоянными спецификациями публичной модели.
Используйте таблицу роутинга, а затем проверьте выбор по умолчанию с зафиксированными ID, реальными сбойными кейсами и единым тестовым контуром. В обзоре GLM-5.3-Flash разобраны происхождение модели и данные о развёртывании, а гайд по DeepSeek V4 Flash Vision Exp API посвящён отдельному визуальному маршруту.