 AIREITER
До официального релиза анонимная модель ходила по сети под именем Ox Alpha. Теперь Z.ai раскрыла её публичную личность: GLM-5.3-Flash. Но слово «Flash» здесь важно трактовать аккуратно: на каждом токене модель задействует 18B параметров, тогда как опубликованный чекпойнт насчитывает примерно 320B и всё равно требует серьёзного железа для локального запуска.
Коротко: Ox Alpha была превью-версией GLM-5.3-Flash
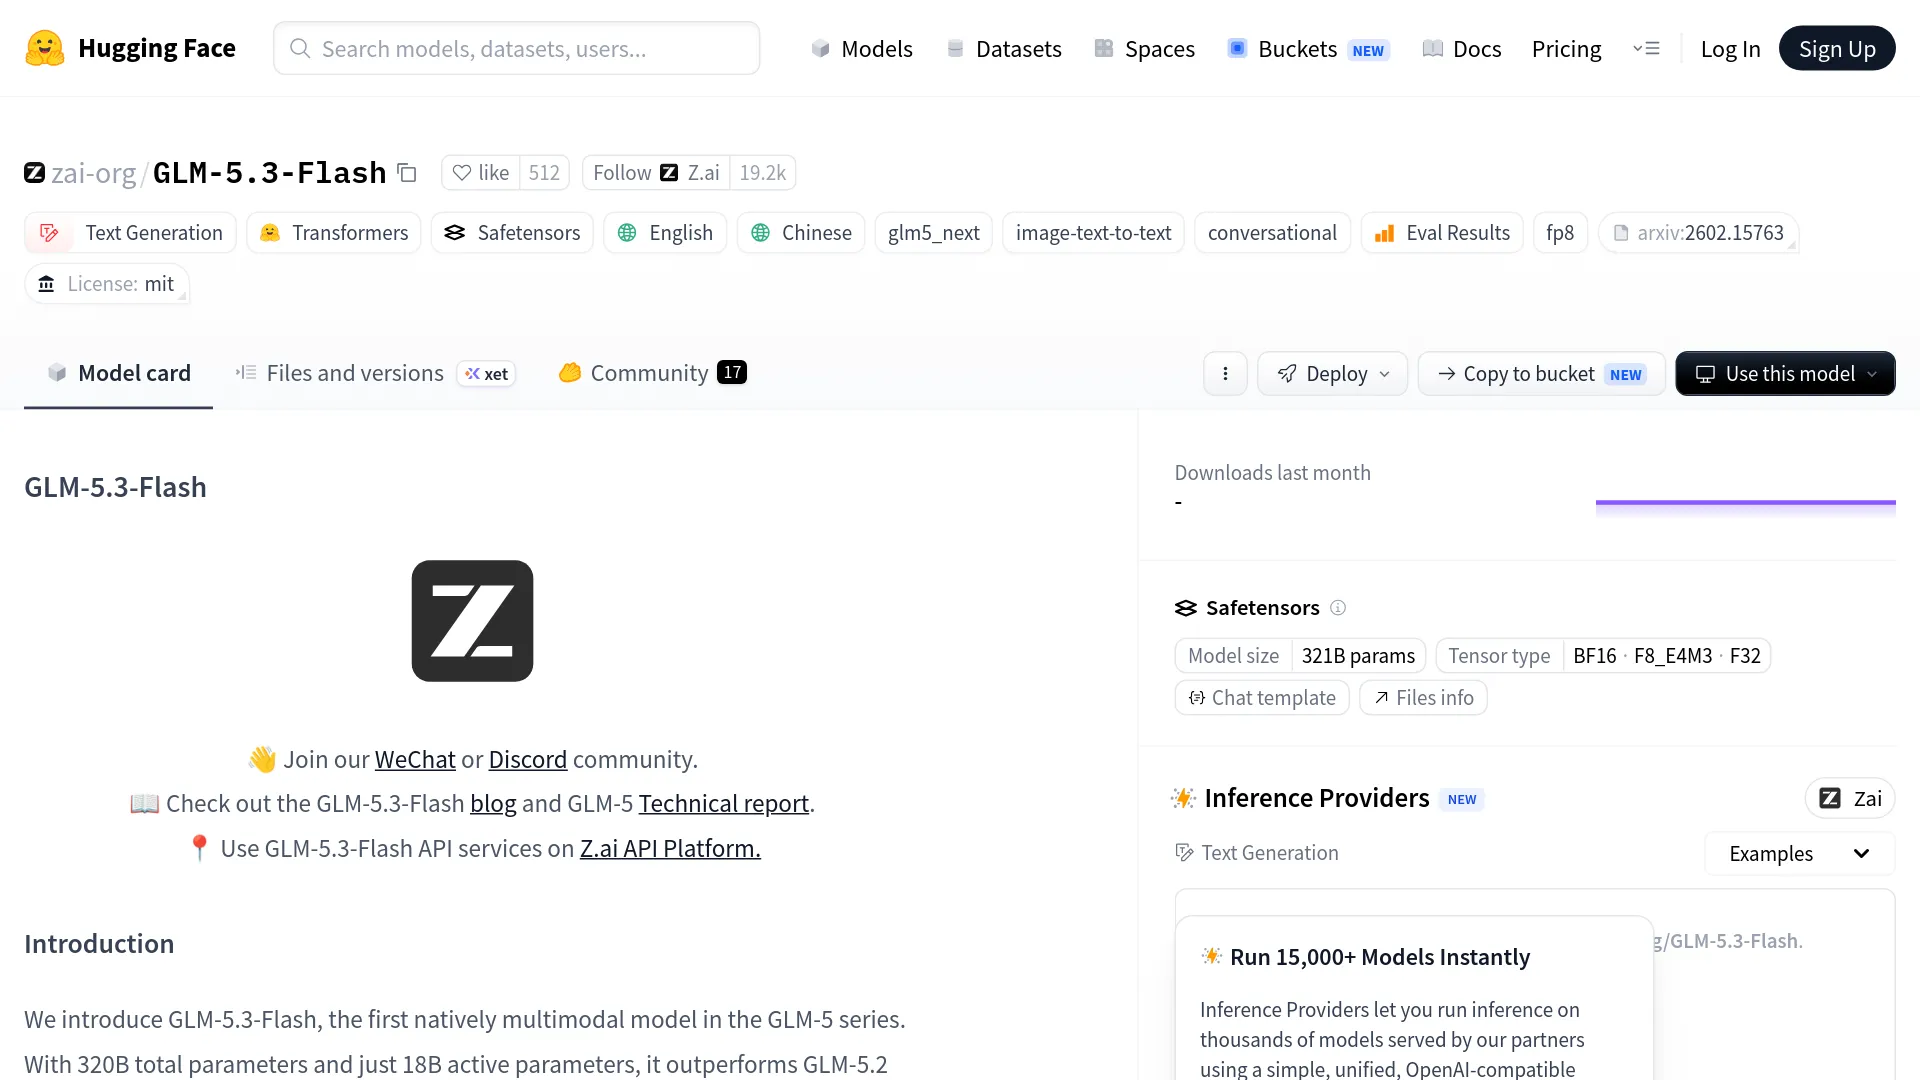
В анонсе от 26 августа 2026 года Z.ai подтвердила, что GLM-5.3-Flash — это модель, которую ранее анонимно тестировали под именем Ox Alpha в OpenCode и OpenRouter. На официальной странице модели на Hugging Face теперь опубликованы публичный чекпойнт, лицензия MIT, поддержка мультимодального ввода и ссылки на материалы для локального запуска.
Поэтому рассказы об Ox Alpha стоит воспринимать как данные о предварительном доступе, а не как окончательные характеристики выпущенной модели. У Ox Alpha были собственные маршрутизация, нагрузка и операционные ограничения, так что ранние отзывы о скорости, квотах и политиках могут не описывать работу каждого эндпоинта GLM-5.3-Flash.
«Для меня ничего не изменилось. Обе модели слишком большие для моей системы с 32 ГБ оперативной памяти». — u/dampflokfreund в r/LocalLLaMA
GLM-5.3-Flash в цифрах
| Характеристика | GLM-5.3-Flash |
|---|---|
| Официальный релиз | 26 августа 2026 года |
| Прежнее имя в превью | Ox Alpha / ox-alpha |
| Архитектура модели | 320B параметров всего, 18B активных на токен |
| Контекстное окно | 1 048 576 токенов (1M) |
| Входные данные | Текст, изображения и видео |
| Выходные данные | Текст |
| Лицензия | MIT |
| Официальный чекпойнт | zai-org/GLM-5.3-Flash |
| Указанная цена входных токенов API | $0.15 за 1M токенов |
| Указанная цена кешированных входных токенов | $0.03 за 1M токенов |
| Указанная цена выходных токенов API | $0.50 за 1M токенов |
На странице Hugging Face указан фактический размер модели — около 321B параметров, тогда как в описании используется сокращённая запись 320B-A18B. Эти цифры относятся соответственно к общему объёму параметров в чекпойнте и вычислениям на токен: 18B активных параметров не превращают модель в локальный вариант на 18B.
Что изменилось между Ox Alpha и публичным релизом
Z.ai сообщает, что до публичного релиза анонимно запускала GLM-5.3-Flash под именем Ox Alpha в OpenCode и OpenRouter, собирая обратную связь в реальных сценариях. В карточке OpenRouter превью описывалось как мультимодальная модель с длинным контекстом и временной ценой $0. Публичный релиз теперь позволяет однозначно связать модель с провайдером, чекпойнтом и лицензией.
При этом превью и выпущенная модель остаются разными операционными средами. Совпадение токенизатора или ошибок API в стиле GLM может указывать на происхождение модели, но не доказывает, что каждый анонимный запрос обрабатывался финальными весами и через тот же слой маршрутизации. Для развёртывания и воспроизводимых экспериментов теперь следует ориентироваться на публичный чекпойнт.
Что стоит за названием «Flash»
GLM-5.3-Flash сочетает разреженную архитектуру mixture-of-experts с изменениями в механизме внимания, призванными снизить стоимость работы с очень длинным контекстом. По данным Z.ai, модель включает 320B параметров всего, 18B активных параметров, 45 слоёв, гибридное разреженное и линейное внимание, механизм извлечения IndexPool и Manifold-Constrained Hyper-Connections (mHC). В карточке модели также указано, что для обучения использовался мультимодальный корпус на 30T токенов.
Z.ai заявляет о снижении вычислений для внимания в 3 раза и уменьшении KV-кеша в 4,4 раза при контексте 1M по сравнению с GLM-5.3. Это заявления об архитектуре от производителя, а не универсальная гарантия задержки на любом железе: реальная скорость зависит от длины контекста, количества параллельных запросов, обработки изображений и используемого стека инференса.
Нативная мультимодальность модели особенно интересна для агентских сценариев, а не просто для ярлыка «чат-бот с поддержкой зрения». Предполагаемый Z.ai цикл выглядит так: агент анализирует отрендеренный интерфейс, состояние браузера, документы или другие визуальные данные, а затем корректирует код или результат. В официальной карточке показана работа с изображениями, а документация публичной модели и развёртывания также описывает поддержку видео.
Что показывают бенчмарки — и чего они не показывают
В официальном релизе и карточке модели опубликованы сильные результаты, особенно в задачах программирования и работы агентов. Среди видимых показателей карточки — 84.3 в TerminalBench 2.1, 63.4 в DeepSWE и 55.3 в HLE. В материалах Z.ai также указаны 57 баллов в Artificial Analysis Intelligence Index, 48.8 в AutomationBench и 29.0 в Z.ai Code Bench в режиме максимального усилия.
| Бенчмарк | GLM-5.3-Flash | Сравнение или базовый показатель | Источник и ограничение |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2: 81.0; Claude Opus 4.8: 85.0 | Результат Z.ai/карточки модели; важны настройки стенда и лимиты |
| DeepSWE v1.1 | 63.4 | GLM-5.2: 46.2 | Опубликованная оценка; результат нельзя переносить на любой репозиторий |
| AutomationBench | 48.8 | GLM-5.2: 26.2 | Опубликованная оценка с указанной версией бенчмарка |
| Z.ai Code Bench, максимальное усилие | 29.0 | Claude Opus 4.8: 29.5 | Заявление о практически равном результате в конфигурации Z.ai |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai называет результат сопоставимым с Claude Opus 4.8 | Внешний индекс; набор задач не ограничен программированием |
Результаты получены на разных стендах, с разными ограничениями контекста, таймаутами и системами оценки. Поэтому их лучше сравнивать по направлению, а не превращать в единую универсальную таблицу лидеров. Самый осторожный вывод таков: есть убедительные свидетельства заметного превосходства GLM-5.3-Flash над GLM-5.2 в тестах для программных агентов, но это не означает, что модель обходит каждого конкурента на переднем крае.
То же относится к ранним пользовательским тестам. @prz_chojecki сообщил, что Ox Alpha решила все 226 задач ErdosBench лучше, чем GLM-5.2. Это полезное наблюдение для формирования собственных тестов, но не замена контролируемой проверке на ваших инструментах и репозитории.
Практические ограничения, с которыми столкнулись первые пользователи
В данном случае «Flash» надёжнее описывает объём активных вычислений и ценовое позиционирование, чем скорость интерактивной работы. Пользователи в обсуждениях r/opencodeCLI отмечали сильные результаты в программировании, но одновременно жаловались на долгие ожидания — особенно во время анонимного превью. Это наблюдения для конкретных провайдеров и нагрузок, а не официальные тесты задержки.
«Как её вообще можно называть “Flash”, если она намного медленнее основной модели?» — u/ahriad в r/opencodeCLI
Наиболее полезный операционный показатель — надёжность длительных агентских задач под нагрузкой. @solomonneas сообщил о 30 успешных сборках из 49 попыток за семидневный тест; 14 неудач завершились таймаутами. Это не доказывает фиксированный процент сбоев для официального API, но вполне оправдывает резервный маршрут для задач, способных выполняться часами.
Есть и ограничение для локального запуска, которое легко теряется за заголовками о бенчмарках: официальный чекпойнт FP8 занимает около 306 GiB ещё до учёта накладных расходов рантайма и KV-кеша. Поэтому модель с 320B параметров требует инфраструктуру с большим объёмом памяти, даже если на каждом токене активно только 18B параметров.
API, облачный доступ и варианты локального запуска
Для облачного использования на странице цен Z.ai указана стоимость GLM-5.3-Flash: $0.15 за 1M входных токенов, $0.03 за 1M кешированных входных токенов и $0.50 за 1M выходных токенов. Временная акция со скидкой 50% устанавливает цены $0.075 за вход, $0.015 за кешированный вход и $0.25 за выход; она действует до 24:00 9 сентября 2026 года, UTC+8. Перед расчётом бюджета проверьте официальную таблицу цен Z.AI: у акции есть дата окончания.
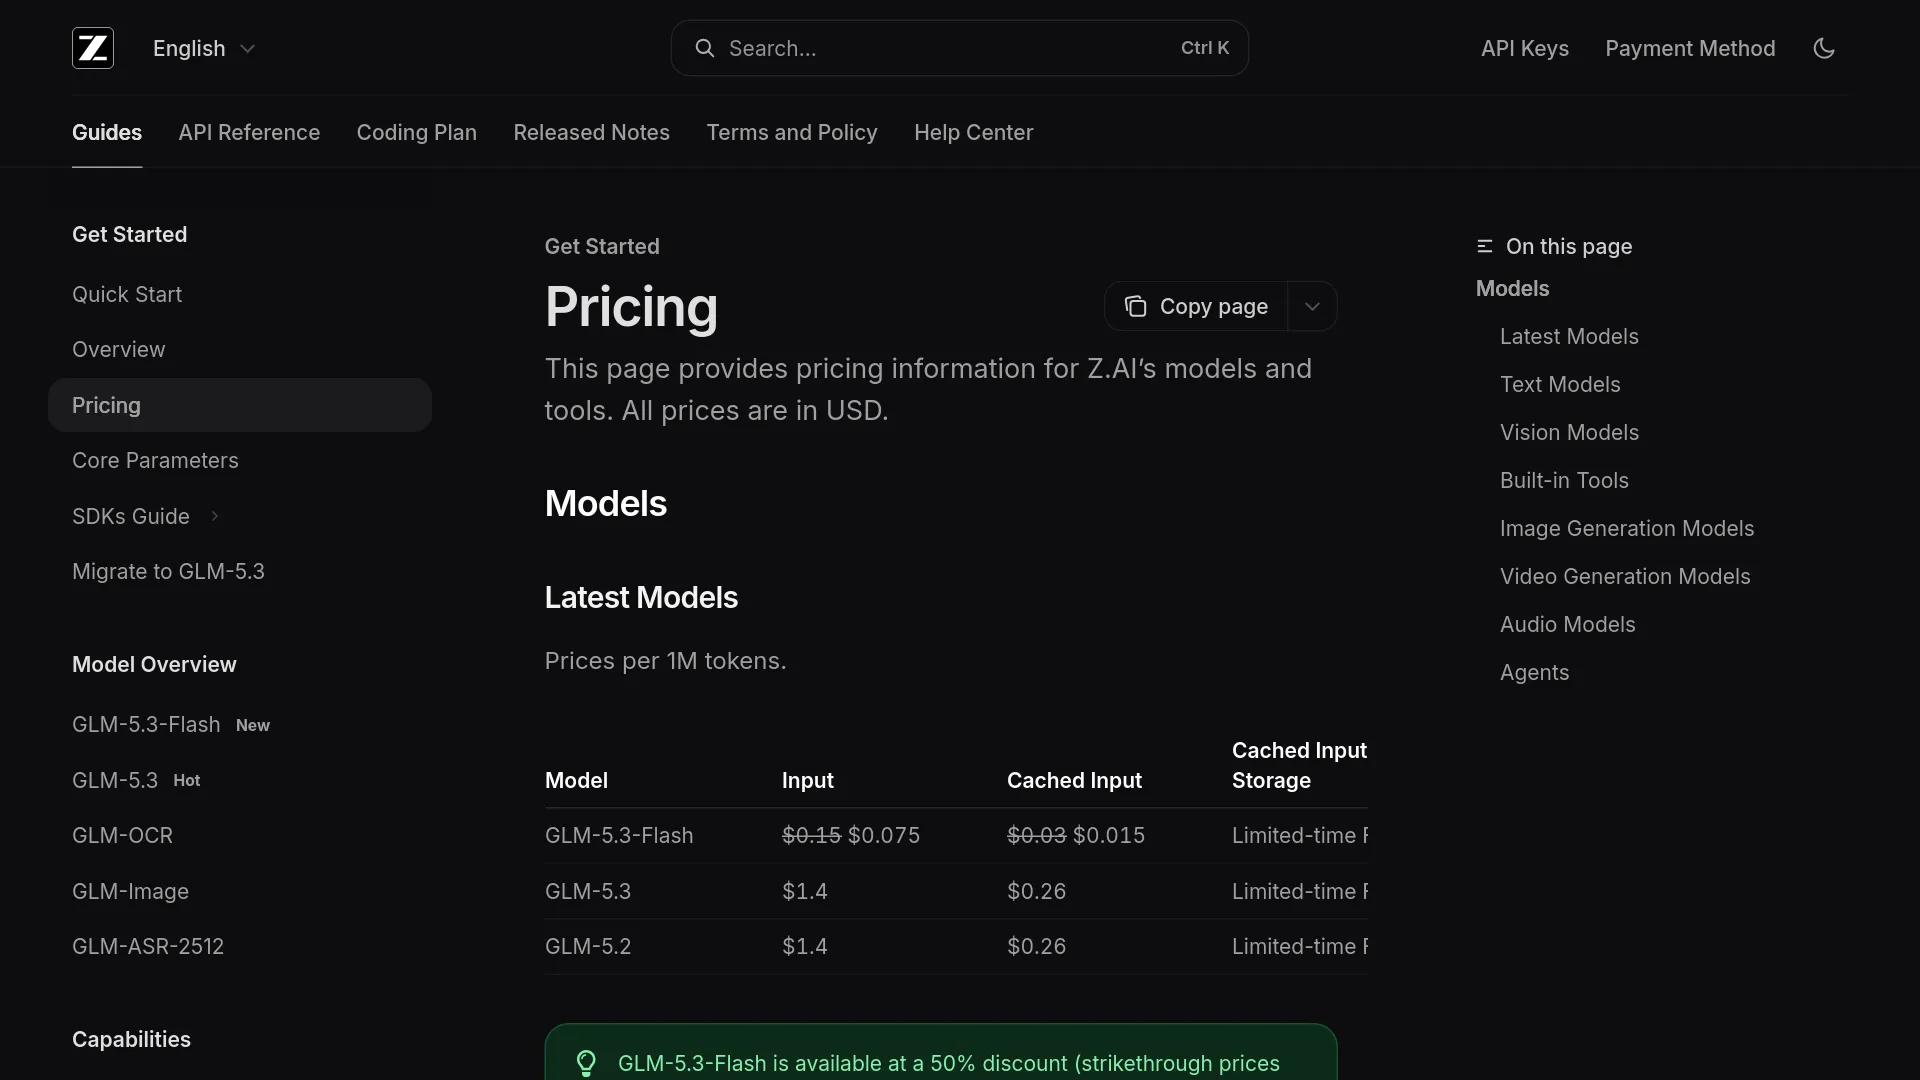
Публичный тариф не следует путать с временной ценой превью Ox Alpha. Например, 10M входных и 2M выходных токенов по стандартному тарифу обойдутся в $2.50 без учёта возможных дополнительных комиссий провайдера: 10 × $0.15 + 2 × $0.50. Если провайдер считает часть входных токенов кешированными, стоимость входа может быть ниже.
Локальный запуск возможен, но это скорее инфраструктурный проект, чем скачивание модели на ноутбук. В официальном рецепте vLLM указано около 306 GiB для весов FP8 и 386GB VRAM для стандартного развёртывания FP8; для BF16 требуется 772GB. В поддерживаемом сценарии сейчас нужны видеокарты NVIDIA Hopper или новее, свежая версия FlashInfer и специальный образ vLLM, пока интеграция дорабатывается.
В руководстве KTransformers описаны гетерогенный инференс на CPU и GPU, прямая загрузка официальных весов FP8 и как минимум 350GB свободной системной памяти. Пример для одной видеокарты использует конфигурацию с выгрузкой части модели, а не доказывает, что одна потребительская GPU способна вместить модель целиком. В руководстве также применяется проверенная настройка на 501 025 токенов и установлен лимит мультимодального запроса: либо восемь изображений, либо одно видео.
| Способ развёртывания | Что подтверждает документация | Главное ограничение |
|---|---|---|
| Z.ai API | Облачный доступ с оплатой по использованию; опубликованы стандартные и акционные тарифы | Нужно проверить лимиты, региональные условия и текущий статус акции |
| vLLM | Запуск FP8/BF16, OpenAI-совместимый эндпоинт, тензорный параллелизм, мультимодальный режим | Требуется NVIDIA-инфраструктура с большим объёмом памяти; текущий рецепт рассчитан на Hopper+ |
| KTransformers | Гетерогенный инференс CPU-GPU и загрузка FP8 | Около 306 GiB под веса; рекомендуется как минимум 350GB системной памяти |
| Экосистема Ollama/LM Studio/llama.cpp | В карточке модели есть ссылки на квантизированные дистрибутивы и совместимые инструменты | Поддержка квантованных вариантов и скорость зависят от конкретной сборки |
Кому уже стоит использовать GLM-5.3-Flash
Для экономичных программных агентов и пилотных проектов с длинным контекстом. Низкая стандартная цена, контекст 1M и заявленное превосходство над GLM-5.2 делают модель сильным кандидатом для анализа репозиториев, изменений в нескольких файлах, генерации тестов и повторяющихся агентских вызовов. Пока стабильность на ваших задачах не подтверждена, оставьте в контуре приёмочные тесты и резервную модель.
Для мультимодальных технических задач, где текстовые модели GLM становятся узким местом. Входные изображения и видео позволяют агенту анализировать результат работы браузера, интерфейсы, диаграммы, документы и другие отрендеренные материалы. Это не генератор видео: модель анализирует визуальный ввод и возвращает текст или код.
Не выбирайте модель только потому, что «18B активных» звучит как характеристика десктопной модели. Полный чекпойнт насчитывает примерно 320B параметров, а локальный запуск требует сотни гигабайт дискового пространства или памяти ещё до учёта контекста и накладных расходов рантайма. Если у вас уже нет инфраструктуры для инференса с большим объёмом памяти, облачный API обычно будет проще и экономичнее.
Не отправляйте конфиденциальный код на непроверенный эндпоинт превью. Публичный релиз GLM-5.3-Flash однозначно связан с Z.ai, но условия провайдера, хранение данных и маршрутизация по-прежнему важны. Для рабочего трафика зафиксируйте действующую политику обработки данных эндпоинта и используйте официальный API либо провайдера с условиями, которые можно проверить.
FAQ
Ox Alpha и GLM-5.3-Flash — это абсолютно одна и та же модель?
Z.ai официально подтвердила, что GLM-5.3-Flash — модель, ранее доступная в превью под именем Ox Alpha. Раннее поведение Ox Alpha остаётся полезным ориентиром, но маршрутизацию и лимиты превью нельзя считать характеристиками публичной модели.
GLM-5.3-Flash — это open source?
Официальный чекпойнт на Hugging Face выпущен под лицензией MIT, а Z.ai предоставляет материалы для локального запуска. Точнее говорить об «открытых весах»: веса доступны, но запуск полной модели всё равно требует серьёзной инфраструктуры.
Сколько памяти нужно GLM-5.3-Flash для локального запуска?
Официальные веса FP8 занимают около 306 GiB без учёта рантайма и KV-кеша. В рецепте vLLM указано 386GB VRAM для стандартного развёртывания FP8, а KTransformers рекомендует как минимум 350GB системной памяти для гетерогенного инференса.
API действительно стоит $0.15 за миллион входных токенов?
Да. На официальной странице цен Z.AI указаны $0.15 за вход, $0.03 за кешированный вход и $0.50 за выход; акция со скидкой 50% действует, согласно указанным условиям, до 9 сентября 2026 года, UTC+8.
GLM-5.3-Flash быстрее других моделей с приставкой Flash?
Имеющихся данных недостаточно, чтобы установить универсальный рейтинг по задержке. Ранние пользователи сообщали о медленных агентских сессиях и таймаутах, поэтому на собственном маршруте провайдера измеряйте время до первого токена, длительность выполнения, количество повторных попыток и долю принятых задач.
Поддерживает ли GLM-5.3-Flash изображения и видео?
Да. Z.ai и официальная карточка модели описывают ввод текста, изображений и видео с текстовым выводом. Документация локального запуска также устанавливает ограничения: в описанной конфигурации KTransformers запрос может содержать до восьми изображений или одно видео.
Используйте облачный API, если хотите получить низкую стоимость и мультимодальность GLM-5.3-Flash без покупки инференс-сервера с памятью в несколько сотен гигабайт; локальный запуск имеет смысл тестировать только при наличии такой инфраструктуры. Для долгих агентских задач держите проверенный резервный вариант: опубликованные данные гораздо убедительнее подтверждают возможности и цену модели, чем её стабильность в длительной интерактивной работе.