 AIREITER
Если вы ищете альтернативы GLM-5-3-Flash, то наверняка уже разобрались с историей выхода Ox Alpha. Теперь важнее другое: чем заменить недорогой, но временами медленный агентский маршрут, как не связываться с локальным чекпойнтом на 320B параметров и сохранить мультимодальные сценарии без полной переделки API-клиента. Универсального ответа нет — подходящая замена зависит от того, какую именно проблему вы решаете.
Коротко: выбирайте модель под конкретный недостаток
DeepSeek V4 Flash подойдет для гибкой работы с текстом, когда важны цена при попадании в кэш, возможность отключить режим рассуждений и высокая параллельность. Модель поддерживает контекст на 1M токенов и до 2 500 одновременных запросов. Официальная цена в непиковые часы — $0.22 за миллион некэшированных входных токенов и $0.66 за миллион выходных.
Qwen3.8-Flash стоит тестировать как облачную замену, если вам нужны изображения и видео, совместимость API и встроенные инструменты. Заявленная стоимость — $0.15 за миллион входных токенов и $0.47 за миллион выходных.
GLM-5.3 — логичный шаг внутри той же экосистемы Z.ai, если возможностей флагманской текстовой модели достаточно, а Flash уже не хватает. GPT-5.6 Terra и Claude Opus 4.8 относятся к премиум-классу: их имеет смысл подключать там, где еще одна успешно завершенная задача оправдывает многократно больший счет. Kimi K3 предлагает контекст на 1M токенов, но дешевой заменой не является.
Вопрос не в том, «какая модель победит». Сначала определите, что вы оптимизируете: стоимость токенов, работу с изображениями, длительные coding-сессии, локальный контроль или долю принятых задач.
Эндпоинт Ox Alpha закрыт: начните с проверки миграции
Официальный анонс Z.ai подтвердил, что анонимный превью-эндпоинт Ox Alpha был моделью GLM-5.3-Flash, 26 августа 2026 года. В публичном релизе появился именованный чекпойнт, опубликованные тарифы, модель на Hugging Face с лицензией MIT и документированный API-доступ. Старую preview-среду не стоит воспринимать как постоянный контракт: маршрутизация, квоты, задержки и политика обработки запросов у превью и выпущенного API могут отличаться.
Если конфигурация все еще обращается к stealth/ox-alpha, публичный идентификатор OpenRouter — z-ai/glm-5.3-flash. Для прямых запросов к Z.ai используется общий базовый URL https://api.z.ai/api/paas/v4. У Z.ai есть отдельный эндпоинт Coding Plan — https://api.z.ai/api/coding/paas/v4, поэтому не рассчитывайте, что у подписочного маршрута и общего API одинаковые биллинг и лимиты.
В обзоре GLM-5.3-Flash на AIReiter разобрана базовая модель, включая разницу между 18B активных параметров и примерно 320B параметров во всем чекпойнте. Здесь мы отвечаем на следующий вопрос: чем заменить ее, если больше не устраивают стоимость, скорость, требования к железу или надежность?
«Для меня ничего не изменилось. Обе модели слишком большие для моей системы с 32 ГБ оперативной памяти». — u/dampflokfreund, r/LocalLLaMA
Сравнение альтернатив: цена, контекст и способ развертывания
Цены ниже — снимок тарифов, опубликованных провайдерами и проверенных 28 августа 2026 года. Это не единая акция для всех моделей: DeepSeek меняет ставки в зависимости от пиковых и непиковых часов, а цена Flash у Z.ai учитывает временную скидку, действующую до 9 сентября 2026 года, 24:00 UTC+8.
| Модель | Вход / 1M токенов | Выход / 1M токенов | Контекст | Входные модальности | Когда выбирать |
|---|---|---|---|---|---|
| DeepSeek V4 Flash | $0.22 вне пиковых часов; $0.44 в пиковые | $0.66 вне пиковых часов; $1.32 в пиковые | 1M | Текст | Учет кэша и режим без рассуждений |
| Qwen3.8-Flash | $0.15 | $0.47 | 1M | Текст, изображения, видео | Облачная мультимодальность и совместимость API |
| GLM-5.3 | $1.40 | $4.40 | 1M | Текст | Та же платформа, но более производительная модель |
| GPT-5.6 Terra | $2.00 | $12.00 | 1.05M | Текст | Более надежная работа со сложными агентскими задачами |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Текст | Сложный кодинг и анализ длинного контекста |
| Kimi K3 | $3.00 | $15.00 | 1M | Текст | Задачи, где важны длинный контекст и возможности модели |
Сейчас Z.ai указывает для GLM-5.3-Flash цену $0.075 за миллион входных токенов, $0.015 за миллион кэшированных входных токенов и $0.25 за миллион выходных в рамках 50%-ной акции. Без скидки тарифы составляют $0.15, $0.03 за кэшированные входные токены и $0.50 соответственно. На сравнительном графике используется обычная цена, а не временный промотариф. (Тарифы Z.ai)
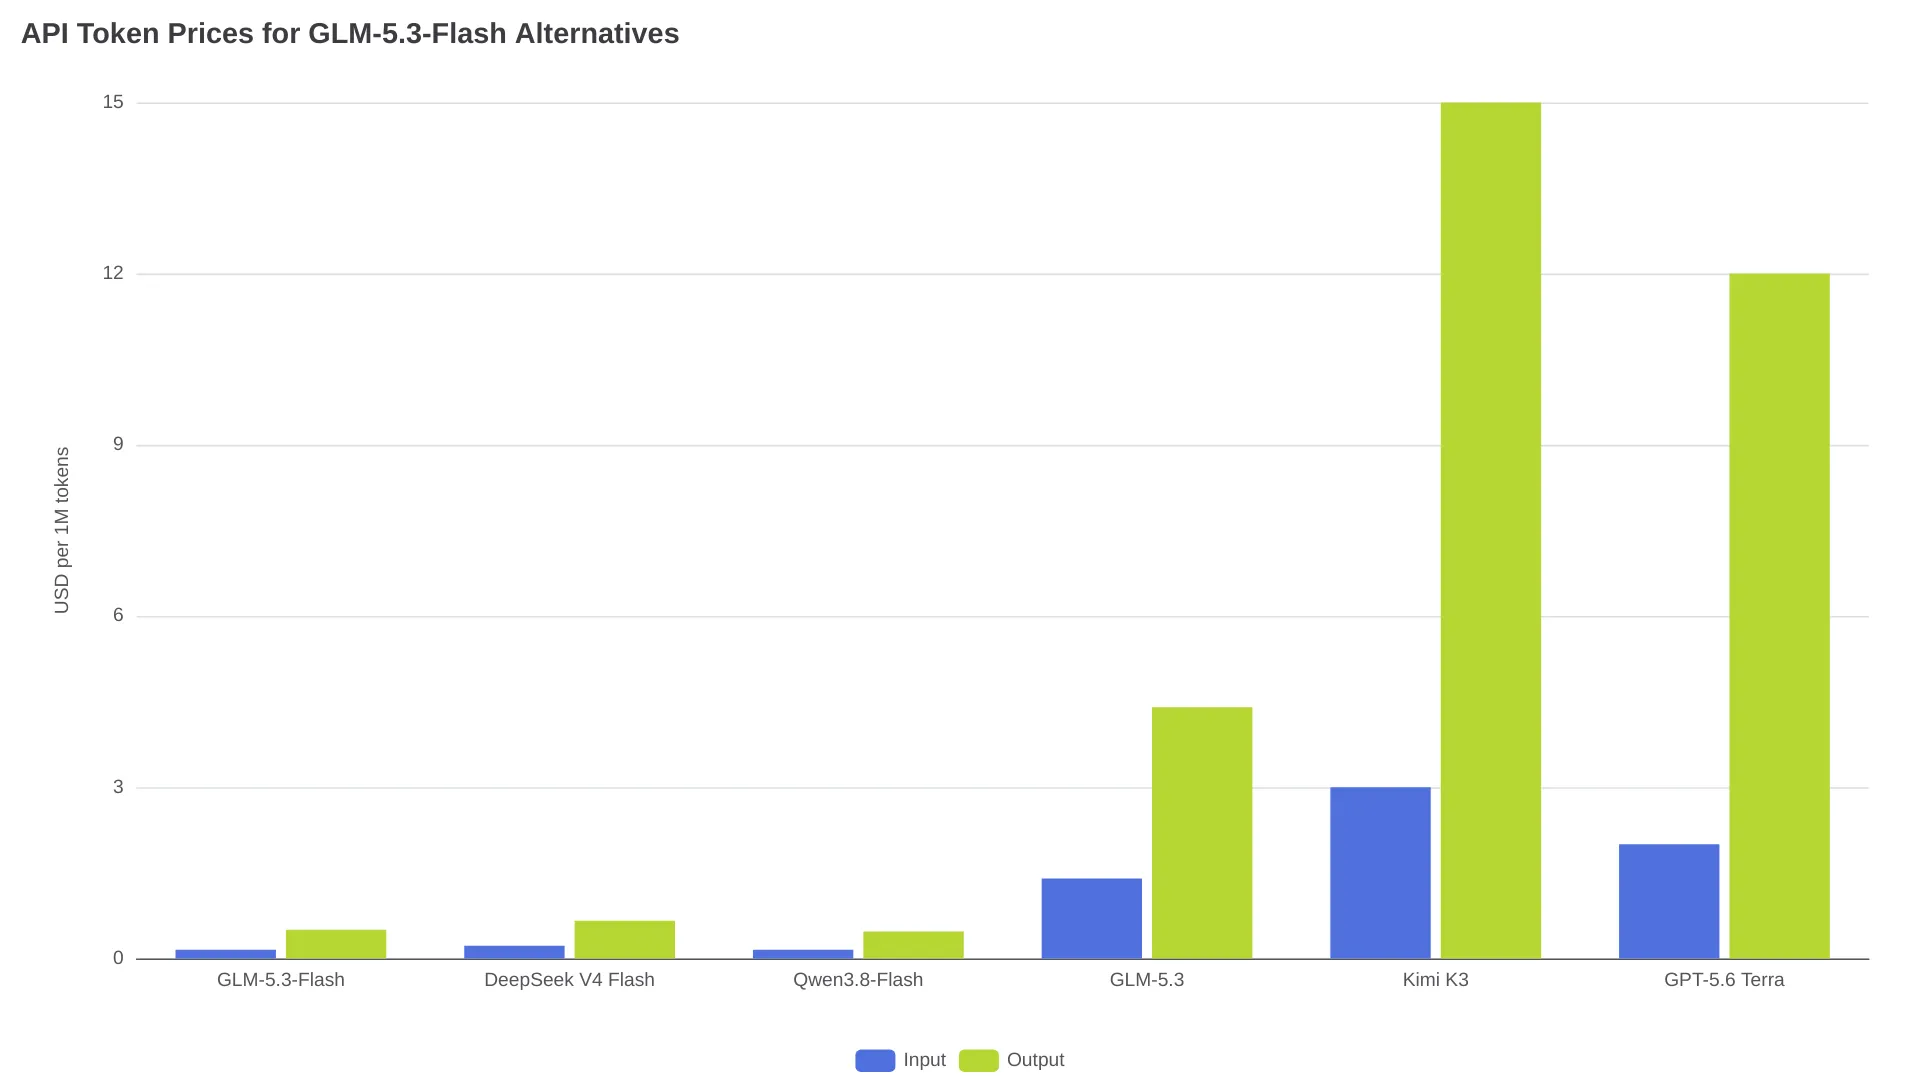
Основа сравнения: обычная цена GLM-5.3-Flash, официальная непиковая цена DeepSeek V4 Flash и актуальные тарифы провайдеров для остальных строк. Пиковая цена DeepSeek вдвое выше непиковой.
Шесть практичных вариантов замены
DeepSeek V4 Flash: текст и кодинг с учетом кэша
DeepSeek V4 Flash — первая модель, которую стоит проверить, если GLM-5.3-Flash оказывается слишком дорогой для обычного текстового трафика. DeepSeek заявляет контекст на 1M токенов, максимум 384K выходных токенов, JSON-вывод, вызов инструментов, Responses API и совместимость с API Anthropic. Официальный лимит параллельности — 2 500 запросов.
Здесь важна именно схема биллинга. DeepSeek разделяет попадания и промахи кэша, а в будние пиковые интервалы — 01:00–04:00 и 06:00–10:00 UTC — удваивает тарифы. Кроме того, доступны режимы с рассуждениями и без них. В карточке GLM-5.3-Flash на Hugging Face вместо простого режима без рассуждений описаны уровни reasoning effort: low, high и max.
DeepSeek V4 Flash хорошо подходит для запросов с повторяющимся контекстом, чатов с активным поиском по данным и текстового кодинга, где важны кэширование или управляемые рассуждения. При этом Qwen3.8-Flash предлагает более низкие заявленные тарифы для свежих токенов, поэтому DeepSeek не будет автоматически самым дешевым вариантом для любого текстового запроса. Это и не визуальная замена один в один: обработка изображений вынесена в отдельный маршрут DeepSeek — deepseek-v4-flash-vision-exp, а токены, полученные из изображения, тарифицируются как входные.
Qwen3.8-Flash: наиболее близкая облачная мультимодальная замена
Qwen3.8-Flash — самый очевидный облачный кандидат для тестирования, если агент работает со скриншотами, графиками или видео, а переписывать интеграцию не хочется. QwenCloud заявляет поддержку изображений, текста и видео, контекст на 1M токенов, максимум 991K входных и 131K выходных токенов. Модель совместима с API OpenAI и Anthropic, поддерживает инструменты, структурированный вывод, кэширование, пакетную обработку, веб-поиск и дообучение.
Компромисс связан с устройством кэша. QwenCloud указывает $0.016 за миллион токенов при чтении неявного кэша, $0.20 за создание явного кэша и $0.47 за выходные токены. Опубликованные лимиты составляют 2M токенов в минуту и 15 000 запросов в минуту, однако на странице не уточняется, относятся ли они к аккаунту, ключу, организации или конкретному развертыванию.
Выбирайте Qwen3.8-Flash, если без визуального ввода не обойтись или важна цена свежих токенов. На официальной странице модели нет таблицы с именованными бенчмарками, результатов по задержке или исследования надежности длинных сессий. Поэтому проверяйте ее на собственных трейcах агента и не принимайте совпадение функций за полное поведенческое соответствие.
GLM-5.3: переход на более мощную модель внутри той же семьи
GLM-5.3 — не бюджетная альтернатива, а разумный апгрейд, когда проблема заключается в недостаточной глубине текстового анализа, а не в цене или мультимодальности. В тарифной таблице Z.ai указаны $1.40 за миллион входных токенов, $0.26 за миллион кэшированных входных и $4.40 за миллион выходных — примерно на порядок выше обычной цены Flash.
Z.ai позиционирует GLM-5.3 как флагманскую coding-модель, тогда как GLM-5.3-Flash — как более дешевую нативно мультимодальную модель. Используйте GLM-5.3 точечно для сложных текстовых задач: переход на нее может убрать визуальный сценарий, ради которого Flash и выбирали.
GPT-5.6 Terra: когда важнее надежно завершить агентскую задачу
GPT-5.6 Terra — премиальный вариант для команд, которым важнее доведение сложной задачи до результата, чем минимальная цена токенов. OpenAI указывает $2 за миллион входных токенов, $0.20 за миллион кэшированных входных и $12 за миллион выходных при размере контекста примерно 1.05M токенов. В опубликованной Z.ai таблице бенчмарков GPT-5.6 Terra получает 87.4 на Terminal-Bench 2.1 и 69.6 на DeepSWE v1.1 — выше, чем GLM-5.3-Flash с результатами 84.3 и 63.4 в указанных условиях.
Эти показатели оправдывают тестирование Terra там, где провал в coding-задаче обходится дороже увеличенного счета API. Но они не доказывают универсальное превосходство модели в продакшене. Рассматривайте ее как следующий уровень для ценных изменений в репозиториях и сложной автономной работы.
Claude Opus 4.8: сложный кодинг и анализ длинного контекста
Claude Opus 4.8 стоит $5 за миллион входных токенов и $25 за миллион выходных по стандартным глобальным тарифам Anthropic. Также Anthropic указывает $0.50 за миллион токенов при чтении кэша, а пакетная обработка обходится в половину стандартной цены входных и выходных токенов.
В сравнительной таблице Z.ai Opus 4.8 опережает GLM-5.3-Flash на Terminal-Bench 2.1, Agents’ Last Exam, HLE with Tools и NL2Repo, тогда как Flash выигрывает в нескольких сценариях с активным использованием инструментов и автоматизацией. Поэтому Opus разумнее подключать как проверенный уровень эскалации, а не назначать универсальной моделью по умолчанию.
Kimi K3: контекст 1M для сложных задач, но не для экономии
Kimi K3 попал в этот список по другой причине: он подходит тем, кому нужен маршрут с контекстом 1M токенов для длительных инженерных или исследовательских процессов. Kimi указывает $0.30 за миллион кэшированных входных токенов, $3 за миллион входных и $15 за миллион выходных.
При таких тарифах Kimi K3 стоит выбирать только в том случае, если его контекст и набор возможностей оправдывают премию. Это не ответ на вопрос «как снизить счет за токены».
Выбирайте модель по рабочей нагрузке, а не по месту в рейтинге
| Задача или ограничение | С чего начать | Почему |
|---|---|---|
| Массовая классификация или извлечение данных из текста | Qwen3.8-Flash | Более низкие заявленные тарифы на свежие входные и выходные токены, чем у DeepSeek V4 Flash в непиковые часы |
| Длинный текст с повторяющимися префиксами | DeepSeek V4 Flash | Тарифы при попадании в кэш и возможность отключить рассуждения |
| Длинный текст с преимущественно новым содержимым | Qwen3.8-Flash | Более низкие заявленные тарифы на свежие токены |
| Скриншоты, графики или видео в API-сценарии | Qwen3.8-Flash | Нативный ввод изображений и видео, знакомые API-протоколы |
| Та же экосистема Z.ai, но более сложное текстовое рассуждение | GLM-5.3 | Провайдер сохраняется, но модель поднимается на уровень выше |
| Кодинг, где ошибка дорого обходится | GPT-5.6 Terra | Премиальный вариант с более высокими заявленными результатами в coding-бенчмарках |
| Внимательная проверка кода или планирование изменений в репозитории | Claude Opus 4.8 | Премиальное рассуждение, кэширование и пакетная обработка |
| Длинные задачи, где контекст важнее цены | Kimi K3 | Позиционирование как модель с контекстом 1M |
| Обычный ноутбук или рабочая станция с 32 ГБ | Сначала облачный API | GLM-5.3-Flash — это чекпойнт примерно на 320B параметров, а не локальная модель на 18B |
Ограничения локального запуска здесь существенны. В официальном описании чекпойнт GLM-5.3-Flash содержит примерно 320B параметров; в обзоре развертывания AIReiter указаны объем около 306 GiB в FP8 и примерно 386GB видеопамяти для конфигурации vLLM по умолчанию. Квантизация снижает требования, но не превращает модель в обычную загрузку для ноутбука.
Более безопасная схема миграции агентских систем
Вынесите адаптер провайдера отдельно от маршрутизации задач, а затем проверяйте замену на тех сценариях, которые действительно важны.
- Сохраните единый интерфейс запросов. Если провайдер это поддерживает, оставьте слой сообщений, инструментов и структурированного вывода, совместимый с OpenAI. Управление рассуждениями, визуальные payload, вызовы инструментов, структурированный вывод и ограничения контекста оформите как отдельные capability flags, а не как универсальные поля.
- Проверяйте принятые задачи, а не только сгенерированный текст. Фиксируйте, собирается ли код, корректен ли вызов инструмента, проходит ли визуальная проверка и завершается ли задача без повторной попытки. Дешевый первый ответ, которому требуются два повторных запуска на репозитории, может оказаться вовсе не дешевле.
- Маршрутизируйте запросы по типу сбоя. Повторяющийся текстовый контекст отправляйте в DeepSeek V4 Flash, мультимодальные запросы — в Qwen3.8-Flash, а рискованные coding-задачи — в GPT-5.6 Terra, Claude Opus 4.8 или GLM-5.3 в зависимости от результатов ваших проверок.
- Оставьте резервный маршрут. В обзоре AIReiter зафиксирован семидневный общественный тест: 30 успешных сборок из 49 попыток и 14 сбоев по тайм-ауту. Это не универсальный показатель отказов провайдера, но достаточная причина не запускать production-агента на одном-единственном маршруте.
- Считайте бюджет по обычным тарифам. Акция Z.ai для Flash заканчивается 9 сентября 2026 года. Ставки DeepSeek меняются в зависимости от пикового окна. У Qwen создание кэша и чтение кэшированных данных тарифицируются по-разному. Миграция, которая окупается только во время временной акции, не дает стабильной модели расходов.
Для первого прогона можно взять десять обычных или преимущественно текстовых запросов и еще десять задач с кодом, инструментами или визуальным вводом. Сравните долю принятых задач, общее время выполнения, количество повторов и суммарные расходы на токены. Для многих команд это означает тестирование DeepSeek V4 Flash на текстовых задачах с повторяющимся контекстом и Qwen3.8-Flash в мультимодальных сценариях, при этом GLM-5.3-Flash стоит сохранить как резерв, пока новые маршруты не докажут свою надежность.
FAQ
Какая бесплатная альтернатива Ox Alpha лучшая?
Среди проверенных здесь официальных источников нет постоянной бесплатной замены, не привязанной к конкретному провайдеру. Квоты и акции могут меняться, но для production-решения следует ориентироваться на опубликованные платные тарифы, а бесплатный доступ считать приятным бонусом.
Какая альтернатива поддерживает изображения и видео?
Qwen3.8-Flash официально заявляет поддержку изображений, текста и видео. Обычный маршрут DeepSeek V4 Flash отличается от deepseek-v4-flash-vision-exp, поэтому перед миграцией визуального агента обязательно проверьте конкретный эндпоинт.
Какую альтернативу можно запустить локально?
К моделям с открытыми весами относятся чекпойнт GLM-5.3-Flash и Qwen3.8-Flash-Next. В GLM-5.3-Flash примерно 320B параметров, а в документации Qwen для открытой модели Flash-Next указан нативный контекст 262K, который можно расширить до 1M с помощью YaRN. Ни одну из этих моделей не стоит считать подходящей для компьютера с 32 ГБ.
Как избежать сюрпризов после смены провайдера?
Запустите 20 репрезентативных задач через два маршрута и сравните долю принятых задач, общее время выполнения, количество повторов и суммарные расходы на токены. Сохраняйте текущий маршрут GLM-5.3-Flash как резервный, пока новая модель не покажет надежный результат на ваших инструментах и репозиториях.