 AIREITER
Нужно превратить запись в нормальный текст или вывести субтитры с микрофона практически без задержки? Gemini 3.5 Transcribe стоит рассмотреть: модель умеет очищать расшифровки, учитывать пользовательский словарь и работать с несколькими языками. Но у двух API-сценариев совершенно разные ограничения. Для готовых записей лучше подходит файловый API, а Live API рассчитан на короткие сессии с минимальной задержкой.
Коротко: выбирайте File API, если вам не нужны субтитры в реальном времени
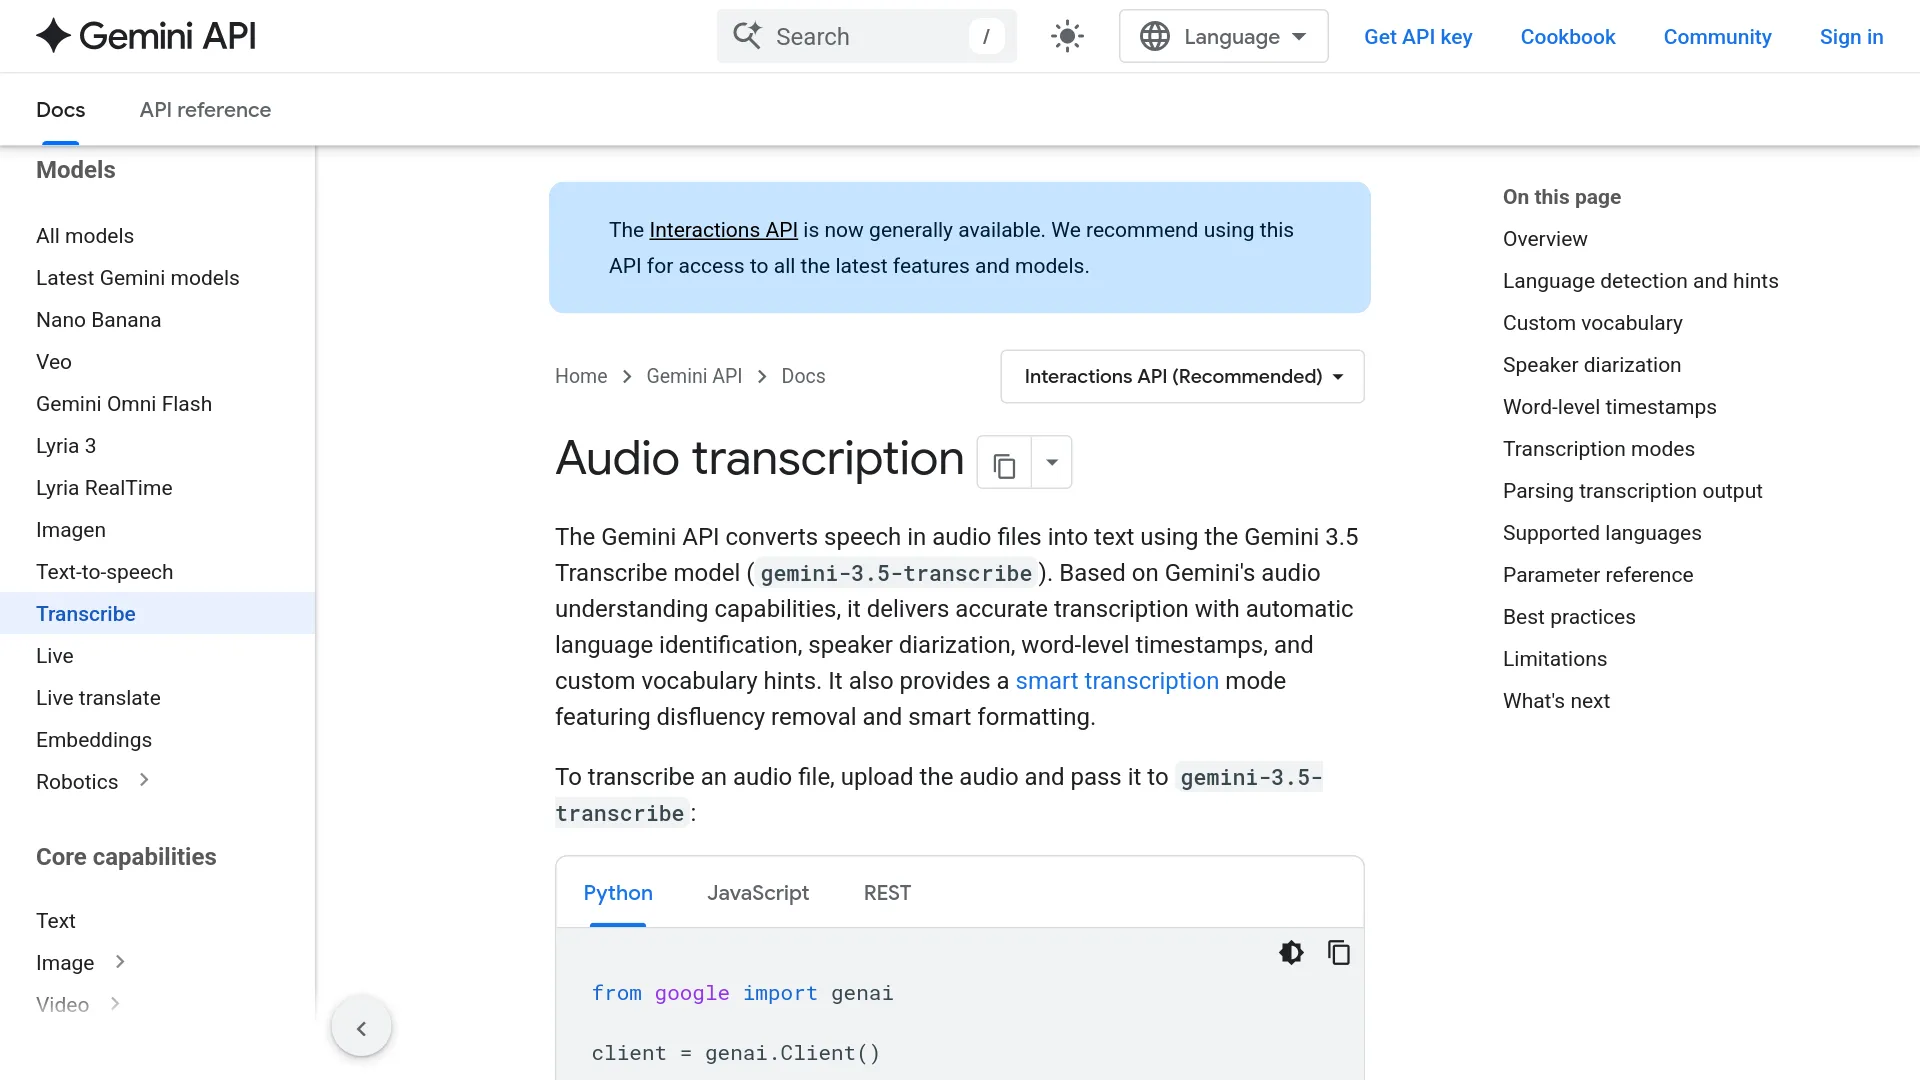
Gemini 3.5 Transcribe — специализированное семейство моделей Google для преобразования речи в текст. С 26 августа 2026 года оно доступно в режиме public preview. Для записанного и потокового аудио Google описывает разные идентификаторы моделей, способы подключения, события вывода и ограничения.
| Задача | Идентификатор модели | API | Главное ограничение |
|---|---|---|---|
| Встречи, звонки, загруженные записи | gemini-3.5-transcribe | Interactions API | До 1 часа для стандартного unary-запроса; 30 минут при диаризации или таймкодах слов |
| Субтитры в реальном времени, микрофон, голосовой интерфейс | gemini-3.5-transcribe-live | Live API | Непрерывная сессия до 10 минут; нет live-диаризации и таймкодов на уровне слов |
Для архива встреч, анализа звонков и подготовки субтитров начинайте с gemini-3.5-transcribe. Для предпросмотра субтитров или интерфейса push-to-talk используйте gemini-3.5-transcribe-live. Рабочие процессы для записи и потокового аудио описаны отдельно в руководстве Google по транскрибации записанного аудио и документации Live API.
Пока только preview
Google представила Gemini 3.5 Transcribe 26 августа 2026 года. API для разработчиков доступен в режиме public preview через Google AI Studio и Google Antigravity. Корпоративный доступ также заявлен в preview-режиме через Gemini Enterprise Agent Platform. Это означает, что региональная доступность, квоты и стабильность могут отличаться от показателей полноценного коммерческого сервиса распознавания речи. Перед запуском серьёзных объёмов протестируйте модель на типичных для вас записях.
Сколько стоит Gemini 3.5 Transcribe на практике
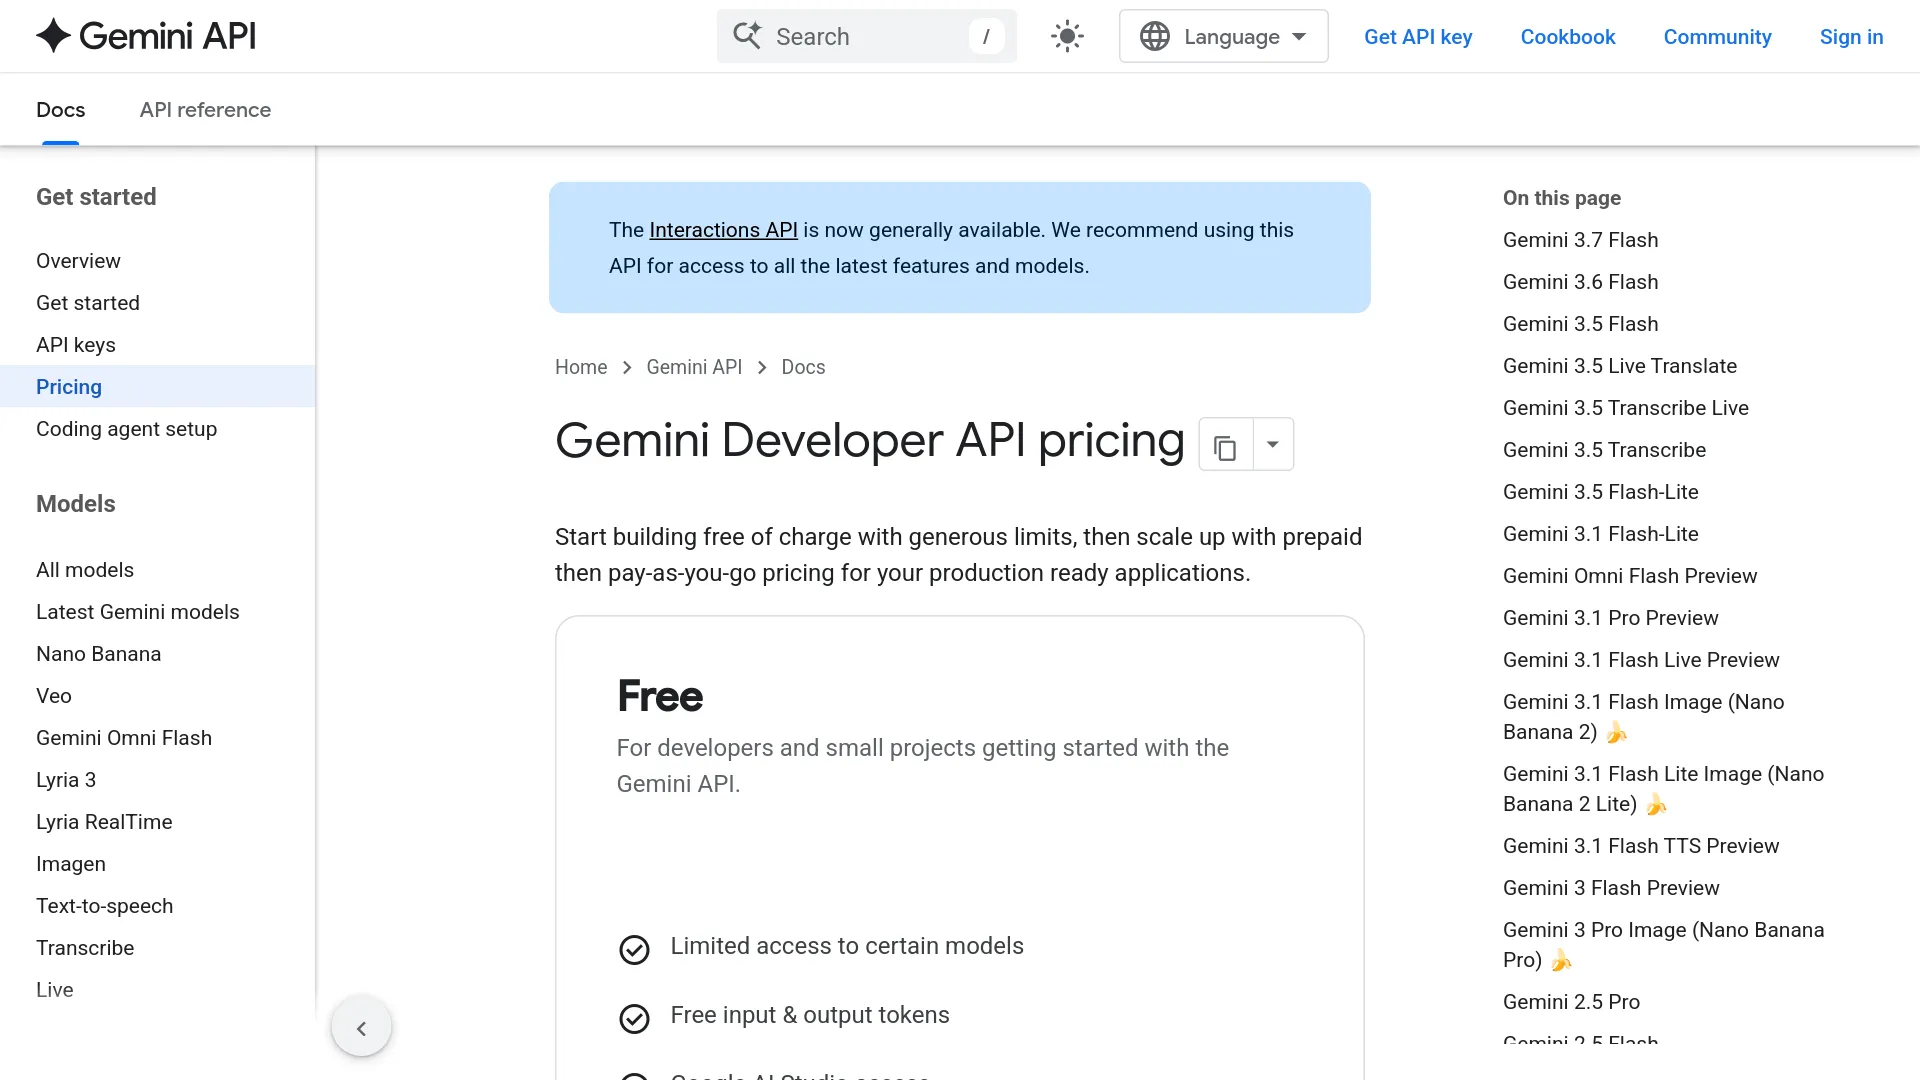
На странице цен Gemini API Google указывает тарифы в токенах, а не фиксированную стоимость минуты транскрибации. В текущем прайс-листе для gemini-3.5-transcribe указаны $2 за миллион токенов аудио на входе и $12 за миллион текстовых токенов на выходе.
Согласно документации по аудио, одна секунда аудио соответствует 32 токенам, то есть 1 920 аудиотокенам в минуте. Поэтому только входное аудио обходится примерно в $0,00384 за минуту при тарифе $2 за миллион токенов — без учёта текста на выходе и других тарифицируемых токенов.
| Модель | Опубликованная тарифная база | Ориентировочная смешанная оценка | Ориентировочная стоимость часа |
|---|---|---|---|
gemini-3.5-transcribe | $2/M аудиотокенов на входе + $12/M текстовых токенов на выходе | Около $0,005/мин | Около $0,30/час |
gemini-3.5-transcribe-live | Потоковая обработка аудио и текста по токенам | Около $0,009/мин | Около $0,54/час |
Смешанные оценки зависят от объёма текста в расшифровке, поэтому это ориентиры для планирования, а не гарантированные поминутные тарифы. Длинный вывод, повторяющийся контекст и дополнительные инструкции могут изменить итоговый счёт. Перед расчётом больших объёмов проверьте актуальную таблицу цен: тарифы preview-моделей могут меняться.
Какие возможности действительно важны в продакшене
Дословная или интеллектуальная транскрибация
VERBATIM — режим по умолчанию в документации Google по транскрибации. Он сохраняет слова-паразиты, повторы, паузы, незаконченные фразы и исходные исправления говорящего. Выбирайте его, если расшифровка должна оставаться записью разговора, доказательным материалом, исходником для субтитров или объектом контроля качества.
SMART превращает сырую расшифровку в более удобный для чтения текст. Модель убирает речевые сбои, исправляет самоисправления, добавляет пунктуацию и структуру, а также может форматировать даты, валюты, числа, списки и абзацы. Фраза «Во вторник — нет, в среду» в очищенном варианте может превратиться просто в «В среду».
Smart-режим несовместим с диаризацией и таймкодами на уровне слов. Если приложению нужны одновременно удобные заметки и возможность проверить исходную речь, сначала запрашивайте вербатим-версию, а очистку выполняйте отдельно для её копии.
Пользовательский словарь и переключение языков
Google заявляет автоматическое определение языка для 85+ локалей, включая переключение между языками в одном разговоре. Если язык известен заранее, передайте BCP-47-код, например en-US или es-ES, чтобы повысить точность распознавания.
Пользовательский словарь поддерживает до 1 000 терминов, однако практическая рекомендация Google — использовать обычно 100 терминов или меньше. Добавляйте названия продуктов, акронимы, имена, медицинские и технические термины, а не общеупотребительную лексику.
Метки говорящих и таймкоды слов
Для записанного аудио API может возвращать информацию о говорящих и временные отметки для отдельных слов. В документации указан максимум в восемь говорящих, тогда как в публикации о запуске Google говорит об атрибуции до трёх говорящих и помечает поддержку трёх и более говорящих как экспериментальную.
Таймкоды слов доступны в режиме verbatim и содержат смещения начала и конца каждого слова. Google предупреждает, что их включение может снизить общую точность транскрибации. Диаризация и таймкоды также уменьшают стандартный лимит длительности аудио с одного часа до 30 минут.
| Требование | Поддерживается? | Ограничение |
|---|---|---|
| Метки говорящих в записанном аудио | Да | В документации указано до 8; атрибуция 3+ говорящих экспериментальная |
| Таймкоды отдельных слов в записанном аудио | Да | Только режим verbatim; точность может снизиться |
| Метки говорящих в потоковой транскрибации | Нет | Если атрибуция важна, используйте записанное аудио |
| Таймкоды отдельных слов в потоковой транскрибации | Нет | Live-вывод приходит поэтапно и ориентирован на высказывания |
| Smart-режим вместе с метками или таймкодами | Нет | Для этих аннотаций выбирайте verbatim |
Как отправить записанный файл в Gemini 3.5 Transcribe API
В руководстве по записанному аудио Google описывает три шага: загрузить файл, передать полученный URI файла в Interactions API и забрать готовую расшифровку из interaction.output_text.
- Загрузите аудио через Files API. Этот вариант подходит для записей длиннее нескольких секунд и файлов, которые будут использоваться повторно.
- Сохраните полученные URI файла и MIME-тип, например
audio/mp3. - Передайте URI модели
gemini-3.5-transcribeчерез Interactions API. - Прочитайте текстовый результат и, если это было запрошено, проверьте аннотации
word_infoс данными о говорящих и времени.
Официальный сценарий SDK сводится к следующему примеру загрузки и транскрибации:
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
После того как Files API вернул FILE_URI, REST-запрос будет выглядеть так:
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
Чтобы получить очищенную расшифровку, добавьте конфигурацию транскрибации со smart-режимом:
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
Для меток говорящих и таймингов слов используйте вместо этого режим verbatim:
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Не объединяйте smart-конфигурацию с диаризацией или таймкодами. В задокументированных правилах API это именно выбор режима работы, а не просто настройка форматирования.
Как работает потоковая транскрибация
Live API открывает двунаправленное потоковое соединение с использованием gemini-3.5-transcribe-live. Клиент непрерывно отправляет аудио и получает два текстовых события:
interim_input_transcription: изменяющаяся гипотеза с низкой задержкой для субтитров или предпросмотра интерфейса.input_transcription: финализированный текст, который можно записать в транскрипт или передать в состояние приложения.
В руководстве Google для Live API указано необработанное аудио в формате 16-bit PCM, 16 кГц, моно, little-endian. Рекомендуемый размер фрагмента — около 100 миллисекунд, примерно по 1 024–2 048 фреймов. Для браузерных и мобильных клиентов Google советует использовать ограниченные ephemeral-токены, а не раскрывать обычный API-ключ. В примерах Google применяется одноразовый токен со сроком действия 30 минут.
Потоковый endpoint поддерживает автоматическое определение языка, подсказки в формате BCP-47, пользовательский словарь и вывод в режимах VERBATIM или SMART. Live-диаризация и таймкоды отдельных слов не поддерживаются. Непрерывная сессия ограничена 10 минутами, поэтому для более длинных потоков потребуется управлять сессиями на уровне приложения и сшивать расшифровки.
Для определения границ реплик Live API предлагает три подхода:
- Автоматический VAD: сервер сам определяет начало и конец речи.
- Гибридный VAD: клиентский детектор сообщает об окончании речи, а серверное определение остаётся резервным механизмом.
- Ручной VAD: интерфейс push-to-talk явно отправляет события начала и завершения активности.
Что показывают ранние тесты — и чего они не показывают
По данным Google, средний WER составляет 4,0% для потокового и 2,6% для непотокового режима по оценке Artificial Analysis. В публикации о запуске также приведены результаты FLEURS: 5,50% streaming WER и 5,04% non-streaming WER, а также улучшение времени до финальной расшифровки на 70% по сравнению с Chirp 3.
Это данные, предоставленные Google или приведённые со ссылкой на её материалы, а не независимое прямое сравнение Gemini 3.5 Transcribe с другими решениями. В открытом тесте koedesk STT оценивались Gemini 3.5 Flash и другие движки, но Gemini 3.5 Transcribe напрямую в нём не измерялась.
Первые пользователи отдельно проверяют лимиты длительности для файлового и потокового режимов, эталонные расшифровки для расчёта WER и надёжность распознавания телефонных номеров и ID заказов на тихих участках. Поэтому тестируйте на реальных записях имена, идентификаторы, числа, смену говорящих, тайминги и задержку — одного среднего WER недостаточно.
Когда выбирать Gemini 3.5 Transcribe, а когда подождать
| Сценарий | Насколько подходит | С чего разумно начать |
|---|---|---|
| Чистые заметки со встречи или диктовка | Хорошо подходит | File API, SMART, явная подсказка языка, если он известен |
| Юридическая, комплаенс- или архивная запись | С оговорками | File API, VERBATIM; критические фрагменты проверять вручную |
| Записанные звонки с несколькими говорящими | С оговорками | File API, VERBATIM + диаризация; ограничивать сессии 30 минутами |
| Субтитры с синхронизацией по словам | С оговорками | File API, VERBATIM + таймкоды слов; проверять тайминги и точность |
| Субтитры в реальном времени | Хорошо подходит для коротких сессий | Live API, для сохранения текста использовать только финальные события |
| Долго работающий голосовой агент | Потребуется дополнительная инженерная работа | Делить сессии до достижения лимита 10 минут и обрабатывать переподключения |
| Офлайн- или конфиденциальная локальная обработка | Подходит плохо | Документированный сценарий отправляет аудио в сервис Google; рассмотрите self-hosted ASR |
Gemini 3.5 Transcribe лучше всего раскрывается там, где транскрибация — лишь первый этап более крупного процесса: очистить речь, сохранить техническую лексику, определить говорящих и передать структурированный текст дальше. Если же нужна только дешёвая дословная расшифровка или обязательна офлайн-обработка, это решение подходит хуже.
FAQ по Gemini 3.5 Transcribe API
Gemini 3.5 Transcribe бесплатна?
Google указывает бесплатный уровень для использования Gemini API, однако квоты и доступность моделей могут меняться. Платное использование рассчитывается по токенам; сейчас на странице цен приведены ориентиры около $0,005 за минуту для транскрибации записей и $0,009 за минуту для потоковой модели.
Чем отличаются файловая и потоковая модели?
gemini-3.5-transcribe обрабатывает загруженные записи через Interactions API и поддерживает диаризацию и таймкоды слов для записанного аудио. gemini-3.5-transcribe-live передаёт необработанный PCM-поток через Live API, возвращает промежуточные и финальные события и ограничена сессиями до 10 минут без live-диаризации и таймкодов на уровне слов.
Можно ли обработать трёхчасовую запись одним запросом?
Не в рамках специализированной конфигурации для транскрибации записей. Стандартный unary-лимит составляет один час, а диаризация или таймкоды слов сокращают его до 30 минут. Для более длинной записи потребуется нарезка на уровне приложения и аккуратная работа с контекстом и непрерывностью говорящих.
Можно ли использовать Gemini 3.5 Transcribe офлайн?
В документированном сценарии аудио загружается в сервис Google или передаётся ему потоково. Google не описывает офлайн- или self-hosted-версию Gemini 3.5 Transcribe.
Самый безопасный способ начать интеграцию
Начните с небольшого фрагмента реальных данных, а не с идеально записанного демонстрационного клипа. Прогоните один и тот же файл дважды: сначала в режиме verbatim для проверки точности, затем в smart-режиме для оценки читаемости. Отдельно измеряйте распознавание имён, чисел, смены говорящих, дрейф таймкодов и стоимость.
Сохраняйте исходную расшифровку как эталон, используйте smart-версию для пользовательских заметок и предусмотрите запасной сценарий на случай ошибок загрузки или изменений preview-модели. Переходите к Live API только после того, как клиент научится обрабатывать PCM-фрагменты по 100 миллисекунд, различать промежуточные и финальные события, работать с ephemeral-токенами и учитывать границу сессии в 10 минут.