Os gráficos de modelos hospedados prometem 280 tokens por segundo, mas os primeiros testes em notebooks ficam entre 8 e 220 tok/s, dependendo do hardware e do runtime. O Inkling 2 Mini é uma opção forte para agentes de código offline — um modelo de pesos abertos com 26,4B e cerca de 20 GB —, mas vale conhecer suas limitações em chat, factualidade e acesso via API antes de fazer o download.
Para quem o Inkling 2 Mini vale a pena — e quem deve passar longe
O Inkling 2 Mini se encaixa muito bem em um tipo de tarefa e deixa a desejar em vários outros. Por isso, o uso pretendido pesa mais que a tabela de benchmarks. Assistência de programação offline, com ferramentas e busca, é o território natural do modelo; chat intenso e uso exclusivamente via API, não.
| Seu tipo de uso | Veredito sobre o Mini |
|---|---|
| Agente de código offline em um Mac com 32 GB ou mais ou no DGX Spark | Ótimo encaixe: é aqui que aparecem os melhores resultados relatados |
| Trabalho privado com contexto longo (até 1 milhão de tokens, nominalmente) | Vale testar: na prática, comece com contexto de 32K |
| Chat com várias interações ou cumprimento rigoroso de instruções | Melhor passar: o Qwen3.8-27B tem resultados superiores nesse cenário |
| Uso de uma API hospedada hoje | Melhor passar: ainda não há listagem serverless, apenas preços de amostragem e fine-tuning |
O restante desta análise mostra os números por trás dessa divisão: o que o looping muda, quais benchmarks resistem a uma análise mais cuidadosa, qual é a velocidade local na prática e o que o preço realmente compra.
O que é o Inkling 2 Mini e como funciona seu looping
O Thinking Machines Lab lançou o Inkling 2 Mini em 20 de novembro de 2026 como um modelo de pesos abertos sob a licença Apache 2.0. Os pesos estão disponíveis no Hugging Face como thinkingmachines/Inkling-2-Mini. O modelo aceita texto e imagem, gera texto e declara contexto máximo de 1 milhão de tokens.
| Especificação | Inkling 2 Mini |
|---|---|
| Lançamento | 20 de novembro de 2026, Thinking Machines Lab |
| Licença | Apache 2.0 |
| Parâmetros | 26,4B no total / 3,4B ativos por token / 5,4B efetivos com looping |
| Camadas | 24 armazenadas; as 12 intermediárias rodam 3 vezes por token (6 + 3x12 + 6 = 48 aplicações) |
| Roteamento MoE | 8 de 128 especialistas por token em cada camada |
| Precisão | NVFP4 em 20 camadas, MXFP8 nas 4 finais; checkpoint de cerca de 20 GB (19,5 GB + 0,64 GB do preditor) |
| Contexto / modalidades | Até 1 milhão de tokens; entrada de texto + imagem, saída de texto |
| Alvos locais | Mac com 32 GB ou mais de memória via Ollama, ou um NVIDIA DGX Spark, segundo o cartão do modelo |
Os 3,4B representam os parâmetros ativos armazenados; ao contar as três passagens do looping, o custo computacional efetivo fica em aproximadamente 5,4B. Reutilizar os pesos mantém o arquivo compacto, mas aumenta o trabalho necessário para gerar cada token, como explica o guia técnico do Hugging Face.
O looping acrescenta computação, não conhecimento armazenado. O anúncio de lançamento apresenta o Mini como inferior aos modelos Inkling maiores em recuperação factual, já que o conhecimento depende principalmente do total de parâmetros. É por isso que busca e ferramentas são tão importantes neste modelo.
Quais benchmarks são confiáveis — e quais merecem desconto
Todos os resultados abaixo vêm dos próprios testes de laboratório, por meio dos cartão do modelo no Hugging Face. O Mini se destaca em programação e busca orientadas por ferramentas, mas empata ou fica atrás em raciocínio, visão e disciplina no chat.
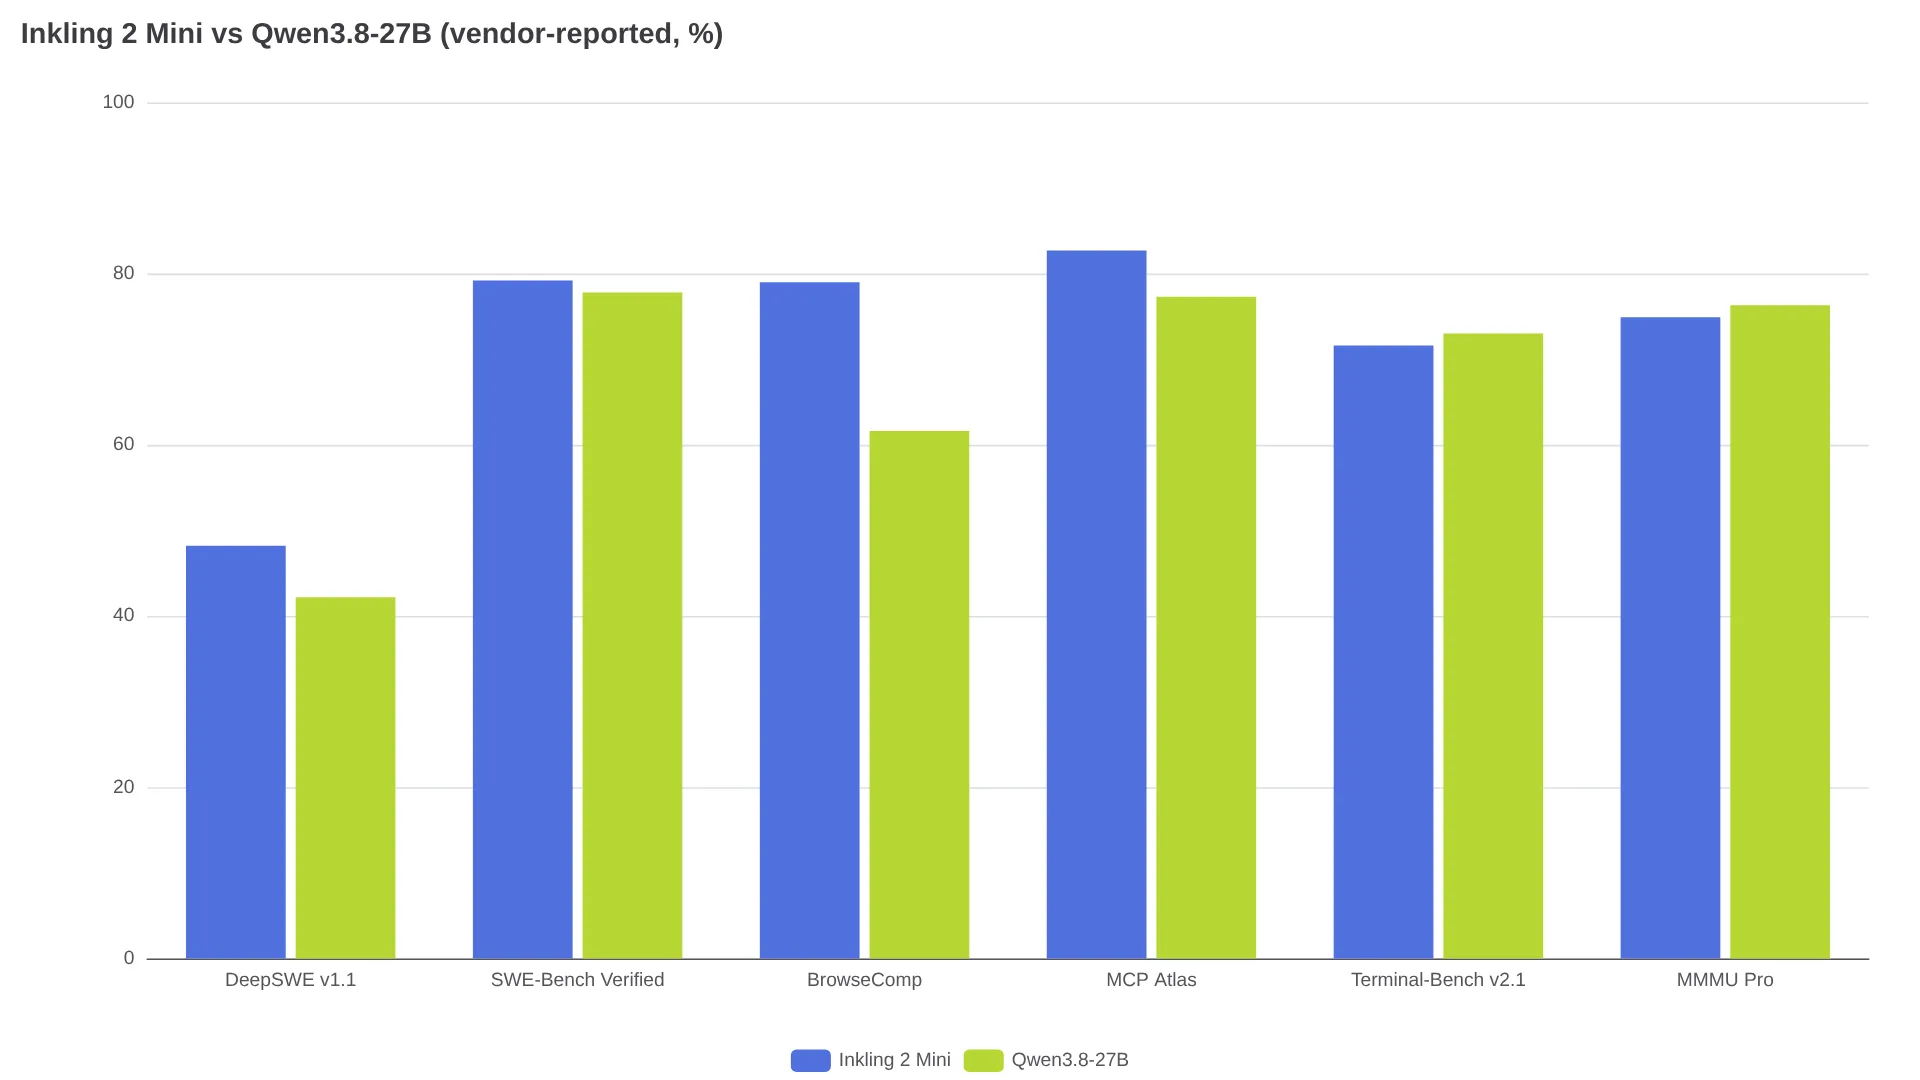
O Mini lidera no DeepSWE v1.1, com 48,2% contra 42,2% do Qwen3.8-27B; no SWE-Bench Verified, com 79,2% contra 77,8%; no BrowseComp, com 79,0% contra 61,6%; e no MCP Atlas, com 82,7% contra 77,3%. O Artificial Analysis dá nota 20,1 aos dois modelos em seu Intelligence Index, mas o Mini conclui a tarefa do índice em 9,0 minutos, contra 38,2 do Qwen. O ARC Prize registra 84,5% no ARC-AGI-1 e 49,3% no ARC-AGI-2, ambos na configuração de raciocínio mais alta.
A outra metade da história, segundo o mesmo cartão do modelo, é menos favorável ao Mini: HLE-Diamond com 15,2% contra 15,3%, MMMU Pro com 74,9% contra 76,3% e Terminal-Bench v2.1 com 71,6% contra 73,0%. A diferença em factualidade é maior: no AA-Omniscience, a taxa de respostas sem alucinação fica em 63,4%, contra 71,4% do Qwen. O Mini também fica atrás do Qwen no ComplexConstraints (33,4%) e no MultiChallenge (50,0%).
Rodar localmente não se resume a um único número
A listagem oficial do Ollama e o cartão do modelo indicam um Mac com 32 GB ou um DGX Spark, mas o suporte inicial a modelos com looping faz a velocidade real variar bastante. A taxa de 280 tok/s em ambiente hospedado, medida pelo Artificial Analysis, é um indicador ruim do desempenho em notebooks.
| Configuração | Velocidade relatada | Fonte |
|---|---|---|
| Teste hospedado (Artificial Analysis) | 280 tok/s | Medição de terceiros |
| RTX 4090, vLLM corrigido + FP8/NVFP4 + drafter | ~190–220 tok/s | Usuário do Reddit, somente após o patch (117 na linha de base) |
| MacBook Pro com M5 Max | ~125 tok/s | @alexocheema |
| MacBook Pro com M1 Max e 64 GB, quantização de 4 bits | ~20 tok/s | Usuário gregsadetsky, do Hacker News, via análise de lançamento da eesel |
| Versões iniciais do llama.cpp, hardware variado | ~5–10 tok/s | Discussão no r/LocalLLM |
"Não consegui fazer passar nem de 5 t/s." — u/KURD_1_STAN, tópico de comparação no r/LocalLLM
Grande parte dessa diferença vem do suporte do runtime e da quantização. As versões atuais lidam melhor com as camadas em looping que as versões do primeiro dia, enquanto a escolha da quantização altera o espaço ocupado — a recomendação de 4 bits usa cerca de 17,6 GB, mais um projetor de visão de 639 MB, segundo o guia da Unsloth via Crewmark — antes mesmo de contextos longos aumentarem a pressão sobre o cache KV.
Em um teste de correspondência de pagamentos com a mesma latência, o Qwen atingiu 98,2% de precisão e zero correspondências falsas, enquanto o Mini chegou a 96,9% e gerou cinco correspondências falsas:
"Testamos o Inkling 2 Mini contra o Qwen3.8-27B em nossa tarefa real de correspondência de pagamentos... Qwen: 98,2% de precisão, 0 correspondências falsas... Inkling: 96,9%, 5 correspondências falsas... O Qwen continua sendo a escolha para esta tarefa." — @exebat3 (publicação)
Na prática, comece com contexto de 32K, reduza esse valor se faltar memória e confirme se a versão do seu runtime oferece suporte às camadas em looping antes de tirar conclusões sobre a qualidade.
O preço que ainda não tem botão de compra
As tarifas do Tinker citadas na página do modelo no Artificial Analysis são de US$ 0,15 por milhão de tokens de entrada, US$ 0,015 para tokens em cache e US$ 0,50 para saída, com fine-tuning a US$ 0,75 (64K) e US$ 1,50 (256K). Aplicando esses valores ao uso de tokens medido, o custo estimado fica em US$ 0,59 por tarefa do índice, contra US$ 3,53 do Qwen3.8-27B.
Esses US$ 0,59 são uma estimativa, não um preço hospedado disponível para compra. O Mini não aparece em nenhuma listagem de inferência serverless no momento desta análise, algo que a análise da eesel verificou no Tinker e no OpenRouter. Além disso, o Mini gerou 161 milhões de tokens de saída durante a execução do índice, contra uma mediana de 85,7 milhões. Ou seja, a verbosidade consome parte da vantagem de preço por token. Para hospedar o modelo por conta própria, compare hardware, eletricidade e custos de configuração com uma API hospedada do Qwen ou de um modelo de ponta.
Duas configurações que determinam se o modelo vai funcionar
O nível de esforço de raciocínio vai de nenhum (0,0) a mínimo (0,1), baixo (0,2), médio (0,7), alto (0,9, padrão) e xhigh/máximo (0,99). Segundo o cartão do modelo, o nível mínimo não desativa completamente o raciocínio.
Usar menos pode ser melhor. Na discussão do Terminal-Bench no r/LocalLLM, um usuário marcou 10/13 em um subconjunto de 13 tarefas com esforço baixo, enquanto o esforço médio expirou repetidamente. Em outro teste, um usuário do Hacker News citado na análise da eesel consumiu 19.200 tokens de raciocínio sem ferramentas e não concluiu a tarefa; ao ativar a busca, o modelo encontrou uma solução, mas usou o nome errado para o hook.
Limite o número de tokens de saída e de turnos do agente, coloque o acesso ao sistema de arquivos em um sandbox e exija revisão humana antes de usar o resultado em produção. O cartão do modelo alerta para ações destrutivas sem confirmação e loops de raciocínio dos quais o modelo não consegue sair, especialmente ao depurar código.
O compromisso que você precisa aceitar antes do download
O Mini obtém mais computação sem exigir um checkpoint maior ao reutilizar suas camadas intermediárias. O laboratório também disponibiliza um checkpoint de pesquisa com looping variável para estudar esse comportamento (guia). Os problemas relatados são concretos: loops durante a depuração, uma mudança para o japonês no meio da resposta relatada por um usuário e chamadas de ferramentas que precisam ser controladas. Baixe o modelo para programação offline com proteções; se você precisa de um chat cuidadoso ou de uma API pronta para usar, é melhor esperar.
Perguntas frequentes
O Inkling 2 Mini roda em um notebook?
Sim, desde que a versão do software seja adequada: um Mac com Apple Silicon e 32 GB ou mais, usando Ollama ou uma versão atual do llama.cpp, de preferência com quantização de 4 bits (cerca de 17,6 GB mais o projetor). Espere aproximadamente 20 tok/s em um M1 Max mais antigo e mais de 100 tok/s em hardware M5; runtimes sem os patches necessários podem cair para velocidades de um dígito, como mostra a tabela acima.
O Inkling 2 Mini é melhor que o Qwen3.8-27B?
Para agentes de código, sim; para chat, não. Como mostra o gráfico acima, o Mini lidera no DeepSWE, SWE-Bench Verified, BrowseComp e MCP Atlas. O Qwen lidera no Terminal-Bench v2.1, MMMU Pro, factualidade e instruções com restrições. Todos os números foram divulgados pelos fornecedores por meio do cartão do modelo.
Por que as fontes citam tanto 3,4B quanto 5,4B de parâmetros ativos?
3,4B é o número de parâmetros ativos armazenados; 5,4B acrescenta as três passagens do looping, de aproximadamente 1,0B cada. Use 5,4B para estimar a computação e 3,4B para estimar a memória.
Posso chamar o Inkling 2 Mini por uma API hospedada hoje?
Não havia um endpoint serverless próprio no momento desta análise. O Tinker informa preços de amostragem e fine-tuning, mas não oferece uma listagem serverless do Mini, segundo a verificação da eesel. Rode os pesos do Hugging Face localmente ou espere que o modelo chegue a algum serviço hospedado.
Como faço para interromper os loops de raciocínio?
Comece com esforço baixo (0,2), limite os tokens de saída e os turnos do agente e coloque as ferramentas em um sandbox, conforme recomenda o cartão do modelo.
Leia também: review do Inkling 2 Small e preços da API, para conhecer o irmão de 594B que responde ao Mini; melhor LLM para agentes de código em 2026, que posiciona o Mini entre as opções para agentes; e o guia do llama.cpp v1.0, runtime do qual o Mini depende localmente.