Um agente pode conhecer centenas de ferramentas sem precisar levar o schema completo de todas elas em cada prompt. Essa é a proposta do Tool Retrieval na Gemini API: nomes e descrições ficam disponíveis, mas os parâmetros detalhados só entram no contexto quando a tarefa exige uma ferramenta. Há uma ressalva importante: cada busca aciona outra passagem pelo modelo. Se isso acontece em quase todos os turnos, o custo pode aumentar em vez de cair.
Lançado em preview em 19 de novembro de 2026, exclusivamente na Interactions API, o recurso adiciona a ferramenta tool_search e a flag defer_loading: true, segundo o anúncio do Google. Ferramentas adiadas expõem nome e descrição, enquanto o JSON dos parâmetros permanece fora do contexto. Não existe cobrança separada: valem as tarifas padrão de entrada, entrada em cache e saída.
Como 200 ferramentas podiam consumir 164.000 tokens antes mesmo da primeira chamada
O que pesa no prompt não é apenas a quantidade de ferramentas, mas o tamanho dos schemas. Em catálogos grandes, eles podem dominar o consumo de contexto.
Uma análise técnica independente da documentação do Google usa uma comparação ilustrativa: cerca de 164.000 tokens de entrada sem adiamento, contra aproximadamente 23.650 com Tool Retrieval, em uma biblioteca com 200 ferramentas da qual apenas algumas são usadas por solicitação. São números arredondados daquela análise, não um benchmark. A ideia é simples: você deixa de pagar pelos schemas que não usa.
Há também a questão da precisão. Quando dezenas de schemas semelhantes disputam espaço no contexto, o modelo tem mais oportunidades de escolher a ferramenta errada. O Google apresenta o Tool Retrieval como ajuda tanto para reduzir tokens quanto para melhorar a seleção. Como não há número de precisão publicado, trate essa segunda parte como uma hipótese a validar nas suas próprias tarefas.
Como o Gemini faz a busca de ferramentas com tool_search e defer_loading
A configuração usa dois trechos resumidos de declaração: uma entrada tool_search com {"type": "tool_search"} e "defer_loading": true em cada ferramenta adiada. O formato completo da requisição aparece na análise da documentação. Mesmo adiadas, as ferramentas continuam visíveis ao modelo por nome e descrição. Segundo o guia sobre defer_loading, quando short_description está definido, é ele que o modelo vê; caso contrário, o modelo recebe a primeira frase da descrição completa.
No fluxo do lado do servidor, tudo acontece em uma única requisição:
- O modelo emite um
tool_search_call, por exemplo, solicitandoissue_refund. - A API devolve um
tool_search_resultcom o schema completo. - O modelo emite a
function_callreal. No exemplo de reembolso do Google, são usadosorder_id: "A-1042"eamount: 40com o modelogemini-4-hydrogen. - Seu código executa a chamada e devolve o
function_result.
Registre tudo em interaction.steps. Se a ferramenta errada for carregada, comece pelo trace e verifique se há nomes ou descrições vagos.
Busca no servidor ou no cliente: uma requisição contra uma ida e volta
| Modo | Quem pesquisa | Índice necessário | Idas e voltas extras | Melhor cenário |
|---|---|---|---|---|
| No servidor (padrão) | Gemini | Nenhum — "There's no index to build or host." | Nenhuma, ocorre na mesma requisição | Bibliotecas grandes e em sua maioria estáticas; servidores MCP completos |
No cliente ("execution": "client") | Seu app | Seu registro ou índice de embeddings | Uma por busca | Permissões por usuário, registros privados, ferramentas adicionadas no meio da conversa |
A busca no servidor não exige um índice hospedado e termina na mesma resposta. Conforme a análise da documentação, definir defer_loading: true em uma ferramenta mcp_server adia todas as ferramentas expostas por esse servidor.
No modo cliente, você usa tool_search com "execution": "client". O exemplo usa o nome search_tools e uma string query obrigatória. Seu app devolve as correspondências em um function_result e depois chama client.interactions.create com previous_interaction_id. De acordo com a mesma análise, é permitido apenas um tool_search por requisição, e os dois modos não podem ser combinados.
Prefira o modo cliente quando a autorização varia por usuário ou integrações podem surgir no meio da conversa. Uma busca no servidor sobre um catálogo compartilhado não aplica, por si só, filtragem de permissões individuais, segundo a análise citada. Ela também aponta o modo cliente como a opção que permite disponibilizar ferramentas no meio da conversa sem declarar tudo antecipadamente.
A conta de cobrança do Gemini Tool Retrieval: 26 tokens agora, outra passagem completa depois
O Tool Retrieval não tem cobrança própria, segundo o anúncio do Google: "Tool Retrieval has no separate charge." Ainda assim, quatro custos medidos permanecem, conforme a análise de economia de tokens:
tool_searchacrescenta um pequeno bloco fixo de tokens de entrada a cada requisição.- A análise citada estima cerca de 26 tokens para cada linha adiada de nome e descrição.
- Cada busca no servidor executa outra passagem do modelo sobre o contexto atual, cobrada por
total_tool_use_tokensem um volume próximo ao de entrada do prompt, menos os acertos de cache, segundo a análise. - Cada schema carregado continua sendo cobrado como entrada pelo restante da conversa e não pode ser descarregado.
| Carga de trabalho (estimativas ilustrativas da análise citada) | Sem retrieval | Com retrieval | Resultado |
|---|---|---|---|
| 200 ferramentas, poucas usadas por tarefa | ~164.000 tokens | ~23.650 tokens | Economiza |
| 10 ferramentas, contexto de 30 mil tokens, busca em quase todos os turnos | ~68.000 tokens | ~92.830 tokens | Custa mais |
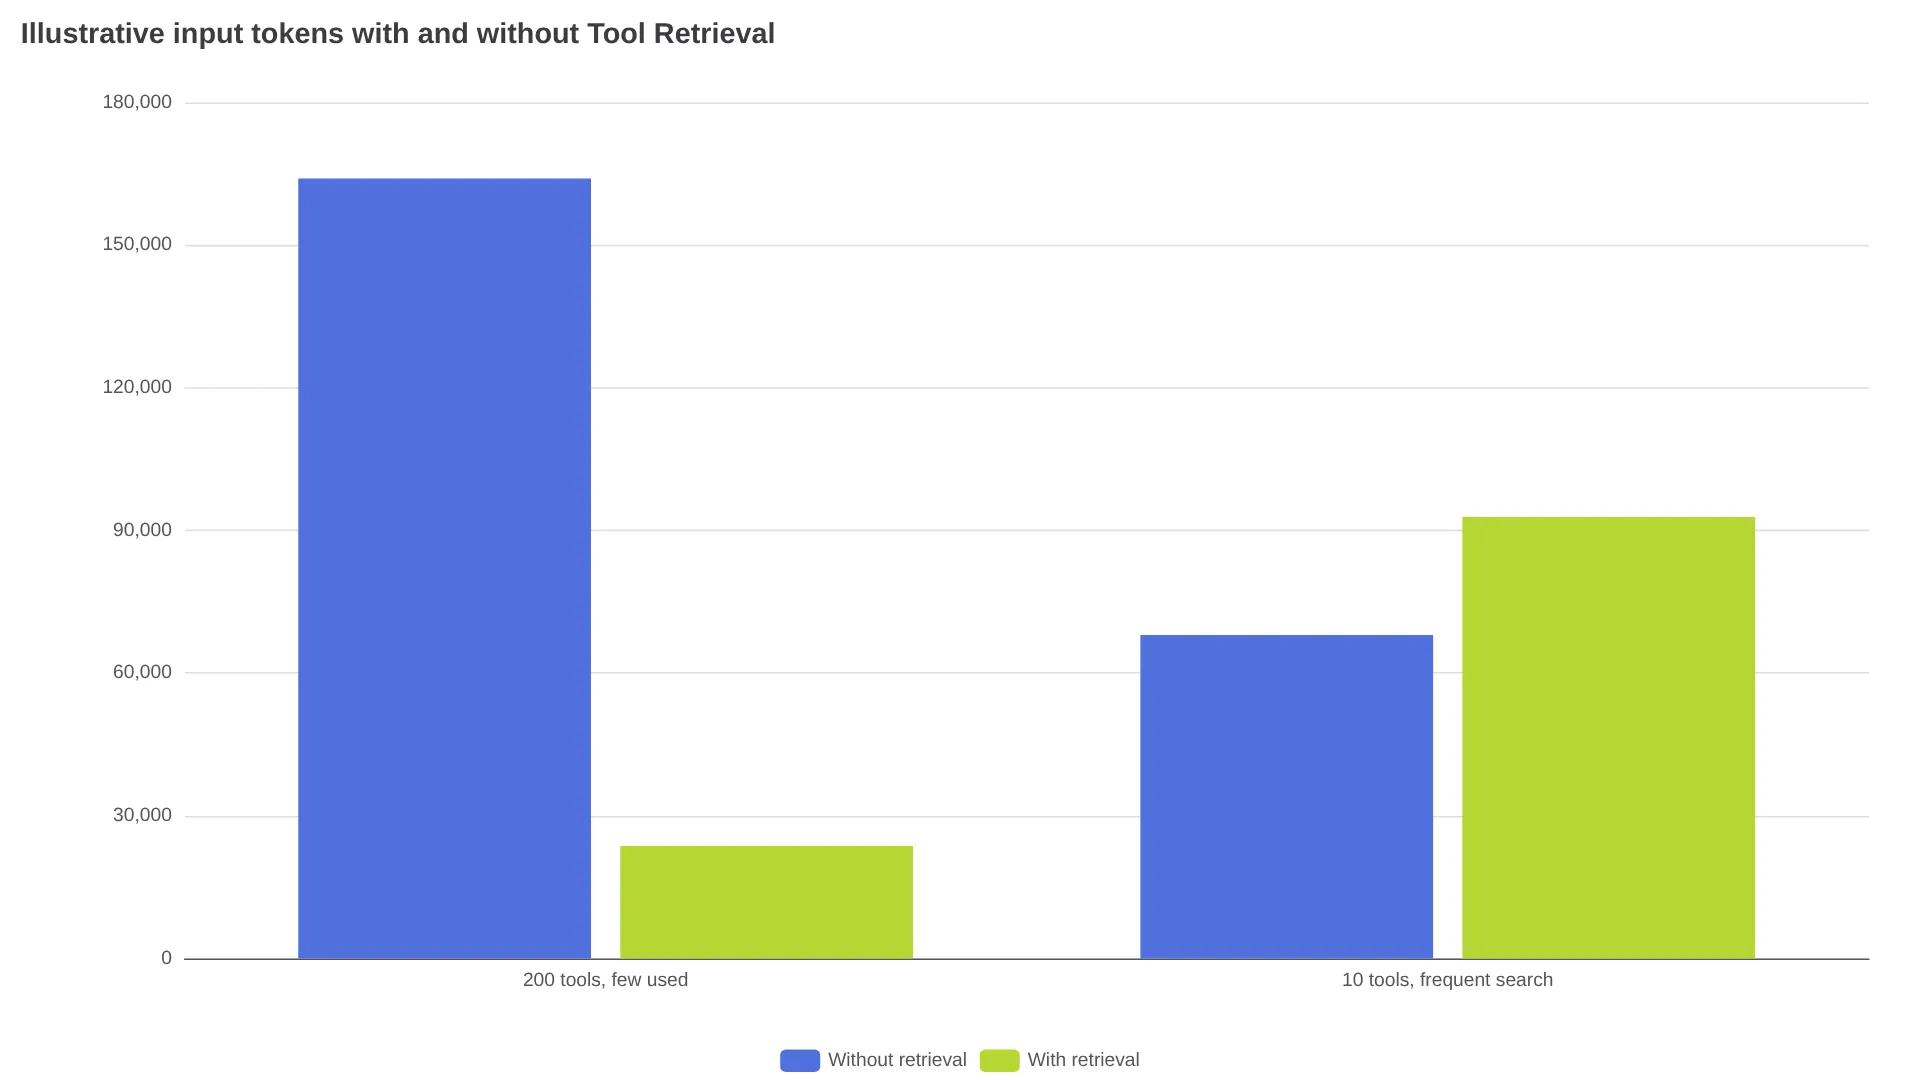
A recomendação do Google, no mesmo anúncio, é direta: "Measure it against your own traffic."
"No modo do lado do servidor... cada busca no servidor acrescenta outra passagem do modelo sobre o contexto atual... Portanto, uma biblioteca grande em que cada tarefa usa poucas ferramentas pode se beneficiar. Uma biblioteca pequena, com conversa longa e buscas frequentes, pode custar mais." — @tekroch
O adiamento pode estabilizar o prefixo em cache, mas também pode reduzir o prompt para abaixo do limite mínimo de tamanho do cache. Acompanhe a taxa de acertos de cache junto dos tokens de entrada, recomenda a análise citada.
Quando adiar schemas e quando deixá-los carregados
Em bibliotecas pequenas, primeiro compare com o carregamento estático. Frequência de busca e tamanho dos schemas importam mais que qualquer corte baseado na quantidade de ferramentas. Em catálogos grandes, com 1 a 3 ferramentas por tarefa, adie a cauda no servidor e mantenha sem adiamento as ferramentas mais usadas, aquelas presentes na maioria das requisições. Para ferramentas por usuário ou adicionadas durante o chat, use o modo cliente e preveja uma ida e volta por consulta.
As notas de implementação citadas listam três falhas das quais é preciso se proteger:
- Não adie uma ferramenta mencionada nas instruções de sistema ou na saída de outra ferramenta. O modelo pode tentar chamá-la sem pesquisar, e o turno seguinte pode falhar.
- Funções adiadas ainda precisam incluir
parameterscompletos na requisição; apenas nome e descrição podem devolver um schema vazio e impossível de chamar. - Em apps sem estado, repita sem alterações
tool_search_call,tool_search_result, assinaturas e todo o arraytoolsem cada turno.
A qualidade da descrição define a recuperação: antes de ver qualquer schema, o modelo escolhe com base em nomes e descrições. "Pesquisar faturas de clientes por intervalo de datas" é encontrável; "Auxiliar de faturas" entra em colisão com outras ferramentas. O adiamento não é uma fronteira de segurança. Nomes e descrições de MCP adiados continuam visíveis como entrada de prompt, e ferramentas carregadas executam com as permissões concedidas, conforme a análise de segurança.
Limitações desta prévia
É apenas um preview, limitado à Interactions API e à superfície v1beta. Não há suporte a generateContent; usar defer_loading em um modelo não compatível retorna HTTP 400, segundo a análise da documentação.
A cobertura de modelos hoje é mais estreita do que o título sugere. O anúncio fala em Gemini 3.6 e posteriores, incluindo todos os modelos Gemini 4, enquanto a análise citada informa que a documentação ativa lista atualmente gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash e gemini-3.6-flash. Confirme o seu modelo na documentação antes de presumir compatibilidade entre modelos irmãos. Não há data de GA anunciada. A Anthropic lançou a mesma ideia de defer_loading como beta em novembro de 2025; os diferenciais do Google são o adiamento de MCP no servidor e o modo cliente, segundo a cobertura do lançamento.
| Formato da sua biblioteca | Modo indicado | Primeira ação |
|---|---|---|
| Pequena e estável | Carregamento estático | Meça os tokens dos schemas antes de adicionar complexidade |
| 50–200 ferramentas, poucas usadas por tarefa | Adiamento no servidor | Adie a cauda e mantenha carregadas as ferramentas mais acessadas |
| Ferramentas por usuário ou adicionadas durante o chat | Retrieval no cliente | Crie uma busca que considere permissões |
| Todas as ferramentas usadas em todos os turnos | Carregamento estático | O custo da busca provavelmente supera a economia |
Comece liberando uma fatia da cauda longa e compare, em tarefas idênticas, os tokens de entrada, total_tool_use_tokens, a latência e o sucesso das tarefas com e sem adiamento.
Perguntas frequentes
Tool Retrieval funciona com generateContent?
Não. Apenas na Interactions API em v1beta.
Quais modelos são compatíveis?
O anúncio menciona Gemini 3.6 e posteriores, incluindo Gemini 4; a análise citada diz que a documentação ativa restringe isso atualmente a modelos que incluem gemini-4-hydrogen e gemini-3.6-flash. Consulte a documentação do seu modelo específico.
Isso pode aumentar minha conta?
Sim. Na carga de trabalho ilustrativa citada, com 10 ferramentas, o consumo sobe de ~68.000 para ~92.830 tokens quando há buscas em quase todos os turnos.