Na API, o melhor modelo não depende apenas da capacidade: a data também pesa na fatura. Até 30 de novembro, o Carbon custa menos; a partir de 1º de dezembro, o Gemini 4 Neon passa a ser 25% mais barato. O Google lançou o Gemini 4 Neon em 18 de novembro de 2026 por US$ 3 a cada 1M de tokens de entrada e US$ 15 a cada 1M de tokens de saída, com janela de 1M de tokens e sem plano gratuito.
A virada de preços em 30 de novembro muda a decisão
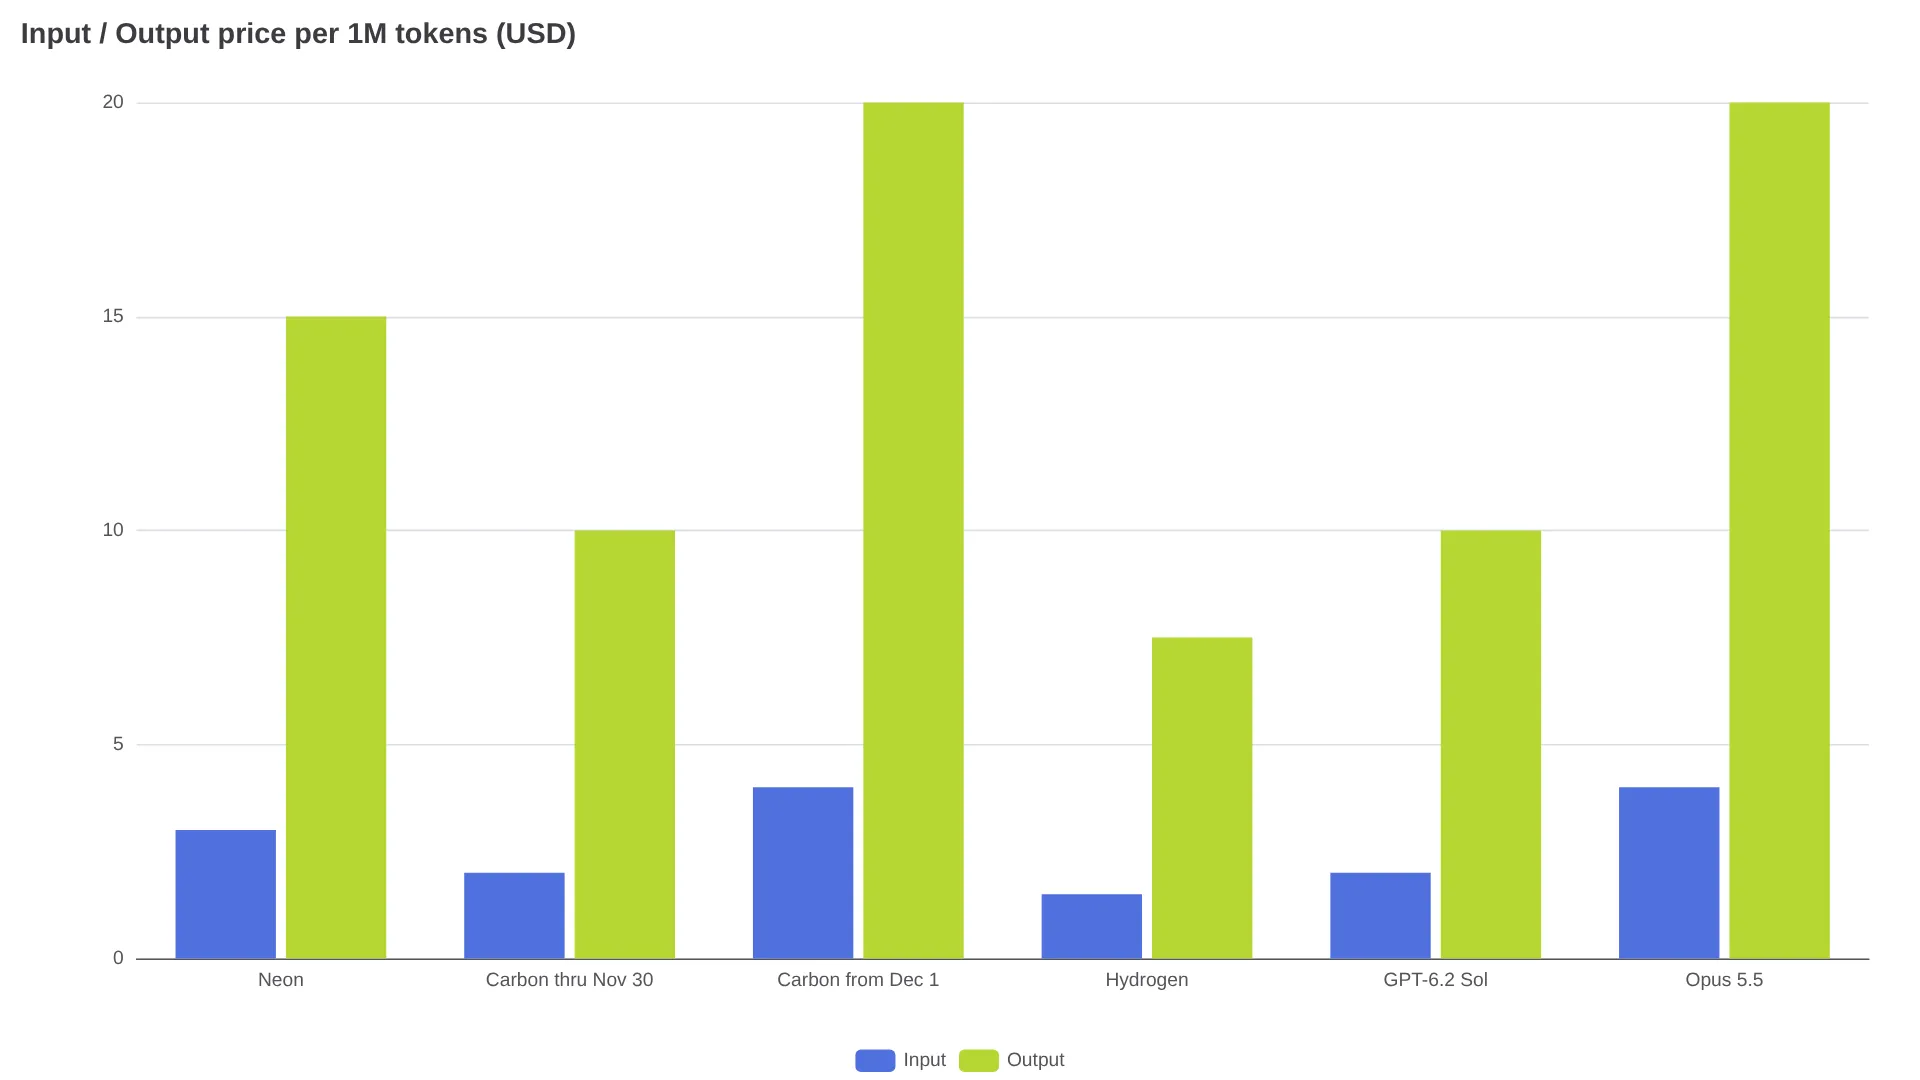
Para entender o preço da API Gemini 4 Neon, é preciso olhar o calendário. Até 30 de novembro de 2026, o Gemini 4 Carbon tem preço introdutório de US$ 2 por entrada e US$ 10 por saída a cada 1M de tokens. Em 1º de dezembro, Carbon e Argon sobem para US$ 4/US$ 20, deixando o Neon, a US$ 3/US$ 15, exatamente 25% mais barato por token (comparativo de preços). Antes de 30 de novembro, porém, o Neon custa 50% mais que o Carbon nas tarifas promocionais.
O Google apresenta a comparação em custo por tarefa e afirma que o Neon reduz esse custo em 32% frente ao Carbon em thinking alto, além de oferecer ao menos 36% de economia no nível xhigh contra concorrentes não identificados (análise do lançamento). Para orçamento, use as tarifas publicadas de US$ 3/US$ 15: os números por tarefa são informados pelo Google e não trazem uma base nomeada.
Onde o Neon se encaixa na família Gemini 4
O Gemini 4 Neon ocupa a faixa intermediária: oferece mais profundidade de raciocínio que o Hydrogen e se aproxima da qualidade do Carbon com execução mais rápida, segundo o posicionamento do modelo na OpenRouter. O Carbon era a referência para programação de fronteira, o Argon era o modelo principal de raciocínio para matemática e ciências, e o Hydrogen era a opção de alto volume por US$ 1,50/US$ 7,50 (índice de preços). O Neon traz quatro níveis de raciocínio — low, medium, high e xhigh — e usa high como padrão (especificações do provedor).
Segundo o anúncio do Google e o detalhamento do lançamento, esta era a disponibilidade no lançamento:
| Plataforma | Acesso ao Neon |
|---|---|
| Gemini API | Desenvolvedores pagantes, com o ID de modelo gemini-4-neon (listagem de catálogo) |
| AI Studio / app Gemini / Antigravity | Camada paga, além dos planos Google AI Pro e Ultra |
Vale cautela com o rótulo Neon no Antigravity. Usuários na discussão sobre Antigravity relatam que a entrada do orquestrador ainda pode resolver para um prompt de sistema do Carbon em algumas sessões; uma resposta resumiu: "its just the orchestrator. not neon" (discussão). Até o Google publicar o mapeamento por build ID, calcule custos pelo ID do modelo na API, não pelo rótulo da interface.
O que os US$ 3/US$ 15 representam na prática
As tarifas padrão são US$ 3,00 para entrada, US$ 15,00 para saída e US$ 0,15 para entrada em cache a cada 1M de tokens (anúncio oficial). Elas valem para toda a janela de contexto de 1.048.576 tokens (verificação de preços). Índices de terceiros listam Batch por US$ 1,50/US$ 7,50, Flex por US$ 1,50/US$ 7,50 e Priority por US$ 5,40/US$ 27,00 (especificações e tabela do provedor), mas o Google não havia publicado Neon Batch/Flex/Priority em sua página geral de preços no lançamento. Portanto, trate o Neon como Standard-only até essa página ser atualizada (análise do lançamento).
Fórmula reutilizável: custo = entrada nova / 1M × US$ 3 + entrada em cache / 1M × US$ 0,15 + saída, incluindo thinking / 1M × US$ 15.
Três regras de cobrança mudam bastante o preço de tabela (análise do lançamento e referência de preços):
- Tokens de thinking são cobrados como saída. A saída a US$ 15 domina qualquer fatura.
- O cache é apenas implícito, exige prompt mínimo de 4.096 tokens e dá 95% de desconto na entrada elegível em cache. Não há cache explícito
cachedContentsnem cobrança para gravar no cache. - A saída síncrona é limitada a 65.536 tokens (especificações). Saídas maiores exigem execução em segundo plano.
Prompts curtos, com menos de 4.096 tokens, não recebem nenhum benefício de cache (referência de preços). Um bot de suporte com 1.200 tokens de entrada não consegue usar a tarifa de US$ 0,15.
Quanto custam duas cargas de trabalho modeladas
Os cenários abaixo usam quantidades fixas de tokens e não incluem novas tentativas nem variação no tamanho do raciocínio. A participação da saída é o ponto central. Todas as linhas aplicam as mesmas proporções de cache e as tarifas de tabela de cada modelo na tabela de preços do lançamento.
Sessão de programação: 50 chamadas, 80.000 tokens de entrada por chamada, 90% vindos de cache, 2.500 tokens de saída por chamada incluindo thinking. Totais: 400.000 de entrada nova, 3,6M em cache e 125.000 de saída.
| Modelo | Custo da sessão |
|---|---|
| Gemini 4 Neon US$ 3/US$ 15 | US$ 3,62 (US$ 1,20 de entrada nova + US$ 0,54 em cache + US$ 1,88 de saída = US$ 3,615) |
| Carbon até 30 de novembro US$ 2/US$ 10 | US$ 2,41 |
| Carbon a partir de 1º de dezembro US$ 4/US$ 20 | US$ 4,82 |
| Hydrogen US$ 1,50/US$ 7,50 | US$ 1,81 |
| GPT-6.2 Sol US$ 2/US$ 10 | US$ 2,41 |
Suporte em escala: 10.000 conversas por dia durante 30 dias, 6.000 tokens de entrada em cada uma, com 75% elegíveis para cache, e 500 tokens de saída por conversa. Totais: 450M de entrada nova, 1,35B em cache e 150M de saída.
| Modelo | Custo mensal |
|---|---|
| Gemini 4 Neon US$ 3/US$ 15 | US$ 3.802,50 (dos quais US$ 2.250 são de saída) |
| Carbon até 30 de novembro US$ 2/US$ 10 | US$ 2.535,00 |
| Carbon a partir de 1º de dezembro US$ 4/US$ 20 | US$ 5.070,00 |
| Hydrogen US$ 1,50/US$ 7,50 | US$ 1.901,25 |
| GPT-6.2 Sol US$ 2/US$ 10 | US$ 2.535,00 |
O Neon custa 2x mais por token que o Hydrogen e 50% mais que o Sol a US$ 2/US$ 10. Para vencer no preço por tarefa, precisa concluir trabalhos com menos tokens ou menos novas tentativas. Os benchmarks citados (Intelligence Index 61, posição #3, e Coding Agent Index, posição #1) são informados pelo fornecedor e não comprovam menor custo em tarefas reais (compilado de benchmarks).
Preço por token não é a sua cota
Percentuais exibidos no app não se convertem em dólares da API. Um usuário Pro relata que sessões longas com contexto no Neon consomem 1-2% por mensagem:
Também tentei mudar conversas existentes com contexto longo para o Neon e estou vendo 1-2% de uso por mensagem; parece que esse pode realmente ser utilizável no plano Pro! — u/biblecrumble (discussão)
A cota do app reflete janelas de cinco horas, nível de thinking e chamadas de ferramentas. Já a cobrança da API contabiliza todos os tokens processados, incluindo thinking, além de Search grounding separado por consulta (análise do lançamento). Faça o orçamento do trabalho via API em dólares, com base nas tabelas acima, e meça a folga da assinatura em suas próprias execuções high e xhigh.
Migre em uma linha e ajuste três pontos
Quem chama Carbon, Argon ou Hydrogen pode migrar apenas trocando o ID do modelo para gemini-4-neon (análise do lançamento). Ainda assim, três detalhes podem quebrar as chamadas (análise do lançamento):
- Defina
thinking_levelexplicitamente. O padrão do Neon é high. - Remova campos
cached_content. O cache explícito não é compatível. - Remova
temperature,top_petop_k. Valores fora da faixa retornam HTTP 400; os demais são ignorados.
Para saídas longas, aumente também max_output_tokens em direção a 65.536 ou use execução em segundo plano.
Vale migrar agora ou aproveitar o Carbon primeiro?
| Situação | Escolha |
|---|---|
| Entrega antes de 30 de novembro e necessidade de máximo raciocínio | Fique no Carbon a US$ 2/US$ 10 e teste o Neon em paralelo |
| Agentes de produção em dezembro com contexto longo | Neon a US$ 3/US$ 15 é o candidato pelo preço de tabela — valide sucesso nas tarefas e novas tentativas antes de migrar |
| Chat simples em alto volume | Fique no Hydrogen a US$ 1,50/US$ 7,50, a única opção com plano gratuito neste grupo (índice de preços) |
| Menor preço de tabela para fronteira hoje | GPT-6.2 Sol a US$ 2/US$ 10, se sua stack permitir OpenAI |
| Necessidade de documentação para Batch | Espere — Neon Batch não foi publicado |
Perguntas frequentes
Quanto custa a API Gemini 4 Neon?
US$ 3 para entrada, US$ 15 para saída e US$ 0,15 para entrada em cache a cada 1M de tokens, segundo o Google.
Quais são os limites de contexto e saída?
1.048.576 tokens de entrada e 65.536 tokens de saída síncrona.
Existe plano gratuito?
Não. O Neon é exclusivo para planos pagos; o Hydrogen mantém uma camada gratuita.
Batch, Flex ou Priority estão disponíveis?
O Google não os havia publicado no lançamento; listagens de terceiros mostram Batch/Flex por US$ 1,50/US$ 7,50 e Priority por US$ 5,40/US$ 27 — confirme antes de orçar.
Como funciona o cache?
É apenas implícito, exige no mínimo 4.096 tokens e oferece 95% de desconto na entrada elegível em cache.
Qual é o ID do modelo?
gemini-4-neon.
Neon vs Hydrogen vs Carbon: qual usar?
Hydrogen para volume barato; Carbon até 30 de novembro para os tokens de fronteira mais baratos; Neon a partir de 1º de dezembro para raciocínio avançado 25% abaixo da tarifa de US$ 4/US$ 20 do Carbon.
Quanto custa uma solicitação com 2.000 tokens de entrada e 500 de saída?
US$ 0,0135 pela tabela, antes do cache. Thinking é cobrado como saída.