Na tabela de preços, o Astra parece simples: $8 por milhão de tokens de entrada e $40 de saída, contra $2 e $10 do Sol — uma diferença de 4x. Na prática, porém, o custo depende da tarefa. Nos números do FrontierCode abaixo, o Sol executa programação rotineira por cerca de um quinto do preço ($1.29 vs $5.97), enquanto o Astra abre vantagem de aproximadamente 4 a 10 pontos nos testes especializados mais exigentes, nos quais uma execução correta pode evitar várias tentativas.
Preços da OpenAI e disponibilidade dos modelos
A OpenAI posiciona o Astra para os projetos mais difíceis e o Sol para o trabalho cotidiano (anúncio de lançamento). Uso do plano e gasto da API são medidores separados: o uso de planos ChatGPT/Codex não paga chamadas de API, e chamadas de API não consomem a cota do plano. Os dois modelos têm janela de contexto de 1,050,000 tokens, com até 922,000 tokens de entrada e 128,000 de saída por solicitação. Aceitam texto e imagem como entrada, e geram texto como saída. Os IDs são gpt-6.2-astra e gpt-6.2-sol nas APIs Responses e Chat Completions.
Preços padrão de API por milhão de tokens:
| Modelo | Entrada | Entrada em cache | Gravação em cache (30 min) | Saída |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra (antecessor) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol (antecessor) | $2.00 | $0.10 | $2.50 | $10.00 |
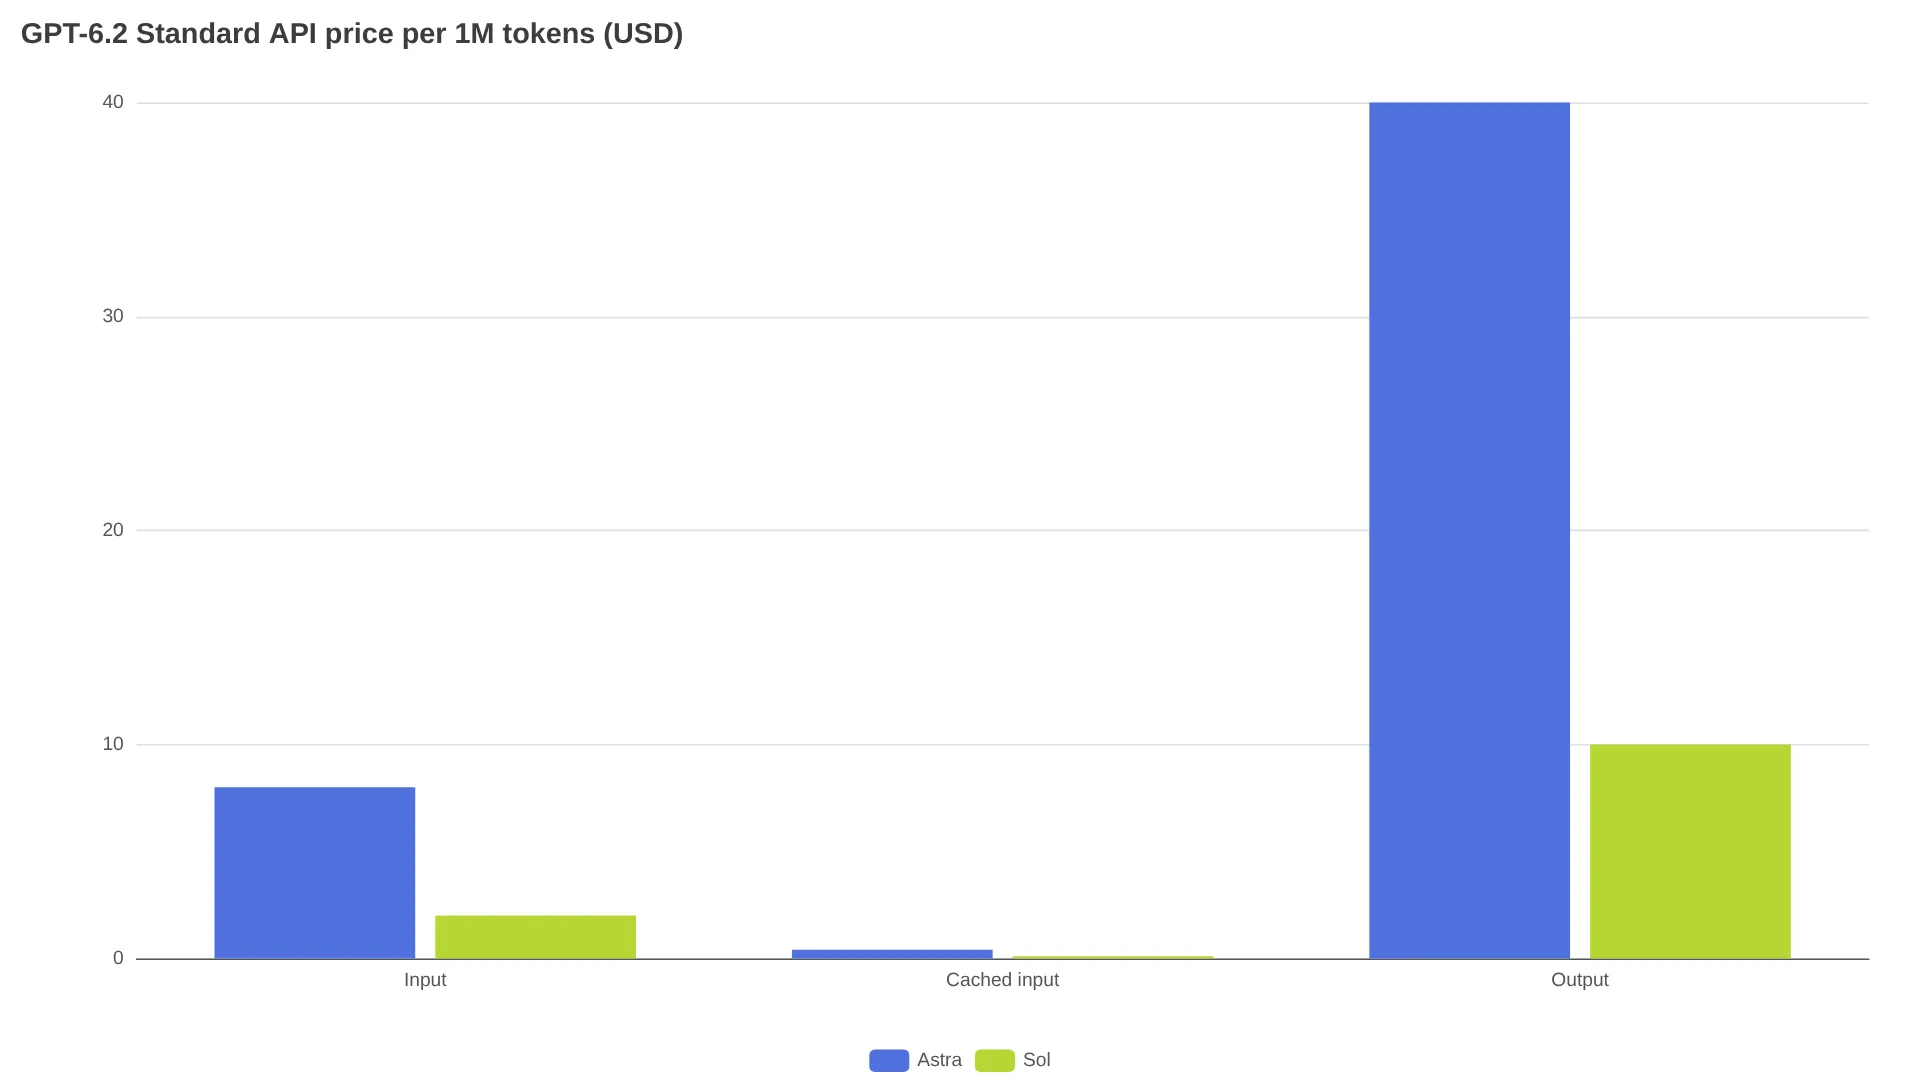
O Astra é 20% mais barato que o GPT-6 Astra em entrada e saída, além de custar 60% menos em entrada em cache. O Sol mantém os preços do GPT-6.1 Sol. No lançamento, em 17 de novembro de 2026, ambos estavam geralmente disponíveis na API; Batch tem 50% de desconto sobre o Standard, e as janelas de processamento em segundo plano custam 30–40% menos (detalhamento de níveis do GenAI Brief).
Três fatores que podem multiplicar a conta
1. Gravar no cache também tem custo. Leituras em cache custam 5% do valor de entrada ($0.40 no Astra e $0.10 no Sol). A gravação em cache custa 1.25x o valor de entrada para TTL de 30 minutos ($10.00 no Astra e $2.50 no Sol) e 2.5x para retenção de 12 horas, segundo a tabela de preços do GenAI Brief. Exemplo: regravar 108,000 tokens de histórico após uma falha de cache custa 108,000 × $10/M = $1.08 no Astra ou 108,000 × $2.50/M = $0.27 no Sol, antes da saída.
2. Ao passar de 272,000 tokens, a solicitação inteira muda de faixa. Acima de 272K tokens de entrada, o preço da entrada dobra ($8 para $16 no Astra e $2 para $4 no Sol), e o da saída sobe 1.5x ($40 para $60 no Astra e $10 para $15 no Sol). No teste de precificação do GenAI Brief, adicionar 20K de histórico e ultrapassar esse limite fez um turno do Astra passar de $0.344 para $0.624: aumento de 81% com 7% a mais de entrada. Resuma ou corte o histórico antes de 272K; se isso alterar o prefixo em cache, reserve orçamento para uma falha de cache.
3. As faixas de velocidade multiplicam todos os valores. Fast custa 2x o Standard. Ultrafast custa 3x até 28 de fevereiro de 2027 e passa a 6x em 1º de março de 2027 (somente residência nos EUA; Standard/Fast/Batch aceitam EUA e UE), conforme as regras de níveis do GenAI Brief e a documentação de níveis de processamento da OpenAI. A 3x, a saída do Astra custa $120/M; a 6x, $240/M.
O que importa é o custo por tarefa, não por token
Com o mesmo volume de tokens, o Astra custa 4x mais que o Sol. Ele só compensa se usar menos tokens, exigir menos tentativas ou evitar uma correção humana cara. A regra de equilíbrio é direta: uma tentativa com Astra precisa substituir mais de quatro tentativas com Sol, com a mesma quantidade de tokens, ou reduzir os tokens ponderados em cerca de 75%, para vencer em gasto direto de API.
Custos de tarefa reportados — os benchmarks, configurações de esforço e métodos de cálculo diferem, portanto use-os como referência de direção e confirme com seus próprios replays:
| Fonte / carga de trabalho | Astra | Sol | O que indica |
|---|---|---|---|
| Índice de Inteligência da Artificial Analysis, esforço máximo | 62 a $4.00/tarefa, 10.4 min (GPT-6 Astra: 57 a $6.24) | 57 a $1.01/tarefa, 7.9 min | O Sol iguala a pontuação 57 do GPT-6 Astra por cerca de um sexto do custo de $6.24 por tarefa |
| FrontierCode 2.0 via DataCamp, esforço máximo | 44.2% a $5.97/tarefa | 43.8% a $1.29/tarefa | Diferença de 0.4 ponto por cerca de 5x o custo por tarefa; nessa evidência de programação, Astra não justifica o preço |
| Harvey LAB-AA / SecureSWE / Terminal-Bench-Science via DataCamp | 15.0% / 65.7% / 77.1% | 11.1% / 55.6% / 68.0% | A vantagem do Astra é maior aqui; vale testá-lo para jurídico, código seguro e ciência |
| BenchCAD 2.1 Core via DataCamp | 82.5% | 73.1% | Diferença de cerca de 9 pontos em CAD sustenta testar Astra nesse tipo de trabalho |
| Reconstrução de slide pelo DataCamp, teste de execução única | $0.22, 4,968 tokens de saída | $0.07, tamanhos de fonte exatos | Não houve diferença visível de qualidade nessa tarefa baseada em template; o Sol venceu no custo |
| Agents' Last Exam via resumo do DataCamp sobre números da OpenAI, Sol High vs. antigo Astra Max | — | Sol High 72.0% a $0.69/tarefa vs. GPT-6 Astra Max 73.1% a $8.99 | Cerca de 1 ponto a menos por aproximadamente 1/13 do custo nessa configuração |
Exemplo com a conta correta: se cada tentativa com Sol custa $0.10 e há 2 sucessos a cada 3 tentativas, o custo do Sol é $0.15 por resultado aceito. Nesse cenário, o Astra, a $0.40 por tentativa, não consegue vencer apenas por taxa de sucesso. O Astra passa a ganhar quando o sucesso do Sol desaba, como 1 êxito em 5 tentativas ($0.50 por resultado aceito), enquanto o Astra acerta na primeira ($0.40). A OpenAI informa 22% menos tokens de saída para o Astra no GDPval v2; trate alegações do fornecedor como indicativas.
Comece com o Sol para programação rotineira e agentes de alto volume; teste o Astra em jurídico, CAD ou execuções científicas longas. Encaminhe para o Astra apenas quando total spend / accepted tasks, incluindo novas tentativas e correções, for menor.
Prefixo estável preserva o cache e evita reprocessamento
Alterar instruções, ferramentas, esquemas ou saídas anteriores no meio da conversa pode invalidar o cache e acionar novo raciocínio no GPT-6.2.
Para preservar o cache de prefixo (notas de integração do GenAI Brief, documentação de modelos da OpenAI):
- Adicione uma nova mensagem de desenvolvedor ou
configuration_update, em vez de reescrever as mensagens iniciais. - Inclua ferramentas com
additional_toolsou controle-as comtool_choice/allowed_tools, em vez de trocar a lista de ferramentas no meio da conversa. - Encurte saídas antigas de ferramentas e reduza imagens antes do primeiro envio.
- Faça o diagnóstico com Prompt Cache Diagnostics e
input_transformationsdo Responses (prefix_mismatch) antes de migrar tráfego de produção.
Checklist de migração para Astra e Sol
Com base no guia de migração da EpiFive e nas regras de integração do GenAI Brief, verificados com a comparação de modelos da OpenAI:
- Altere
modelparagpt-6.2-astraougpt-6.2-sol. - Comece com
reasoning.effort: medium(Responses) oureasoning_effort: medium(Chat Completions).noneé rejeitado; uselowpara chamadas de baixa latência. - Remova
temperature,top_pelogprobs/top_logprobsdas solicitações. Mova o uso de ferramentas para a API Responses. - Ao migrar do GPT-5.5 ou anterior, substitua
prompt_cache_retentionporprompt_cache_options.ttl: "30m"e inclua o gasto de gravação em cache no orçamento. - Com Zero Data Retention,
storeé tratado comofalse— reenvie os itens de saída anteriores na ordem correta, incluindo itens de raciocínio criptografados. - Execute novamente 30 tarefas curtas por modelo — taxa de aprovação, novas tentativas, tokens de saída e custo por resultado aceito — mais uma sessão longa de agente com prefixo estável versus uma edição no prefixo — taxa de acerto de cache e custo total da tarefa.