A API do Qwen4 Max deixou de ser apenas uma prévia limitada ao Token Plan e já pode ser usada no modelo pay-as-you-go: US$ 1,50 por 1M de tokens de entrada e US$ 4,50 por 1M de tokens de saída, com janela de contexto de 1M de tokens. Já dá para construir com qwen4-max, mas atenção: o qwen4-max-preview será descontinuado em 25 de novembro de 2026.
Qwen4-Max API em resumo: disponível desde 16 de novembro de 2026
A Alibaba liberou o Qwen4-Max de forma geral em 16 de novembro de 2026, no Alibaba Cloud Model Studio, com o identificador qwen4-max. Antes disso, o modelo passou por uma prévia exclusiva para assinantes do Token Plan, iniciada em 11 de novembro. O lançamento foi anunciado pela conta @Alibaba_Qwen como uma nova arquitetura MoE com visão nativa e janela de contexto de 1M de tokens; a API já está disponível no QwenCloud. A documentação do QwenCloud replica as instruções do Model Studio para acesso internacional. Use o endpoint do Model Studio correspondente à sua região (documentação do QwenCloud).
| Item | Qwen4-Max (qwen4-max) |
|---|---|
| Status | Disponível em geral desde 16 de nov. de 2026; a prévia qwen4-max-preview funciona de 11 a 25 de nov. de 2026 e depois será descontinuada |
| Entrada / saída | US$ 1,50 / US$ 4,50 por 1M de tokens (Singapura, internacional) |
| Leitura do cache | US$ 0,075 por 1M de tokens |
| Outras regiões | US$ 1,413 / US$ 4,24 por 1M de tokens nos EUA (Virgínia), Frankfurt, Tóquio e Hong Kong |
| Contexto | 1M de tokens; entrada máxima listada em 991K tokens |
| Saída máxima | 131.072 tokens sem raciocínio; 262.144 tokens para raciocínio mais resposta |
| Modos de entrada | Texto, imagens e vídeo |
| Estilo da API | Compatível com OpenAI e Anthropic; chamadas de ferramentas, saída JSON estruturada, busca na web, cache, processamento em lote e fine-tuning |
| Regiões | Singapura, EUA (Virgínia), Frankfurt, Tóquio, Hong Kong e Pequim; trabalhos em lote apenas em Pequim |
| Teste | Novas contas de Singapura recebem 1M de tokens gratuitos por 90 dias |
Os preços e limites acima vêm da documentação do Alibaba Cloud Model Studio, conforme reportado em 16 de novembro de 2026 (preços e documentação do QwenCloud). Exemplo: 100K tokens de entrada + 10K de saída custam aproximadamente US$ 0,15 + US$ 0,045 = US$ 0,195 em Singapura.
O que realmente mudou em relação ao Qwen3.8-Max
O anúncio da Qwen, com números da Artificial Analysis, coloca o Qwen4-Max em 43 pontos no Intelligence Index — 9 pontos acima do Qwen3.8-Max (xhigh) e 3 pontos abaixo do Kimi K3.1 Pro. O custo médio é de US$ 3,27 por tarefa, aproximadamente um terço do Qwen3.8-Max, com 39% menos tokens de saída.
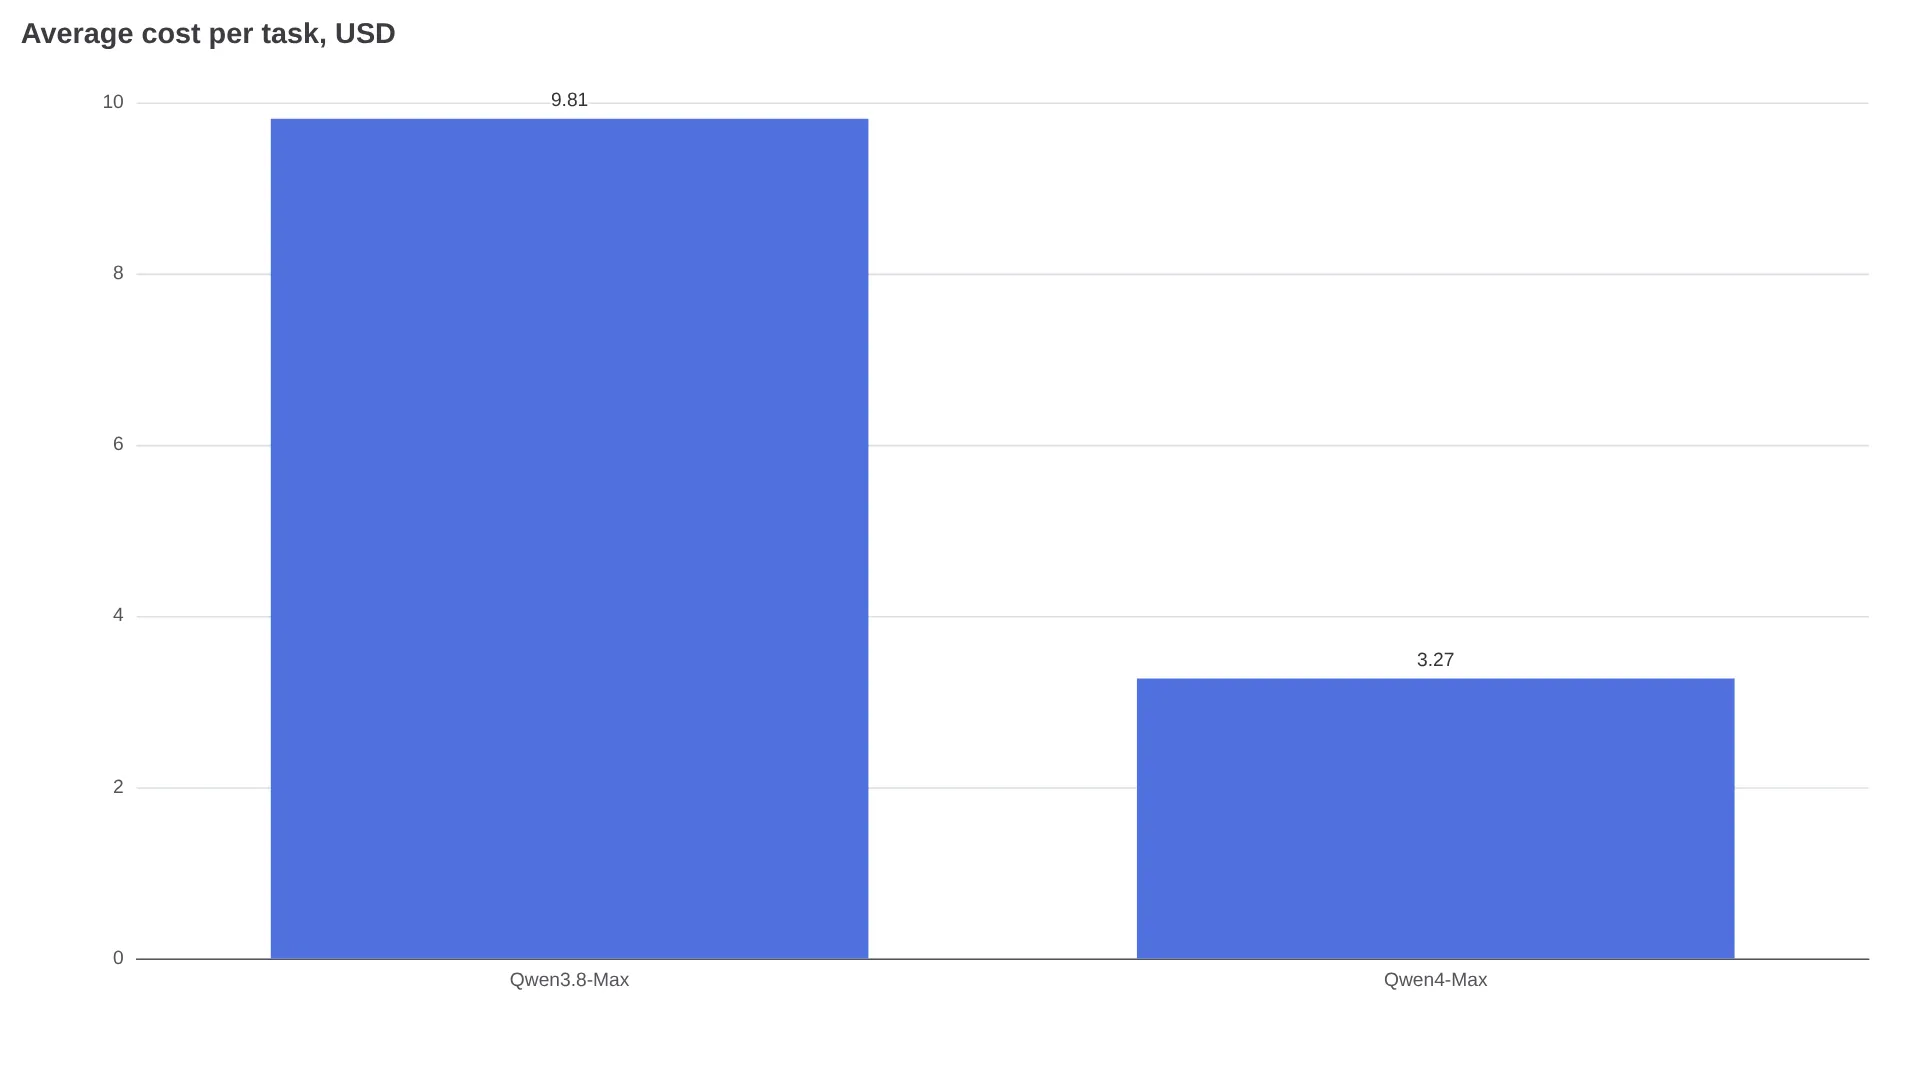
São duas economias combinadas: o preço por token mostrado na tabela e a redução no número de tokens por tarefa — até cerca de 50% menos na avaliação interna da Qwen. Um processamento de 1M de tokens com reutilização de cache é o cenário mais beneficiado, já que as leituras implícitas do cache custam US$ 0,075 por 1M, valor anunciado como 70% menor que o cache do Qwen3.8-Max.
Por baixo do capô, o Qwen4-Max usa uma arquitetura MoE com visão nativa, 2,4T de parâmetros totais, 71B ativos e 328B de embedding N-gram. Embora o blog da Qwen cite pontuações da Artificial Analysis, o AI First Look e o AICoder observam que as tabelas completas de benchmarks e as listagens públicas no ranking da AA ainda não estavam disponíveis em 16 de novembro.
Para conhecer o antecessor, veja também: preços da API do Qwen3.8-Max e Qwen3.8-Max vs. Kimi K3.
Especificações e limites que afetam a conta
Mais do que o número chamativo de 1M, três limites merecem atenção.
Contexto total não é o mesmo que entrada utilizável. A janela tem 1M de tokens, mas o QwenCloud informa uma entrada máxima de 991K tokens. Reserve uma margem de segurança e teste a recuperação de informações no meio do contexto em fluxos que dependem muito de retrieval.
Saída e raciocínio dividem o mesmo orçamento. Sem raciocínio, a saída máxima é de 131.072 tokens. Com o raciocínio ativado, o raciocínio e a resposta compartilham um limite de 262.144 tokens; quanto mais pesada a análise, menos espaço sobra para a resposta. Na prévia, o limite compartilhado entre raciocínio e resposta era de 393.216 tokens, segundo o resumo de especificações da prévia feito pelo XenoSpectrum. Portanto, não coloque os limites da prévia em produção sem revisar.
O padrão de raciocínio também mudou. O raciocínio vem ativado por padrão. No modelo GA, o nível padrão é high, com low e xhigh também disponíveis; na prévia, o padrão era xhigh, de acordo com a tabela de especificações do AI First Look. Se a latência estiver alta, reduza primeiro o reasoning_effort para low.
A entrada multimodal aceita texto, imagens e vídeo. Na prévia, os limites de envio de vídeo eram de 2 horas, 2 GB e 64 vídeos por solicitação, segundo o resumo de especificações da prévia do XenoSpectrum. Esses são limites de envio, não uma garantia de compreensão. Teste a recuperação de informações em vídeos longos usando os seus próprios arquivos.
Para controlar custos, peça uma saída JSON estruturada e reduza respostas prolixas; também vale reutilizar contextos longos por meio de leituras do cache, que custam US$ 0,075 por 1M em Singapura. As notas de lançamento do AICoder também listam a criação explícita de cache por cinco minutos a US$ 1,875 por 1M onde houver suporte.
Como chamar o qwen4-max com o SDK da OpenAI
O Model Studio oferece os formatos de Chat Completions, Responses e Anthropic Messages da OpenAI, segundo a documentação do modelo da Alibaba Cloud. Use qwen4-max nos backends pay-as-you-go; o qwen4-max-preview é exclusivo do Token Plan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
Use a chave e o endpoint da mesma região no Model Studio. Quando houver suporte, solicite response_format={"type": "json_object"} ou um JSON Schema e valide saídas estruturadas grandes.
Pay-as-you-go, Token Plan ou apps de chat: qual opção escolher?
| Opção | Mais indicada para | Principal restrição |
|---|---|---|
Pay-as-you-go do Model Studio (qwen4-max) | Aplicativos, backends e processamento em lote | Cobrança por token; confira a região do endpoint e a chave |
Token Plan (qwen4-max-preview) | Programação interativa no Claude Code, Cline, Cursor e OpenCode | Apenas uso interativo; não permite automação em produção, scripts em lote ou incorporação em backends; somente na região de Singapura; termina em 25 de nov. de 2026, às 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio e Qoder | Testar prompts, trabalhar com documentos e usar uma IDE agêntica sem configurar chaves | Disponibilidade e taxas de créditos aparecem no app; não constituem um contrato de API |
O Token Plan funciona como uma franquia mensal de créditos para desenvolvimento interativo. O detalhamento do Token Plan feito pelo Apidog lista planos individuais que vão do Lite, por US$ 3 promocionais / US$ 8 de tabela, com 20.000 créditos, ao Pro, por US$ 43 promocionais / US$ 51 de tabela, com 200.000 créditos. As chaves começam com sb-sp-. Compartilhar chaves, executar trabalhos em segundo plano ou embutir a chave em um backend distribuído viola os termos. Para testes rápidos de prompts, o Apidog e o XenoSpectrum listam Qwen Chat, QwenWork, QwenStudio e Qoder como opções de avaliação; a disponibilidade aparece no app e varia conforme a conta.
Faça a migração antes de 25 de novembro de 2026:
- Troque o nome do modelo de
qwen4-max-previewparaqwen4-max. - Substitua a URL-base e a chave do Token Plan por uma chave pay-as-you-go do Model Studio e pelo endpoint regional.
- Teste novamente os padrões de raciocínio (
xhighparahigh). - Meça de novo os limites de saída (393K compartilhados na prévia contra 131K/262K no GA).
O que os primeiros usuários relatam: builds iniciais rápidos, agentes irregulares
Testes com amostras pequenas reunidos pelo AI First Look relatam builds funcionais a partir de um único prompt. Em um deles, foram aprovados 20 de 20 testes ocultos em cerca de 2,5 minutos, contra 17 minutos do Qwen3.8-Max. O mesmo compilado, porém, registra um teste de jogo em que o Qwen4-Max terminou mais rápido, mas ainda ficou em segundo lugar na avaliação geral.
Estou encontrando essas falhas o tempo todo ao tentar gerar qualquer código.
— @bijanbowen, publicação (primeira impressão de um usuário real, 16 de novembro de 2026; captura de tela com erros repetidos de geração de código)
Um compilado inicial de testes em chinês (@weconomypistis) apontou o preço e o custo por tarefa como os maiores avanços, mas considerou as operações no terminal e com agentes inferiores às do Kimi, com respostas mais lentas.
FAQ
O Qwen4-Max tem pesos abertos?
Não. Em 16 de novembro, o Qwen4-Max era oferecido apenas como serviço hospedado, sem pesos anunciados, segundo o rastreador do AI First Look. A Qwen afirma que modelos Qwen4 menores receberão pesos abertos posteriormente, de acordo com o anúncio do Qwen4-Max, mas ainda não informou data, tamanhos ou licença.