 AIREITER
Dois modelos chineses de ponta com arquitetura mixture-of-experts, contexto de um milhão de tokens e raciocínio no esforço máximo ativado por padrão — mas com custos bastante diferentes. O Kimi K3 é a opção mais forte para programação, porém cobra US$ 15 por milhão de tokens de saída: 2,5x os US$ 6 do Qwen 3.8 Max. Já o Qwen 3.8 Max, em disponibilidade geral desde 3 de agosto de 2026, é a escolha mais nova e econômica, além de levar vantagem em gráficos e uso de computador. A contrapartida é que os dois raciocinam intensamente por padrão: no Kimi K3, a tarifa maior de saída pesa em cada requisição; e os pesos abertos do Qwen só devem chegar por volta de 11 de agosto.
Modelos muito parecidos no papel, com escolhas bem diferentes na prática
Qwen 3.8 Max e Kimi K3 são modelos mixture-of-experts de trilhões de parâmetros, com janelas de contexto de um milhão de tokens e visão nativa. Foram lançados com apenas três semanas de diferença em meados de 2026. As especificações os colocam na mesma faixa, o que faz muitas comparações virarem uma troca interminável de benchmarks. Na prática, a decisão é mais objetiva: quanto você aceita pagar a mais em saída para ganhar qualidade em programação, e se precisa agora de pesos abertos ou de multimodalidade mais forte.
| Especificação | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Parâmetros totais | 2.4T | 2.8T |
| Ativos por token | ~95B | 104B |
| Arquitetura | MoE (~4% ativos) | MoE (16 de 896 especialistas) |
| Janela de contexto | ~1M (991K de entrada máxima) | 1,048,576 |
| Visão | Sim (entrada de texto + imagem) | Sim (nativa) |
| Raciocínio padrão | xhigh, thinking ativado | esforço máximo, reasoning ativado |
| Pesos abertos | Não (previsão de ~11 de agosto) | Sim (HF, 27 de julho, 1.56TB MXFP4) |
| Status da API | GA, 3 de agosto de 2026 | GA |
Fontes: comparativo direto da yottalabs, Alibaba QwenCloud via AIReiter e Moonshot platform.kimi.ai, verificados em 6 de agosto de 2026.
Preços, custo por carga de trabalho e acesso
Os dois fornecedores divulgam preços por token, mas a maior diferença não está onde a contagem de parâmetros sugere. Ela se concentra nos tokens de saída, justamente onde modelos de raciocínio consomem grande parte do orçamento. O Kimi K3 cobra US$ 15 por milhão de tokens de saída, contra US$ 6 do Qwen 3.8 Max. Como ambos expõem o raciocínio por padrão, essa cobrança vale tanto para os traços de raciocínio quanto para a resposta final.
| Preço por 1M de tokens | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Entrada (sem cache) | US$ 2.00 | US$ 3.00 |
| Entrada (com cache) | US$ 0.25 | US$ 0.30 |
| Saída (inclui thinking) | US$ 6.00 | US$ 15.00 |
| Contexto | ~1M | 1,048,576 |
Fontes: página de modelos Alibaba QwenCloud, atualizada em 2 de agosto de 2026, e Moonshot platform.kimi.ai/docs/pricing/chat-k3, verificados em 6 de agosto de 2026.
Em uma carga típica de programação — 20M de tokens de entrada, 60% de cache hit e 5M de tokens de saída — o Kimi K3 custa cerca de US$ 103, sendo US$ 27.60 de entrada e US$ 75 de saída. No Qwen 3.8 Max, o total fica perto de US$ 49: US$ 19 de entrada e US$ 30 de saída. A diferença de 2x vem quase toda da saída. O cache reduz a distância na entrada, mas não altera a tarifa de saída; e, como os dois usam raciocínio máximo por padrão, essa parcela tende a ser grande.
O acesso também não é igual. O Qwen 3.8 Max entrou em disponibilidade geral na API da Alibaba em 3 de agosto de 2026, mas seus pesos ainda não são públicos. A página do modelo continua indicando Open Source: No, com previsão de publicação no Hugging Face e no ModelScope na semana de 11 de agosto (Alibaba, via a página de preços do Qwen 3.8 Max). O Kimi K3 é a alternativa aberta: a Moonshot publicou o checkpoint MXFP4 de 1.56 TB em 27 de julho, e a API já está disponível.
O Kimi K3 também pode ser acessado pelo endpoint de API Kimi K3 da AIReiter, pela tarifa oficial da Moonshot e sem markup. É útil para testar o K3 ao lado de outros modelos em uma única fatura. O Qwen 3.8 Max ainda não foi integrado ao serviço.
Kimi K3 é superior em programação agêntica
Para programação em várias etapas — loops de agentes, refatorações de repositórios e tarefas no estilo SWE que exigem chamadas de ferramentas e recuperação após becos sem saída — o Kimi K3 é a melhor escolha. Ele supera o Qwen 3.8 Max de forma consistente nos benchmarks públicos de agentes, com uma margem maior justamente nas tarefas mais próximas do trabalho real de engenharia.
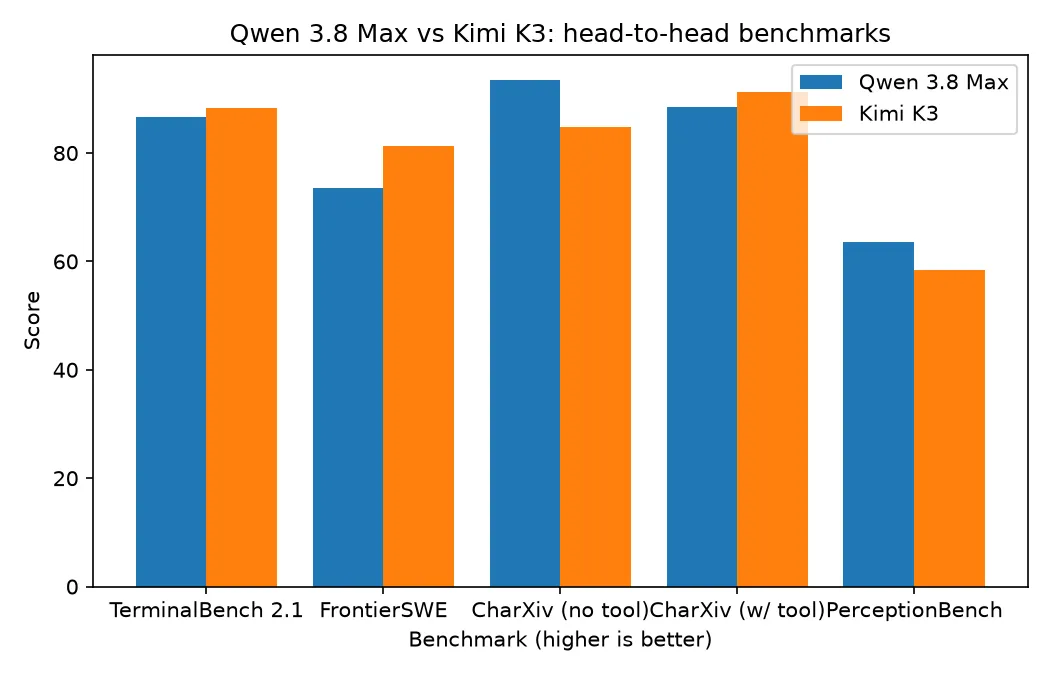
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv (com ferramenta) | 88.4 | 91.3 |
Fonte: comparativo direto da yottalabs, verificado em 6 de agosto de 2026.
A percepção da comunidade acompanha os números, com a ressalva de custo que define esta comparação:
"O K3 está em outro nível. O Qwen 3.8 é quase parecido com ele. Ainda assim, os custos de assinatura ou API não se justificam para nenhum dos modelos como estão..." — r/Qwen_AI
"O K3 supera o Qwen 3.8 de longe neste exercício; o Qwen foi 3 vezes mais rápido que o Kimi para gerar esta landing page." — @filicroval no X
O Kimi K3 também tem uma pontuação bruta de inteligência mais alta: 57 no Artificial Analysis Intelligence Index. Por outro lado, é lento: cerca de 39 tokens de saída por segundo e 3.1 segundos até o primeiro token (Artificial Analysis). A troca aqui é qualidade e abertura em troca de mais latência e custo.
Qwen 3.8 Max entrega mais em multimodalidade e custo-benefício
O Qwen 3.8 Max faz mais sentido quando a carga de trabalho depende de interpretar gráficos, capturas de tela ou controlar um navegador, e quando o custo de saída importa mais do que extrair os últimos pontos em benchmarks de programação. Ele supera o Kimi K3 em avaliações de documentos e percepção, mantém um recorde verificado em um benchmark de uso de computador e cobra 40% da tarifa de saída do Kimi K3.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv (sem ferramenta) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | sem pontuação pública |
Fonte: comparativo direto da yottalabs, verificado em 6 de agosto de 2026.
O ponto fraco do Qwen 3.8 Max é exatamente a área em que o Kimi K3 se destaca e se aproxima dos modelos fechados de fronteira. No SWE-bench Pro, ele marca 67.7, bem abaixo dos 80 do Claude Fable 5 (tabela publicada pela Alibaba, executada pelo fornecedor). Portanto, não é o modelo indicado para as avaliações mais difíceis de engenharia de software. Sua API tinha apenas três dias no momento da publicação, já que a disponibilidade geral chegou em 3 de agosto de 2026, e seus pesos ainda são fechados. Quem precisa de self-hosting hoje terá de esperar ou escolher o Kimi K3.
Qual modelo escolher para cada carga de trabalho
A escolha certa depende menos de qual é objetivamente melhor e mais do tipo de tarefa que você vai enviar ao modelo. A tabela abaixo associa cargas de trabalho comuns à recomendação e ao motivo verificado.
| Se sua carga de trabalho é… | Escolha | Por quê |
|---|---|---|
| Loops de agentes, refatorações de repositórios, tarefas SWE (custo não é a restrição) | Kimi K3 | FrontierSWE 81.2 vs 73.5, TerminalBench 88.3 vs 86.6 |
| Leitura de documentos/gráficos, navegador ou uso de computador, com sensibilidade a custo | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, US$ 6 vs US$ 15 de saída |
| Self-hosting hoje | Kimi K3 | Pesos no HF desde 27 de julho; os do Qwen chegam por volta de 11 de agosto |
Perguntas frequentes
O Qwen 3.8 Max é melhor que o Kimi K3 para programação?
Não. O Kimi K3 lidera os benchmarks de programação agêntica mais relevantes, com 81.2 a 73.5 no FrontierSWE e 88.3 a 86.6 no TerminalBench 2.1. Para tarefas de engenharia em várias etapas, o Kimi K3 é a escolha mais forte.
Qual é mais barato: Qwen 3.8 Max ou Kimi K3?
O Qwen 3.8 Max. Ele cobra US$ 6 por milhão de tokens de saída, contra US$ 15 do Kimi K3, e US$ 2 de entrada, contra US$ 3. Os preços de cache hit são parecidos, resultando em uma diferença de aproximadamente 2x em uma carga típica de programação.
Qual é mais barato para programação agêntica com raciocínio máximo?
O Qwen 3.8 Max continua sendo mais barato. Os dois modelos cobram tokens de raciocínio como saída no esforço máximo, então a tarifa de US$ 15/M do Kimi K3 amplia a diferença justamente na carga de programação em que ele é superior.
Os dois modelos aceitam contexto de um milhão de tokens?
Sim. O Qwen 3.8 Max aceita aproximadamente 991K tokens de entrada, menos quando o thinking está ativado, enquanto o Kimi K3 aceita 1,048,576. Ambos têm, nominalmente, janelas de um milhão de tokens.
Os pesos são abertos?
Os do Kimi K3 são. A Moonshot lançou o checkpoint MXFP4 de 1.56 TB em 27 de julho de 2026. Os do Qwen 3.8 Max ainda não: a Alibaba os lista como fechados, com lançamento no Hugging Face e ModelScope previsto para a semana de 11 de agosto.
Leituras relacionadas
- Página do modelo Kimi K3: análise dedicada ao Kimi K3
- Preços da API do Qwen 3.8 Max: detalhamento completo de preços e especificações técnicas do Qwen 3.8 Max
- Qwen3.8-27B: lançamento menor de pesos abertos da linha Qwen 3.8 para self-hosting
- Kimi K2.7 Code vs GLM 5.2: comparação relacionada dentro da mesma categoria de modelos para programação