 AIREITER
O Qwen3.8-Max já está em disponibilidade geral, com preço de US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. Só a tarifa de saída já custa quatro vezes menos — ou ainda menos — que Claude Opus 4.8, Claude Fable 5 e GPT-5.6 Sol. Há, porém, um detalhe importante para a conta final: o reasoning_effort vem configurado como xhigh, fazendo o valor cobrado se distanciar rapidamente do preço de tabela.
Quanto custa usar o Qwen3.8-Max
O Qwen3.8-Max é um modelo mixture-of-experts de 2,4 trilhões de parâmetros, com 95 bilhões de parâmetros ativos por token. Ele assume o posto de principal modelo da Alibaba antes ocupado pelo Qwen3.7-Max. Os valores abaixo foram publicados na página do modelo da Alibaba, atualizada em 2 de agosto de 2026:
| Item | Preço por 1 milhão de tokens |
|---|---|
| Entrada | US$ 2,00 |
| Saída | US$ 6,00 |
| Entrada (cache implícito) | US$ 0,25 |
| Criação de cache explícito | US$ 2,50 |
| Leitura de cache explícito | US$ 0,17 |
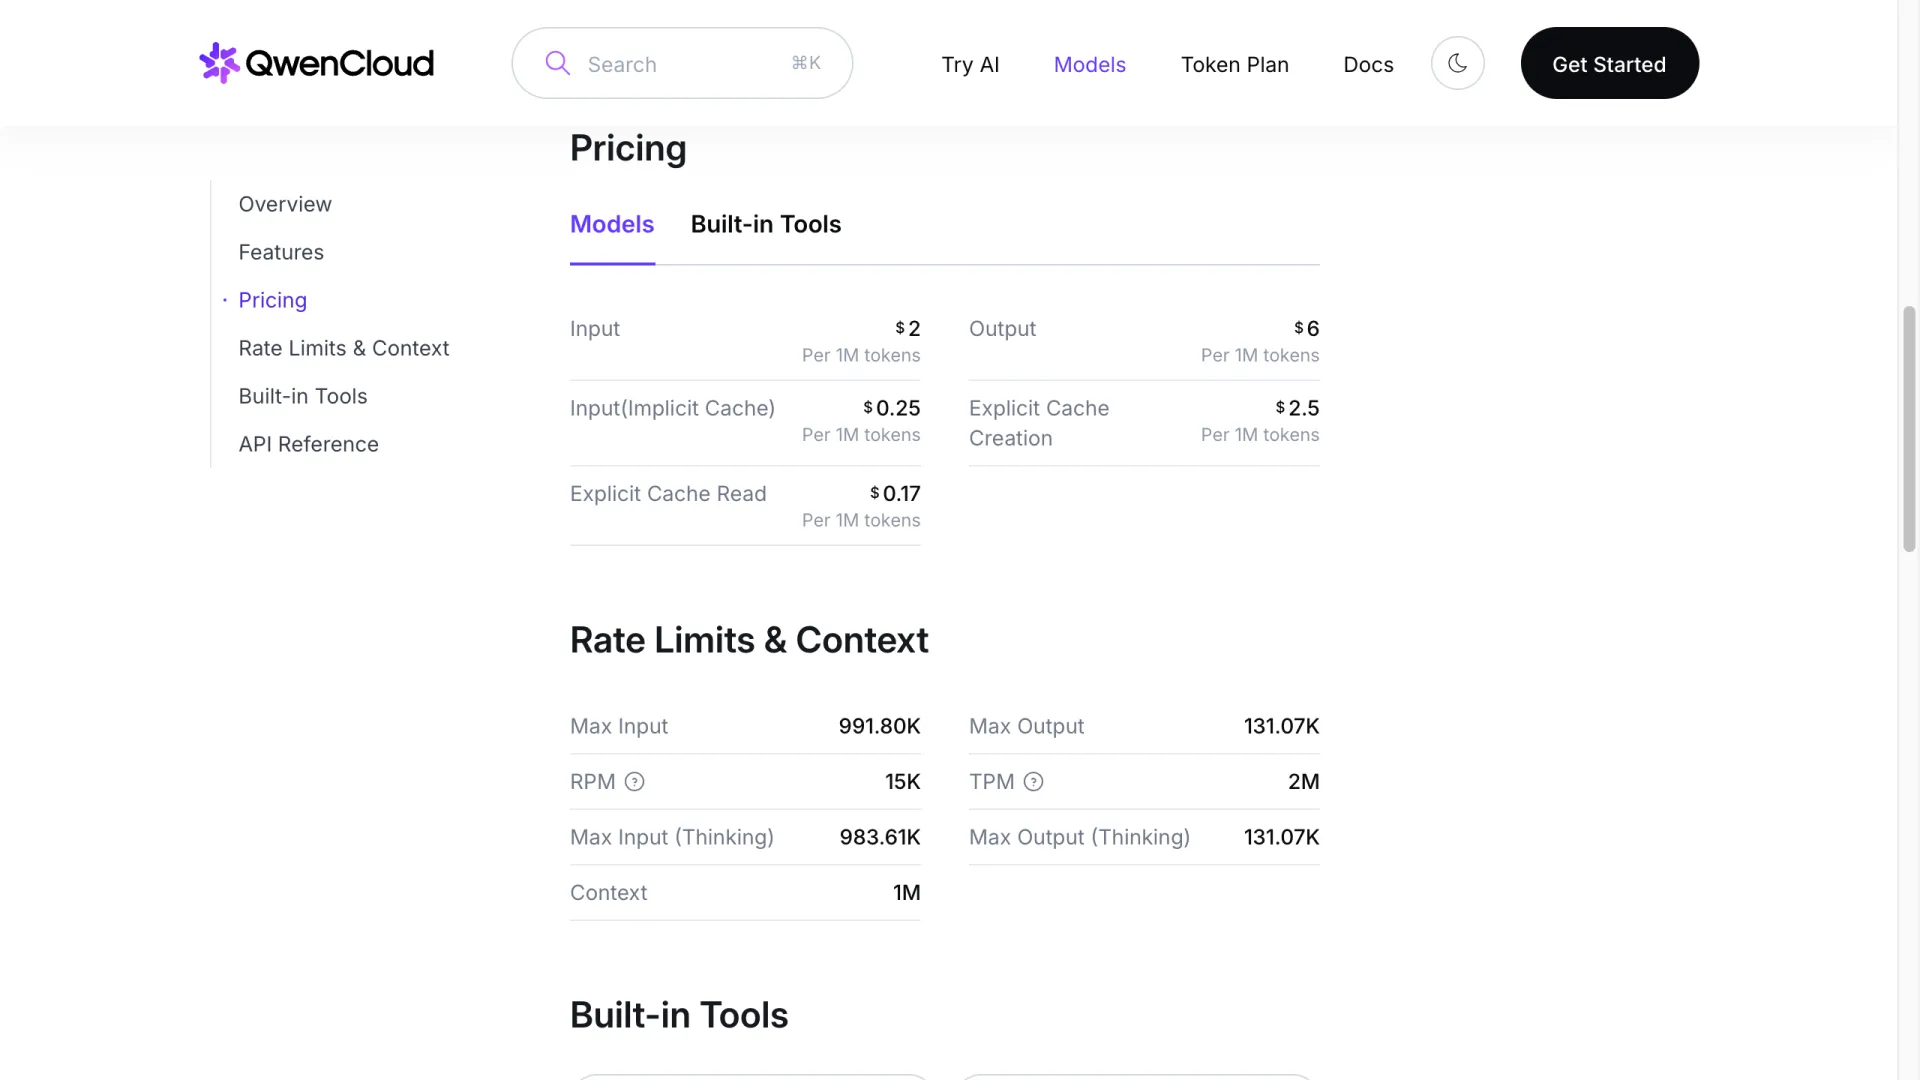
O cache implícito não exige nenhuma implementação: prefixos repetidos passam automaticamente a custar US$ 0,25, ou um oitavo da tarifa normal de entrada. Já o cache explícito exige uma escolha. Gravar custa US$ 2,50 e ler custa US$ 0,17; por isso, ele supera a entrada sem cache a partir da segunda leitura. Em relação à tarifa implícita de US$ 0,25, porém, só se torna vantajoso por volta da trigésima leitura do mesmo prefixo. Para a maior parte dos aplicativos, o melhor é não mexer no cache explícito.
Há uma limitação importante: a API é aberta, mas os pesos ainda não. Segundo o post de lançamento da Alibaba, os pesos do Qwen3.8-Max chegam ao Hugging Face e ao ModelScope na próxima semana. É o primeiro compromisso com data definida depois de semanas de um "em breve" sem data. Em 3 de agosto, a barra lateral da página do modelo ainda mostrava Open Source: No.
Por que US$ 6 por saída não representa a conta inteira
A documentação de lançamento da Alibaba apresenta três níveis para reasoning_effort e define xhigh como padrão. É o nível mais profundo, acima de medium ("equilibra precisão e velocidade") e low ("otimizado para velocidade e custo"). O preserve_thinking também vem ativado por padrão em todos os cenários. Como tokens de pensamento são cobrados como tokens de saída, essas duas configurações já direcionam gasto para a tarifa de US$ 6 antes mesmo do primeiro prompt.
Na prática, os dois controles de custo efetivo começam configurados contra você — e ambos podem ser alterados com um parâmetro na requisição. Reduzir para medium ou low separa pagar US$ 6 por milhão por uma deliberação profunda desnecessária de cobrar esse valor apenas nas tarefas em que ela realmente se justifica.
Um dos primeiros testadores resumiu sem rodeios o que achou desse nível de deliberação, no título de uma discussão no r/LocalLLaMA:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
Isso não é resultado de benchmark. É apenas mais um motivo para testar cada nível de esforço na sua própria carga de trabalho antes de padronizar o uso da configuração padrão.
Contexto de até 1M sem sobretaxa
A página do Qwen3.8-Max lista uma única tarifa de entrada e uma única tarifa de saída, sem faixas adicionais por tamanho de contexto. Gemini 3.1 Pro e GPT-5.6 Sol, por outro lado, passam a cobrar mais quando o contexto ultrapassa determinado limite:
| Modelo | Entrada (contexto curto) | Saída (contexto curto) | Entrada (contexto longo) | Saída (contexto longo) |
|---|---|---|---|---|
| Qwen3.8-Max | US$ 2,00 | US$ 6,00 | US$ 2,00 (até 1M) | US$ 6,00 (até 1M) |
| Gemini 3.1 Pro | US$ 2,00 (≤200K) | US$ 12,00 | US$ 4,00 (>200K) | US$ 18,00 |
| GPT-5.6 Sol | US$ 5,00 | US$ 30,00 | US$ 10,00 | US$ 45,00 |
O Gemini 3.1 Pro iguala exatamente o Qwen3.8-Max no preço de entrada até 200K tokens, mas dobra o valor acima desse ponto. Já o GPT-5.6 Sol dobra a entrada e aumenta a saída em 50% quando a requisição entra na faixa de contexto longo, sobre uma tabela que já foi reestruturada.
Assim, a diferença aumenta à medida que o contexto cresce, em vez de permanecer estável. Um prompt de 400K tokens custa US$ 0,80 em entrada no Qwen3.8-Max, US$ 1,60 no Gemini 3.1 Pro e US$ 4,00 no GPT-5.6 Sol. É em pipelines de documentos, sessões longas de agentes e análises de repositórios completos que isso se acumula. Em interações curtas de chat, o impacto quase não aparece.
Como o preço se compara aos modelos dos benchmarks da Alibaba
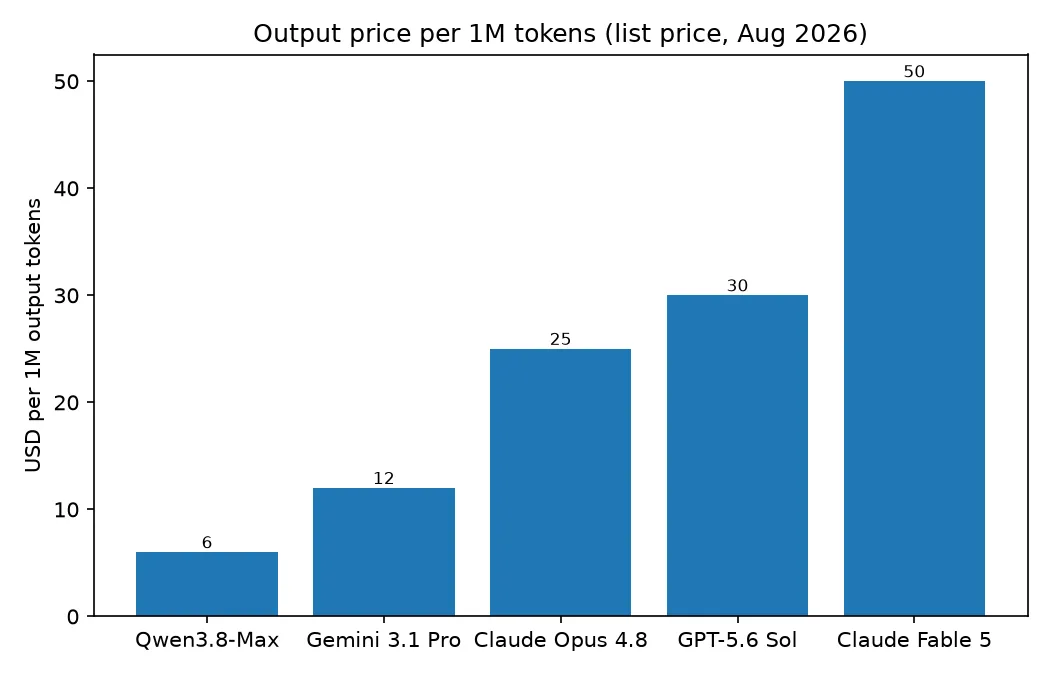
Os US$ 6 por saída representam menos de um quarto dos US$ 25 do Claude Opus 4.8 e um quinto dos US$ 30 do GPT-5.6 Sol. O Claude Fable 5, a US$ 50, custa mais de oito vezes esse valor. Se essa diferença compensa ou não depende da equivalência de capacidade, e a Alibaba publicou uma tabela com 28 linhas de benchmarks para defender que sim:
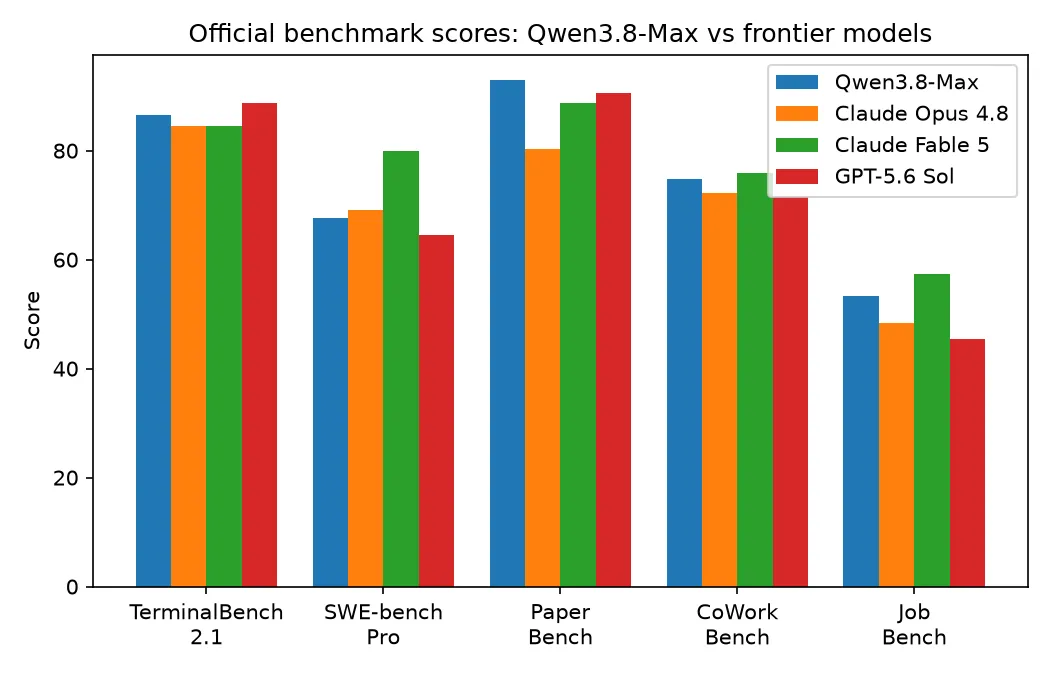
Ele lidera no PaperBench, com 93,0 contra 90,5 do GPT-5.6 Sol e 88,8 do Fable 5; no JobBench, marca 53,4 contra 48,4 do Opus 4.8; e supera por pouco os dois modelos Claude no Terminal Bench 2.1, com 86,6. Já no SWE-bench Pro, fica bem atrás: os 80,0 do Fable 5 estão mais de doze pontos à frente dos seus 67,7. Todos esses números foram obtidos e publicados pelo fornecedor na mesma página.
Isso divide a escolha de forma bastante clara. Em trabalhos agentivos com muito uso de saída — loops longos de chamadas de ferramentas, geração de documentos e o tipo de reprodução de pesquisa medido pelo PaperBench — um desconto de 4 a 8 vezes na saída muda a economia unitária de operar o sistema. Em engenharia de software no nível de repositório, que é o que o SWE-bench Pro avalia, o desconto vem acompanhado de uma queda real de capacidade. Nesse cenário, ainda faz sentido pagar as tarifas do Fable 5.
Testar isso na sua própria carga de trabalho é simples e barato: o post de lançamento da Alibaba documenta chamadas de chat-completions e responses compatíveis com OpenAI, além de uma interface compatível com Anthropic. São os mesmos dois formatos de requisição aceitos por Claude Opus 4.8 e GPT-5.6 Sol.
O que mudar no código agora
O identificador do modelo é qwen3.8-max. Em 3 de agosto, ele era a única entrada 3.8 no catálogo de modelos da Alibaba; o identificador de prévia qwen3.8-max-preview desapareceu. Portanto, verifique seu provedor de relay antes de pressupor que algum desconto da prévia continuou após a disponibilidade geral.
As duas interfaces são atendidas por três URLs-base regionais: Pequim, Singapura e Virgínia, nos EUA. Estes são os primeiros limites que devem entrar no caminho:
| Limite | Valor |
|---|---|
| Janela de contexto | 1M |
| Entrada máxima | 991,80K |
| Entrada máxima (thinking) | 983,61K |
| Saída máxima | 131,07K |
| Requisições por minuto | 15K |
| Tokens por minuto | 2M |
Vale notar a diferença de aproximadamente 8K tokens entre os dois limites de entrada: ativar thinking reduz a margem disponível para a entrada, além de aumentar os tokens de saída. E, se os pesos realmente chegarem na próxima semana, o número de 95B de parâmetros ativos será o ponto de partida para qualquer comparação entre hospedar o modelo e pagar US$ 2/US$ 6 pela API.
Perguntas frequentes
A API do Qwen é grátis?
Não. O Qwen3.8-Max é cobrado por token: US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. A assinatura Token Plan vendida na plataforma de API da Alibaba é um produto separado, baseado em créditos, e não se confunde com a cobrança por token da API.
Quanto custa o Qwen Max?
Na geração atual, custa US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída, com cache implícito de prefixo a US$ 0,25. Entradas mais antigas de qwen-max na documentação da Alibaba Cloud se referem a gerações anteriores e têm outras tarifas.
O Qwen3.8-Max cobra mais pela janela de contexto de 1M?
Não. Entrada e saída têm o mesmo preço com 5K tokens ou 900K tokens, a diferença estrutural mais clara em relação ao GPT-5.6 Sol e ao Gemini 3.1 Pro.
O Qwen3.8-Max é mais barato que o Qwen3.7-Max?
Não é possível responder com base nas páginas oficiais. A página do modelo Qwen3.7-Max mostra os preços por token como --, atrás de uma indicação de 50% de desconto, em vez de informar as tarifas. Portanto, não há um valor publicado para comparar.
Leituras relacionadas
- Preços do Claude Fable 5: a faixa de US$ 10/US$ 50 comparada aqui
- Como reduzir os custos de tokens do Claude Fable 5: os mesmos controles de esforço e cache em outro fornecedor