 AIREITER
Baixar 17GB não significa que você terá um agente local confortável de usar. O Qwen3.8-27B é um modelo open-weight capaz, sob licença Apache-2.0, mas seu raciocínio extra-alto padrão pode transformar uma tarefa rápida em uma espera longa se a quantização, o limite de contexto e a stack de serving não estiverem alinhados à máquina.
Vale a pena rodar o Qwen3.8-27B localmente?
O Qwen3.8-27B faz sentido em ambiente local para desenvolvedores com cerca de 24GB de GPU ou memória unificada disponíveis, que valorizam o tratamento local dos dados e aceitam respostas interativas mais lentas do que as de uma API hospedada rápida. Seu principal atrativo não é um benchmark isolado: trata-se de um modelo denso sob Apache-2.0, com entrada de imagem e vídeo, contexto nativo de 262.144 tokens e raciocínio configurável, em um tamanho viável para implantação. O cartão oficial do modelo da Qwen informa lançamento em 14 de agosto de 2026.
Não o encare como substituto automático para qualquer modelo de API. Os resultados oficiais foram reportados pelo próprio fornecedor, quantizações agressivas alteram qualidade e velocidade, e o raciocínio xhigh padrão é uma escolha ruim para muitas tarefas interativas locais.
Antes dos benchmarks, faça as contas de memória
O Qwen3.8-27B é um modelo denso, portanto todos os pesos entram em ação a cada token gerado. Por isso, largura de banda de memória, cache KV, quantização e contexto solicitado têm um peso que o tamanho do arquivo de pesos, sozinho, não revela. O cartão da Qwen documenta contexto nativo de 262K, mas uma sessão local pode ser configurada com muito menos do que isso para preservar memória e desempenho utilizáveis. Os exemplos de serving da Qwen mostram o máximo de 262.144 tokens; esse é um limite de capacidade, não um padrão sensato para toda máquina de consumo.
| Memória disponível | Ponto de partida prático | O que esperar | Recomendação |
|---|---|---|---|
| 12GB | Quantização agressiva classe Q3 com offload para CPU/RAM | Contexto curto e perdas consideráveis de latência | Prefira um modelo menor, a menos que o objetivo seja experimentar localmente |
| 16GB | Q3 agressivo ou uma quantização no estilo Q4 escolhida com cuidado | Viável para tarefas curtas e supervisionadas; contexto e velocidade ficam limitados | Teste antes de assumir um fluxo de trabalho com agentes |
| 24GB | Quantização classe Q4 | Ponto de entrada prático para código, ferramentas e contexto moderado | Melhor opção para a maioria dos usuários locais do Qwen3.8-27B |
| 32GB+ | Quantização de maior qualidade ou mais margem para contexto | Menos concessões em torno do cache KV e de sessões longas | Prefira esta faixa para trabalho contínuo com agentes |
São recomendações operacionais, não requisitos mínimos do fornecedor. Usuários independentes relatam que uma RTX 3060 de 12GB consegue rodar uma build local e fazer chamadas de ferramentas, enquanto outros alertam que um agente denso nesse nível de VRAM tem desempenho fraco. A divergência é justamente o motivo para não confundir “consegue carregar” com “funciona bem”. Veja a discussão de usuários reais no r/LLM.
Uma placa de 24GB é o piso para um fluxo confortável em 4 bits, não uma garantia de conforto com contexto longo. Uma análise focada em implantação estima o uso total de memória em 4 bits entre 17GB e 19GB, mas também alerta que o cache KV cresce rapidamente em sessões longas de agentes. A análise de implantação local da Neoteric é uma referência útil para planejamento, não uma especificação oficial de hardware.
Como as configurações padrão podem fazer o Qwen3.8-27B parecer inviável
O Qwen3.8-27B ativa o modo de raciocínio por padrão. O cartão oficial expõe valores de reasoning_effort, incluindo xhigh, medium e low, além de enable_thinking=False para requisições sem raciocínio; preserve_thinking também vem ativado por padrão. A seção de boas práticas da Qwen alerta que reduzir o esforço de raciocínio nem sempre diminui o tempo total para concluir uma tarefa, mas uma configuração alta ainda é um padrão caro para trabalhos triviais.
Um teste local de Simon Willison deixa a diferença clara. Ao rodar uma build Q4_K_M no LM Studio, ele relata que uma primeira tarefa de SVG usou 22.276 tokens de raciocínio e levou 21 minutos na configuração padrão; ao desativar o raciocínio, obteve um resultado diferente em 137 segundos. A configuração medida por ele não é um benchmark universal, mas ilustra bem o risco de configuração. Leia o teste completo e as transcrições.
“Eu esperava algo no mesmo nível do 3.6 35b, porém mais lento por causa da quantização pesada, mas no fim ele o superou em tudo.” u/AltruisticList6000, r/LocalLLaMA, relatando um experimento Q3 em uma RTX 4060 Ti de 16GB.
O resultado positivo não elimina as concessões. Outro relato de usuário descreve contexto limitado a 32K e uma sessão de agente que se tornou pouco confiável, enquanto outro recomenda instruções claras e atômicas para programação local. A discussão sobre o fluxo de trabalho está aqui.
O que vem oficialmente no Qwen3.8-27B
O Qwen3.8-27B é um modelo denso de visão e linguagem nativo, não um modelo MoE. O cartão oficial descreve entrada de texto, imagem e vídeo; 64 camadas; dimensão oculta de 5.120; 262.144 tokens de contexto nativo; e licença Apache-2.0. Também documenta extensão baseada em YaRN até 1M de tokens, com o alerta explícito de que YaRN estático pode prejudicar o desempenho em textos curtos. As especificações oficiais e orientações sobre contexto devem prevalecer sobre resumos de lançamento de terceiros.
O repositório oficial cita Transformers, vLLM, SGLang, TokenSpeed e caminhos locais quantizados, como llama.cpp, Ollama e LM Studio. O suporte do runner importa porque o modelo usa uma arquitetura híbrida de Gated DeltaNet e Gated Attention; atualize o runner antes de diagnosticar uma falha do modelo. O repositório quickstart da Qwen inclui exemplos de serving compatíveis com OpenAI.
O que os benchmarks publicados comprovam — e o que não comprovam
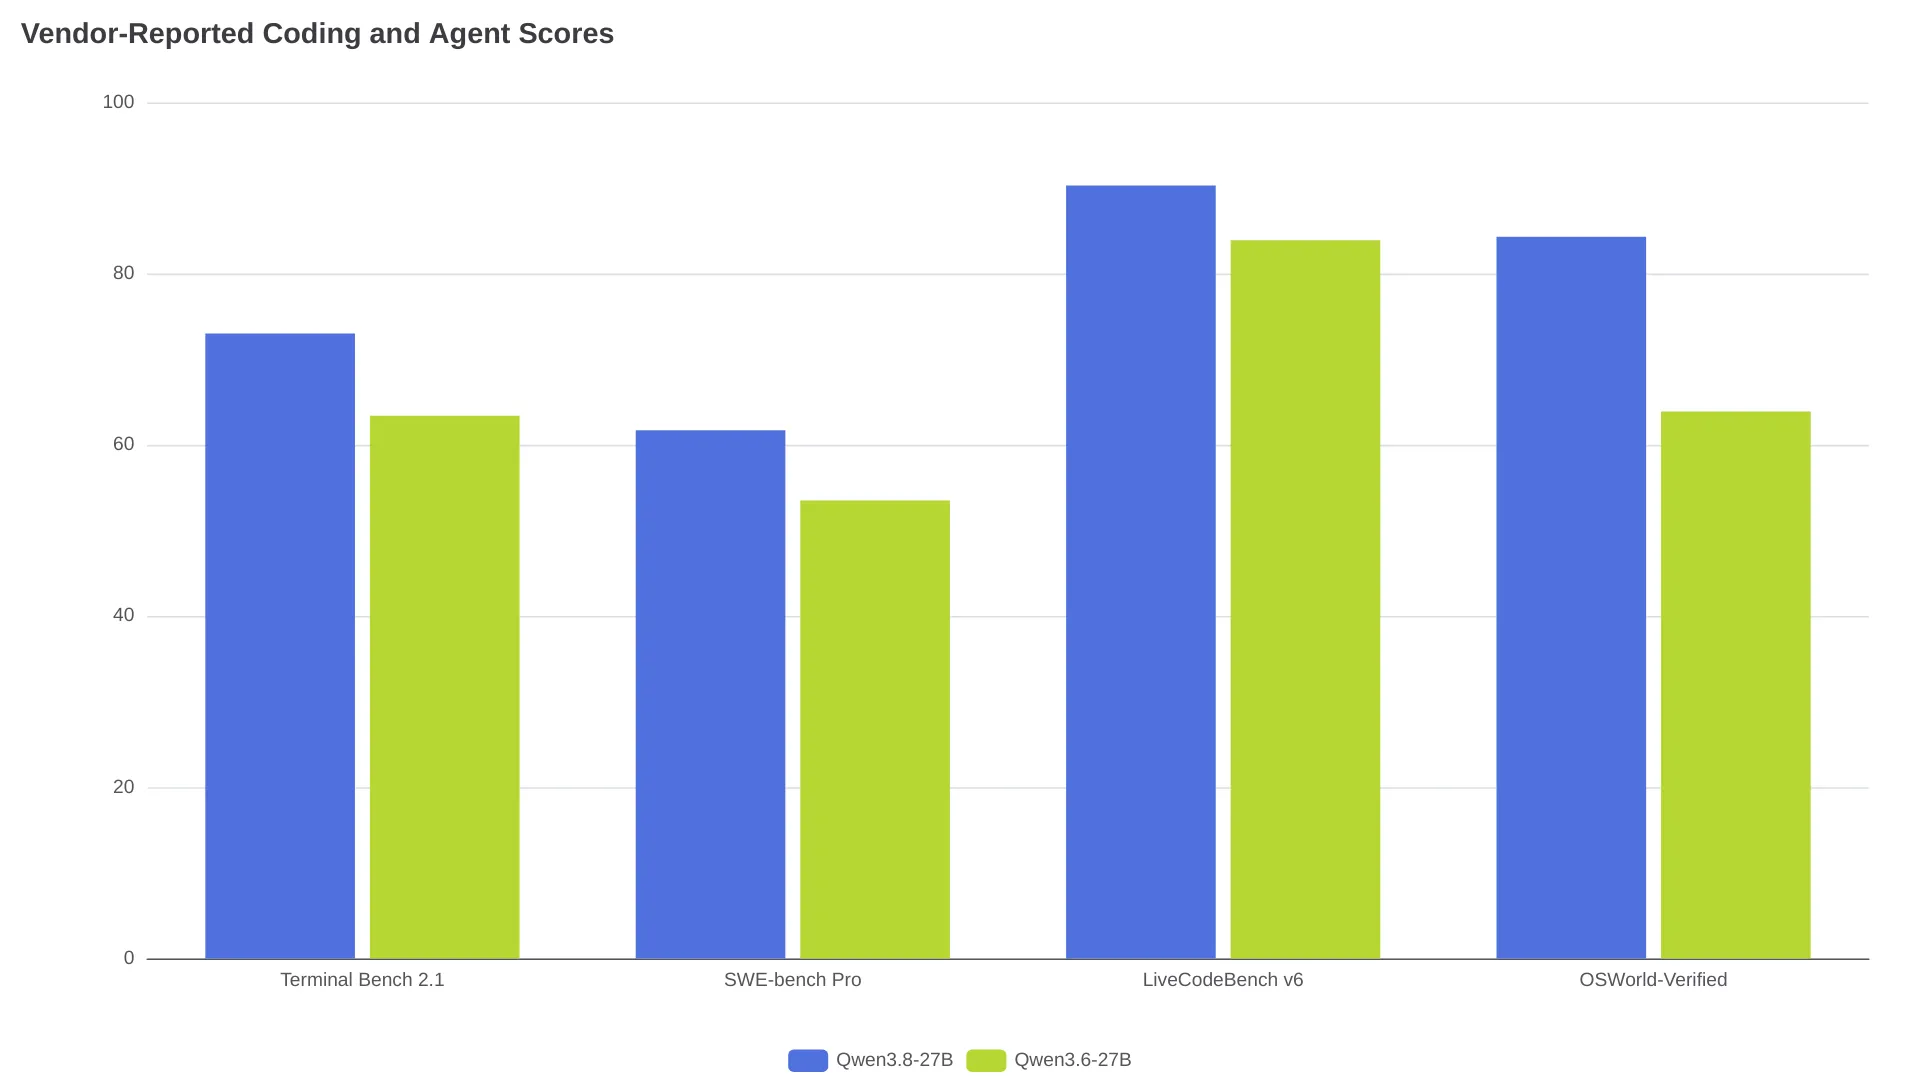
A Qwen reporta ganhos relevantes sobre o Qwen3.6-27B em avaliações de programação e uso de computador. O gráfico mostra quatro resultados reportados pelo fornecedor no cartão oficial do modelo, não resultados reproduzidos de forma independente.
| Benchmark oficial | Qwen3.8-27B | Qwen3.6-27B | Como interpretar |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Sinal de capacidade para programação em terminal com agentes |
| SWE-bench Pro | 61.7 | 53.5 | Sinal de resolução de issues em repositórios |
| LiveCodeBench v6 | 90.3 | 83.9 | Sinal de avaliação de programação |
| OSWorld-Verified | 84.3 | 63.9 | Sinal de uso de computador |
O cartão do modelo publica a comparação completa e a metodologia. Para SWE-bench Pro e DeepSWE 1.1, a Qwen afirma ter usado um harness do Claude Code com temperature=1.0, top_p=0.95 e contexto de 256K; também inclui benchmarks internos, como QwenSWEBench. Revise a metodologia antes de comparar modelos. Esses números sustentam a conclusão de que há “uma evolução oficial substancial em relação ao Qwen3.6-27B”, não que ele seja “um substituto universal comprovado para uma API de fronteira”.
Uma primeira configuração local que faz sentido
Uma primeira implantação local deve priorizar comportamento previsível, não o máximo de raciocínio. Use um runner atual, comece com uma quantização classe Q4 em hardware da faixa de 24GB, defina um limite de contexto deliberadamente moderado e execute tarefas curtas de agente antes de liberar loops autônomos longos.
- Inicie um servidor compatível com OpenAI em um mecanismo com suporte, como vLLM ou SGLang. A Qwen publica exemplos com
Qwen/Qwen3.8-27B,--reasoning-parser qwen3e--tool-call-parser qwen3_coder. Os comandos oficiais estão no repositório. - Para classificação, extração ou edições rápidas de código, defina
enable_thinking=False. A Qwen recomenda, sem raciocínio, os valorestemperature=0.7,top_p=0.80epresence_penalty=1.5. Veja o exemplo oficial de API. - Para depuração que exige mais raciocínio, experimente
lowoumediumantes dexhighe compare o tempo total de conclusão e a qualidade das chamadas de ferramenta em uma tarefa real. - Desative o raciocínio preservado quando cada tarefa for independente. Preserve-o apenas quando o contexto de raciocínio em múltiplos turnos justificar a pressão adicional sobre o cache KV.
- Teste chamadas de ferramentas, conformidade com o esquema de saída e uma rolagem de contexto antes de usar o modelo sem supervisão. Um modelo que escreve bom código em um prompt ainda pode falhar em um loop de agente de longa duração.
Quando o Qwen3.8-27B não é a escolha local certa
O Qwen3.8-27B não é a primeira escolha ideal quando 12GB ou menos são um limite rígido, quando a latência de resposta importa mais do que o controle local ou quando um agente precisa executar sem supervisão e obedecer estritamente ao formato exigido. Ele pode rodar em configurações limitadas, mas isso não equivale a entregar throughput interativo confiável ou contexto suficiente para trabalho em repositórios.
Testes independentes também identificam tendência a respostas longas, latência elevada na cauda e adesão imperfeita a instruções estritas. Uma avaliação estruturada registrou 4 timeouts em 49 testes e tempo de resposta P95 de 143,32 segundos em sua configuração de workstation. Esses números não são garantias portáveis de desempenho, mas servem como alerta útil contra tratar um modelo local de 27B como componente de automação sem revisão. O relatório de testes da CrucibleMark detalha a configuração e as limitações.
Perguntas frequentes sobre o Qwen3.8-27B
O Qwen3.8-27B foi lançado oficialmente?
Sim. O repositório oficial da Qwen informa que o lançamento do Qwen3.8-27B no Hugging Face Hub e no ModelScope ocorreu em 14 de agosto de 2026. A linha do tempo de lançamentos da Qwen é a fonte primária.
O Qwen3.8-27B roda em uma GPU de 16GB?
Uma configuração com quantização pesada e contexto curto pode rodar, mas será uma implantação limitada. Relatos de usuários vão de resultados promissores com Q3 em uma RTX 4060 Ti de 16GB a alertas de que o uso de agentes densos com pouca VRAM envolve grandes compromissos de velocidade e qualidade. Discussão no LocalLLaMA.
O Qwen3.8-27B tem janela de contexto de 1M de tokens?
Ele tem 262.144 tokens de contexto nativo. O cartão do modelo descreve contexto de 1M por meio de escalonamento YaRN/RoPE e alerta que YaRN estático pode reduzir o desempenho em textos curtos. Documentação oficial sobre contexto.
Como desativo o raciocínio do Qwen3.8-27B?
Defina enable_thinking=False na requisição da API, como mostrado no cartão do modelo da Qwen. Para tarefas que exigem raciocínio, comece com low ou medium, em vez de presumir que xhigh seja apropriado. Exemplo oficial sem raciocínio.
Quem usa Qwen3.6-27B deve atualizar?
Atualize se o hardware atual já comporta a mesma classe de implantação e se a carga de trabalho se beneficia das melhorias em programação, uso de computador ou multimodalidade. Mantenha o Qwen3.6-27B se a stack atual estiver estável e o novo runner, a quantização ou o comportamento de raciocínio ainda não tiverem sido validados no fluxo de trabalho real.
Escolha pelo limite que você não consegue mudar
| Restrição | Melhor próximo passo |
|---|---|
| Tratamento local de dados e 24GB disponíveis | Rode o Qwen3.8-27B em Q4 e comece com pouco ou nenhum raciocínio |
| Apenas 12GB a 16GB | Teste uma build no estilo Q3 para tarefas curtas supervisionadas ou escolha um modelo menor |
| Sessões longas de agentes em repositórios | Reserve margem de 32GB+ e valide o comportamento do cache KV antes de adotar |
| Respostas interativas rápidas | Use uma API hospedada ou um modelo local menor |
| Formatação ou publicação estrita sem supervisão | Mantenha uma camada de validação e revisão humana; não dependa apenas da conformidade do modelo |
O Qwen3.8-27B amplia o que um modelo local implantável de 27B consegue tentar fazer. Ele não elimina o trabalho de sistemas: escolha a quantização de acordo com o hardware, controle o raciocínio de forma deliberada e avalie o modelo em um fluxo de trabalho representativo, não pelo tamanho do download.