 AIREITER
Um job com vários nós no Modal é cobrado pela alocação completa, não por uma assinatura separada de cluster. O Modal Clusters está geralmente disponível, mas a conta continua sendo formada pelo uso de GPUs, CPU, memória, armazenamento e rede de cada contêiner.
Preços do Modal Clusters em um minuto
A página oficial de preços do Modal e o anúncio de disponibilidade geral descrevem a cobrança por uso e o ponto de entrada @modal.clustered para iniciar vários contêineres juntos. O RDMA é opcional e muda o caminho de comunicação, mas não a fórmula básica de preços.
quantidade de GPUs × segundos de GPU × tarifa da GPU + segundos de CPU + GiB-segundos de memória + armazenamento + egress aplicável
Essa fórmula é importante porque um cluster multiplica a alocação completa de cada nó. Um job que solicita quatro nós com oito GPUs H100 por nó é cobrado por 32 H100, não por um coordenador mais workers “gratuitos”.
O que o Modal Clusters acrescenta à tabela de preços
O lançamento de disponibilidade geral do Modal, em 1º de outubro de 2026, transforma a execução em vários nós em um recurso gerenciado. O parâmetro size define o número de contêineres, enquanto rdma=True ativa o caminho de comunicação de alta velocidade quando houver suporte (anúncio do Modal).
A documentação descreve o agendamento em grupo: o Modal tenta colocar o conjunto solicitado em execução ao mesmo tempo, em vez de iniciar um job parcial que não consegue avançar. Entre os workloads compatíveis estão treinamento distribuído, fine-tuning, inferência com paralelismo de modelo e arquiteturas de prefill/decode que dependem de comunicação sincronizada entre GPUs.
A documentação de clusters também estabelece limites práticos: a alocação de GPUs é feita por nó completo, clusters somente de CPU não são compatíveis e um contêiner que falhe ou seja preemptado pode fazer a chamada agrupada inteira falhar. Apenas a saída do rank 0 é retornada, portanto jobs longos precisam salvar checkpoints fora do contêiner.
As tarifas de GPU por trás da conta do Modal Clusters
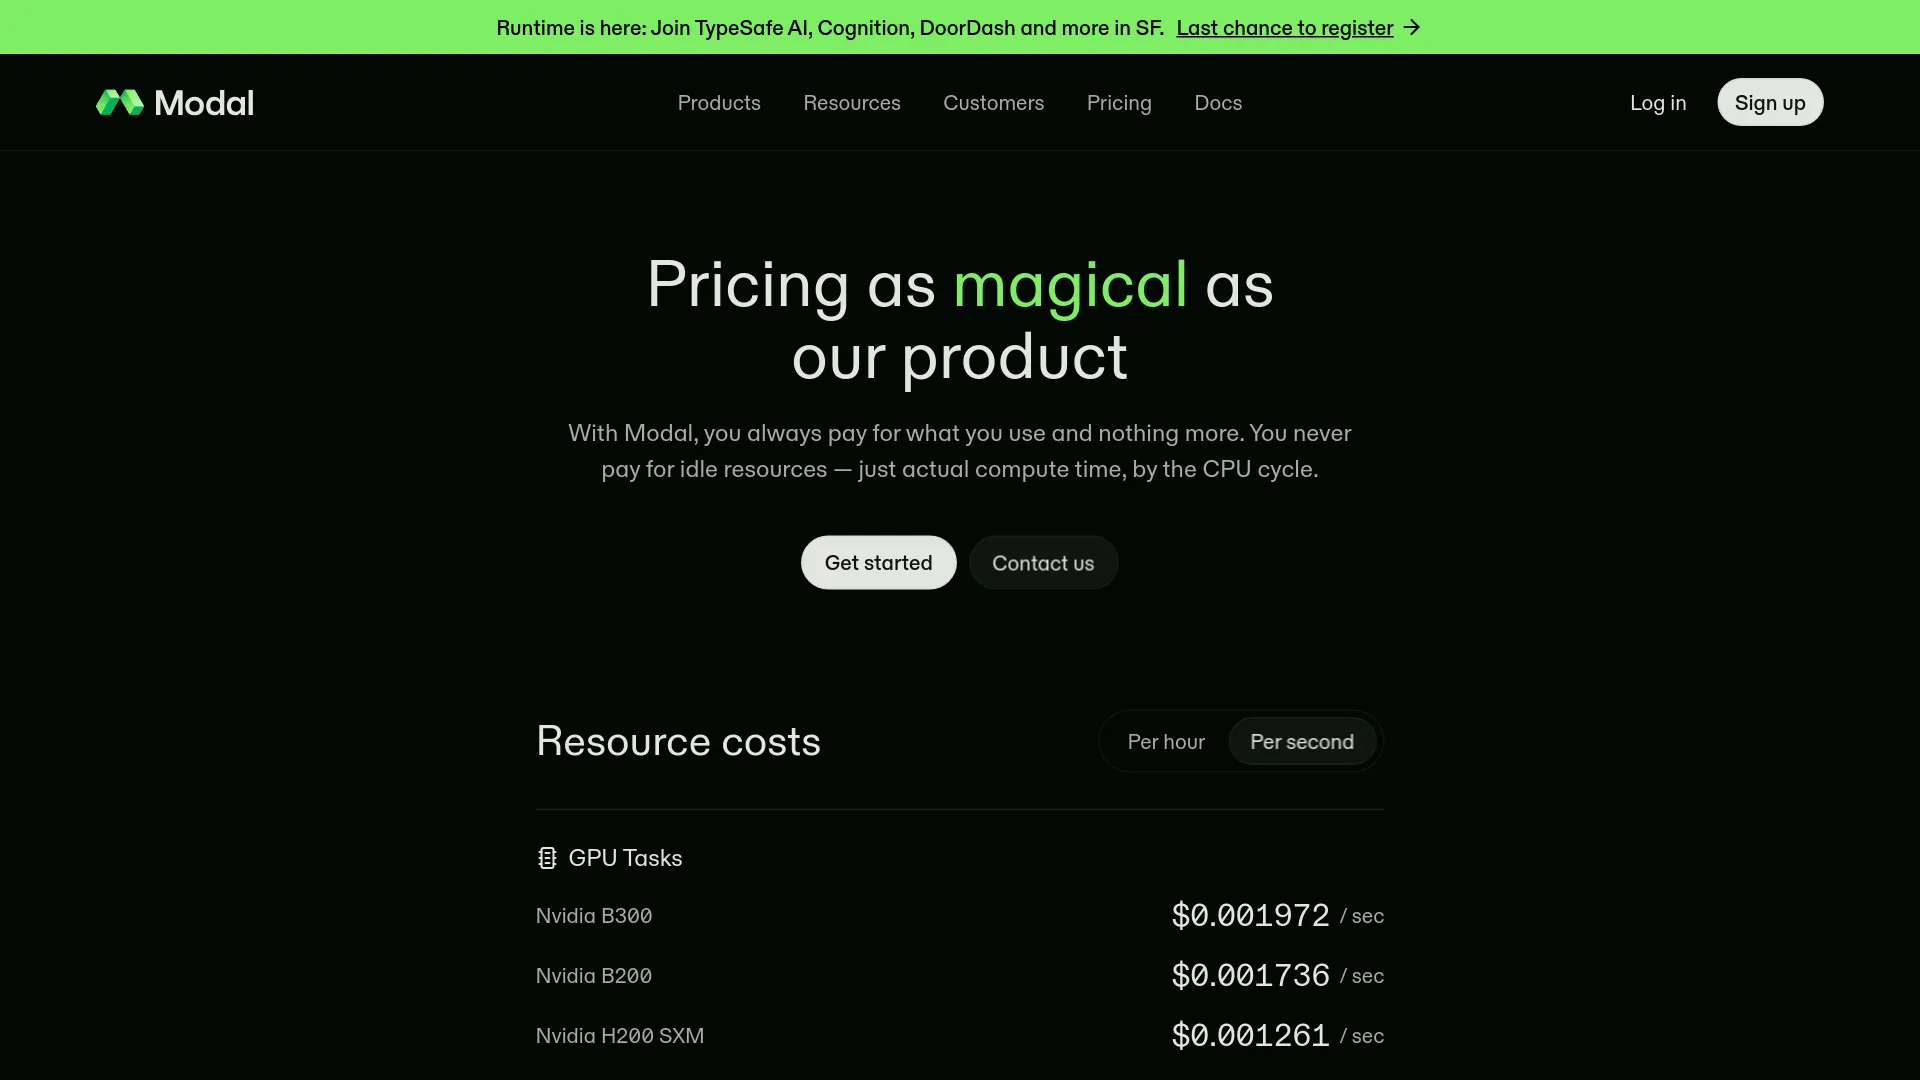
As tarifas públicas abaixo são um bom ponto de partida para uma estimativa. Os valores por hora foram calculados a partir dos preços por segundo e não incluem CPU, memória, armazenamento nem possíveis multiplicadores regionais.
| GPU | Por segundo | Aprox. por GPU-hora |
|---|---|---|
| B300 | $0.001972 | $7.10 |
| B200 | $0.001736 | $6.25 |
| H200 SXM | $0.001261 | $4.54 |
| H100 SXM5 | $0.001097 | $3.95 |
| A100 80 GB | $0.000694 | $2.50 |
| L4 | $0.000222 | $0.80 |
O Modal também lista CPU a $0.0000131 por segundo de núcleo físico e memória a $0.00000222 por GiB-segundo. Os volumes custam $0.09 por GiB por mês, com o primeiro 1 TiB gratuito. O egress de rede aparece listado a $0.04 por GiB além da franquia incluída. Antes de iniciar um job grande, confirme os valores atuais na tabela oficial de tarifas.
Exemplo prático: quatro nós com oito H100
Imagine um job de treinamento distribuído que solicita size=4 e H100:8 em cada nó.
- Quatro nós × oito GPUs = 32 GPUs H100.
- 32 × $3.95 por hora = cerca de $126.40 por hora apenas em GPUs.
- Considere $126.40 como o piso do custo de GPU; CPU, memória, armazenamento e egress são cobrados à parte.
É esse valor que deve ser comparado com capacidade reservada ou dedicada. A vantagem serverless é que o cluster pode reduzir a escala depois do pico; isso não torna barato um cluster totalmente ocupado.
Os limites do plano podem pesar mais que a tabela de preços
Uma funcionalidade em disponibilidade geral não significa capacidade ilimitada. Os planos de workspace publicados pelo Modal incluem limites de concorrência e restrições da plataforma que podem impedir um cluster grande antes mesmo de o preço virar o problema principal.
| Plano | Taxa da plataforma | Crédito de computação incluído | Concorrência de GPU publicada |
|---|---|---|---|
| Starter | $0/month | $30/month | 10 GPUs |
| Team | $250/month | $100/month | 50 GPUs |
| Enterprise | Custom | Custom | Custom / higher limits |
Um experimento com 32 H100 já consome 32 GPUs, portanto o plano Starter não comporta o exemplo acima dentro do limite de concorrência de 10 GPUs. No papel, o Team comporta essa quantidade, mas a disponibilidade real, a escolha da região e o hardware solicitado continuam afetando o agendamento.
Não confunda o crédito de $30 do Starter com 30 GPU-horas gratuitas. Pela tarifa indicada para H100, ele representa aproximadamente 7,6 GPU-horas de H100, antes de contabilizar os demais recursos do job.
Quando o Modal Clusters faz sentido financeiramente
O Modal Clusters se destaca quando o job é grande, intermitente e trabalhoso demais para manter provisionado. Um pico de treinamento que roda por algumas horas e depois é encerrado aproveita melhor a capacidade de reduzir a escala a zero do que um cluster que permanece ligado continuamente por semanas.
Ele é uma boa escolha para:
- Fine-tuning distribuído em que todos os nós precisam iniciar juntos.
- Picos curtos de treinamento com capacidade de GPU cara.
- Inferência em vários nós que exige RDMA ou paralelismo de modelo.
- Equipes Python que, de outra forma, teriam de operar Kubernetes, SLURM ou configurar RDMA manualmente.
Uma função comum do Modal em um único nó é mais adequada quando o modelo cabe em uma máquina. Infraestrutura dedicada ou reservada merece uma comparação séria quando a utilização é previsível, o workload precisa de um SLA fixo ou o principal objetivo é obter o menor custo sustentado por GPU-hora.
Uma discussão com usuários reais também ajuda a delimitar o cenário. Em uma thread sobre visão computacional, u/Substantial_Camel735 recomendou manter a busca vetorial em um VPS, em vez de executar essa parte nos workers do Modal (discussão no Reddit). Encare isso como a preferência de arquitetura de um profissional, não como um benchmark de toda a plataforma.
“Estamos prestes a deixar o modal, mas esse design parece certo; eu não usaria os workers do modal para fazer a busca. Apenas faria isso no seu VPS, consultando o seu banco vetorial.” — u/Substantial_Camel735, r/computervision
O que verificar antes de iniciar um job grande
- Multiplique a alocação completa. Verifique
size × GPUs por nóe compare o total com a concorrência do workspace. - Comece pelo menor cluster que faça sentido. Um teste com dois nós pode revelar problemas de imagem, NCCL, ranks e rendezvous antes que um lançamento com 32 GPUs multiplique a conta.
- Separe RDMA da depuração da aplicação. Valide o job distribuído sem RDMA, se o workload permitir, depois habilite
rdma=Truee meça o caminho sensível à comunicação. - Salve checkpoints em armazenamento durável. Um rank que falhe ou seja preemptado pode fazer a chamada inteira falhar; uma nova tentativa sem checkpoint pode repetir todo o job caro.
- Reserve orçamento para CPU, memória e egress. A conta da GPU é apenas a primeira linha da fatura, especialmente quando datasets ou resultados atravessam regiões.
- Decida se é necessário fixar a região. Restringir o posicionamento pode alterar o pool disponível para agendamento e o multiplicador de preço; trate a localidade como uma exigência que precisa ser medida e confirme-a na documentação atual de preços regionais.
O RDMA, por si só, não aparece como uma cobrança separada nos preços oficiais do Modal. O ganho está no desempenho: treinamento sincronizado e grandes transferências de KV cache podem ficar limitados pela rede quando usam TCP comum. O custo dessa escolha é que o hardware compatível com RDMA e as opções de posicionamento podem reduzir a disponibilidade.
FAQ sobre o Modal Clusters
Existe uma taxa separada pela API do Modal Clusters?
Não há uma sobretaxa separada de cluster publicada. O Modal cobra os recursos usados por cada contêiner: GPUs, CPU, memória, armazenamento e uso de rede aplicável.
Qual é o tamanho máximo de um cluster?
Os materiais de disponibilidade geral descrevem clusters públicos de até 32 nós ou 256 GPUs; necessidades maiores são tratadas diretamente com o Modal (anúncio de disponibilidade geral). Os limites de concorrência do workspace e a capacidade disponível continuam valendo.
O Modal Clusters pode executar inferência?
Sim, mas o workload precisa se encaixar no modelo de execução agrupada. Inferência em vários nós ou com paralelismo de modelo é um caso de uso mais forte do que um endpoint HTTP comum; funções web agrupadas têm limitações, incluindo a entrega do tráfego ao rank 0 (documentação de clusters).
A decisão na prática
| Seu workload | Melhor ponto de partida |
|---|---|
| O modelo cabe em uma GPU ou nó | Função comum do Modal |
| Pico curto de treinamento sincronizado em vários nós | Modal Clusters, depois de um teste pequeno |
| Utilização total, previsível e contínua | Compare capacidade de GPU dedicada ou reservada |
| Busca ou banco de dados junto da inferência em GPU | Mantenha o serviço de dados separado, a menos que as medições justifiquem a co-localização |
| Exigência rígida de rede privada ou self-hosting | Avalie outro modelo de implantação |
O Modal Clusters facilita começar a orquestrar GPUs em vários nós, mas não é automaticamente mais barato. O posicionamento serverless e a ergonomia do Python podem economizar tempo de engenharia, enquanto a utilização contínua, as restrições regionais e as novas tentativas do cluster inteiro podem dominar a conta. Primeiro calcule a quantidade total de nós; só depois compare o prêmio pela conveniência com a capacidade dedicada.