 AIREITER
Um usuário do Claude Code calculou quanto teria pago em tarifas de API por um mês de uso do plano Max e chegou a US$ 7.470, contra uma assinatura de US$ 200. O problema não está na tabela de preços por token. O acesso medido elimina o teto que a assinatura impunha discretamente, enquanto os agentes reenviam muito mais tokens do que uma pessoa digitando em uma janela de chat.
A diferença que os desenvolvedores estão encontrando
Os números publicados pelos usuários são altos — e relativamente consistentes. Uma discussão no r/ClaudeAI que reconstrói os logs de sessões do Claude Code calculou um mês de uso do Max em aproximadamente US$ 7.470 na tabela da API, contra uma assinatura de US$ 200. Em uma discussão menor sobre assinatura versus API, um assinante do plano de US$ 200 estimou o mesmo workload em US$ 5.000–US$ 20.000 por mês.
São estimativas não auditadas de usuários, mas o padrão que mais pesa nos tokens é o mesmo nos dois casos: um agente percorrendo um repositório.
"Estou no plano corporativo da API da minha empresa usando o Claude Code e posso dizer, por experiência própria, que é muito fácil gastar US$ 100–US$ 200 por sessão em custos de API programando normalmente em projetos maiores." — u/andywidjaja, r/ClaudeAI
Plano pago e chave de API são produtos diferentes
A Anthropic deixa essa separação explícita. Seu artigo da central de ajuda, atualizado em 16 de março de 2026, descreve os planos Claude e o Claude Console como “produtos separados, criados para finalidades diferentes” e afirma que uma assinatura paga “não inclui acesso à API ou ao Console do Claude”. A OpenAI segue a mesma lógica, cobrando o ChatGPT e a plataforma de API por sistemas separados.
A melhor forma de entender a diferença é observar o que cada produto vende:
| Plano de chat pago | Chave de API | |
|---|---|---|
| Unidade vendida | Uma licença humana | Volume de tokens processados |
| Limite | Janela móvel de 5 horas mais limites semanais | Sem franquia incluída; ainda existem limites de taxa e de gastos |
| Acesso | Aplicativos web, desktop e mobile | Seu próprio código |
| Formato do preço | Fixo por mês | Variável, por token |
| Para alimentar seu próprio produto | Não é para isso que é vendido | Esse é justamente o objetivo |
A página de preços do Claude lista o Pro por US$ 20/mês no pagamento mensal ou US$ 17/mês no plano anual (US$ 200 pagos antecipadamente), e o Max a partir de US$ 100/mês, com 5× ou 20× o uso do Pro por sessão de cinco horas. A Anthropic não publica uma quantidade de mensagens para esses níveis porque o consumo varia conforme o tamanho da conversa, o modelo e os recursos usados. Na prática, a comparação coloca uma quantidade medida lado a lado com outra que não é medida.
A mesma página traz outro detalhe importante: o Claude Enterprise combina uma taxa mensal de US$ 20 por assento com o uso cobrado pelas tarifas da API. Ou seja, os clientes mais pesados acabam voltando para o medidor.
Quantos tokens uma assinatura compra na tarifa oficial
Converter o valor do plano em tokens torna a diferença concreta. Estes são os preços oficiais por milhão de tokens (MTok), retirados da documentação de preços da plataforma Claude e da página de preços da API da OpenAI, conferidos em 1º de outubro de 2026.
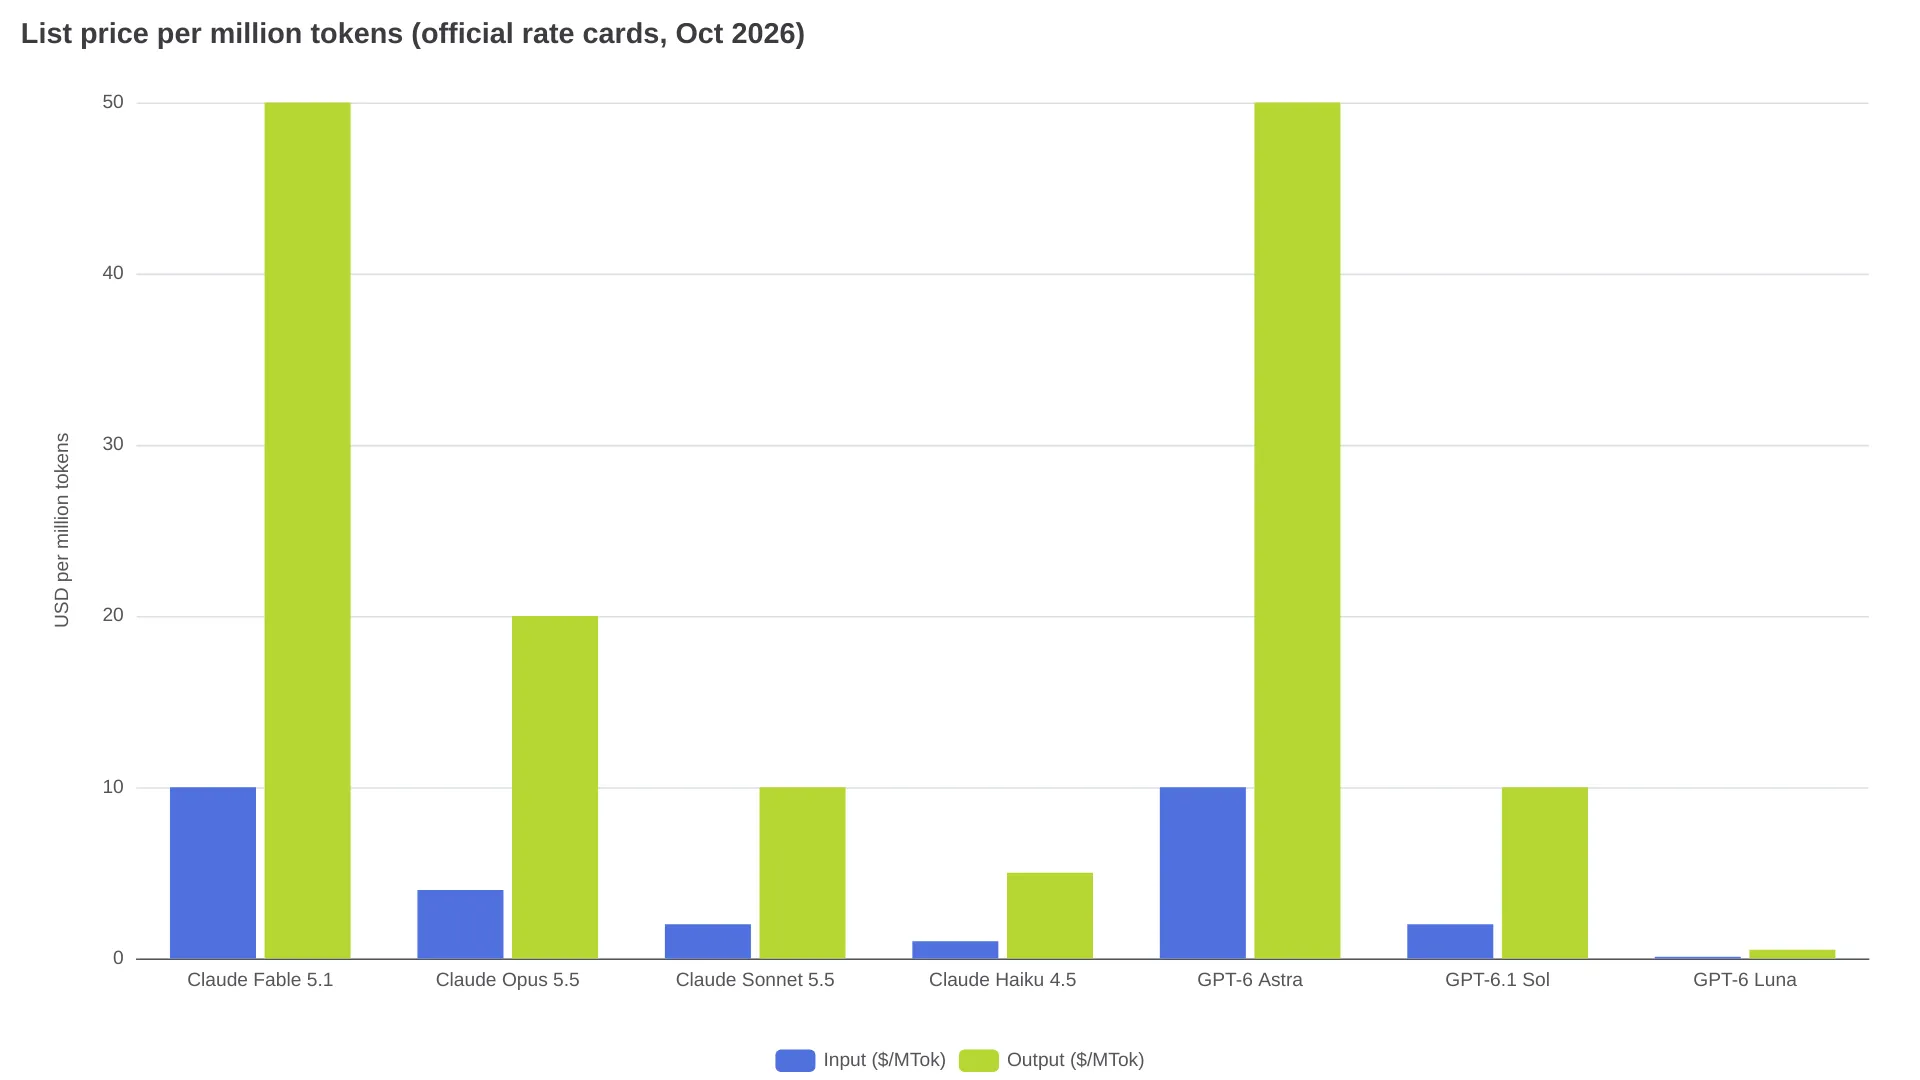
| Modelo | Entrada | Saída | Leitura do cache | Lote (entrada/saída) |
|---|---|---|---|---|
| Claude Fable 5.1 | US$ 10 | US$ 50 | US$ 0,25 | US$ 5 / US$ 25 |
| Claude Opus 5.5 | US$ 4 | US$ 20 | US$ 0,20 | US$ 2 / US$ 10 |
| Claude Sonnet 5.5 | US$ 2 | US$ 10 | US$ 0,20 | US$ 1 / US$ 5 |
| Claude Haiku 4.5 | US$ 1 | US$ 5 | US$ 0,10 | US$ 0,50 / US$ 2,50 |
| GPT-6 Astra | US$ 10 | US$ 50 | US$ 1,00 | US$ 5 / US$ 25 |
| GPT-6.1 Sol | US$ 2 | US$ 10 | US$ 0,10 | US$ 1 / US$ 5 |
| GPT-6 Luna | US$ 0,10 | US$ 0,50 | US$ 0,01 | US$ 0,05 / US$ 0,25 |
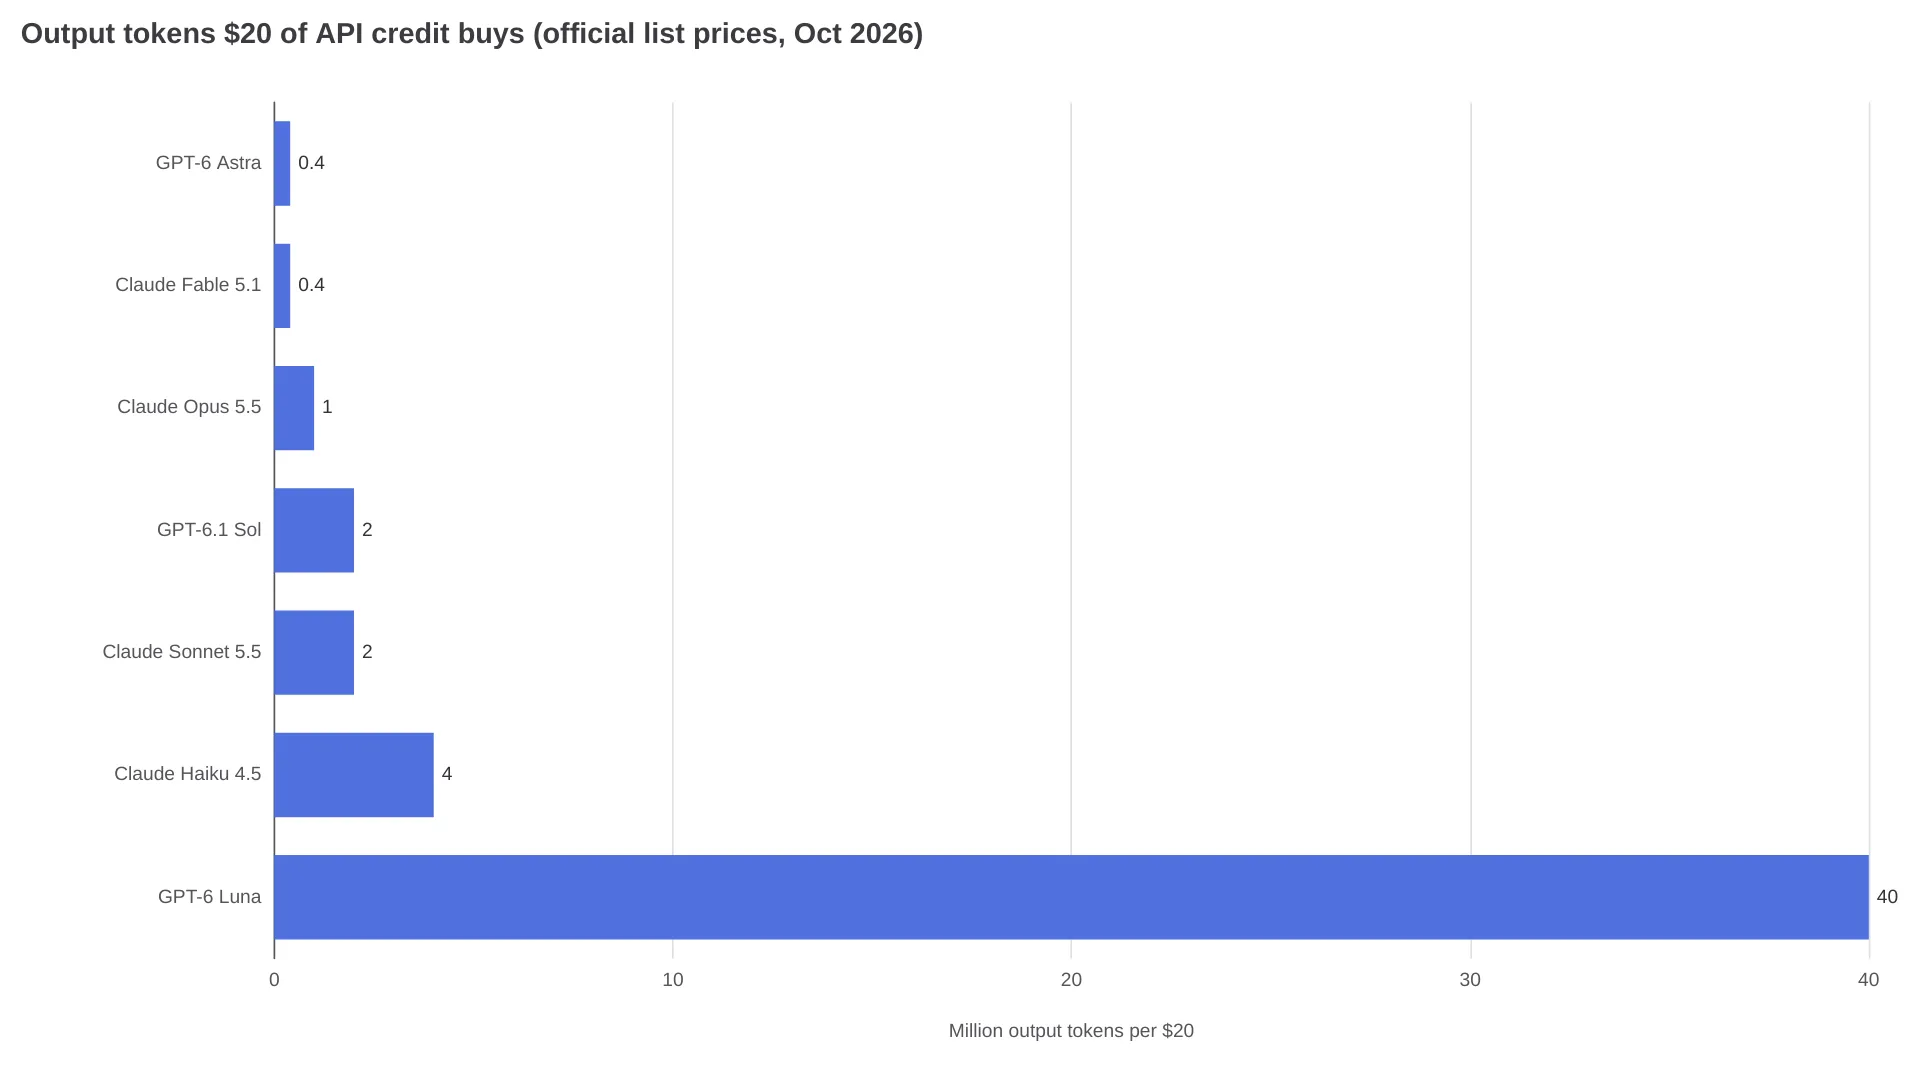
Em um workload parecido com chat, com alguns milhares de palavras de contexto e algumas centenas de palavras na resposta, US$ 20 em créditos do Sonnet 5.5 cobrem aproximadamente 10 milhões de tokens de entrada ou 2 milhões de tokens de saída. O seu cálculo vem dos quatro campos da resposta da API: (entrada nova × tarifa de entrada) + (entrada em cache × tarifa de leitura do cache) + (gravações no cache × tarifa de gravação) + (saída × tarifa de saída), com multiplicadores adicionais para processamento em lote, contexto longo e região. Registre esses quatro valores por endpoint durante uma semana e você terá uma estimativa mensal para comparar com o preço de uma licença.
Para onde os tokens realmente vão
Quatro fontes comuns de gastos inesperados com tokens ficam escondidas além da tabela de preços. As três últimas estão documentadas na análise da LLM Cost Lab sobre custos fora da tabela.
- O histórico, reenviado a cada turno. Em integrações de chat baseadas em requisições, o cliente reenvia o histórico. Assim, o turno 20 leva consigo os turnos 1 a 19. Quando cada turno acrescenta uma quantidade parecida de contexto, o volume de entrada cresce aproximadamente com o quadrado do tamanho da conversa. É por isso que a análise calcula uma sessão de 20 turnos em US$ 0,163, contra US$ 0,063 no cenário em que as chamadas fossem independentes — uma diferença de 2,6×.
- O prompt de sistema, multiplicado em cada chamada. Um prompt de sistema com 2.000 tokens em 1 milhão de requisições representa 2 bilhões de tokens de entrada antes mesmo de o usuário digitar qualquer coisa.
- Tokens de raciocínio que você não vê. Nos modelos que cobram os traços internos de raciocínio como saída, esses tokens podem ser várias vezes mais longos que a resposta visível. Medir o uso apenas pelos caracteres retornados, portanto, subestima a fatura.
- Resultados de ferramentas, tentativas repetidas e gerações descartadas. Se o modelo gerou o conteúdo, você paga por ele — inclusive pela resposta rejeitada pelo seu validador JSON e pela chamada paralela que foi vencida por outra e acabou descartada.
Tokens baratos ainda podem dominar uma conta, o que confunde quem olha apenas o painel de uso. Na discussão da conta de US$ 7.470, um comentarista observou que as leituras do cache representavam 48% do total, apesar de serem o tipo mais barato de token na tabela.
“esse já é o tipo de token mais barato da API. Então, se ele ainda domina mesmo depois da aplicação das tarifas oficiais, o workload real consiste principalmente em reler o contexto a cada turno” — u/YoanEdwin, r/ClaudeAI
Aplicando as tarifas do Opus 5.5 a um turno de agente com 150 mil tokens de contexto de repositório, a estrutura fica evidente:
| Opus 5.5, sessão de 60 turnos, contexto de 150 mil + saída de 2 mil tokens por turno | Custo |
|---|---|
| Entrada nova por turno, sem acerto de cache (150 mil @ US$ 4) | US$ 0,60 |
| Leitura do cache por turno em vez de entrada nova (150 mil @ US$ 0,20) | US$ 0,03 |
| Saída por turno (2 mil @ US$ 20) | US$ 0,04 |
| Uma gravação no cache de 1 hora por sessão (150 mil @ US$ 8) | US$ 1,20 |
| Total da sessão, sem cache | US$ 38,40 |
| Total da sessão, com cache | US$ 5,40 |
Duas sessões com cache por dia, durante 22 dias úteis, custam aproximadamente US$ 238 — já acima de um plano de US$ 200. Sem cache, o mesmo mês passa de US$ 1.600. A tarifa não mudou; o volume de tokens, sim.
Não são duas opções, mas três
A maioria das comparações para em plano versus API. Existe um terceiro nível, que aparece quando a franquia acaba: créditos de uso extra vendidos dentro do próprio produto de assinatura.
Relatos no r/codex colocam esse terceiro nível acima do preço bruto da API. Um usuário Pro acompanhou o consumo de aproximadamente 16 milhões de tokens por meio de créditos comprados, que custaram cerca de US$ 40. Depois, estimou que o mesmo volume sairia por aproximadamente US$ 12 nas tarifas oficiais da API.
“sim, o preço dos créditos chega perto de ser predatório. US$ 50 por uma única landing page é absurdo quando a API custaria algo como US$ 2” — u/AbjectBug5885, r/codex
São estimativas de usuários, não tarifas universais, e os preços de recarga variam conforme o fornecedor e o plano. Nos casos do Codex acima, a recarga custou aproximadamente 3× o gasto equivalente na tabela da API — uma diferença que vale comparar com seus próprios números antes de comprar créditos pela segunda semana seguida.
Cinco alavancas que reduzem a conta
Cada alavanca tem uma tarifa oficial, então a conta pode ser conferida primeiro na página do fornecedor.
- Cache de prompts, incluindo o custo de gravação. A documentação de preços da Anthropic estabelece que uma gravação no cache de 5 minutos custa 1,25× a entrada básica, enquanto a gravação de 1 hora custa 2×. As leituras custam 0,1× da tarifa básica (0,05× no Opus 5.5 e 0,025× no Fable 5.1). Uma gravação de 5 minutos se paga depois de uma leitura; a de 1 hora, depois de duas. Se você gravar e nunca ler, pagará mais do que pagaria sem usar cache. A ordem do prompt também importa tanto quanto ativar o recurso: coloque o conteúdo estável primeiro e as variações do usuário por último, ou o prefixo deixará de coincidir. O diagnóstico da taxa de acerto está explicado neste guia de cache de prompts.
- Use processamento em lote sempre que puder esperar. Os dois fornecedores reduzem em 50% o preço de tabela para processamento assíncrono: o Opus 5.5 cai para US$ 2/US$ 10 e o Sonnet 5.5, para US$ 1/US$ 5. A cobertura é menos uniforme em outros modelos: a LLM Cost Lab identificou uma faixa de lote com desconto em 26 dos 83 modelos acompanhados. Confirme se o seu modelo está incluído antes de projetar a arquitetura em torno disso. O funcionamento está detalhado no nosso guia de preços da Batch API.
- Escolha o modelo de acordo com a tarefa. Classificação, roteamento e decisões de recuperação raramente precisam de um modelo de ponta. O Haiku 4.5, a US$ 1/US$ 5, contra o Fable 5.1, a US$ 10/US$ 50, representa uma diferença de 10× em etapas que geram dez tokens.
- Limite a saída, não apenas o
max_tokens. A saída custa 5× mais que a entrada em praticamente todas as linhas da tabela acima. Um schema que proíba introduções troca um pequeno custo estrutural pelo texto que seria cobrado de outra forma. Já omax_tokensfunciona melhor como teto de segurança do que como ferramenta de formatação, pois uma resposta truncada pode exigir uma segunda tentativa paga. - Fique de olho nos multiplicadores adicionais. A faixa de contexto longo da OpenAI dobra as tarifas de entrada do contexto curto, e o modo Fast dobra novamente o preço padrão. A Anthropic cobra 1,1× para inferência fixada nos EUA, e sua documentação de preços afirma que o Claude 4.7 e versões posteriores usam um tokenizador mais recente, que produz aproximadamente 30% mais tokens para o mesmo texto. Seu prompt não mudou; o medidor, sim.
Existe ainda uma opção estrutural fora dessa lista: encaminhar o tráfego programático por um único endpoint medido, em vez de manter uma relação de cobrança para cada fornecedor. É essa a finalidade do endpoint de API do Claude da AIReiter. Nas tarifas oficiais, um mês com 40 milhões de tokens de entrada e 8 milhões de saída em nível Sonnet custa US$ 80 + US$ 80 no uso excedente. Comparar esse valor com o preço de uma segunda licença leva cerca de um minuto.
Qual opção comprar
| Seu cenário | Compre | Por quê |
|---|---|---|
| Chat, pesquisa e código ocasional em um aplicativo | Apenas o plano pago | Gasto limitado, aplicativos incluídos e uso bem abaixo dos limites do plano |
| Programação solo com agentes, em uma máquina | Plano primeiro; chave com cobrança por uso para o excedente | O plano absorve a maior parte do uso; a chave elimina a espera pela renovação semanal |
| Lançamento de um produto usado por outras pessoas | Apenas a API | Uma licença atende uma pessoa; seus usuários precisam do próprio volume de processamento |
| Jobs periódicos em lote: avaliações, reprocessamentos e classificação | API com faixa de processamento em lote | 50% de desconto sobre a tabela, com latência irrelevante |
| Compra créditos extras na maioria das semanas | Calcule o excedente usando uma chave | Os preços relatados para créditos ficaram acima das tarifas da API |
Perguntas frequentes
Um plano pago do ChatGPT ou do Claude inclui créditos de API?
Não. A central de ajuda da Anthropic afirma claramente que um plano pago do Claude “não inclui acesso à API ou ao Console do Claude”, enquanto a OpenAI cobra o ChatGPT e a plataforma de API por sistemas separados. Pagar pelos dois significa ter duas cobranças.
Sou cobrado pelos tokens de raciocínio que não aparecem para mim?
Sim, nos modelos que oferecem pensamento ou raciocínio estendido. Esses tokens são cobrados pela tarifa de saída sem aparecer no corpo da resposta. Por isso, consulte o objeto usage.
Pago pela conversa inteira a cada turno?
Sim, a menos que um acerto de cache cubra o prefixo repetido. Na ausência de um recurso de estado mantido no servidor, o cliente reenvia o histórico que quer que o modelo veja. Esse histórico é cobrado como entrada nova pela tarifa do modelo ou pela tarifa de leitura do cache quando o prefixo coincide.
Uma requisição que falha ou é repetida ainda gera cobrança?
Segundo a análise de cobrança da LLM Cost Lab, uma requisição que chega ao modelo e retorna é cobrada mesmo quando o aplicativo descarta o resultado após uma falha de schema ou um timeout do cliente. A exceção são as requisições rejeitadas antes da geração.
O dilema que ninguém resolveu
Os planos limitam os gastos, mas racionam o acesso; as chaves com cobrança por uso fazem o inverso. Como os fornecedores não publicam um valor em tokens para as franquias dos planos, responder “o que é mais barato para mim” exige uma semana de tráfego instrumentado, calculado com base na tabela acima.
Leia também: API de LLM mais barata em 2026 · Guia de preços da API do Claude