 AIREITER
O dashboard do OpenRouter estreou com uma taxa de acerto de cache de 82,8% em toda a plataforma (@OpenRouter). Nos relatos da comunidade, porém, o cenário é bem menos animador: taxas abaixo de 1% (@miolini) e faturas 10–32x maiores do que o esperado (r/openrouter). O cache de prompts do OpenRouter realmente reduz o custo de entrada, mas isso só acontece depois de corrigir quatro falhas específicas. E a alavanca mais importante é manter requisições consecutivas no mesmo provedor já aquecido. Antes de tudo, há um limite inegociável: prompts abaixo do mínimo de tokens do provedor nunca entram em cache, independentemente da configuração.
O que o OpenRouter considera um acerto de cache
O cache de prompts reaproveita um prefixo estável que o provedor já processou. Assim, os tokens de entrada repetidos são cobrados com desconto, em vez do preço integral. Esse cache fica no endpoint específico do provedor que atendeu à primeira requisição, por isso o roteamento é tão relevante quanto a estrutura do prompt. Trata-se de uma camada diferente do cache de respostas, que devolve gratuitamente uma requisição completa idêntica antes mesmo de qualquer roteamento.
| Cache de prompts | Cache de respostas | |
|---|---|---|
| O que reaproveita | Prefixo estável de qualquer requisição | Requisição idêntica byte a byte (SHA-256 do corpo normalizado) |
| Como ativar | Em geral, automático; cache_control para Anthropic, Qwen e Gemini | Cabeçalho X-OpenRouter-Cache: true ou preset |
| Custo | Tokens em cache por 0,1–0,5x o custo de entrada | Acertos são gratuitos; falhas seguem a cobrança normal |
| Duração | Normalmente 3–5 min, até 1h (Anthropic) | Padrão de 300s, intervalo de 1–86.400s |
| É invalidado por | Mudança no prefixo, troca de provedor ou mínimo de tokens | Qualquer alteração no JSON, rotação de chave de API ou ZDR na conta |
O cache de respostas é particularmente útil para tentativas repetidas, testes unitários e chamadas idênticas em fluxos de agentes. A ordem das propriedades do JSON faz parte da chave de cache, portanto até uma alteração inofensiva na serialização resulta em falha. A referência principal sobre o funcionamento do cache no lado dos provedores é o guia de cache de prompts do OpenRouter:
Quanto custa o cache de prompts no OpenRouter, provedor por provedor
Em todos os provedores, a leitura de tokens em cache custa uma fração do preço normal de entrada. Já a gravação que cria o cache pode ter um adicional: na Anthropic, 1,25x o custo de entrada para o TTL padrão de 5 minutos e 2x para a opção de 1 hora. O cache só compensa quando o mesmo prefixo é relido vezes suficientes para amortizar essa gravação; em uma chamada isolada, usar cache pode custar mais do que não usar. No Claude Sonnet 4.6, a entrada em cache custa US$ 0,30/M, contra US$ 3,00/M para entrada nova, segundo os cálculos do próprio OpenRouter.
Os multiplicadores de gravação e leitura por provedor, conforme a mesma fonte:
| Provedor | Gravação no cache | Leitura do cache | Observações |
|---|---|---|---|
| Anthropic | 1,25x (5 min) / 2x (1h) | 0,1x | TTL selecionável por breakpoint |
| OpenAI, antes do GPT-5.6 | Gratuita | 0,25–0,5x | Automático a partir de 1.024 tokens |
| OpenAI GPT-5.6+ | 1,25x | 0,25–0,5x | Agora há suporte a breakpoints explícitos |
| Google Gemini | Gratuita | 0,25x | Implícito no 2.5+, TTL de ~3–5 min |
| Grok | Gratuita | 0,25x | Automático |
| Moonshot | Gratuita | 0,25x | Automático |
| Groq | Gratuita | 0,5x | Apenas modelos Kimi K2 |
| DeepSeek | 1,0x | 0,1x | Gravações cobradas como entrada normal |
| Alibaba Qwen | 1,25x | 0,1x | cache_control explícito obrigatório |
| Z.AI | Gratuita | ~0,2x | Armazenamento em cache listado como gratuito por tempo limitado |
O tutorial do OpenRouter simula 10.000 tokens repetidos ao longo de seis turnos: 6,0x o custo de um turno único sem cache, 1,75x com o cache de 5 minutos da Anthropic e roteamento sticky, e 2,25x em um provedor com gravação gratuita e leituras a 0,25x. O modelo não considera mensagens que crescem nem tokens de saída.
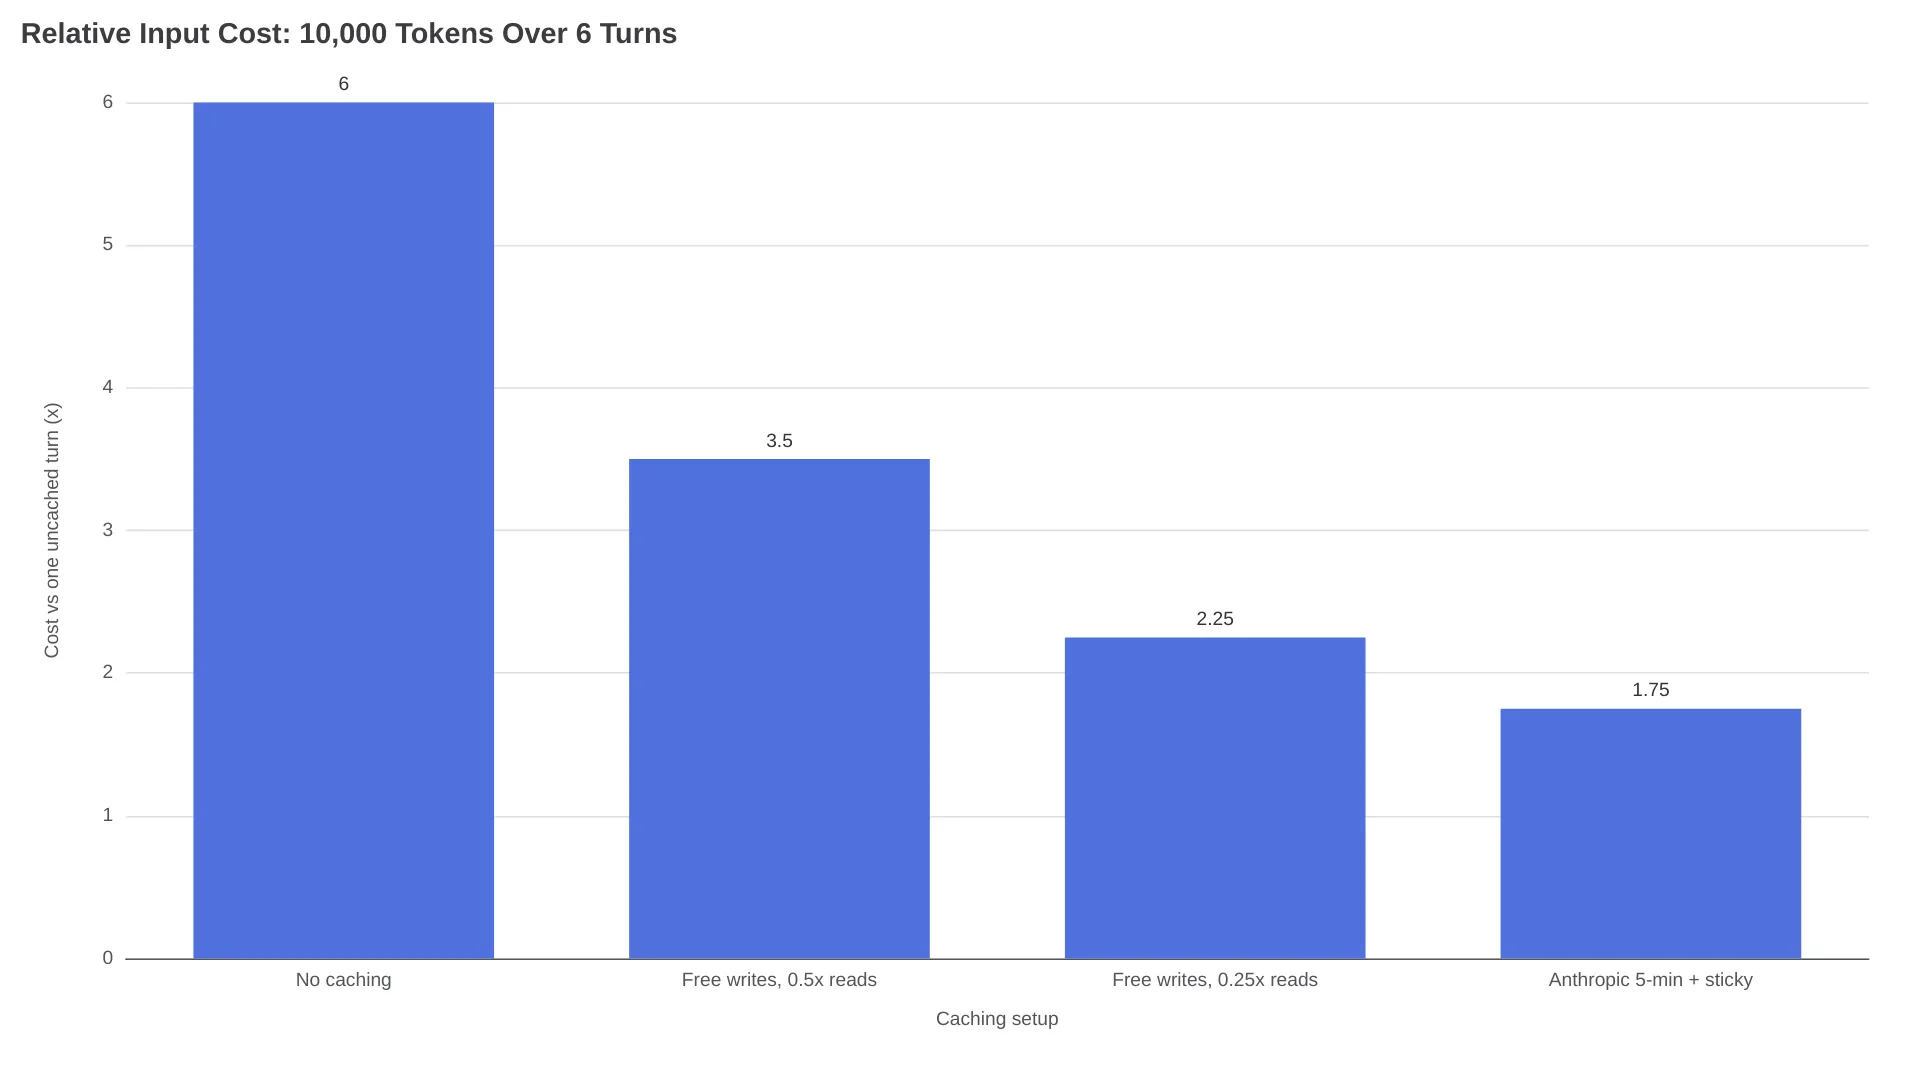
A gravação cara da Anthropic vence em seis turnos porque suas leituras a 0,1x passam a dominar a partir do segundo turno, e a diferença aumenta a cada nova interação. O cenário só se inverte quando o TTL de 5 minutos expira entre os turnos: você paga novamente a gravação de 1,25x em toda requisição — 7,5x em seis turnos, pior do que não usar cache. Já um provedor com gravação gratuita e entrada a 1,0x apenas empata com os 6,0x sem cache.
Meça antes de depurar: três números que confirmam um acerto
Toda resposta do OpenRouter traz o veredito no objeto usage: cached_tokens, cache_write_tokens e cache_discount. A semântica desses campos está documentada no guia de cache do OpenRouter. Consultar os três antes de alterar qualquer coisa separa uma falha real de cache de uma surpresa na precificação. Se cached_tokens for maior que zero, a requisição acertou um cache aquecido; se for zero, não acertou, independentemente do que o dashboard Activity sugira.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Essa resposta tem um acerto de 99,8%: 10.318 dos 10.339 tokens de prompt vieram do cache. cache_write_tokens aparece na primeira requisição que produz o cache; cache_discount informa o valor economizado e pode ser negativo nas gravações da Anthropic, pois o adicional de 1,25x é um custo real que as leituras posteriores precisam compensar. Você encontra os mesmos números na visualização detalhada da geração no Activity — nosso guia do dashboard Activity mostra onde — ou em /api/v1/generation.
Os metadados brutos são a fonte da verdade, não a interface. Um usuário do SillyTavern perseguiu um problema de cache inexistente até consultar os logs diretamente:
"Os metadados brutos do OpenRouter dizem claramente
native_tokens_cached: 0[e]usage_cache: null." — u/HauntingWeakness
Se os seus três números continuam em zero dia após dia, uma das quatro falhas abaixo está consumindo o cache.
Quatro motivos para um cache aquecido esfriar
A documentação do OpenRouter e os relatos da comunidade apontam para quatro causas recorrentes de taxas de acerto em colapso: prompts abaixo do mínimo, expiração do TTL entre turnos, alteração no prefixo e desvio de provedor. Cada uma deixa um sinal próprio nos logs e exige uma correção diferente.
1. O prompt não atinge o mínimo do provedor
Provedores compatíveis com cache de prompts impõem um limite mínimo de tokens específico por modelo. Um prompt de sistema com 900 tokens jamais será armazenado em cache em qualquer modelo Claude, e preenchê-lo artificialmente é explicitamente desaconselhado ("Não preencha a requisição com texto inútil só para forçar isso", diz o tutorial do OpenRouter). Os limites variam em um fator de quatro no catálogo:
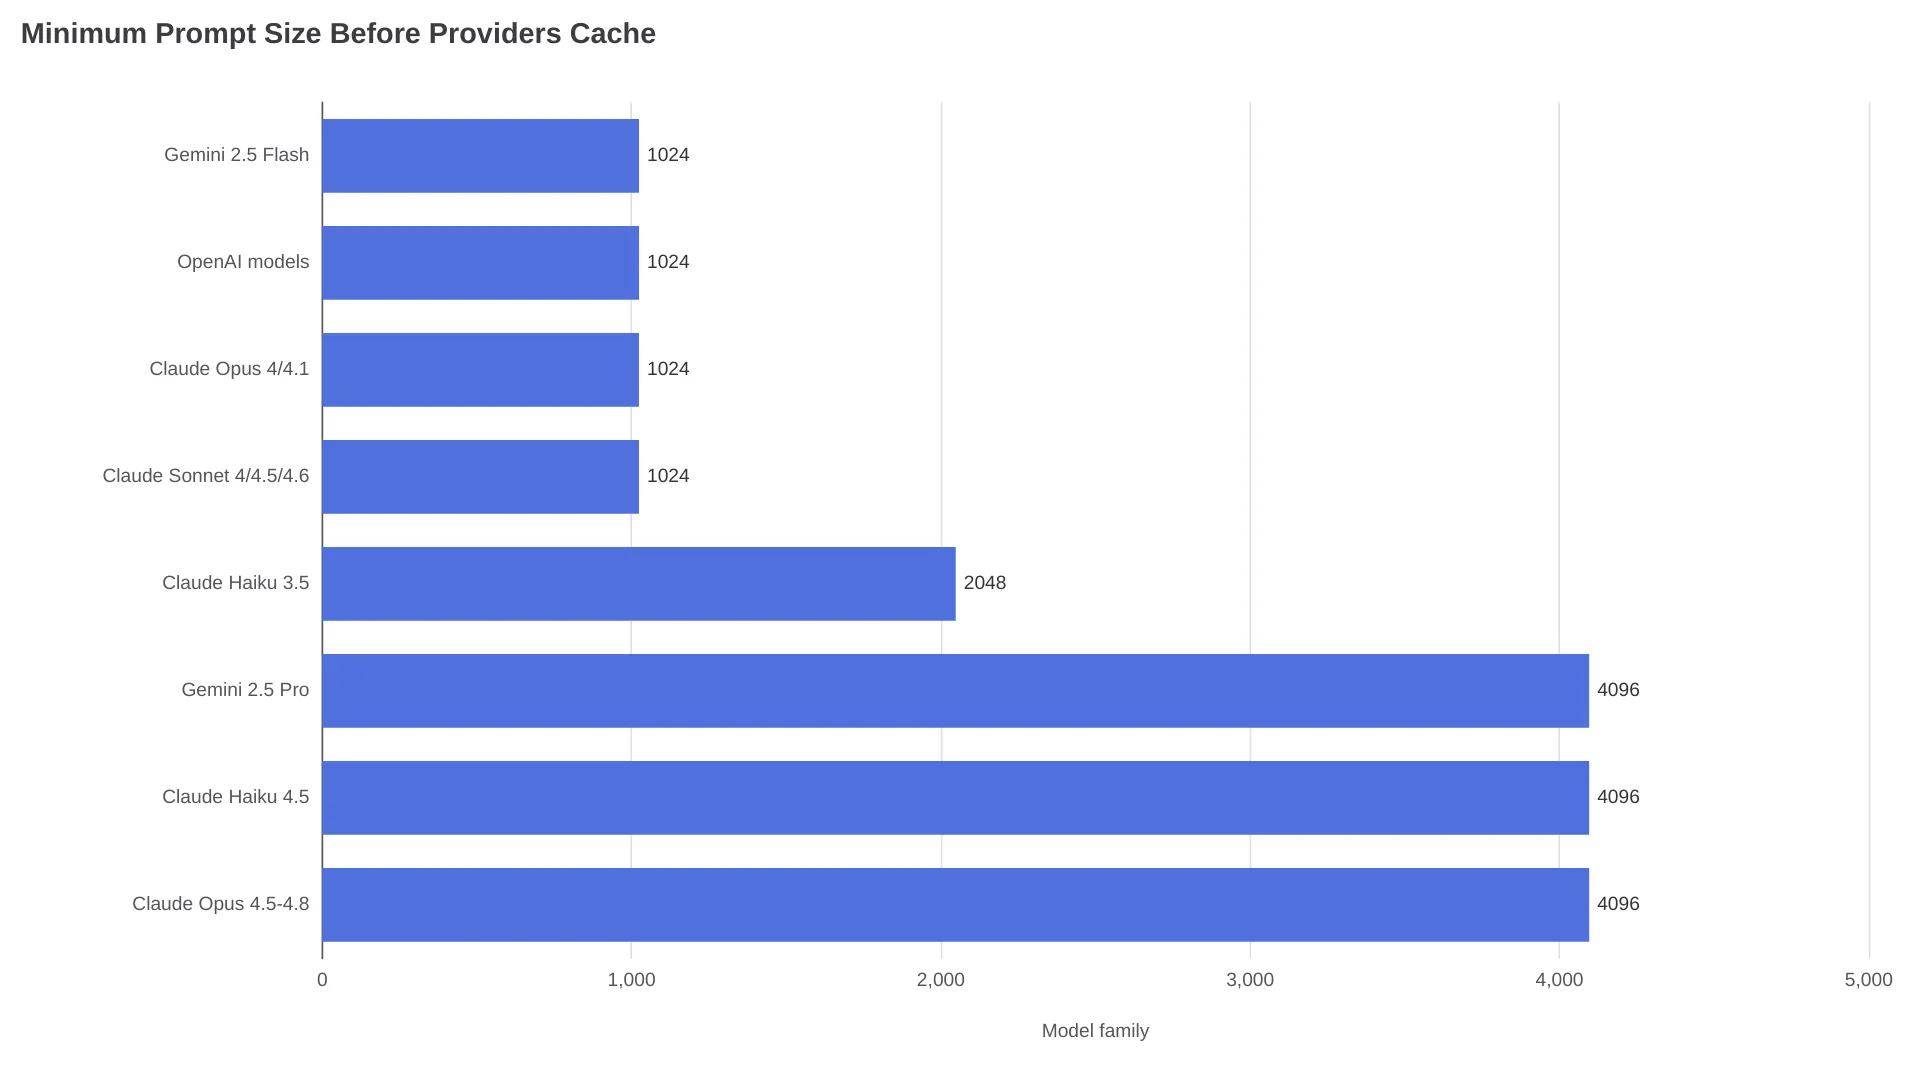
Segundo as notas sobre provedores do OpenRouter, Claude Opus 4.5–4.8 e Haiku 4.5 exigem 4.096 tokens antes que qualquer conteúdo entre em cache; Sonnet 4/4.5/4.6 e Opus 4/4.1 exigem 1.024; Gemini 2.5 Pro fica em 4.096, enquanto Gemini 2.5 Flash aceita 1.024; os modelos OpenAI fazem cache a partir de 1.024. Uma carga de trabalho com prompts curtos no Opus 4.8 é estruturalmente impossível de cachear. A saída é consolidar conteúdo estático — schemas de ferramentas, documentos de referência e few-shots — em um único prefixo ou migrar para um modelo com limite menor.
2. O cache expirou entre os turnos
O cache padrão da Anthropic dura 5 minutos; o TTL de 1 hora custa uma gravação de 2x. O cache implícito do Gemini sobrevive por cerca de 3–5 minutos e, de forma crucial, leituras não reiniciam o cronômetro, conforme o tutorial do OpenRouter. A sessão sticky que mantém você no mesmo provedor morre após 10 minutos de inatividade. Loops de agentes que levam 5–6 minutos pensando entre chamadas estouram todas essas janelas:
"O OpenRouter [é] ótimo para testar modelos. Mas é silenciosamente péssimo para agentes em produção. O segredo sujo? O cache é efetivamente zero em cargas de trabalho reais." — @ran_cohenn, descrevendo intervalos de 5–6 minutos em agentes que expiram a afinidade sticky e resultam em falhas completas de cache mais gravações caras
O TTL de 1 hora da Anthropic, com gravação a 2x, é melhor do que pagar 1,25x de novo a cada cinco minutos, desde que a sessão continue dentro dessa hora. Com pausas de vinte minutos entre usuários, nenhum TTL disponível sobrevive, e o cache só ajuda dentro de uma sequência de turnos.
3. O prefixo mudou sem você perceber
O OpenRouter deriva a chave padrão da conversa usando um hash da primeira mensagem de sistema e da primeira mensagem que não é de sistema. Qualquer mudança no início do prompt invalida o cache a partir daquele ponto. Os culpados mais comuns são contexto RAG inserido antes do prompt de sistema, timestamps ou IDs de requisição na primeira mensagem, definições de ferramentas reescritas a cada chamada e interfaces de chat que inserem mensagens no meio do histórico.
"A taxa de falhas de cache aumenta se algo no início do prompt estiver mudando o tempo todo." — u/Exact_Law_6489
Às vezes, a alteração vem de uma ferramenta que você nem escreveu. "Descobri que o Claude Code estava me causando problemas de acerto de cache; acho que é pela forma como ele injeta ferramentas", relata u/askchris. O Gemini ainda traz duas armadilhas: o OpenRouter usa apenas o último breakpoint cache_control enviado, e a instrução de sistema é tratada como conteúdo imutável em cache. Material dinâmico deve ir para uma mensagem posterior do usuário, não depois do prompt de sistema. Em todos os casos, a correção exige a mesma disciplina: prompt de sistema estático, schemas de ferramentas e documentos de referência primeiro; variações por requisição por último.
4. A requisição caiu em um provedor sem cache aquecido
O OpenRouter distribui chamadas entre mais de 70 provedores (segundo seu próprio tutorial), e o cache de prompts é local ao endpoint que o gravou. O roteamento sticky leva as requisições seguintes de volta ao provedor aquecido, mas apenas quando as leituras em cache desse provedor são mais baratas que sua entrada normal. Além disso, um provider.order manual substitui completamente esse comportamento. Um erro no provedor também libera o pin.
Os dados da comunidade sobre essa falha são contundentes:
- @bruceforai mediu o mesmo nome de modelo em diferentes provedores e encontrou taxas de acerto de cache entre 95,3% e 0%, com alguns preços de cache de terceiros 10x acima da taxa oficial.
- @Bryan_1269 teve uma taxa de acerto muito baixa no GLM 5.2 via OpenRouter e mais de 85% com o mesmo prompt diretamente pela Fireworks.
- @miolini, sobre rotear pelo OpenRouter: "a taxa de acerto de cache é muito ruim, tipo menos de 1%."
A posição oficial do OpenRouter é que o pin funciona: "quando você obtém cache em um modelo ou provedor, fica fixado nele até o cache expirar" (@OpenRouter). Isso é compatível com a documentação e indica que a variação entre provedores — não o pin — é o fator a administrar.
Onde posicionar cache_control — e o que pode removê-lo
Os modelos Anthropic no OpenRouter trabalham com cache em dois modos: um objeto cache_control no nível superior, que avança automaticamente à medida que a conversa cresce — recomendação do OpenRouter para chats com vários turnos — e breakpoints explícitos em blocos de conteúdo individuais, até quatro, para materiais grandes e fixos, como schemas de ferramentas, documentos RAG, dumps CSV ou fichas de personagem. O formato no nível superior funciona em Anthropic nativo, Vertex, Azure e Bedrock, onde o OpenRouter o converte em um breakpoint final porque a API do Bedrock não aceita esse campo no nível superior. Para definir um TTL explícito, use Chat Completions ou a Anthropic Messages API, não Responses.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens de schemas de ferramentas e documentos de referência>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
Na OpenAI, o funcionamento é diferente: o cache é automático a partir de 1.024 tokens, e marcadores explícitos prompt_cache_breakpoint existem somente no GPT-5.6 e posteriores. Eles são definidos em um bloco input_text ou text, com TTL mínimo de 30 minutos quando solicitado.
O OpenRouter traduz entre os dialetos, conforme suas notas de provedores: um marcador Anthropic cache_control vira um breakpoint OpenAI; um breakpoint OpenAI vira um marcador Anthropic padrão de 5 minutos; e valores de TTL nunca são transferidos. O Qwen requer marcadores cache_control explícitos, armazena por 5 minutos e oferece suporte apenas em modelos específicos (qwen3-max, qwen-plus, qwen3-coder-plus e outros; snapshots como qwen3.5-plus-02-15 ficam de fora).
Há uma falha mais discreta: alguns clientes e gateways entre sua aplicação e o OpenRouter removem campos não padronizados antes do encaminhamento:
"A queda do cache de prompts da anthropic para zero atrás de gateways geralmente é um bug de marshalling. ... marcadores cache_control sendo silenciosamente removidos antes do encaminhamento ao openrouter. Você não pode abstrair provedores descartando extensões do schema deles." — @SiddharthInk_
Confirme que o marcador chega ao destino: inspecione os metadados brutos da requisição no detalhe da geração no Activity ou envie uma requisição de teste com curl, sem nenhuma camada intermediária. Uma ferramenta que achata mensagens em um único bloco destrói os breakpoints, por mais correta que seja sua posição. O repositório de exemplos do OpenRouter traz exemplos executáveis em TypeScript, Vercel AI SDK e Effect que preservam os marcadores.
Fixe o provedor com session_id e provider.order
Uma identidade de sessão estável é o controle de roteamento mais forte: session_id fixa requisições posteriores no provedor que atendeu à primeira requisição bem-sucedida, antes mesmo de qualquer acerto de cache ser observado. Sem ela, o comportamento sticky só começa após o primeiro acerto de cache detectado. E a identidade padrão — um hash da primeira mensagem de sistema mais a primeira mensagem não pertencente ao sistema — muda silenciosamente com qualquer mutação no prefixo, como no problema 3, segundo a documentação de roteamento do OpenRouter.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Detalhes importantes: session_id vai no corpo da requisição ou no cabeçalho x-session-id — o corpo prevalece se ambos forem definidos; o limite é de 256 caracteres; e o OpenRouter recorre a prompt_cache_key, no estilo OpenAI, se nenhum dos dois estiver presente.
Duas ressalvas da documentação: erros no provedor liberam o pin, e linhas da Batch API são executadas em paralelo e fora de ordem, de modo que a gravação de cache de uma linha não fica visível para a seguinte. Compartilhe um prefixo com "ttl": "1h" entre lotes ou aqueça-o primeiro com uma requisição síncrona. (O guia do Auto Router aborda o reaproveitamento, em melhor esforço, do modelo resolvido pelo Auto Router.)
Se apenas o pin não for suficiente, restrinja diretamente o conjunto de provedores:
"A solução que encontrei foi definir uma lista preferencial de provedores a serem usados em ordem de preferência." — u/nabil9506
Uma lista provider.order com dois ou três provedores de leitura de cache barata troca abrangência de failover por localidade de cache — uma escolha razoável para cargas de trabalho com agentes. u/welcome_to_milliways chama a carga de configuração manual de "uma falha bastante fundamental no OR". Concorde ou não, esse é o contrato atual.
Quando usar cache por um roteador deixa de compensar
O cache de prompts via OpenRouter deixa de valer a pena em três situações reconhecíveis: prompts que nunca alcançam o mínimo de tokens do modelo, sessões com intervalos maiores que todos os TTLs disponíveis e requisições isoladas cujo adicional de gravação não é amortizado por uma leitura com desconto. Há ainda uma quarta: ferramentas que você não consegue alterar e que removem cache_control antes de ele chegar ao roteador. @grapeot dimensiona o problema: quando o cache falha na camada de gateway, a diferença de custo chega a uma ordem de grandeza, muito acima da própria taxa de roteamento.
Para cargas de trabalho em que o cache é crítico e nenhuma das correções se aplica, um único upstream fixo supera um roteador: comportamento de cache determinístico e nenhum pin para administrar. Um endpoint direto da Claude API, com o cache da própria Anthropic, é a rota de saída mais simples quando o desvio entre provedores não pode ser corrigido.
O Zero Data Retention no nível da conta desativa completamente o cache de respostas. Para cache de prompts sob ZDR, consulte a análise do OpenRouter sobre se o cache implícito conta como retenção de dados.
Ordem de correção recomendada
Depurar seguindo a ordem de medição recupera a maior parte da economia com menos mudanças: verifique primeiro e então avance pela pilha, do prompt ao roteamento e ao TTL:
| # | Ação | O que resolve |
|---|---|---|
| 1 | Leia cached_tokens e cache_discount em algumas requisições reais | Diferencia problema de taxa de acerto de problema de expectativa de preço |
| 2 | Compare o tamanho do prompt ao mínimo de tokens do modelo | Elimina o caso de "nunca cacheável" antes de todo o resto |
| 3 | Congele o prefixo: prompt de sistema, schemas e documentos estáticos primeiro; timestamps e RAG por último | Elimina a classe de invalidações silenciosas |
| 4 | Envie session_id em toda requisição de uma conversa | Fixa o provedor desde o primeiro turno, não apenas após o primeiro acerto |
| 5 | Defina provider.order com dois ou três provedores de leitura de cache barata | Remove o desvio entre provedores |
| 6 | Adicione "ttl": "1h" (Anthropic) ou migre para um provedor com gravação gratuita em sessões longas | Lida com expiração entre turnos |
As etapas 1–3 eliminam as classes de falha sob seu controle no código; as etapas 4–6 conciliam os relatos abaixo de 1% com a manchete de 82,8%. Para aprofundar: o guia de preços do OpenRouter, sobre como tokens em cache aparecem na fatura; o guia do Auto Router, sobre o comportamento de fixação de modelos; e o guia do dashboard Activity, para acompanhar as taxas de acerto ao longo do tempo.