 AIREITER
Por US$ 0,04 a cada milhão de tokens de entrada, a API hospedada continua sendo o caminho mais simples. Mas os novos checkpoints de pesos abertos também tornam a inferência local viável — com uma diferença de qualidade expressiva entre os modelos de 3B e 600M.
As três opções d1 da Liquid não são equivalentes
Hoje, a Liquid AI oferece três alternativas relevantes: o serviço proprietário hospedado d1, o modelo de pesos abertos d1-3B e o experimental, também de pesos abertos, d1-omni-600M. A empresa não afirmou que o modelo hospedado seja idêntico a nenhum dos checkpoints disponíveis para download. Por isso, números de benchmark e latência precisam sempre ser atribuídos ao modelo que os gerou.
| Opção | Acesso e preço | Entradas | Contexto publicado | Melhor cenário |
|---|---|---|---|---|
d1 hospedado | Liquid API; US$ 0,04 por 1M de tokens de entrada, sem cobrança por tokens de saída | Texto e imagens diretamente pela Liquid | 66K listados pela Vercel | Integração rápida, custo de inferência quase irrelevante e nenhuma operação de modelo |
d1-3B | Pesos para download; sem taxa de modelo por token | Texto, JSON e imagens | 32.768 tokens | Melhor qualidade local, visão e avaliação para produção |
d1-omni-600M | Pesos experimentais para download; sem taxa de modelo por token | Texto com imagem ou texto com áudio | 16.384 tokens | Pegada reduzida, experimentos com comandos de voz e dispositivos de borda restritos |
Os três respondem a perguntas tipadas, em vez de redigir texto. noul retorna uma probabilidade de sim; choice devolve probabilidades para opções nomeadas; e score retorna uma posição ponderada por probabilidade em uma rubrica ordenada. São modelos indicados para roteamento, moderação, inspeção, guardrails e pontuação — não substitutos para um modelo de chat ou programação.
A recomendação é simples: use o d1 hospedado em um piloto; escolha o d1-3B quando os dados precisarem ficar locais ou quando a latência não puder incluir um salto de rede; e encare o d1-omni-600M como experimental, a menos que áudio ou tamanho sejam a limitação decisiva.
Preço da API versus custo de rodar localmente
A API Liquid AI d1 custa US$ 0,04 por milhão de tokens de entrada. Não há cobrança por tokens de saída, já que o serviço retorna decisões, não texto gerado. Uma carga de 100 milhões de tokens de entrada sai por US$ 4, antes de eventuais taxas de gateway; um bilhão de tokens custa US$ 40.
A US$ 0,04/M de tokens, hospedar o modelo por conta própria raramente compensa apenas pelo custo de inferência. A implantação local faz sentido por privacidade, uso offline, latência no dispositivo, customização ou utilização sustentada.
Os dois checkpoints abertos não têm preço oficial por token em um serviço hospedado. No momento da análise, suas páginas no Hugging Face não exibiam provedor de inferência. Portanto, o valor do d1 hospedado não deve ser apresentado como preço do d1-3B nem do d1-omni-600M.
O serviço hospedado também cobra imagens como entrada. A Liquid AI especifica 1,5 token por bloco de 32×32 pixels, o que faz uma imagem de 1024×1024 consumir 1.536 tokens antes do texto da pergunta. A US$ 0,04/M, a parte referente à imagem custa cerca de US$ 0,00006144; cada pergunta é cobrada como um prompt próprio e inclui a imagem associada.
Pesos abertos não significam uso irrestrito nem custo zero
Os dois repositórios usam a licença lfm1.0 da Liquid AI, e não Apache 2.0 ou MIT. Os termos gerais de preços da empresa dizem que seus modelos para download são gratuitos para uso comercial por companhias com receita anual inferior a US$ 10 milhões. Organizações maiores devem confirmar os termos comerciais atuais, em vez de presumir autorização com base na expressão “pesos abertos”.
No orçamento local, inclua compra de GPU ou dispositivo, capacidade ociosa, monitoramento, atualizações e tempo da equipe. A conta do serviço hospedado é variável e muito baixa; o custo local é majoritariamente fixo.
d1-3B prioriza qualidade; omni prioriza tamanho
O anúncio do Open d1 informa pontuação de 48,57 no Decision Index v0.2.1 para o d1-3B e de 15,95 para o d1-omni-600M. A Liquid AI executou ambos no avaliador oficial, mas os resultados não foram submissões oficiais ao leaderboard.
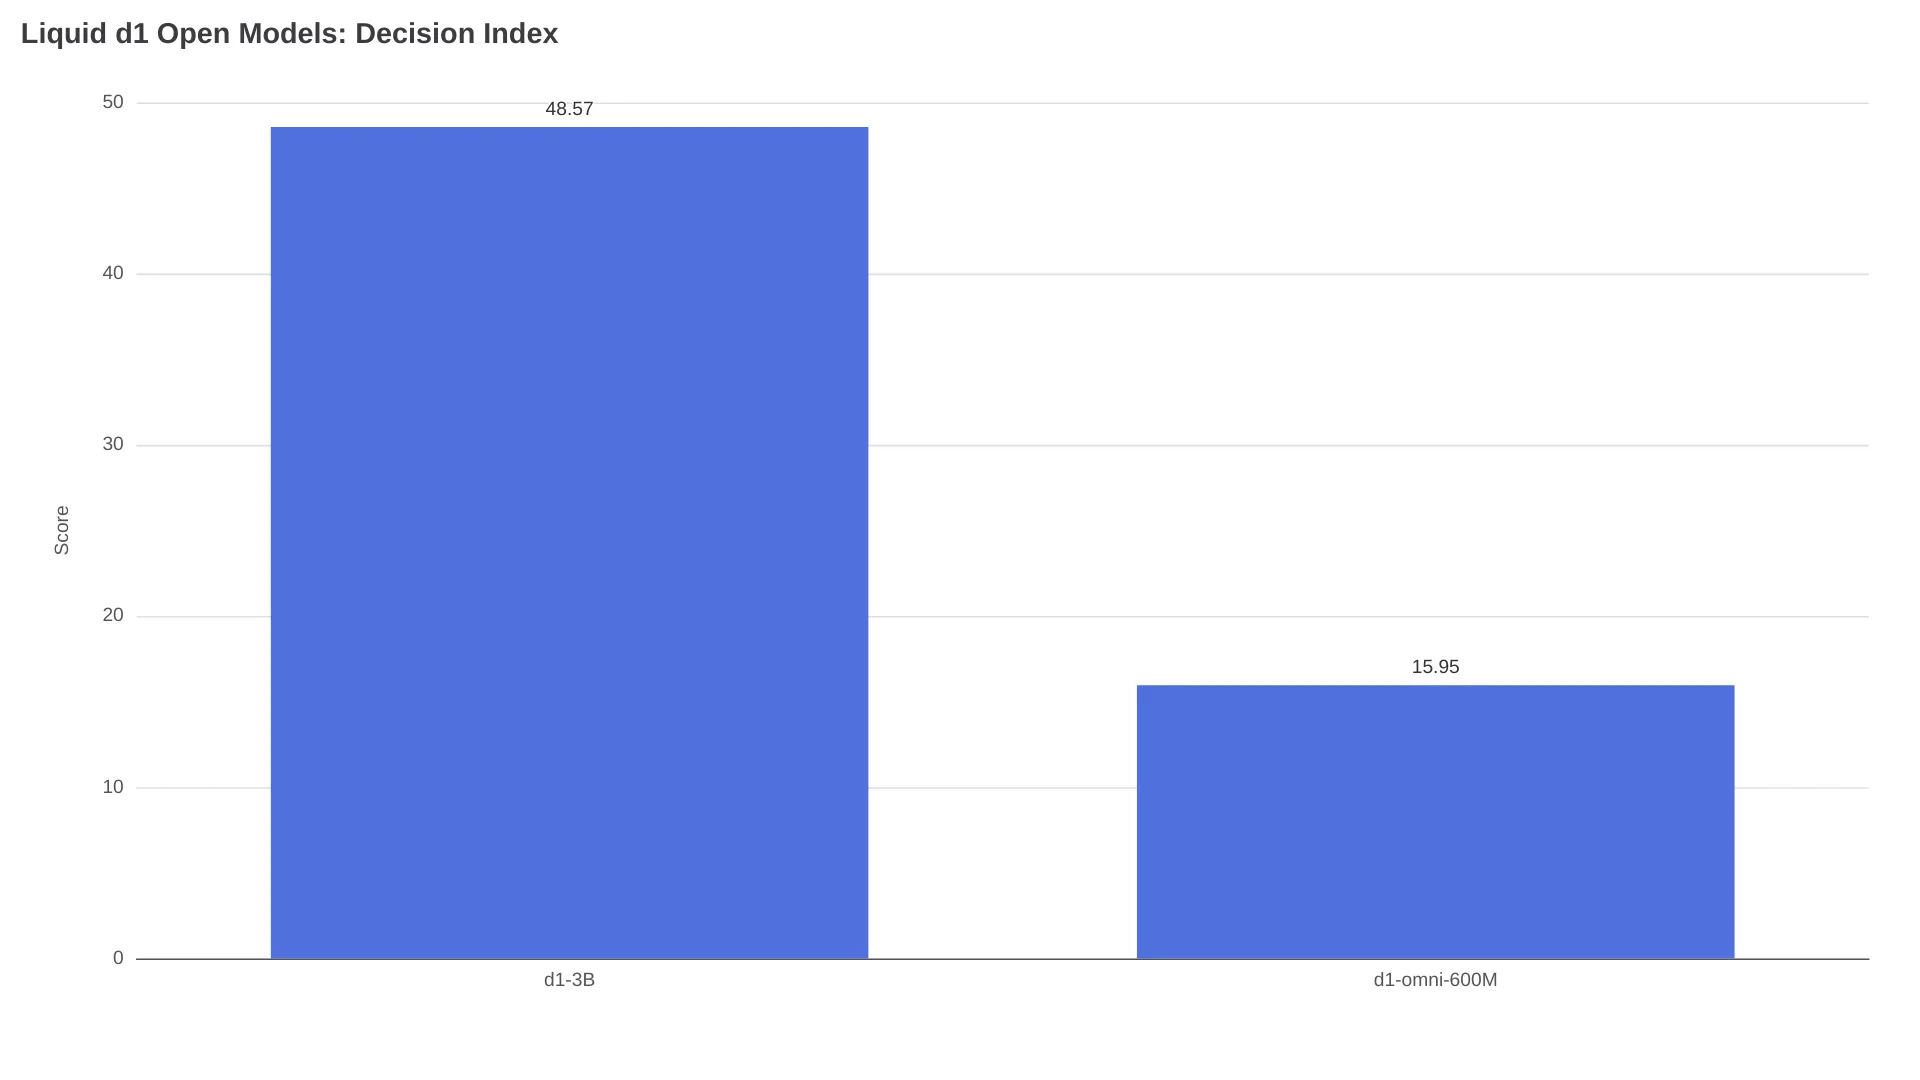
O modelo menor não é ruim em todos os casos. Em sete benchmarks públicos de texto, a Liquid AI reporta médias de 82,9 para o d1-3B e 78,4 para o d1-omni-600M. O omni liderou em Civil Comments, com 95,8 contra 93,0, e em PAWS-X, com 79,5 contra 76,9; o 3B ficou à frente nas outras cinco tarefas listadas. A diferença muito maior no Decision Index mostra que bons resultados pontuais em classificação não tornam o checkpoint de 600M um substituto geral para o 3B.
| Especificação | d1-3B | d1-omni-600M |
|---|---|---|
| Contagem detalhada de parâmetros | 3,12B | 587M |
| Tamanho do repositório/pesos em precisão total | Repositório de 6,27 GB; pesos de 6,25 GB | Modelo F32, cerca de 0,6B de parâmetros |
| Contexto | 32.768 | 16.384 compartilhados entre modalidades |
| Limite de texto com imagem | Dentro do contexto do modelo | Texto de estado e pergunta limitado a 896 tokens com imagens |
| Áudio | Não | Um clipe mono de 16 kHz, de até 30 segundos |
| Imagem + áudio ao mesmo tempo | Não se aplica | Não suportado; gera ValueError |
| Tabela oficial de velocidade | Sim | Não; lançamento inicial de pesquisa |
O model card do d1-omni-600M informa que o treinamento foi feito em float32. Float16 preservou a resposta principal em 243 linhas de texto, 214 de imagem e 416 de áudio, enquanto bfloat16 alterou a resposta principal em 0,8% das linhas de texto e 1,7% das linhas de áudio. Na prática, o dtype precisa ser validado: não é apenas uma opção de otimização.
Rodar localmente é rápido de configurar, mas exige uma validação longa
Os dois model cards expõem system_one para um estado e system_one_batch para requisições agrupadas. O caminho mais curto para o d1-3B usa Transformers 5.14 ou superior, PyTorch, TorchVision, Pillow e código personalizado fornecido pelo repositório.
- Instale as dependências documentadas:
pip install "transformers>=5.14" torch torchvision pillow- Carregue o modelo com a execução do código remoto do repositório habilitada:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Envie decisões nomeadas, não um prompt de chat:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True significa que o Python do repositório é executado no processo de serving. Antes de ir para produção, fixe um commit revisado em vez de carregar uma branch em movimento. O repositório do d1-3B também aponta para quantizações compatíveis com runtimes do llama.cpp, Ollama e LM Studio; um artefato quantizado de terceiros representa uma decisão separada de cadeia de suprimentos e precisão em relação aos pesos oficiais em BF16.
O model card do d1-3B informa tempos de chamadas já aquecidas de 8 ms para uma pergunta em uma RTX 4090, 30 ms em um Apple M5 Pro e 50 ms em um Jetson Orin Nano. Um estado de 3,4K tokens levou 102 ms, 640 ms e 1.640 ms, respectivamente, nesses mesmos dispositivos. Os números de GPU são medianas de 20 execuções; o resultado de 8 ms na 4090 usou CUDA graphs compilados, e uma nova forma de entrada incorre em overhead de compilação ou seleção de kernel.
Não existe tabela oficial de velocidade para o d1-omni-600M. Uma implementação para navegador reportou cerca de 180 ms por comentário para quatro decisões:
“I didn't test it against other machines yet, just my MBP M4 Pro.” — u/FinancialAd1961 no Reddit
O resultado em um único dispositivo demonstra viabilidade no navegador, não desempenho em diferentes navegadores, GPUs, quantizações ou tamanhos de lote.
O acesso pela API é mais simples, mas a identidade do modelo continua importando
O acesso direto ao serviço hospedado usa o modelo d1 em https://api.liquid.ai/decisions/v1/systemone. A Vercel usa liquid/d1; sua página lista contexto de 66K e a mesma tarifa de US$ 0,04/M para entrada. O anúncio da Liquid de 5 de outubro afirmou que Vercel e OpenRouter aceitavam somente texto naquele momento, enquanto a API direta da Liquid aceitava imagens.
Os checkpoints abertos usam métodos Python locais com os mesmos conceitos de decisão, mas uma interface parecida não prova equivalência de comportamento. As probabilidades podem variar o suficiente para levar um caso além de um limiar de automação. Registre o ID exato do modelo, a revisão, o dtype, a probabilidade e o limiar em cada ramificação avaliada.
Por isso, uma migração deve seguir quatro etapas:
- Monte um conjunto rotulado a partir da distribuição real de produção, incluindo casos ambíguos e erros caros.
- Execute os mesmos estados, esquema de perguntas e critérios em cada candidato.
- Defina os limiares com base nos custos de falsos positivos e falsos negativos, não em uma pontuação global de benchmark.
- Faça shadow do vencedor antes de permitir ações destrutivas, financeiras, de controle de acesso ou de segurança.
Qual Liquid d1 escolher?
Para a maioria das equipes, a API hospedada é a recomendação padrão. O preço por token é baixo demais para que um piloto pequeno justifique um projeto de serving local, além de evitar trabalho com drivers, quantização, aquecimento e capacidade.
| Necessidade | Escolha | Motivo |
|---|---|---|
| Caminho mais rápido para produção | d1 hospedado | Endpoint gerenciado e preço de entrada explícito |
| Os dados não podem sair do dispositivo ou da rede | d1-3B | Checkpoint aberto mais robusto e execução local |
| Melhor qualidade publicada de decisão entre os modelos abertos | d1-3B | 48,57 no Decision Index contra 15,95 |
| Classificação de comandos de áudio | d1-omni-600M | Única opção aqui com áudio, limitado a 30 segundos |
| Menor pegada experimental | d1-omni-600M | 587M de parâmetros, mas sem tabela oficial de latência |
| Explicações abertas ou ações geradas | Nenhum deles | Adicione um modelo generativo depois da etapa de decisão |
Prefira o d1-3B ao omni, a menos que a pegada de 600M ou a via de áudio seja indispensável. Uma redução de cinco vezes no número de parâmetros é atraente, mas não elimina a diferença de 32,62 pontos no Decision Index nem o status experimental do omni.
Perguntas frequentes sobre o Liquid AI d1
O Liquid AI d1 é gratuito?
O serviço hospedado d1 custa US$ 0,04 por milhão de tokens de entrada e não cobra tokens de saída. Os checkpoints abertos podem ser baixados sem taxa por token, mas os termos comerciais do LFM 1.0 e os custos de computação local continuam valendo.
d1-3B e d1-omni-600M são o modelo da API d1 hospedada?
A Liquid AI não documentou nenhum dos checkpoints como idêntico ao d1 hospedado. Trate-os como produtos relacionados, mas com IDs de modelo, contextos, benchmarks e caminhos de implantação distintos.
Posso rodar Liquid d1 com Ollama?
A página do d1-3B aponta para quantizações destinadas ao llama.cpp, Ollama, LM Studio e aplicações compatíveis. Verifique o quantizador, a revisão de origem, o suporte à API de decisões e a precisão antes de substituir o caminho oficial via Transformers.
O d1-3B suporta áudio?
Não. O d1-3B aceita texto, JSON e imagens. O d1-omni-600M aceita texto com imagens ou texto com um clipe de áudio de até 30 segundos, mas não pode receber imagens e áudio na mesma requisição.
Quanta VRAM o d1 local precisa?
A Liquid publica um arquivo de pesos BF16 de 6,25 GB para o d1-3B, mas não informa um requisito universal de VRAM. Overhead de runtime, estado do codificador de imagem, tamanho de contexto, lote, precisão e quantização alteram o total; meça a configuração pretendida em vez de equiparar o tamanho do arquivo ao pico de VRAM.
Independentemente do caminho escolhido, valide os limiares de probabilidade em dados de produção rotulados antes de automatizar decisões com consequências relevantes.
Leitura relacionada: a análise da API hospedada Liquid AI d1 aborda com mais detalhes o endpoint direto, a cobrança de imagens e o contrato de requisição tipado.