 AIREITER
Escolher manualmente o melhor modelo para cada solicitação pode virar um gargalo rapidamente. O Auto Router do OpenRouter (openrouter/auto) tenta resolver isso: ele classifica cada prompt em cerca de 30 tipos de tarefa e escolhe o modelo com base em como os mais de 55T de tokens gastos semanalmente na plataforma são direcionados — não em um ranking estático. Desde 10 de agosto de 2026, o OpenRouter substituiu o roteamento baseado em NotDiamond por um sistema guiado por um sinal de gastos da comunidade acumulado em 7 dias. A promessa é reduzir custos na faixa padrão e entregar qualidade de fronteira na faixa máxima. Há um porém: não existe cobrança adicional por requisição, mas o modelo escolhido define sua fatura — e, sem configuração, até um prompt simples pode cair em um modelo caro.
O que mudou no Auto Router do OpenRouter
O Auto Router é um meta-roteador. Em vez de informar um modelo específico, você envia a requisição para openrouter/auto, e ele encaminha o prompt a um modelo subjacente. Você paga a tarifa normal desse modelo, sem taxa de roteamento adicional. A resposta traz o campo model, que informa qual modelo foi selecionado e permite auditar cada chamada.
A atualização de agosto de 2026 trocou o mecanismo anterior, antes operado pelo NotDiamond, pelo que o OpenRouter chama de “sabedoria do mercado”. Em vez de um classificador fixo decidir qual modelo é o “melhor”, o roteador analisa dados anônimos de gastos dos últimos 7 dias. Se milhares de desenvolvedores migraram sua carga de programação de um modelo para outro na semana passada, o roteador acompanha esse movimento em poucos dias.
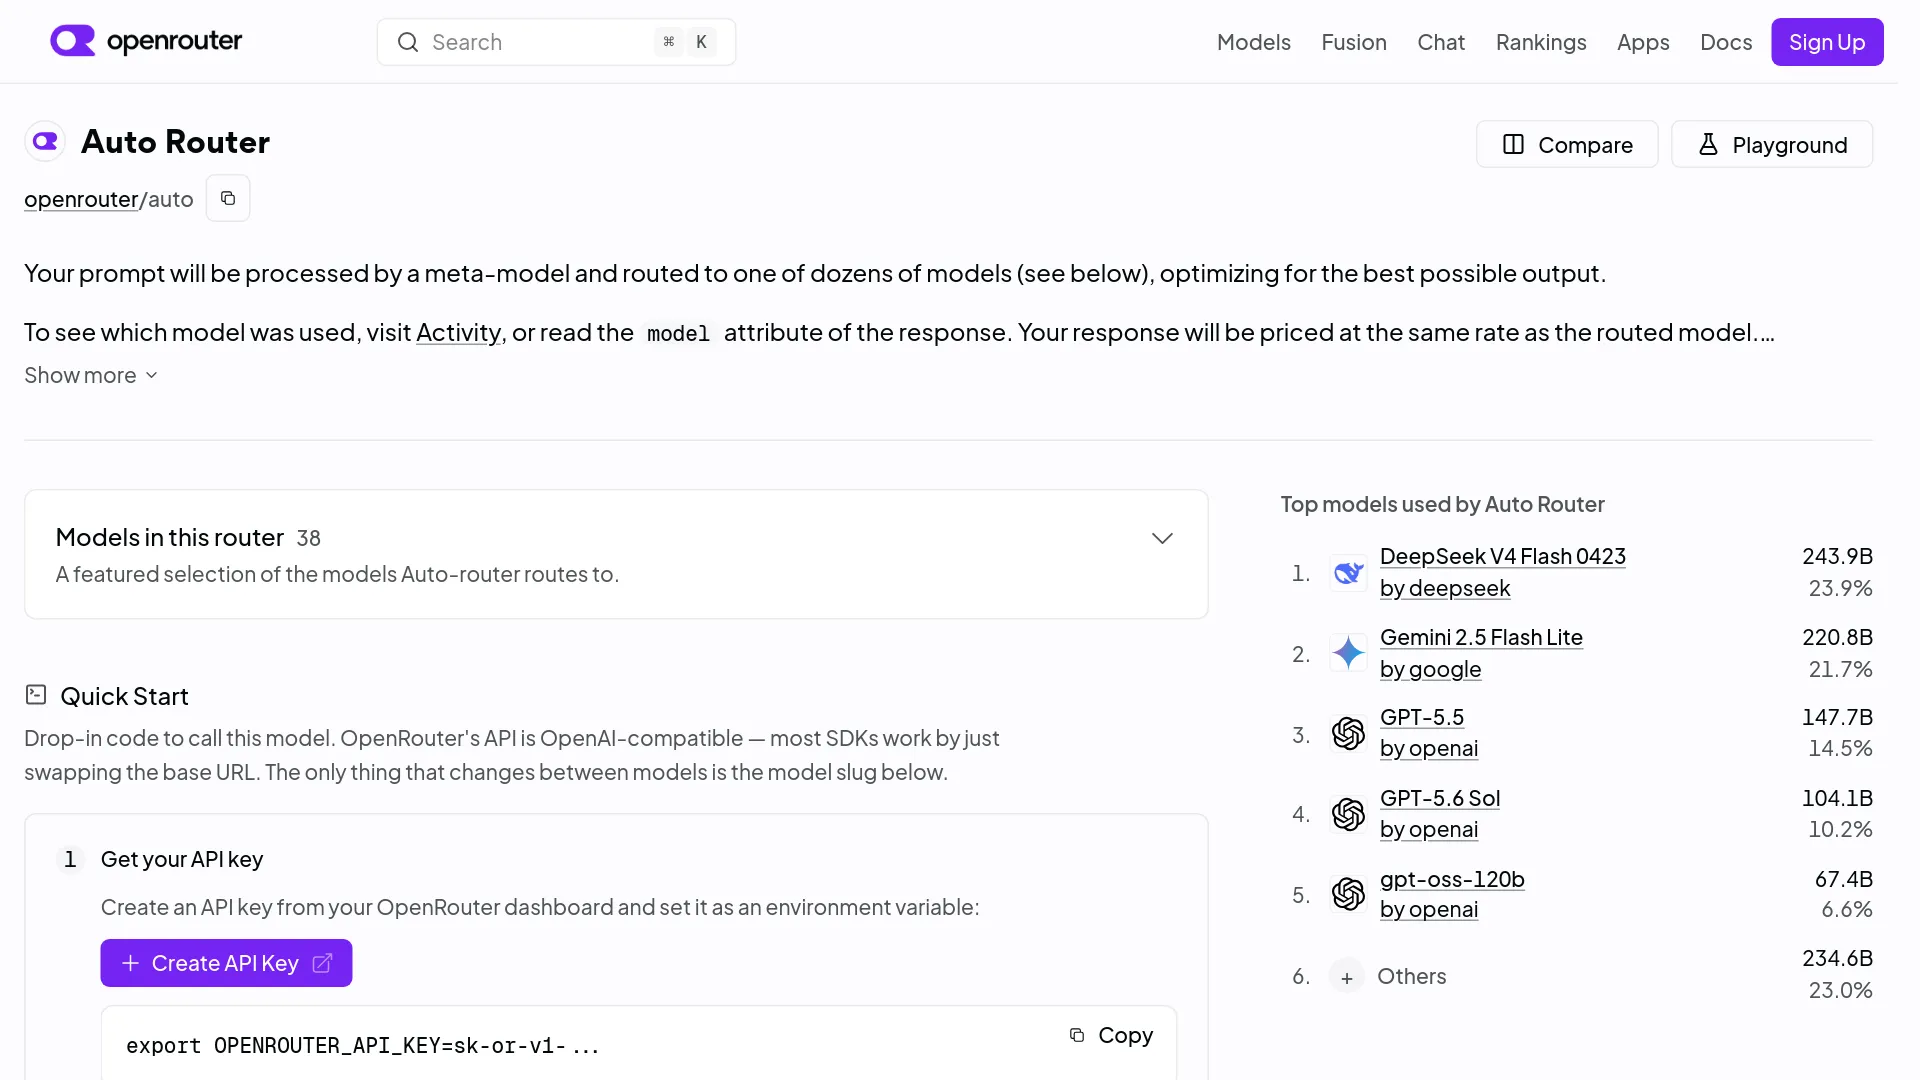
O roteador classifica prompts durante o processamento — sem exigir retenção dos prompts — em aproximadamente 30 categorias, entre elas geração de código, depuração, planejamento de agentes em múltiplas etapas, perguntas e respostas de conhecimento, matemática, suporte ao cliente e relatórios de pesquisa. Caso os dados de classificação ou ranqueamento não estejam disponíveis, ele recorre a um conjunto padrão de modelos para que uma falha no roteamento não interrompa sua requisição.
Há dois slugs disponíveis:
| Slug | Finalidade | ID do plugin |
|---|---|---|
openrouter/auto | Roteador estável, disponível de forma geral | auto-router |
openrouter/auto-beta | Canal de acesso antecipado para atualizações de roteamento | auto-beta-router |
O novo roteador ficou em auto-beta por algumas semanas antes de migrar para o slug estável em 10 de agosto de 2026. Se você enviar a configuração usando o ID de plugin errado, ela será ignorada silenciosamente — uma armadilha frequente na configuração.
Como o roteador escolhe: 30 tipos de tarefa e 5 faixas de custo
A lógica de seleção tem duas entradas: a classificação da tarefa e a faixa de custo. Primeiro, o sistema identifica o tipo de tarefa no prompt. Depois, dentro dessa categoria, ranqueia os modelos candidatos pela participação de uso da comunidade nos últimos 7 dias, já aplicando as restrições da sua conta, como modelos permitidos, guardrails, configurações de privacidade e políticas ZDR.
As faixas de custo definem até que ponto da escala de preço o roteador pode ir. São cinco níveis, do mais barato ao mais capaz: low, medium, high, xhigh e max. O padrão é low. Cada nível representa uma faixa, não um teto: modelos abaixo e acima dela ficam excluídos.
A matriz de roteamento que o OpenRouter publicou em 10 de agosto de 2026 abrange todos os cerca de 30 tipos de tarefa. Os 15 exemplos representativos abaixo mostram como o tipo de tarefa e a faixa de custo definem a escolha:
| Tipo de tarefa | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| Geração de código | glm-5.2 | claude-4.6-sonnet | kimi-k3 | claude-opus-5 | claude-5-fable |
| Depuração | deepseek-v4-pro | glm-5.2 | gemini-3.6-flash | claude-4.8-opus | claude-opus-5 |
| Revisão de código | glm-5.2 | claude-sonnet-5 | kimi-k3 | gpt-5.6-sol | claude-opus-5 |
| SQL e banco de dados | deepseek-v4-flash | glm-5.2 | claude-sonnet-5 | kimi-k3 | claude-opus-5 |
| Frontend e UI | glm-5.2 | claude-sonnet-5 | gpt-5.6-sol | kimi-k3 | claude-5-fable |
| DevOps e configuração | deepseek-v4-flash | glm-5.2 | gpt-5.6-sol | kimi-k3 | claude-opus-5 |
| Planejamento em múltiplas etapas | deepseek-v4-pro | glm-5.2 | claude-4.8-opus | kimi-k3 | claude-5-fable |
| Busca na web | deepseek-v4-flash | glm-5.2 | gpt-5.6-sol | kimi-k3 | claude-4.6-opus |
| Matemática | deepseek-v4-pro | glm-5.2 | gemini-3.1-pro | kimi-k3 | claude-4.6-opus |
| Redação de conteúdo | glm-5.2 | gemini-3.6-flash | claude-4.8-opus | claude-4.6-opus | gpt-5.6-sol |
| Relatórios de pesquisa | deepseek-v4-pro | glm-5.2 | claude-sonnet-5 | gpt-5.6-sol | claude-opus-5 |
| Perguntas e respostas de conhecimento | glm-5.2 | gemini-3.6-flash | claude-sonnet-5 | kimi-k3 | gpt-5.6-sol |
| Tradução | deepseek-v4-flash | gemini-3-flash | gemini-3.5-flash | claude-sonnet-5 | gpt-5.6-sol |
| Classificação | gemini-3-flash | gemini-3.5-flash | gemini-3.6-flash | gemini-3.1-pro | gpt-5.6-sol |
| Suporte ao cliente | gemini-3-flash | gpt-4.1 | gemini-3.6-flash | claude-4.6-sonnet | claude-opus-5 |
A faixa low privilegia modelos mais baratos, como GLM-5.2 e DeepSeek V4 Flash para tarefas de código, além de variantes Gemini Flash para classificação e suporte. Já max direciona para Claude Opus 5, Claude 5 Fable ou GPT-5.6 Sol, conforme a tarefa.
cost_tier e o antigo cost_quality_tradeoff
O antigo parâmetro numérico cost_quality_tradeoff (de 0 a 10, em que 0 priorizava qualidade e 10 priorizava custo; padrão 7) está obsoleto, mas ainda é aceito. O novo parâmetro cost_tier usa faixas nomeadas. Se você enviar os dois, cost_quality_tradeoff tem precedência. É uma decisão de compatibilidade retroativa que pode gerar roteamento inesperado na migração de código antigo. Ao adotar cost_tier, remova o parâmetro anterior.
Configuração em uma requisição de API:
{
  "model": "openrouter/auto",
  "messages": [{ "role": "user", "content": "Debug this Python function" }],
  "plugins": [{
    "id": "auto-router",
    "cost_tier": "max",
    "allowed_models": ["anthropic/*", "openai/*"]
  }]
}
allowed_models aceita padrões curinga, como anthropic/*, para limitar os modelos a um provedor. A lista excluded_models é aplicada depois de allowed_models e pode restringir ainda mais o conjunto. Se nenhum modelo restar após os filtros, a API retorna 404.
Benchmarks: o novo Auto Router contra a versão anterior
O OpenRouter comparou em benchmarks os roteadores novo e antigo em cinco avaliações distintas, considerando as configurações padrão e máxima. O padrão do roteador antigo era cost_quality_tradeoff=7; no novo, é cost_tier=low.
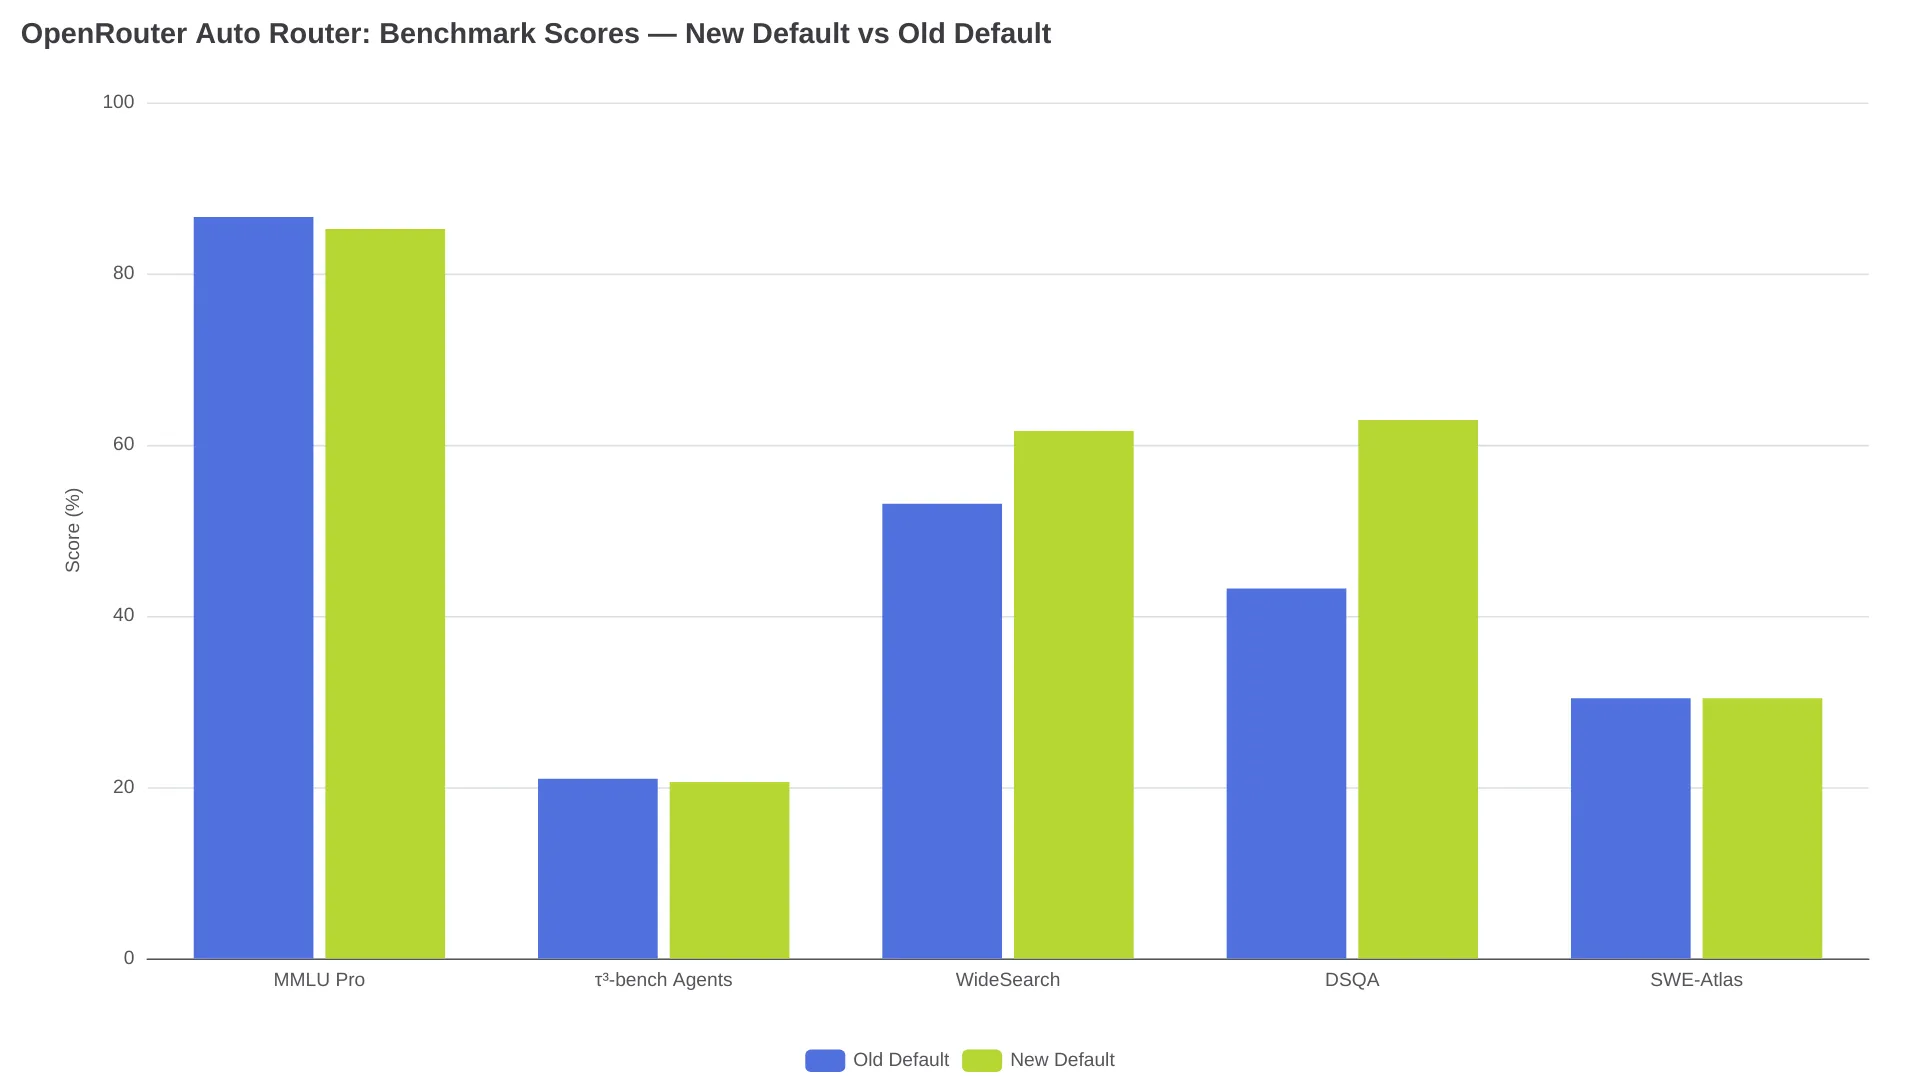
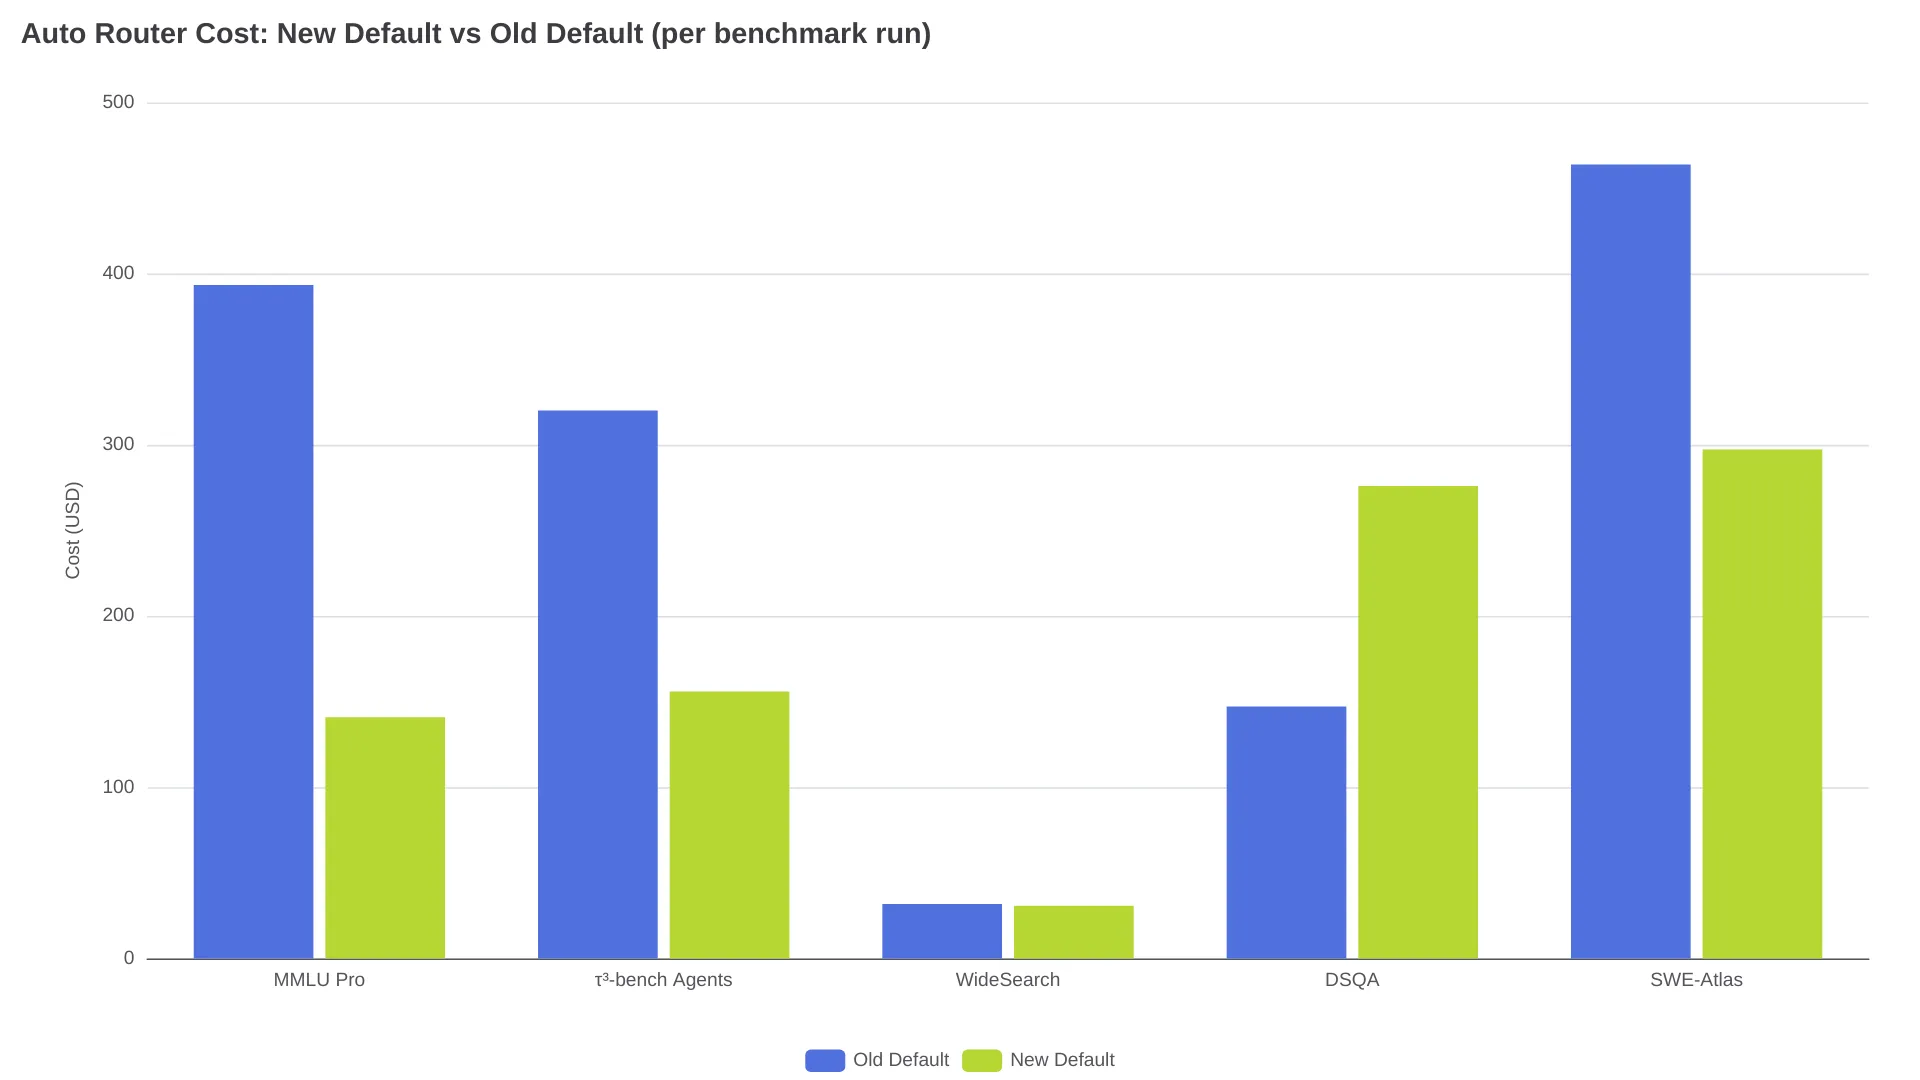
Na faixa padrão, o novo roteador iguala ou supera o anterior em 3 dos 5 benchmarks. Os maiores ganhos aparecem em DSQA (pesquisa, +45,6%) e WideSearch (busca, +16,0%); houve pequenas quedas em MMLU Pro (-1,6%) e tau-bench Banking (-1,9%), além de empate em SWE-Atlas QnA. Os custos da faixa padrão são menores em MMLU Pro (-64,2%), tau-bench (-51,3%) e SWE-Atlas (-35,9%), mas ficam 87,6% maiores em DSQA ($276 contra $147.11). Na faixa máxima, o novo roteador vence os 5 benchmarks: tau-bench Banking passou de 7,2% para 31,6% (+338,9%), e SWE-Atlas QnA, de 2,4% para 60,7% (+2429,2%). Em contrapartida, os custos da faixa máxima são maiores em 4 dos 5 benchmarks, com SWE-Atlas custando $1,325 contra $205. Esses resultados refletem um momento específico; o OpenRouter alerta que o comportamento do roteamento muda conforme as preferências da comunidade evoluem.
Como evitar custos inesperados com o Auto Router
Uma preocupação recorrente com o Auto Router são cobranças imprevisíveis. Como resumiu um usuário do r/openrouter:
“Ele pode simplesmente continuar usando Opus.” — u/xtekno-id, alertando para a seleção descontrolada de modelos caros no contexto de uma equipe de engenharia.
Cinco medidas práticas ajudam a manter os custos previsíveis:
1. O sufixo :free não faz o que parece. openrouter/auto:free não limita o Auto Router a modelos gratuitos — ele ainda pode direcionar chamadas para modelos pagos. Se você precisa de roteamento sem custo, use openrouter/free, que restringe o conjunto apenas a endpoints da camada gratuita. Isso é confirmado pela central de ajuda do OpenRouter.
2. Combine cost_tier e allowed_models. Definir apenas cost_tier=low não impede que o roteador escolha um modelo caro para o seu volume de uso. Adicione allowed_models para limitar as famílias aceitas: ["deepseek/*", "google/*"] mantém você na faixa econômica para a maioria dos tipos de tarefa.
3. Use provider.max_price como limite rígido. Esse parâmetro filtra endpoints elegíveis por preço e estabelece um teto de custo por token que funciona independentemente da faixa escolhida pelo roteador.
4. Considere a taxa de plataforma de 5,5%. O OpenRouter cobra uma taxa de 5,5% na compra de créditos, com mínimo de $0.80, e não por token. Um depósito de $20 em créditos custa $21.10. A cobrança vale independentemente do uso do Auto Router: é a camada de monetização da plataforma, não uma tarifa pelo roteamento.
5. Atenção à persistência de sessão e ao custo de cache. Quando o roteador troca de modelo no meio de uma conversa, o cache de entrada precisa ser reconstruído, aumentando o custo em tokens. Para lidar com isso, existe a persistência de sessão: ele identifica conversas por um session_id explícito ou pela impressão digital das mensagens, reclassifica os candidatos a cada turno, mas prefere o modelo anterior quando ele continua entre os principais candidatos. Se a tarefa mudar de forma relevante, o roteador trocará de modelo — e você pagará o custo de reconstrução do cache.
Quando usar Auto Router e quando fixar um modelo
O Auto Router faz sentido para cargas de trabalho variáveis, com diferentes tipos de tarefa em momentos distintos e seleção manual de modelos se tornando um entrave. A matriz de roteamento serve como ponto de partida para entender em quais modelos a comunidade confia para cada categoria.
| Cenário | Recomendação |
|---|---|
| Cargas variáveis e uso geral | openrouter/auto com cost_tier=low |
| Produção em escala sensível a custos | Fixe modelos específicos ou use listas de fallback |
| Programação em múltiplos turnos com contexto | openrouter/auto com session_id para persistência |
| Precisa de qualidade de fronteira independentemente do custo | openrouter/auto com cost_tier=max |
| Exigência de custo zero | openrouter/free (não auto:free) |
| Quer atualizações de roteamento antes da versão estável | openrouter/auto-beta |
Para equipes de engenharia, o meio-termo prático é uma configuração restrita do auto-roteador: cost_tier ajustado à sua faixa de orçamento, allowed_models limitado aos fornecedores aprovados e provider.max_price como teto rígido.
Perguntas frequentes
O OpenRouter Auto Router tem custo adicional?
Não. Não há sobretaxa pelo uso do Auto Router. Você paga a tarifa padrão do modelo selecionado. A receita do OpenRouter vem da taxa de 5,5% cobrada na compra de créditos.
O openrouter/auto:free é realmente gratuito?
Não. O sufixo :free não restringe o roteamento a modelos gratuitos. Use openrouter/free, o roteador dedicado exclusivamente a opções gratuitas.
Posso limitar o Auto Router a provedores específicos?
Sim. Use o parâmetro allowed_models com padrões curinga, como ["anthropic/*", "openai/*"], no plugin auto-router.
Como descubro qual modelo foi selecionado?
Verifique o campo model na resposta da API. Ele contém o identificador do modelo que processou sua requisição, e não openrouter/auto.
Qual é a diferença entre auto e auto-beta?
openrouter/auto é o roteador estável. O openrouter/auto-beta recebe melhorias de roteamento antes de elas chegarem à versão estável.
O Auto Router oferece suporte a streaming e tool calling?
Sim. Todo o conjunto de recursos do modelo selecionado — streaming, tool calling e visão — fica disponível.