 AIREITER
Os dois endpoints de decisões anunciam o mesmo preço de US$ 0,10 por 1 milhão de tokens de entrada, mas um documento de política repetido pode custar US$ 520 em um e US$ 70 no outro. O OpenAI Decisions API se encaixa melhor em transcrições de agentes com contexto recorrente; o Gemini Decisions API leva vantagem quando entram áudio, vídeo e checklists com 1.000 regras.
Mesmo preço de US$ 0,10, contas diferentes
OpenAI Decisions API e Gemini Decisions API cobram US$ 0,10 por 1 milhão de tokens de entrada não armazenados em cache, sem cobrança por tokens de saída. O OpenAI Decisions API entrou em disponibilidade geral em 22 de outubro de 2026, no modelo gpt-6-luna. Já o Gemini Decisions API foi lançado em 11 de novembro de 2026, em v1beta e com o modelo gemini-decision-1. A opção mais barata depende da repetição e do tipo de entrada — não do logotipo.
| Dimensão | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Modelo | gpt-6-luna | gemini-decision-1 |
| Status | GA desde 22 de outubro de 2026 (documentação da OpenAI) | Preview v1beta desde 11 de novembro de 2026 (anúncio do Google) |
| Perguntas por requisição | 1–400 (documentação da OpenAI) | 1–1.000 (anúncio do Google) |
| Janela de contexto | Multiplicador de 2x para contexto longo acima de 272 mil tokens | 262.144 tokens |
| Entradas | Texto, imagens, input_json, conversas + chamadas de ferramentas | Texto, imagens, áudio, vídeo, PDF |
| Cobrança de saída | US$ 0 | US$ 0 |
| Entrada em cache | US$ 0,01 por 1 milhão de tokens, prefixo ≥1.024 tokens | Não é compatível |
| Nível gratuito | Nenhum nível gratuito separado informado | Sim, no AI Studio, 200 RPM / 50 mil TPM / 10 mil RPD |
| Latência publicada | Cerca de 10x mais rápido que a Responses API | 50–100 ms de processamento do modelo, 150–250 ms de ponta a ponta até 16 mil tokens |
| Empresarial | ZDR, HIPAA, regionalização nos EUA/UE (+10%) | Suporte via Cloud em breve |
Como uma requisição funciona na prática
O OpenAI Decisions API usa POST /v1/decisions com uma matriz ordenada de perguntas, cada uma com um name opcional. O Gemini Decisions API usa client.decisions.create() com um mapa indexado por IDs definidos pelo desenvolvedor. Os dois aceitam três tipos de pergunta, mas os nomes e limites não são iguais.
Os tipos de pergunta da OpenAI são predicate (probabilidade de 0 a 1), choice (categorias não ordenadas) e score (de 2 a 10, com média ponderada pela probabilidade), segundo o guia da OpenAI. No Gemini, os tipos são noul (sim/não, probabilidade de 0,01 a 0,99), choice (2–255 opções) e score (2–255 níveis, com 2–10 recomendado), conforme o anúncio do Google. As perguntas da mesma requisição são independentes nos dois serviços; lógica encadeada exige código na aplicação ou uma segunda chamada.
Três armadilhas que quebram migrações
O Gemini ordena alfabeticamente as chaves de choice antes de pontuar. Por isso, uma opção genérica chamada none_of_the_above pode aparecer antes de shipping (comportamento documentado). A OpenAI repete o name da pergunta na matriz de respostas; o Gemini devolve um mapa indexado pelo ID da pergunta. O noul do Gemini nunca retorna um valor acima de 0,99, então um limite >0.99 nunca é atingido.
O tratamento de recusas também muda. A OpenAI pode retornar uma refusal para uma pergunta e ainda responder às demais, segundo o guia da OpenAI. O Gemini rejeita a requisição inteira com HTTP 400 quando há gatilhos de segurança ou conteúdo proibido, usando códigos como safety e prohibited_content.
"Uma coisa estranha é que parece que Decisions e a geração normal de texto usam caminhos separados de cache e inferência." — u/Balance- no r/OpenAI
Se os dois endpoints precisarem ser suportados, planeje um adaptador fino. Normalize os IDs das perguntas, renomeie as chaves do Gemini para evitar surpresas na ordenação alfabética e limite os thresholds a ≤0,99 no Gemini.
O que cada serviço aceita — e o que você terá de construir
O Gemini Decisions API aceita texto, imagens, áudio, vídeo e PDFs nativamente em uma única entrada compartilhada. O OpenAI Decisions API aceita texto, imagens, input_json, histórico de conversas, chamadas de funções e saídas de ferramentas, mas não arquivos nem áudio. Essa diferença define se as etapas de pré-processamento desaparecem ou entram no projeto.
Uma gravação de chamada acompanhada de metadados da conta vai direto para o Gemini, sem transcrição. O mesmo vale para um PDF escaneado de sinistro com fotos dos danos, que dispensa OCR. Já uma transcrição de agente com chamadas de ferramentas funciona nativamente na OpenAI, com correspondência por call_id; no Gemini, essa transcrição precisa ser achatada em texto. A OpenAI também aceita imagens dentro de instructions da pergunta para comparações entre candidato e referência.
A contagem de tokens de imagem varia conforme o fornecedor. Em um teste independente e prático (System Design Academy), a foto de um ovo em 224×224 contou como 523 tokens de entrada na OpenAI com três perguntas, contra uma estimativa de 390 tokens no Gemini Low (257 tokens de imagem), 663 no Medium e 1.223 no High — ou US$ 0,039, US$ 0,066 e US$ 0,122 por 1.000 fotos.
As afirmações sobre latência são informadas pelos próprios fornecedores. O Google reporta 150–250 ms de ponta a ponta e crescimento quase estável de 1 a 100 perguntas, até 16 mil tokens. A OpenAI afirma ser cerca de 10x mais rápida que a Responses API, sem divulgar um número absoluto. Os relatos de usuários reais são variados:
"Velocidade e custo. As respostas são quase instantâneas e custam uma fração." — u/zyeus-guy no r/OpenAI
Testei o Gemini Decision 1 no nível gratuito: roteamento correto em 30/30 casos, mediana de ~0,24 s e repetições determinísticas, mas ele escolheu com confiança uma categoria errada quando "other" não estava disponível. — teste prático no r/GeminiAI
Use a latência informada pelos fornecedores como um teto a ser superado nos testes — não como um SLA de produção.
Quanto custam de verdade 1 milhão de requisições
A entrada compartilhada é cobrada uma vez por requisição nas duas APIs. Perguntas extras adicionam apenas tokens de instrução. A diferença aparece quando a entrada se repete entre requisições: a OpenAI usa cache, enquanto o Gemini cobra tudo novamente.
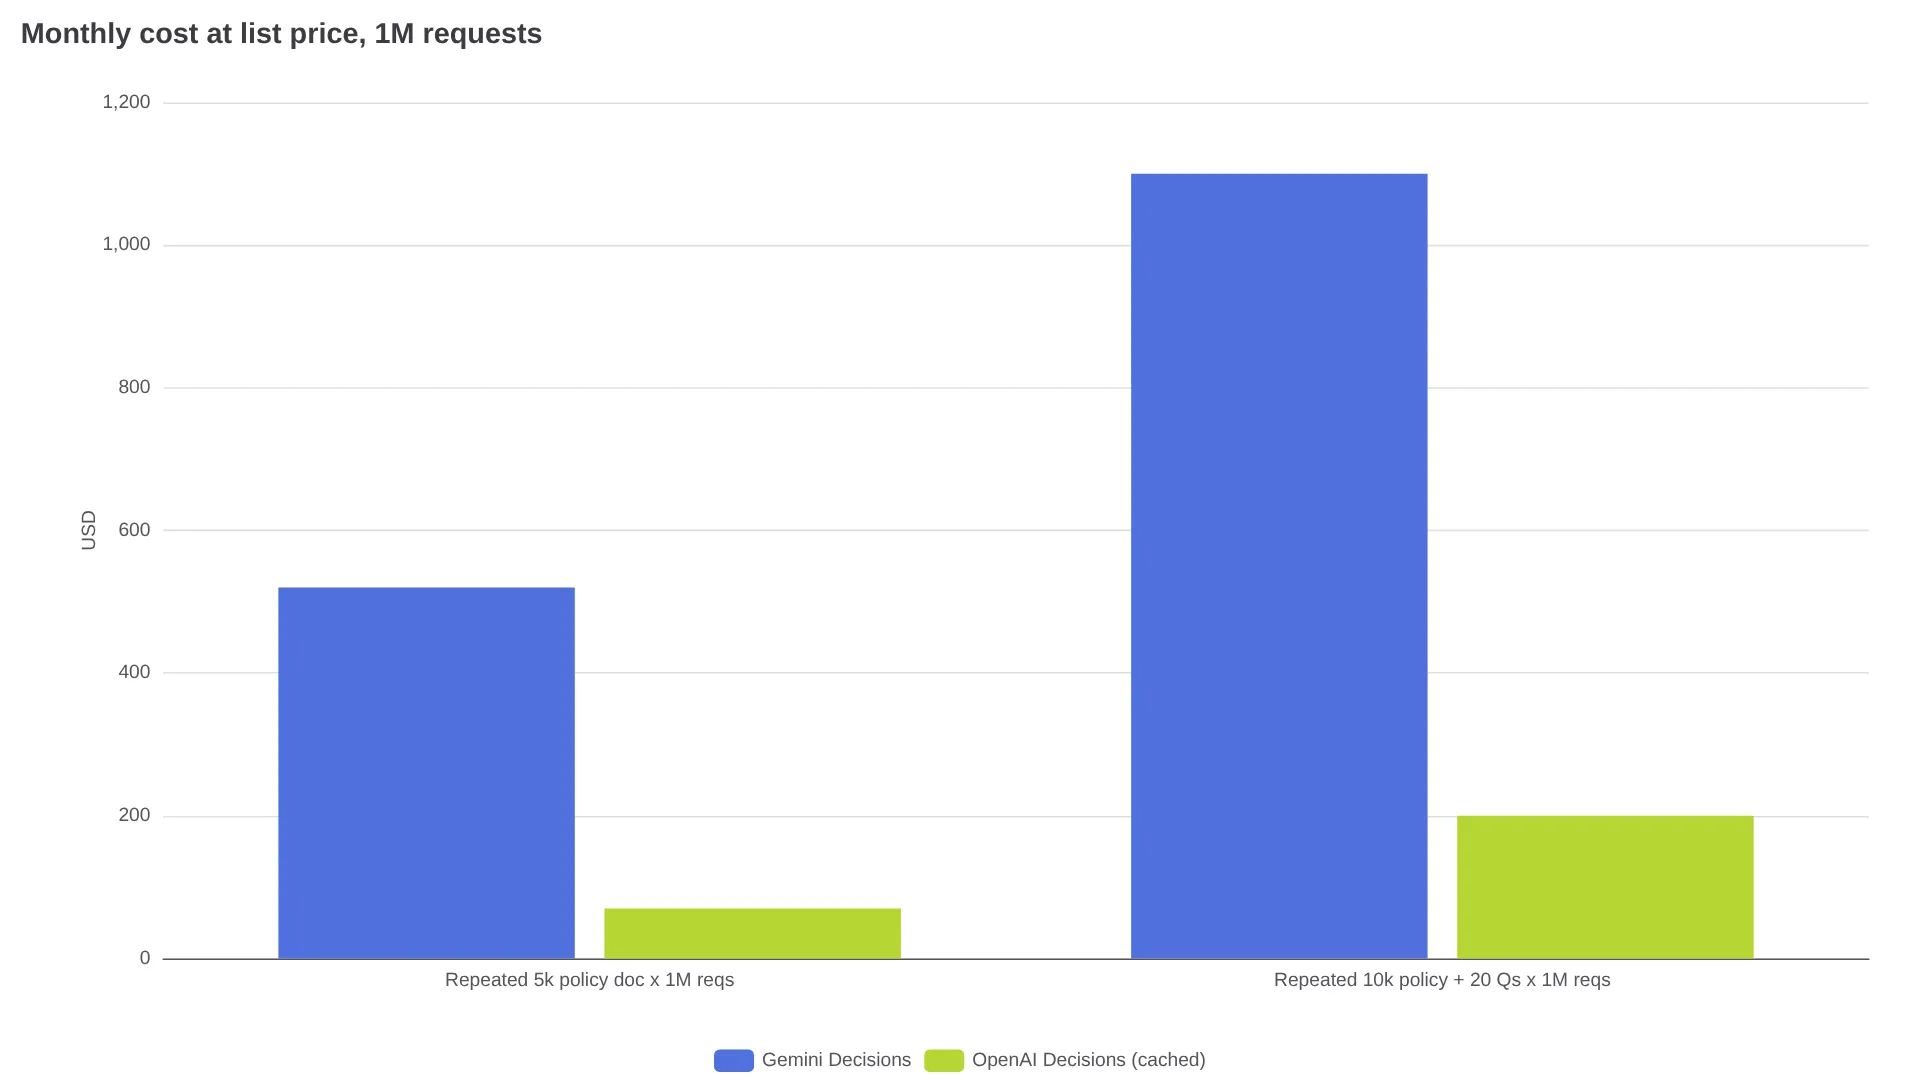
A conta ilustrativa com preços de tabela, seguindo o padrão publicado por Apidog e BaristaLabs, considera acertos de cache na OpenAI antes das cobranças de gravação do cache:
- 1 milhão de tickets com a mesma política de 5.000 tokens mais 200 tokens novos: cerca de US$ 520 no Gemini e US$ 70 na OpenAI com cache.
- 1 milhão de requisições com a mesma política de 10.000 tokens mais 20 perguntas de ~50 tokens: cerca de US$ 1.100 no Gemini e US$ 200 na OpenAI com cache, além das gravações.
Entradas novas e únicas eliminam a diferença: uma mensagem de 400 tokens sem prefixo reutilizável custa a mesma tarifa de US$ 0,10 por 1 milhão de tokens nos dois serviços. O agrupamento pesa mais que a escolha do modelo: uma requisição com 20 verificações em um registro de 4.000 tokens custa cerca de US$ 0,50 por 1.000 registros, enquanto 20 requisições separadas custam cerca de US$ 8,10.
Conversas longas, que relêem o histórico a cada turno, favorecem o cache. Em um modelo de roteador com 30 turnos e leitura de 124.680 tokens, o custo estimado é de cerca de US$ 12,47 por 1.000 chats no Gemini Decision 1 sem cache, contra cerca de US$ 6,31 em um modelo de chat com cache.
Dá para confiar no número retornado?
Na tabela divulgada pelo Google e resumida pelo AIToolsReview, o Decision 1 supera o Luna em todos os testes compartilhados, com ECE top-1 de 0,0250 contra 0,0721 do Luna e 0,0494 do Jev 1.14. No split público do JevBench, os resultados são 92,2% para o Decision 1, 90,9% para o Luna e 90,0% para o Jev 1.14. O custo total da suíte foi de US$ 0,88 para o Decision 1, US$ 0,68 para o Jev e US$ 0,93 para o Luna.
Um compilado independente da Artificial Analysis, citado na mesma avaliação, dá ao Decision 1 um Decision Index de 66, empatado com o Jev 1.14 e em 9º lugar entre 18 modelos — cerca de 7 pontos atrás do Drex Max v1.1. No When2Call, os resultados são 75,2% para o Decision 1, 80,8% para o Jev e 94,6% para o Drex Max, a US$ 345 por 1 milhão de tarefas e 211 ms no Decision 1, contra US$ 156 e 92 ms no Jev.
Para automações baseadas em threshold, a calibração é mais importante que a acurácia de manchete. Uma confiança de 0,90 deveria estar correta cerca de 9 vezes em 10 na distribuição de produção. Valide os thresholds com 200–500 casos rotulados e meça a acurácia por faixa de confiança.
"Confiança: probabilidades calibradas no estilo Jev não são algo que todo endpoint compatível com a OpenAI oferece." — u/xapep no r/LLMDevs
Dois padrões de falha aparecem com frequência. Testes iniciais de profissionais relatam viés pela primeira opção na OpenAI (@NatashaTheRobot), enquanto o teste prático do Gemini acima mostra que, sem uma opção genérica, o modelo escolhe a alternativa menos ruim em vez de se abster. Corrija os dois problemas com uma opção other, um predicado separado de verificação de escopo, descrições curtas e distintas e revisão humana abaixo do threshold.
Checklist de produção antes do lançamento
A OpenAI está em GA, oferece cache, relatório de uso em GET /v1/organization/usage/decisions, ZDR e HIPAA para clientes elegíveis, além de processamento regional nos EUA/UE com acréscimo de 10%. O Gemini está em v1beta, com suporte via Cloud previsto para breve. Os dois fornecedores listam integrações com frameworks como OpenRouter, LangChain, Vercel e LiteLLM.
As regras de cache definem a arquitetura. A OpenAI reutiliza um prefixo de entrada compartilhado com pelo menos 1.024 tokens; o conteúdo das perguntas não entra nesse mínimo. O Gemini não oferece cache de contexto nem níveis Batch, Flex ou Priority. Para prototipagem gratuita, o Gemini é mais atraente, mas o conteúdo do nível gratuito pode ser usado para melhorar produtos do Google. Portanto, mantenha dados reais de clientes em chaves pagas. Antes de automatizar ações de alto risco, registre a distribuição de confiança durante uma semana.
Escolha pela carga de trabalho, não pelo logotipo
Um fluxo de agente com chamadas de ferramentas e instruções repetidas aponta para o OpenAI Decisions API. Requisitos de ZDR, HIPAA ou residência de dados na UE também favorecem a OpenAI.
Gravação de chamada, clipe de vídeo ou PDF escaneado com centenas de verificações apontam para o Gemini Decisions API. A entrada nativa de áudio, vídeo e PDF elimina as etapas de transcrição e OCR, enquanto 1.000 perguntas por requisição atendem listas de regras acima de 400. Limites de orçamento: 100 MB em linha por requisição, 50 MB por PDF e 15 MB por URL externa.
Texto curto e único com menos de 400 perguntas resulta em empate no preço de tabela. Faça o protótipo no nível gratuito do Gemini com dados sintéticos e depois rode os mesmos 200–500 casos rotulados nos dois serviços. Compare a acurácia por faixa, a latência p50/p95, os tokens por requisição e o custo mensal.
| Carga de trabalho | Escolha |
|---|---|
| Documento de política repetido de 5 mil–10 mil tokens, QPS alto | OpenAI Decisions API, o cache economiza 80%+ |
| Roteamento de agentes com histórico de chamadas de ferramentas, voz GPT-Live | OpenAI Decisions API |
| Decisões com áudio / vídeo / PDF, >400 regras | Gemini Decisions API |
| Texto curto e único, <400 perguntas | Empate — escolha a stack já adotada |
| Prototipagem gratuita | Gemini AI Studio; depois reavalie no plano pago |
O Gemini é mais barato que a OpenAI?
O preço de tabela empata em US$ 0,10 por 1 milhão de tokens, sem cobrança de saída; a OpenAI ganha com contexto repetido em cache, enquanto o Gemini ganha na prototipagem gratuita.
A OpenAI consegue ler áudio, vídeo ou PDFs?
Não. Ela aceita apenas texto, imagens, JSON e conversas com chamadas de ferramentas; o Gemini processa áudio, vídeo e PDFs nativamente.
Quantas perguntas cabem em uma requisição?
O Gemini aceita 1–1.000 perguntas dentro de 262.144 tokens; a OpenAI aceita 1–400.
O Gemini está pronto para produção?
O Gemini está em v1beta, com suporte via Cloud pendente; a OpenAI está em GA, com ZDR, HIPAA e processamento regional.
Ainda preciso do Jev ou de um classificador local?
O Jev anuncia US$ 0,042 por 1 milhão de tokens e lidera alguns testes de seleção de ferramentas; inclua-o no benchmark quando o custo por tarefa for determinante.
Como lidar com baixa confiança?
Defina os thresholds com dados rotulados, execute automaticamente acima do limite, encaminhe a faixa intermediária para um modelo maior e bloqueie para revisão humana, sempre com uma opção other.
Leituras relacionadas: