 AIREITER
O Google lançou a Gemini Decisions API em 11 de novembro de 2026. A proposta do Gemini Decision 1 é avaliar opções predefinidas em uma única chamada — mas são os detalhes do cache que determinam se ele realmente sai na frente da OpenAI no seu caso.
Quanto custa uma chamada da Gemini Decisions API
A Gemini Decisions API custa US$ 0,10 por 1 milhão de tokens de entrada, sem cobrança por tokens de saída. O bloco multimodal compartilhado é cobrado uma única vez por solicitação, independentemente da quantidade de perguntas avaliadas. Cada pergunta adicional acrescenta apenas seus próprios tokens de instruções e critérios.
O Google posiciona o Gemini Decision 1 como quase 5 vezes mais barato em uma suíte de benchmarks compartilhada do que o Gemini 3.5 Flash-Lite usando a Interactions API. Não há cobrança por tokens de saída, custos variáveis de tokens de raciocínio nem taxas separadas para transcrição de áudio ou OCR. Para protótipos, o Google AI Studio oferece uma camada gratuita da API.
| Carga de trabalho (500 tokens de entrada cobrados por solicitação) | Solicitações mensais | Tokens de entrada | Custo a US$ 0,10/1M |
|---|---|---|---|
| Roteamento de intenção em suporte | 10.000 | 5M | US$ 0,50 |
| Filtro de moderação | 100.000 | 50M | US$ 5,00 |
| Camada de seleção de ferramentas de agentes | 1.000.000 | 500M | US$ 50,00 |
A fórmula é requests x average billed input tokens / 1,000,000 x $0.10. Como as evidências compartilhadas são cobradas uma só vez, colocar 50 verificações independentes sobre o mesmo chamado em uma única solicitação adiciona apenas os tokens específicos de cada pergunta. A economia vem do agrupamento, não de um desconto por pergunta.
O que o Gemini Decision 1 consegue avaliar
O Gemini Decision 1 (ID do modelo gemini-decision-1) é um classificador e avaliador desenvolvido para essa finalidade, não um modelo de chat. Uma solicitação pode levar uma entrada multimodal compartilhada de até 256 mil tokens e até 1.000 perguntas independentes. Cada resposta retorna probabilidades acompanhadas de um índice de confiança entre 0 e 1.
As modalidades de entrada incluem texto, imagens, áudio, vídeo e PDFs em um único bloco compartilhado, usando o mesmo formato de bloco Content da Interactions API. Imagens e vídeos aceitam resolução ajustável, portanto reduzir a resolução das evidências antes do upload controla diretamente o custo em tokens. Os três tipos de pergunta podem ser combinados na mesma chamada:
| Tipo | Formato | Retorno | Bom para |
|---|---|---|---|
noul (sim/não) | Uma condição com descrições opcionais para verdadeiro e falso | Probabilidade de a condição ser verdadeira | Verificações de políticas, detecção de derramamentos, filtros de relevância |
choice (múltipla escolha) | De 2 a 255 opções nomeadas com critérios | Opção vencedora e probabilidades normalizadas por candidato | Roteamento de modelos, roteamento de filas, seleção da próxima ação |
score (rubrica ordenada) | Níveis ordenados começando em 0 | Pontuação ponderada contínua e probabilidades por nível | Gravidade, urgência, qualidade do lead |
O Google informa 50–100 ms de computação mediana do modelo e latência de ponta a ponta de 150–250 ms, medidos em entradas multimodais e contextos de até 16 mil tokens. Segundo a empresa, esses números permanecem quase estáveis de 1 a 100 perguntas por solicitação. Em benchmarks que cobrem roteamento de agentes, raciocínio, classificação e compreensão multimodal, o Google afirma que o Gemini Decision 1 lidera a suíte com o menor erro de calibração. Até que existam números independentes, trate as duas afirmações como benchmarks do próprio fornecedor.
Gemini contra a OpenAI Decisions API
A comparação mais próxima é com a Decisions API da OpenAI, lançada algumas semanas antes pelo mesmo preço principal. A Gemini Decisions API iguala a OpenAI em US$ 0,10 por 1 milhão de tokens de entrada, com saídas tipadas gratuitas, mas se distancia em capacidade, modalidades e cache.
| Dimensão | Gemini Decisions API | OpenAI Decisions API |
|---|---|---|
| Modelo | gemini-decision-1 | Classe gpt-6-luna |
| Preço principal | US$ 0,10 / 1M de entrada, US$ 0 de saída | US$ 0,10 / 1M de entrada, US$ 0 de saída |
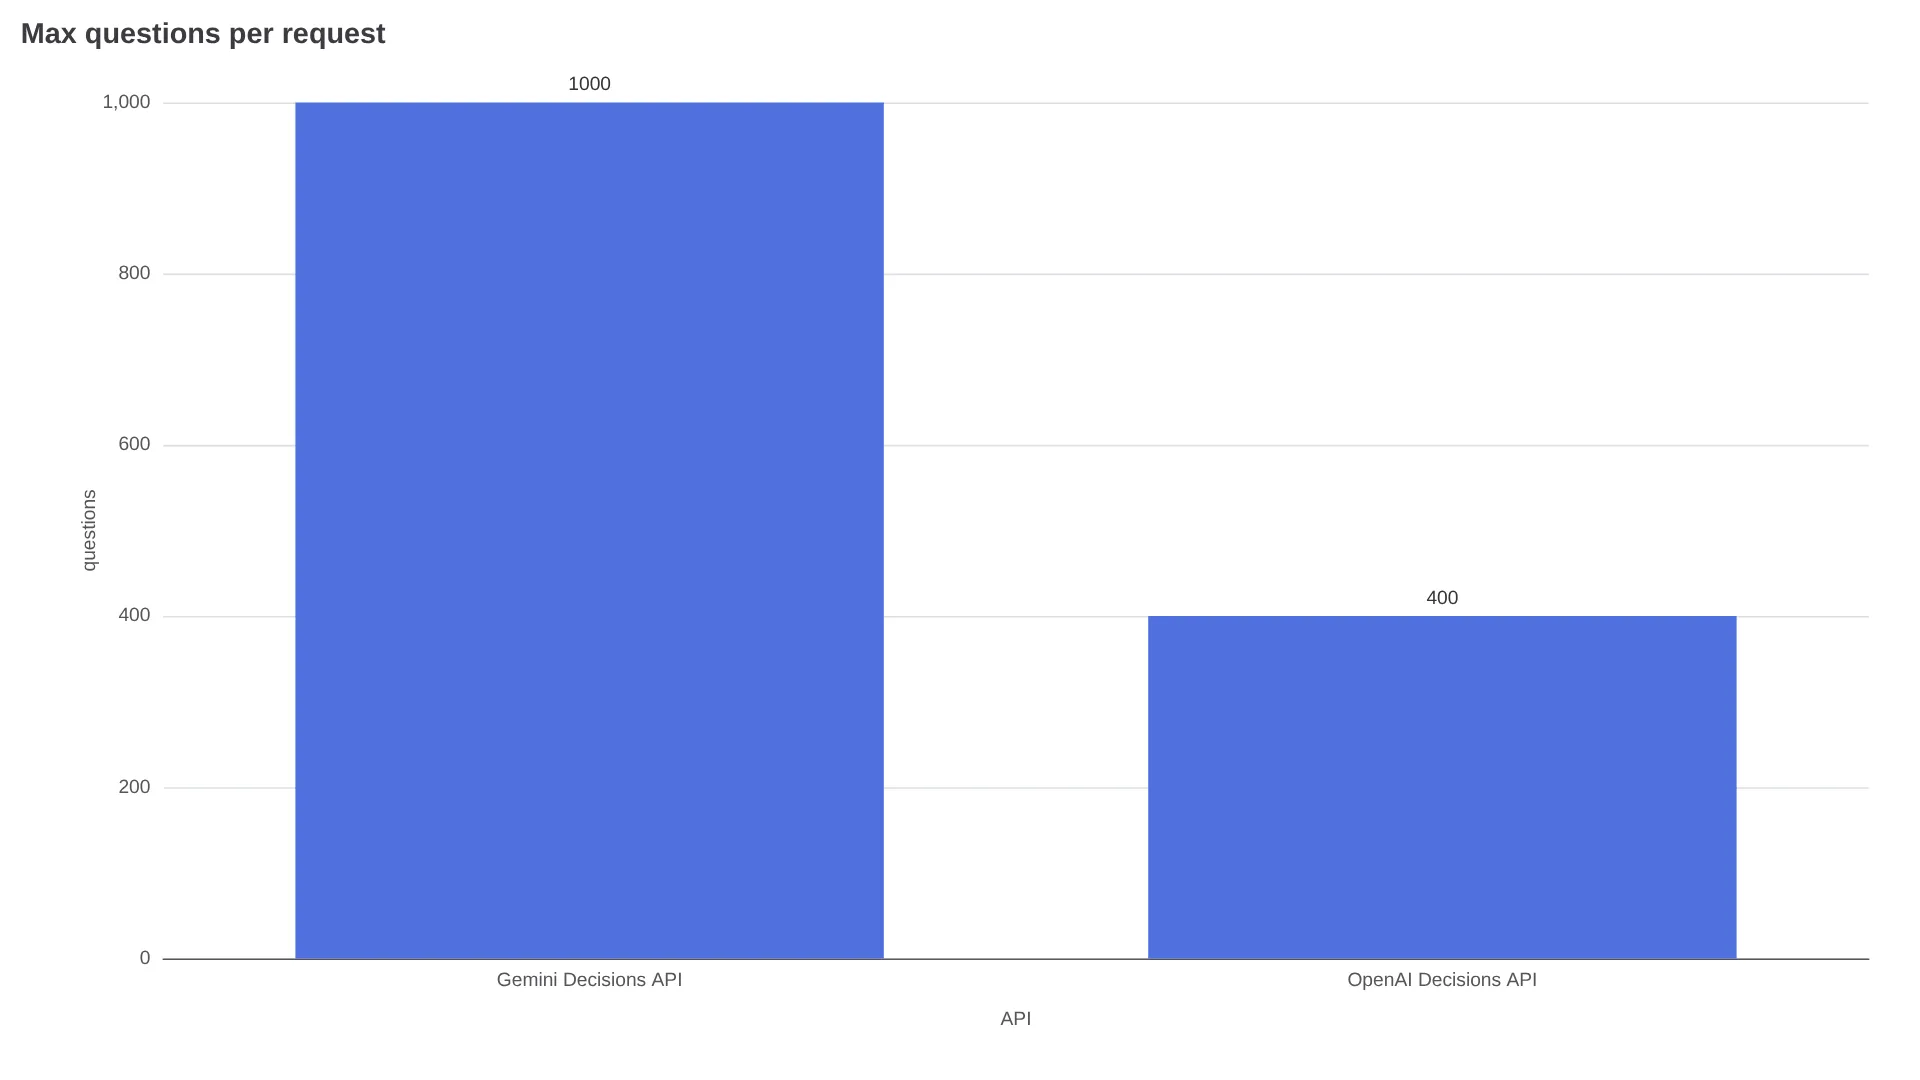
| Máximo de perguntas por solicitação | 1.000 | 400 |
| Tipos de pergunta | sim/não, escolha (2–255), pontuação por rubrica | predicado, escolha, pontuação (2–10 níveis) |
| Modalidades de entrada | Texto, imagens, áudio, vídeo e PDFs (contexto de 256K) | Texto, imagens (URLs, base64), JSON nativo, histórico da conversa e saídas de ferramentas; sem áudio ou arquivos |
| Afirmação sobre latência | 150–250 ms de ponta a ponta, 50–100 ms de computação do modelo | Cerca de 10 vezes mais rápida que a Responses (sem p50/p95 publicado) |
| Cache de prompt | Não anunciado na publicação de lançamento | Sim: prefixo mínimo de 1.024 tokens, US$ 0,01/1M para leituras em cache |
| Camada gratuita | Sim, camada gratuita no AI Studio | Nenhuma camada gratuita dedicada documentada |
| Relatórios | Uso padrão da Gemini API | GET /v1/organization/usage/decisions com chave de administrador |
A coluna do Gemini segue a publicação de lançamento do Google; a coluna da OpenAI segue o guia de preços da OpenAI Decisions API da AIReiter, que cita a documentação oficial da OpenAI.
A tabela deixa três conclusões práticas.
- Escolha a Gemini Decisions API quando as evidências forem multimodais. É possível combinar uma gravação de chamada com metadados da conta ou um PDF escaneado de sinistro com fotos dos danos em uma única passagem; com a OpenAI, em geral seria necessário fazer um pré-processamento separado.
- Ela também é a melhor opção para uma grande quantidade de verificações paralelas. Com 1.000 perguntas independentes por solicitação, contra 400, um único chamado pode incluir intenção de reembolso, roteamento para o departamento, avaliação de urgência e dezenas de predicados de política sem uma segunda viagem até a API.
- A OpenAI mantém uma vantagem em políticas compartilhadas extensas. O cache de prefixos reduz o custo para US$ 0,01/1M, algo relevante quando cada solicitação reenvia um documento de política com 5.000 tokens e as perguntas são curtas.
Onde a Gemini Decisions API se encaixa em produção
Segundo o anúncio de lançamento, o Google usa o endpoint no Notebook para roteamento, no Stitch para wireframes, no CC para escolher emojis e na Busca para segurança de MCP. O padrão é sempre um bloco de evidências compartilhado combinado com várias opções limitadas, enquanto o código usa a confiança retornada para decidir o próximo passo. É justamente nesse ponto que um engenheiro recomenda cautela:
"O preço baixo não é o ponto; o importante é restringir o espaço de saída. Confiança não é precisão, então calibre o sistema com amostras reais do negócio e defina limites de abstenção antes de colocá-lo em produção." — @david1989_zhu (traduzido do chinês)
Monte um conjunto rotulado a partir da carga de trabalho real, incluindo casos ambíguos, trace as taxas de falsos positivos e falsos negativos em diferentes limites e encaminhe explicitamente os resultados de baixa confiança para revisão humana. Tarefas fora do contrato da API — extração aberta, geração de explicações e chamadas de ferramentas que precisam de argumentos — continuam sendo mais adequadas para a Interactions API, a Responses API ou function calling.
Como chamar o Gemini Decision 1
O endpoint está disponível pela Gemini API no Google AI Studio com o modelo gemini-decision-1, usando client.decisions.create nos SDKs google-genai. Há guias para Python, JavaScript e REST na documentação da Decisions API. O exemplo oficial do balcão da sala de descanso verifica uma foto e uma observação em texto usando os três tipos de pergunta em uma única solicitação:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "image", "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg", "mime_type": "image/jpeg"},
        {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."},
    ],
    questions={
        "has_spill": {"type": "noul", "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice", "instructions": "Which cleanup action fits the scene?",
            "criteria": {"wipe_with_cloth": "Small counter spill with cloth nearby.",
                         "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                         "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score", "instructions": "Rate the severity of the counter mess.",
            "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
print(result)
O Google lista integrações com OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit e OpenCode, com suporte ao Google Cloud previsto para breve. Para quem já desenvolveu usando o endpoint da OpenAI, a estratégia é simples: migre primeiro os filtros multimodais e as cargas com muitas verificações paralelas, mantenha na OpenAI os fluxos com políticas longas em que os descontos de cache se aplicam e recalibre os limites do zero. As escalas de confiança não são diretamente transferíveis entre fornecedores.
| Sua carga de trabalho | Use isto |
|---|---|
| Classificar, rotear ou pontuar com opções fixas | Gemini Decisions API |
| As evidências incluem áudio, vídeo ou PDFs | Gemini Decisions API |
| Mais de 400 verificações independentes por item | Gemini Decisions API |
| Política compartilhada longa reenviada a cada chamada | Teste primeiro as leituras em cache da OpenAI |
| É preciso explicar, extrair dados ou gerar argumentos para ferramentas | Interactions / Responses / function calling |
| Ação destrutiva ou relacionada à conformidade | Use Decisions apenas como filtro, com revisão humana |
Existe uma camada gratuita para a Gemini Decisions API?
Sim. O Google AI Studio oferece uma camada gratuita para protótipos.
A Gemini Decisions API oferece cache de prompt?
Nenhuma opção de cache aparece na publicação de lançamento até 12 de novembro de 2026.
Quantas perguntas cabem em uma solicitação da Gemini Decisions API?
Até 1.000 perguntas independentes sobre uma única entrada compartilhada de até 256 mil tokens.
Qual latência devo considerar no orçamento do código de produção?
Considere 250 ms de ponta a ponta até medir o p95 da sua própria região.
Ainda preciso da Interactions API?
Sim, para compor textos, extrair campos arbitrários, explicar decisões ou produzir argumentos para ferramentas.