 AIREITER
Uma decisão de roteamento com 500 tokens custa US$ 0,00005 na tarifa padrão. Isso torna a Decisions API da OpenAI barata o suficiente para operações de alto volume, mas não significa que ela seja automaticamente segura para ações de alto impacto: as probabilidades ainda precisam ser calibradas com dados rotulados do seu próprio cenário.
A cobrança começa em frações de centavo, não em uma tarifa por chamada
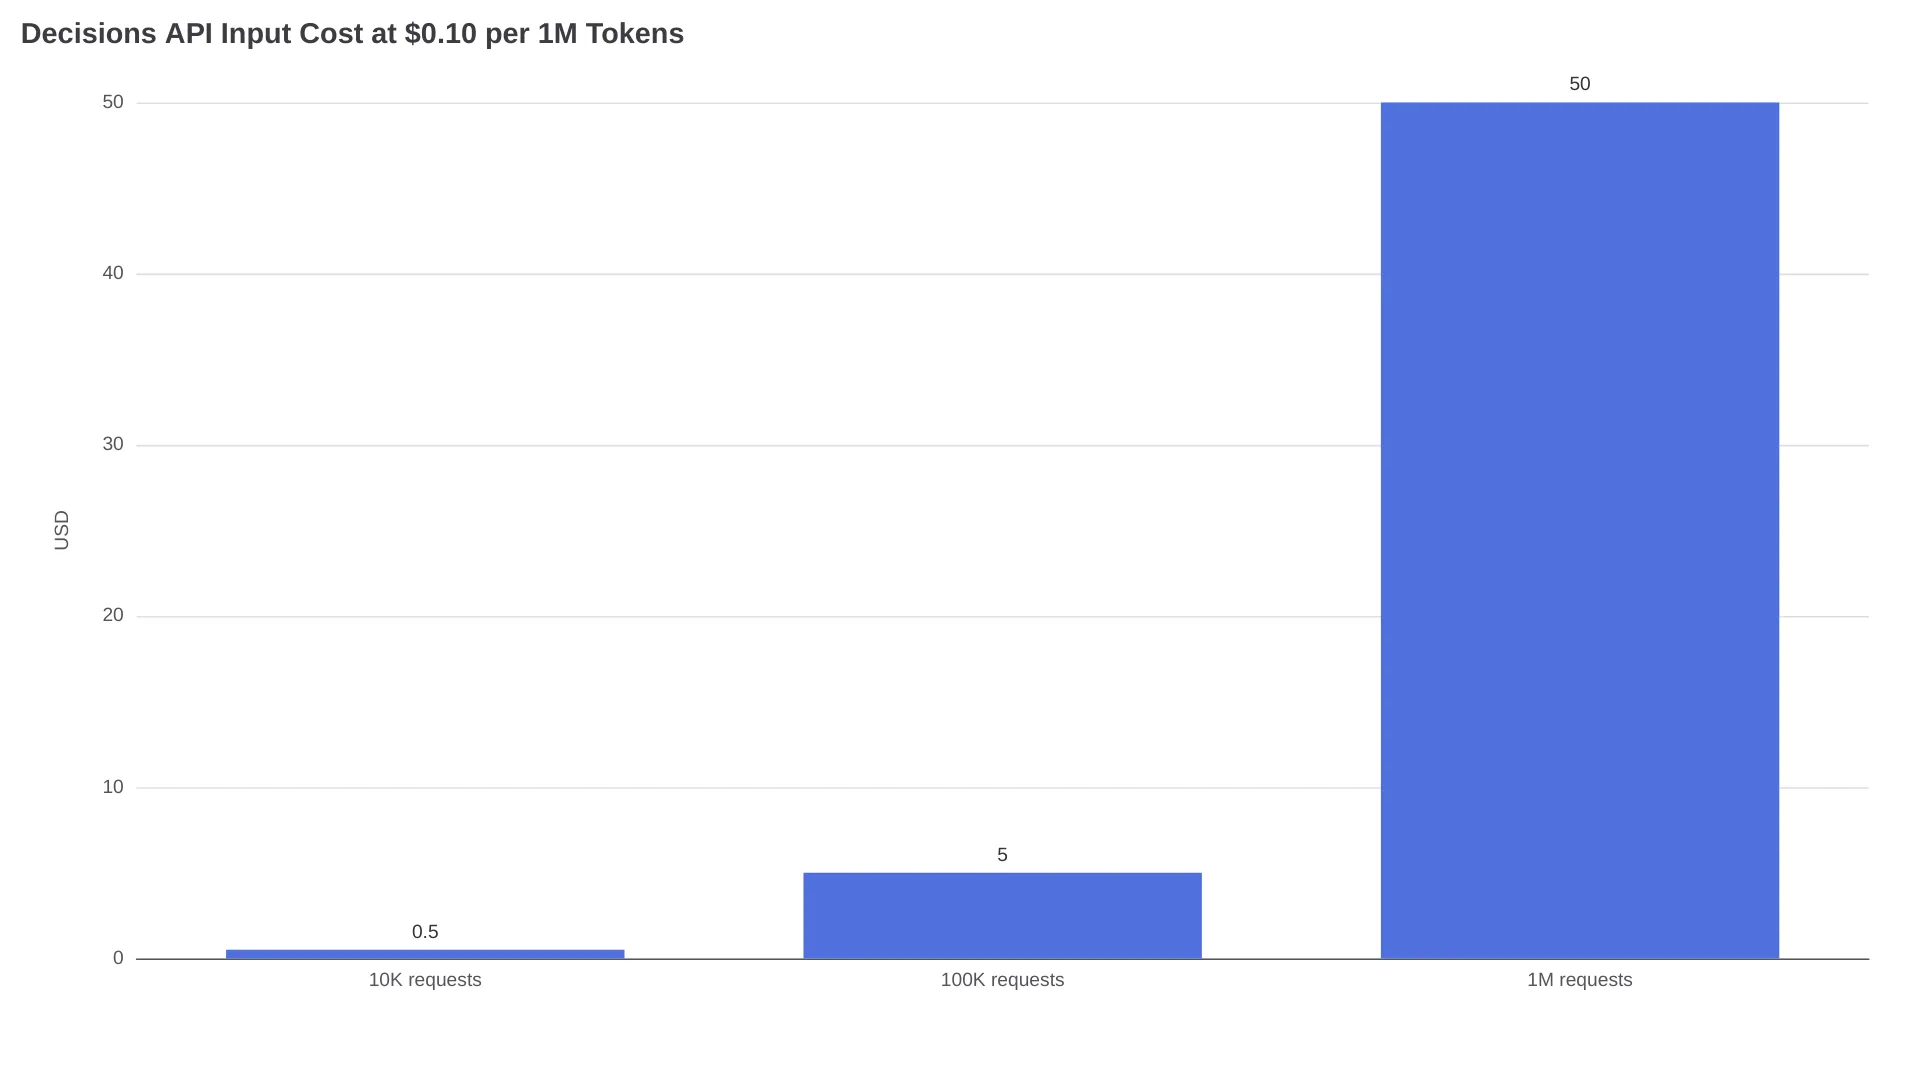
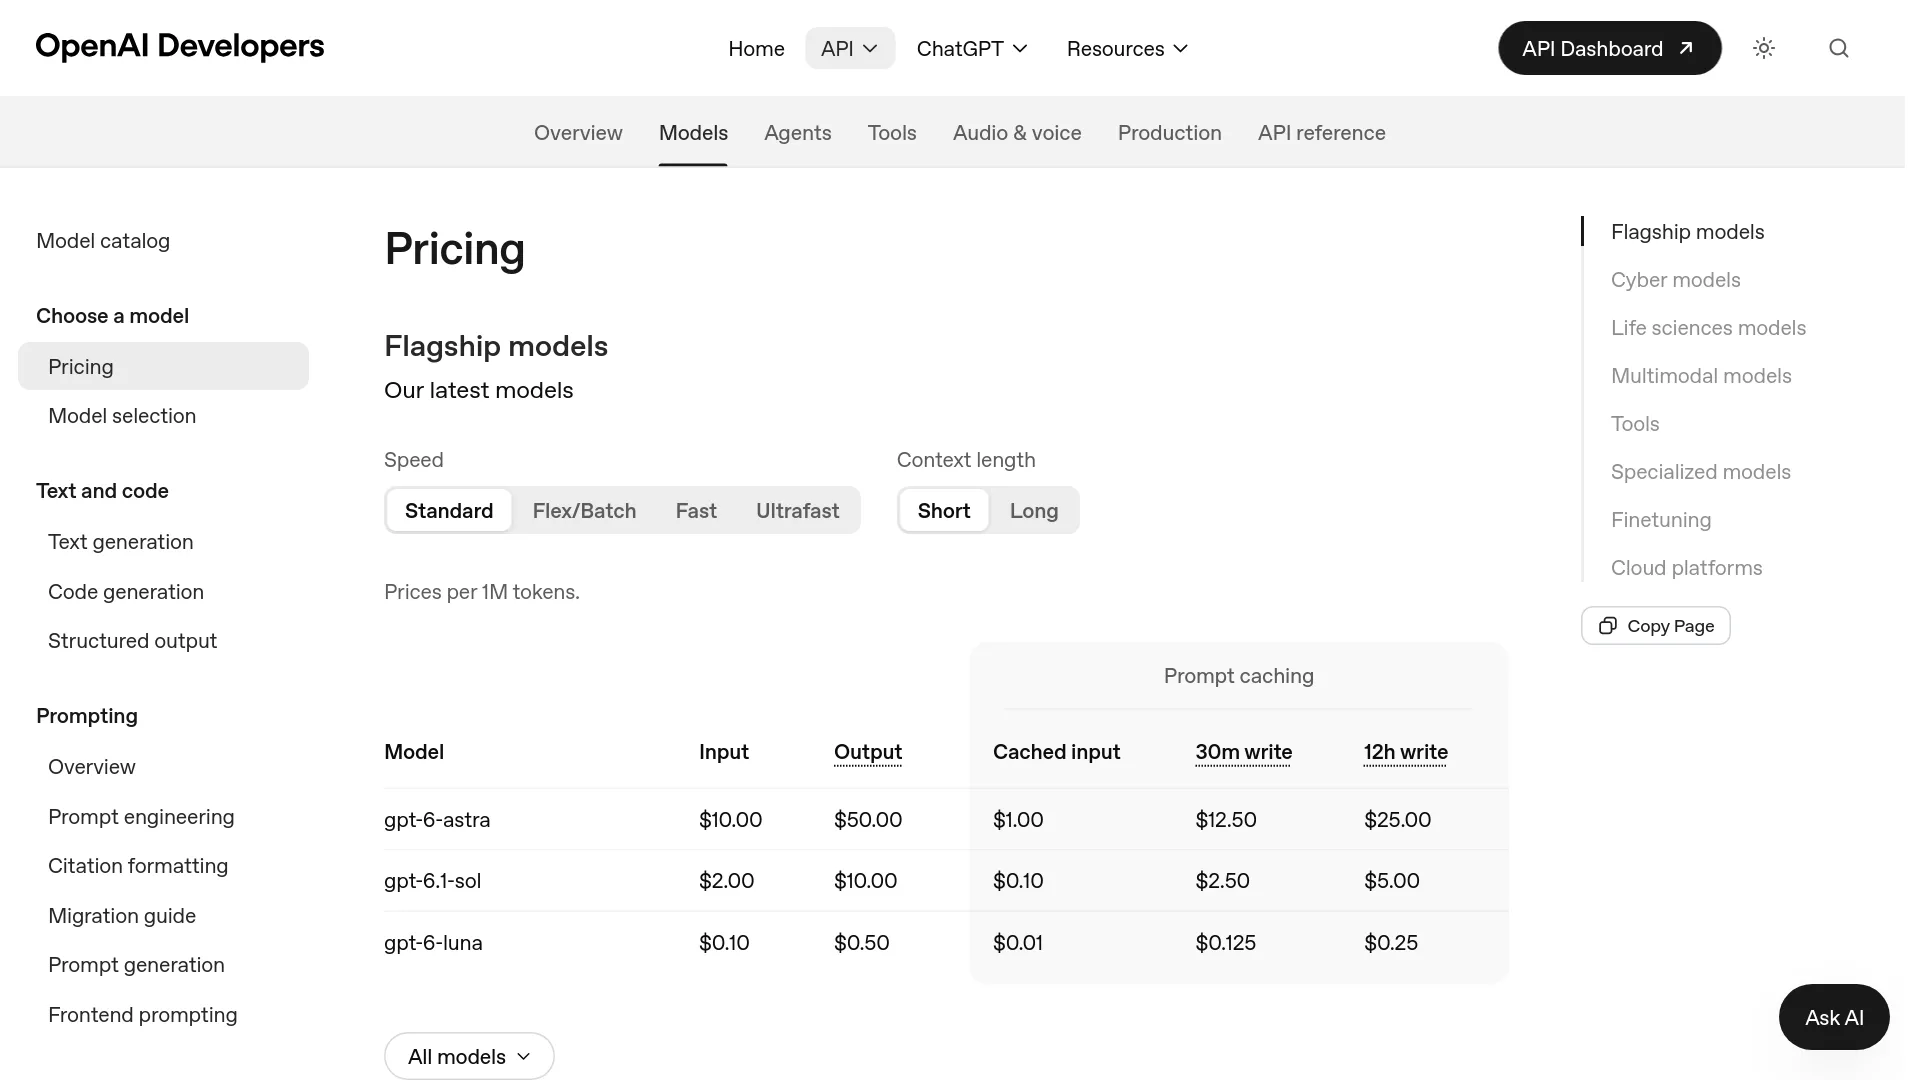
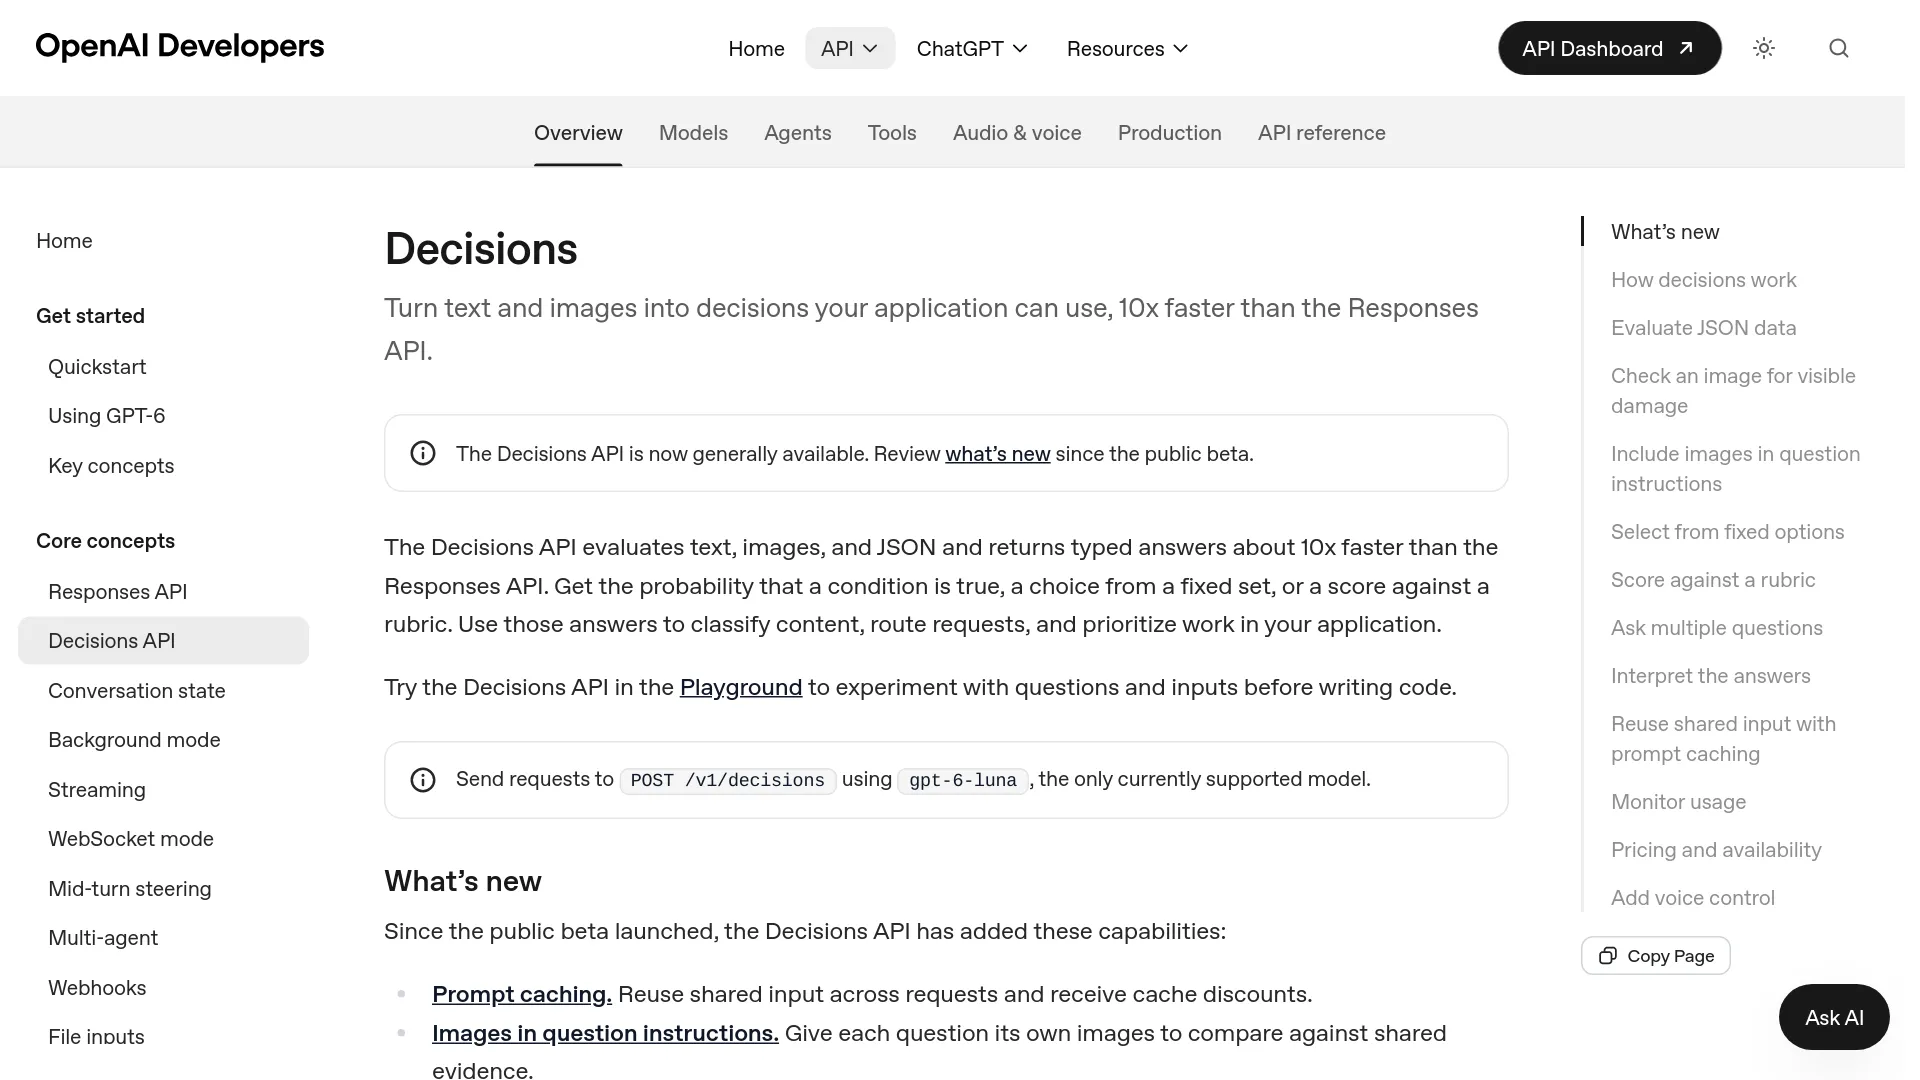
O preço da Decisions API da OpenAI é de US$ 0,10 por 1 milhão de tokens de entrada não armazenados em cache, enquanto os tokens de saída são gratuitos. A OpenAI agora descreve o endpoint como disponível para uso geral, operando exclusivamente com o gpt-6-luna e acessível em POST /v1/decisions, conforme o guia atual da Decisions.
Não há uma tarifa separada por requisição na tabela de preços publicada. A fórmula básica é:
monthly cost = requests × average billed input tokens ÷ 1,000,000 × $0.10
Exemplos de custo com 10 mil, 100 mil e 1 milhão de requisições
Considerando uma média de 500 tokens de entrada por requisição:
| Requisições mensais | Tokens de entrada | Custo padrão de entrada | Custo por requisição |
|---|---|---|---|
| 10.000 | 5 milhões | US$ 0,50 | US$ 0,00005 |
| 100.000 | 50 milhões | US$ 5,00 | US$ 0,00005 |
| 1.000.000 | 500 milhões | US$ 50,00 | US$ 0,00005 |
Os resultados de predicado, escolha e pontuação não geram cobrança adicional por tokens de saída. Já um JSON equivalente produzido pela Responses é gerado e cobrado pela tarifa de saída do modelo; a tabela de preços da OpenAI informa US$ 0,50 por milhão de tokens de saída para o gpt-6-luna na tarifa padrão.
Leituras e gravações de cache, processamento regional e contexto longo
Os US$ 0,10 anunciados como referência não são a única tarifa possível para a entrada. O guia atual informa que as leituras do prompt em cache têm preço reduzido, enquanto as gravações usam as tarifas padrão de gravação em cache do gpt-6-luna. O cartão de preços da OpenAI lista a entrada em cache padrão do Luna a US$ 0,01 por milhão de tokens, a gravação em cache de 30 minutos a US$ 0,125 e a gravação de 12 horas a US$ 0,25 por milhão de tokens.
O cache só começa a ser usado quando o prefixo compartilhado reutilizável tem pelo menos 1.024 tokens. As perguntas não entram nessa contagem mínima, e as imagens específicas de cada pergunta ficam fora do prefixo reutilizável. As leituras e gravações de cache já aparecem em usage.input_tokens; somá-las novamente causaria uma contagem duplicada, segundo a seção sobre cache de prompts.
Endpoints regionais ou com residência de dados podem acrescentar um adicional de 10% para modelos mais novos elegíveis. A seção oficial de preços e disponibilidade também alerta que multiplicadores de contexto longo podem ser aplicados. Consulte a tabela de preços atual antes de fechar uma carga de trabalho sujeita a requisitos de conformidade, pois os dois modificadores podem alterar o cálculo simples de US$ 0,10.
O endpoint foi projetado para ser específico
A Decisions API transforma evidências em um de três resultados tipados. Ela funciona como classificador e avaliador, não como uma versão mais barata de um endpoint de respostas de uso geral.
| Tipo de pergunta | Retorno | Boa aplicação | Má aplicação |
|---|---|---|---|
predicate | Probabilidade de 0 a 1 | Filtro contra fraude, verificação de dano visível, filtro de relevância | Uma justificativa escrita para a decisão |
choice | Uma opção fornecida, probabilidades das opções e confiança | Roteamento de fila, categoria de documento, próxima ação | Uma categoria desconhecida ou gerada dinamicamente |
score | Pontuação ponderada, probabilidades dos níveis e confiança | Gravidade, urgência, qualidade do lead | Extração de nomes, datas ou campos arbitrários |
Uma pontuação aceita de 2 a 10 níveis ordenados. Uma requisição pode conter de 1 a 400 perguntas, mas apenas perguntas independentes devem compartilhar a mesma requisição. Se a segunda pergunta depender da resposta da primeira, a OpenAI recomenda fazer uma nova chamada depois de receber a primeira resposta.
Várias perguntas independentes podem reutilizar as mesmas evidências. Um único chamado de suporte, por exemplo, pode ser analisado quanto à intenção de pedir reembolso, encaminhado ao departamento correto e avaliado por urgência sem que o chamado seja reenviado três vezes. O guia de uso informa que num_model_requests contabiliza a requisição, não a quantidade de perguntas.
O que mudou depois do beta público
A lista atual de novidades substitui várias limitações da época do lançamento:
- O limite de perguntas passou de 200 para 400.
- O cache de prompts está disponível para entradas compartilhadas.
- As entradas podem incluir JSON nativo, histórico de conversa, registros de chamadas de função e saídas de ferramentas correspondentes.
- As imagens podem usar URLs públicas HTTP/HTTPS ou base64 embutido;
file_id, áudio, arquivos e referências a itens continuam sem suporte. - Os relatórios da organização estão disponíveis em
GET /v1/organization/usage/decisions; o endpoint exige uma chave de administrador comapi.usage.reade pode agrupar os resultados por projeto, chave de API ou modelo.
Escolha entre Decisions e Responses pelo formato da saída
Use a Decisions API quando o código da aplicação já souber qual é o formato permitido da resposta. Prefira a Responses quando o modelo precisar compor informações e use chamadas de função quando ele tiver de escolher uma ferramenta e fornecer seus argumentos.
| Necessidade | Melhor opção padrão | Motivo |
|---|---|---|
| Regra de sim/não com probabilidade | Decisions | Saída nativa de predicado; sem cobrança por resposta gerada |
| Escolher uma rota conhecida | Decisions | Retorna a probabilidade de cada opção e o nível de confiança |
| Classificar segundo uma régua ordenada | Decisions | Pontuação ponderada nativa e distribuição entre níveis |
| Retornar campos JSON arbitrários | Responses com Structured Outputs | A Decisions não oferece um esquema JSON de saída personalizado |
| Explicar por que um item foi rejeitado | Responses | A Decisions não gera explicações em prosa |
| Escolher uma ferramenta e criar argumentos | Function calling | A Decisions seleciona uma resposta, mas não produz argumentos de ferramentas |
Com 100.000 chamadas e 400 tokens de entrada em cada uma, a entrada pela Decisions custa US$ 4. Se uma chamada equivalente à Responses gerar 30 tokens de saída por requisição, as tarifas publicadas do Luna resultam em US$ 4 de entrada mais US$ 1,50 de saída, ou US$ 5,50 antes de considerar tokens de raciocínio. A escolha do endpoint ainda depende de a aplicação precisar de campos gerados ou explicações.
Os dois endpoints agora oferecem leituras de cache com desconto. Meça os tokens atingidos pelo cache diretamente no objeto de uso da resposta, em vez de estimá-los pelo tamanho do prompt.
Erros baratos também podem custar caro
Uma fatura baixa de tokens não reduz o impacto de uma aprovação indevida, de uma ação de moderação equivocada ou do encaminhamento incorreto de um pagamento. O guia da OpenAI sobre interpretação das respostas recomenda definir limites usando exemplos rotulados e ponderar os custos diferentes de falsos positivos e falsos negativos.
Essa preocupação também aparece nas discussões entre desenvolvedores. Em uma conversa no Reddit sobre APIs de decisão voltadas à produção, u/Ctbhatia escreveu:
“é melhor um gate que manda pular do que um que chuta e erra.” Fonte: u/Ctbhatia no r/LLMDevs
A confiança e as probabilidades da API são sinais, não uma garantia publicada de calibração. Um resultado com confiança de 0,90 não deve ser interpretado como correto em 90% dos casos até que essa relação seja medida com dados representativos.
A OpenAI afirma que a Decisions é cerca de 10 vezes mais rápida que a Responses no guia oficial, mas não publica dados de p50, p95, região, tamanho do payload ou configuração de comparação. Faça o benchmark na região de implantação pretendida antes de definir um orçamento de latência.
Barreira de produção: calibre, permita abstinência e só então automatize
- Monte um conjunto rotulado a partir da carga de trabalho real, incluindo casos ambíguos e modos de falha com alto custo.
- Execute as mesmas perguntas nesse conjunto e trace as taxas de falsos positivos e falsos negativos em diferentes limites.
- Implemente no código da aplicação um caminho explícito de abstinência. Respostas com baixa confiança ou conflitantes devem seguir para análise humana, em vez de forçar um encaminhamento.
- Monitore o uso de tokens e a quantidade de requisições com
GET /v1/organization/usage/decisionse, depois do lançamento, audite uma amostra dos resultados automatizados.
Uma tabela para decidir como implantar
A OpenAI Decisions API é a opção padrão mais indicada para avaliações curtas, delimitadas e de alto volume dentro de uma stack OpenAI já existente. O preço, por si só, não é motivo suficiente para migrar.
| Carga de trabalho | Recomendação | Condição principal |
|---|---|---|
| Roteamento de suporte ou leads | Use a Decisions | As categorias são fixas e há exemplos rotulados disponíveis |
| Análise de danos em imagens | Faça um teste com a Decisions | Faça benchmark da precisão nas imagens; URLs hospedadas agora são compatíveis |
| Política longa mais item curto | Teste os dois endpoints | Confirme os tokens realmente atingidos pelo cache e a latência |
| Conformidade ou ação destrutiva | Use a Decisions apenas como barreira | Exija abstinência, revisão e limites assimétricos |
| Extração com explicação | Use a Responses | Uma chamada mais completa pode evitar uma segunda requisição de geração |
| Seleção de ferramenta com argumentos | Use function calling | O formato da saída corresponde diretamente à ação |
| Carga de trabalho na UE ou regulamentada | Considere a Decisions | Confirme elegibilidade, residência de dados e o adicional regional |
FAQ sobre os preços da OpenAI Decisions API
A Decisions API é cobrada por requisição ou por token?
A cobrança é baseada nos tokens de entrada, não na quantidade de requisições. A entrada padrão sem cache custa atualmente US$ 0,10 por 1 milhão de tokens, sujeita às regras de cache e aos possíveis adicionais regionais ou de contexto longo.
Os tokens de saída da Decisions API são gratuitos?
Sim. O guia oficial da Decisions informa que não há cobrança pelos tokens de saída.
Existe um plano gratuito?
A documentação atual da OpenAI sobre a Decisions não lista um plano gratuito específico. Créditos da conta ou termos contratuais ainda podem alterar quanto uma organização paga.
O cache de prompts funciona com a Decisions API?
Sim. Prefixos de entrada compartilhados com pelo menos 1.024 tokens podem se qualificar, e a OpenAI define implicitamente um ponto de corte no fim da entrada compartilhada por padrão. O conteúdo das perguntas e as imagens específicas de cada pergunta não fazem parte desse prefixo reutilizável.
A Decisions é mais barata que a Responses API?
Geralmente, sim, em classificações curtas e delimitadas que não precisam de texto gerado. A vantagem pode diminuir quando a Responses produz uma saída pequena ou desaparecer quando o fluxo exige uma segunda chamada para extração ou explicação.
Quantas perguntas cabem em uma requisição?
O limite atual é de 1 a 400 perguntas. Perguntas independentes podem compartilhar a entrada; perguntas dependentes exigem requisições separadas.
As imagens são compatíveis e entram na cobrança?
Sim. A Decisions aceita URLs de imagens hospedadas em HTTP/HTTPS e imagens base64 embutidas, e a entrada de imagem contribui para o uso de entrada cobrado. Referências de imagem por file_id não são compatíveis.
O processamento regional custa mais?
Pode custar. A página de preços da OpenAI aplica um adicional de 10% a endpoints regionais e com residência de dados elegíveis para modelos mais novos; confirme a tarifa atual da região desejada antes da implantação.