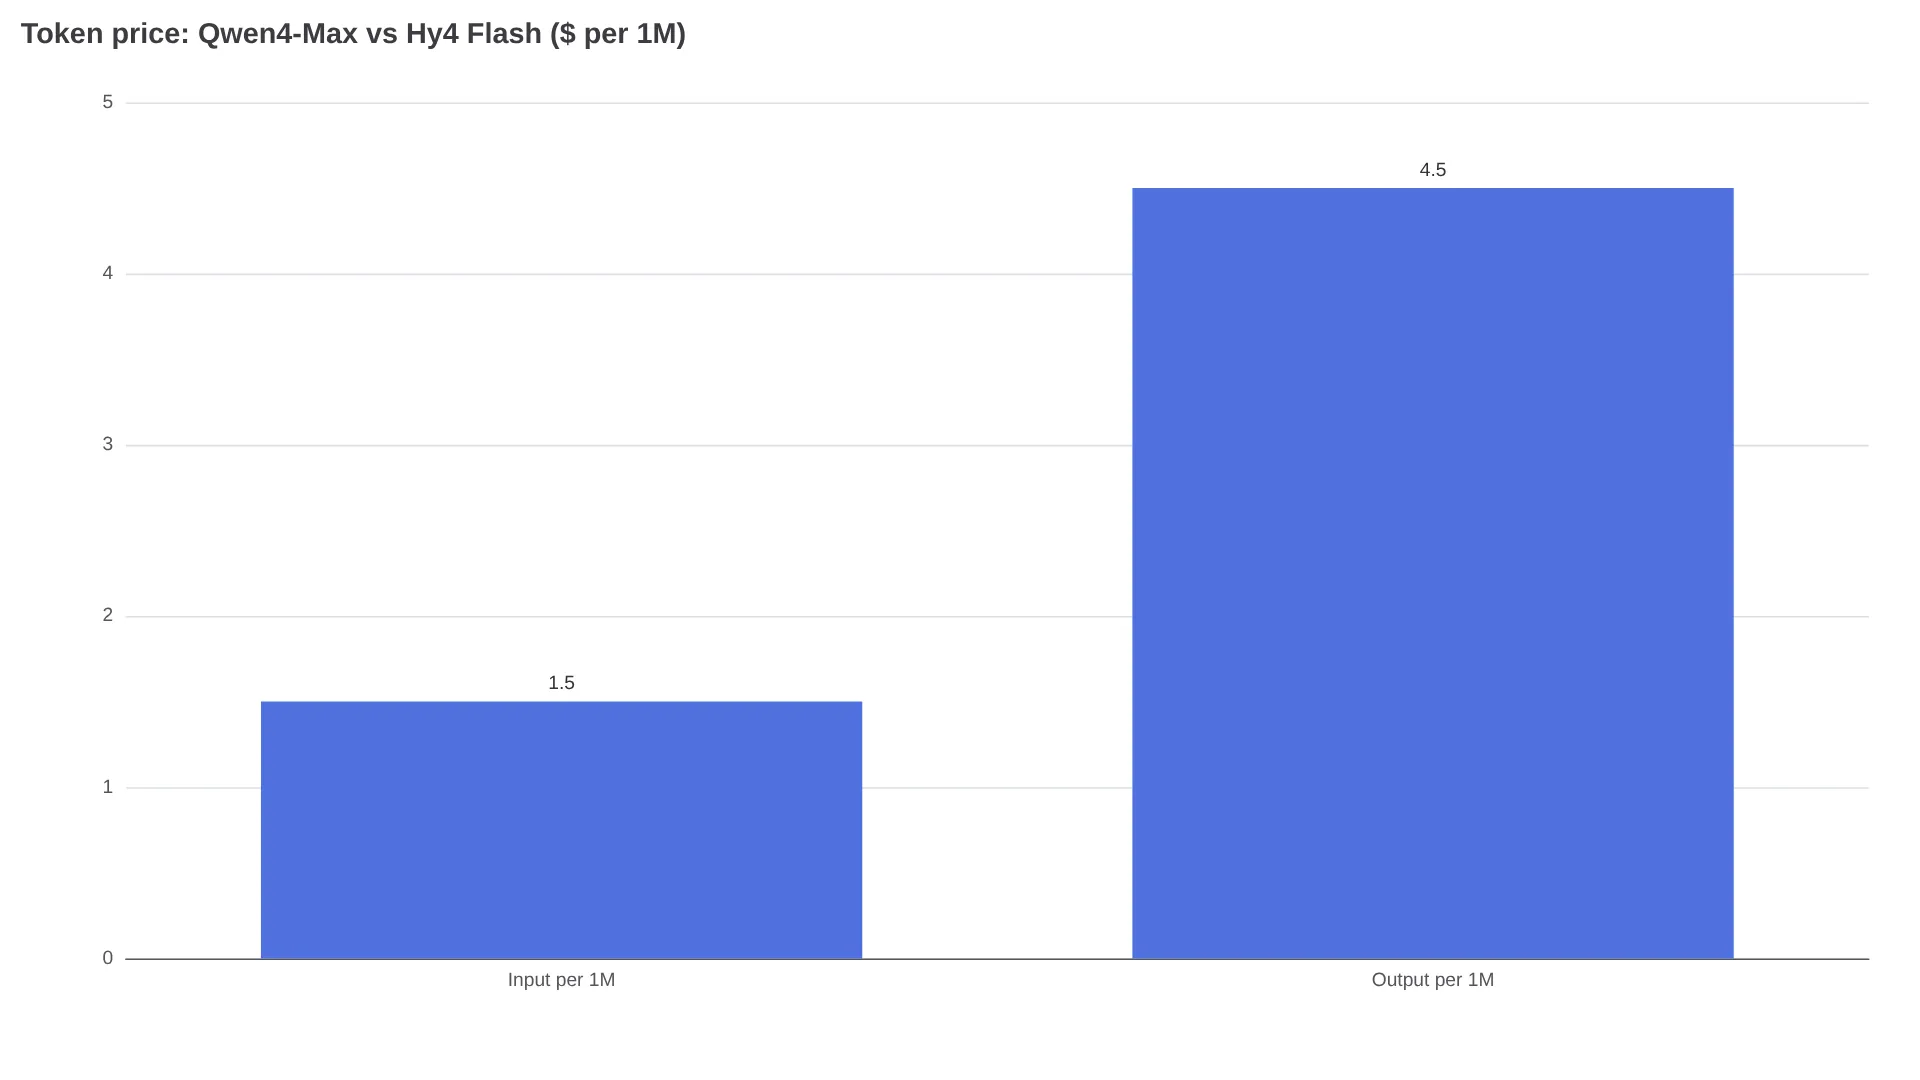
Nos benchmarks citados para programação complexa e fluxos de trabalho, o Qwen4-Max supera o Hy4 Flash — mas cada tentativa no Hy4 Flash custa muito menos. A QwenCloud cobra US$ 1,50/US$ 4,50 por milhão de tokens no Qwen4-Max, enquanto a Tencent informa US$ 0,070/US$ 0,281 para o Hy4 Flash: cerca de 21x mais na entrada e 16x mais na saída. Para agentes, porém, a fatura não depende só da tabela de preços: tokens de raciocínio, retentativas e reaproveitamento de cache pesam bastante. Esta análise de preços da API Qwen4 Max coloca lado a lado o contexto de 1M dos dois modelos, os backbones de 2,4T vs. 224B e as alegações dos fornecedores sobre custo por tarefa, para indicar qual faz sentido em cada carga de trabalho.
Preços de tabela, lado a lado
| Item | Qwen4-Max (Singapura / Internacional) | Hy4 Flash (TokenHub Internacional) |
|---|---|---|
| Entrada por 1M | US$ 1,50 | US$ 0,070 |
| Saída por 1M (inclui raciocínio) | US$ 4,50 | US$ 0,281 |
| Leitura de entrada em cache por 1M | US$ 0,075 | US$ 0,003 |
| Criação explícita de cache por 1M | US$ 1,875 (5 min) / US$ 3,00 (1 h) | Não divulgada separadamente |
| Composto: 0,5M de entrada + 0,5M de saída | US$ 3,00 | ~US$ 0,176 |
| ID do modelo | qwen4-max via QwenCloud | Hy4 Flash via Tencent |
Uma sessão de programação agentiva com 60.000 tokens de entrada e 4.000 de saída deixa a diferença clara. No Qwen4-Max, são US$ 0,09 de entrada mais US$ 0,018 de saída, ou cerca de US$ 0,108 por tentativa. No Hy4 Flash, são US$ 0,0042 mais US$ 0,0011, aproximadamente US$ 0,0053 por tentativa — cerca de 20x menos antes de considerar retentativas. Com a entrada totalmente em cache, os mesmos 60 mil tokens de entrada custam US$ 0,0045 no Qwen4-Max e US$ 0,00018 no Hy4 Flash, antes da saída. A QwenCloud cobra o raciocínio como saída; no Hy4 Flash, a saída custa US$ 0,281 por milhão, então respostas menores reduzem diretamente os tokens faturados.
O que os backbones sinalizam para a fatura
O Qwen4-Max é um modelo MoE de 2,4T de parâmetros, com 71B de parâmetros ativos por token (Offloop, DataCamp). Já o Hy4 Flash é um LatentMoE de 224B, com 12B ativos, inferência em 4 bits e alegação de mais de 150 tokens por segundo (Tencent). Para a cobrança, o ponto decisivo é o volume de saída medido: os testes do Qwen4-Max chegaram a 127M de tokens de saída, ante mediana de 78,6M entre os pares (DataCamp), enquanto o pós-treinamento do Hy4 Flash reduziu o comprimento médio das saídas em 50% (Tencent).
Qual tabela de preço vale para você
Na região de Singapura, a QwenCloud cobra US$ 1,50 pela entrada, US$ 4,50 pela saída e US$ 0,075 pela leitura em cache. Os limites são 991.808 tokens máximos de entrada sem thinking e 983.616 com thinking, 131.072 tokens de saída com thinking desligado e 262.144 combinados (QwenCloud). Outras implantações — Virgínia, Frankfurt, Tóquio e Hong Kong — mostram US$ 1,413 / US$ 4,24 / US$ 0,071 (tabela regional via Offloop).
Novas contas pay-as-you-go de Singapura são anunciadas com uma franquia gratuita de 1 milhão de tokens, sujeita a condições, via Xenospectrum. A rota do Token Plan para qwen4-max-preview será descontinuada em 25 de novembro de 2026 e nunca cobriu backends de produção (notas de migração).
Para o modelo Flash, o Hy4 lista US$ 0,070 / US$ 0,281 / US$ 0,003, contra US$ 0,834 / US$ 2,501 / US$ 0,042 do Hy4 completo, seu flagship (Tencent). Até 30 de novembro de 2026, o TokenHub custava metade do preço (~US$ 0,035 efetivos na entrada) (Tencent). Consulte o OpenRouter para verificar a disponibilidade. Mais detalhes: preços do Hy4 Flash.
Três fatores que definem o custo real
O primeiro é que o raciocínio divide o orçamento de saída e é cobrado como saída. O Qwen4-Max usa high por padrão, com orçamento de 131.072 tokens para thinking; as alternativas são xhigh e low. No teste de SVG de Simon Willison via OpenRouter, resumido pela Offloop, foram usados 6.362 tokens em high contra 26.295 em xhigh para o mesmo prompt: 4,1x mais tokens faturáveis. Definir max_completion_tokens como 10.000 no modo thinking limita a 10.000 o total somado de raciocínio e resposta.
O segundo fator é o efeito acumulado de verbosidade e retentativas. Dados compilados pela Alibaba via Offloop estimam cerca de 105.000 tokens de saída por tarefa de benchmark no Qwen4-Max, contra 171.000 no Qwen3.8-Max: redução de 39%, mas ainda muito acima da mediana dos pares. Um benchmark em sandbox no Reddit — 56 tarefas, duas tentativas por tarefa, 112 tentativas no total, thread — encontrou sucesso em 64 tentativas com o Qwen4-Max Preview e em 61 com o DeepSeek V4.1 Flash, mas 16 timeouts contra 4 e cerca de 13 minutos por tarefa contra 7. Cada timeout que exige nova tentativa gera outra requisição faturável.
"os 16 timeouts do qwen estão pesando bastante nessa diferença de 64 vs. 61." — u/the_crooked_badger, thread do r/DeepSeek
O terceiro é o reaproveitamento de cache, especialmente relevante para agentes de contexto longo. A leitura em cache do Qwen4-Max por US$ 0,075 custa 95% menos que a entrada normal; um participante da thread do r/Qwen_AI relatou 112M de entrada em cache contra 14M sem cache. A leitura de cache do Hy4 Flash, a US$ 0,003, é mais 25x barata, embora isso pese menos quando ciclos extras de raciocínio dominam a conta. Como resumiu @MarcosRGjr: "Ignore o preço por token. Agentes são cobrados por tarefa" (post).
Quanto os fornecedores dizem que custa uma tarefa — e o que mostram dados externos
São alegações dos fornecedores comparadas a indicadores externos, não uma comparação direta validada.
| Alegação | Número | Base |
|---|---|---|
| Alibaba Work360, Qwen4-Max vs. Qwen3.8-Max (interno do fornecedor, via DataCamp) | US$ 1,67 vs. US$ 4,43 por tarefa tentada | Suíte de 721 campos, ~35% menos tokens em high |
| Gráfico da Alibaba com linhas AA, Qwen4-Max vs. Qwen3.8-Max (compilado pelo fornecedor, via Offloop) | US$ 3,27 vs. US$ 10,02 por tarefa de benchmark | xhigh, 105K vs. 171K tokens de saída |
| Tencent WorkIndex, Hy4 Flash vs. Hy4 completo (interno do fornecedor, via Tencent e análise) | ¥0,2 vs. ¥5,7 por tarefa | Suíte de escritório com 8 conjuntos |
| Teste cego da Tencent, Hy4 Flash vs. Claude Haiku 5.5 (conduzido pelo fornecedor, via Tencent) | ¥0,26, 2,79/4 vs. ¥4,73, 2,81/4 | 85 usuários, 259 tarefas, 6,7 vs. 6,8 min |
No Work360, o Qwen4-Max marca 52,69 contra 47,74 do Qwen3.8-Max; o Intelligence Index sobe de 34 para 43, ainda abaixo de Kimi K3.1 Pro, com 46, e Opus 5.5, com 59 (Offloop, LLM Leaderboard).
Resultados externos reproduzidos em gráficos dos fornecedores delimitam essas alegações. Testes afiliados ao Vals, via o guia do LLM Leaderboard, mediram 63,20% para o Qwen4-Max a US$ 9,33 por teste, contra 63,94% para o GPT-6.1 Sol a US$ 3,61. No gráfico da Tencent, o Terminal-Bench 4.0 dá 48,5% ao Qwen4-Max e 19,2% ao Hy4 Flash; o Hy4 completo marca 44,4%. No ProgramBench, são 31,5 contra 16,0 (Offloop). O AutomationBench-AA registra 72,5% para o Qwen4-Max (DataCamp), enquanto a automação do Hy4 Flash alcança 52,2 (Tokenstrom).
O custo esperado por sucesso é o custo de uma tentativa dividido pela probabilidade de sucesso. Apenas como ilustração: US$ 0,108 / 0,485 ≈ US$ 0,22 para o Qwen4-Max, contra US$ 0,0053 / 0,192 ≈ US$ 0,028 para o Hy4 Flash — uma diferença de cerca de 8x. Taxas de benchmark não equivalem às taxas de retentativa em produção. Nesses volumes de tokens, o Qwen4-Max precisa de uma probabilidade de sucesso aproximadamente 20x maior, ou de economia equivalente em ferramentas, latência e correções, para vencer apenas em dólares.
Escolha pelo tipo de carga e confirme com 30 tarefas reais
| Perfil do agente | Padrão recomendado | Motivo |
|---|---|---|
| Programação difícil, de longa duração, e trabalho em terminal | Qwen4-Max em high | Taxa de sucesso maior (48,5 vs. 19,2; 31,5 vs. 16,0) pode justificar o prêmio quando falhas ou correções são caras |
| Loops de escritório em alto volume: slides, documentos, reparo de planilhas e computer-use | Hy4 Flash | ¥0,2 vs. ¥5,7 no WorkIndex, paridade com Claude Haiku 5.5 (2,79 vs. 2,81) a cerca de um dezoito avos do custo |
| Esteiras com cache e extração em lote | Hy4 Flash como padrão; Qwen4-Max se o replay comprovar economia em qualidade | Compare US$ 0,003 vs. US$ 0,075 em leituras de cache e o custo de correção nos seus documentos |
Antes de se comprometer, reproduza 30 tarefas suas nos dois modelos. Meça tokens de raciocínio mais saída por sucesso, registre chamadas de ferramentas, timeouts, correções e tempo mediano junto com o valor gasto.
Perguntas frequentes
Quanto custa a API Qwen4 Max por milhão de tokens?
A QwenCloud em Singapura lista US$ 1,50 para entrada e US$ 4,50 para saída, com US$ 0,075 por leituras em cache. Outras regiões listam US$ 1,413 / US$ 4,24 / US$ 0,071. O Hy4 Flash lista US$ 0,070 para entrada, US$ 0,281 para saída e US$ 0,003 para cache.
Tokens de raciocínio ou thinking são cobrados como saída?
O Qwen4-Max cobra o thinking a US$ 4,50 dentro de um orçamento compartilhado de 262.144 tokens. As saídas do Hy4 Flash custam US$ 0,281, portanto saídas mais curtas reduzem os tokens faturados.
Qual é o limite útil de contexto, e não o número de 1M do anúncio?
A QwenCloud documenta 991.808 tokens de entrada sem thinking e 983.616 com thinking, 131.072 de saída com thinking desligado e 262.144 combinados. A Tencent lista contexto de 1M para o Hy4 Flash. Deixe uma margem de segurança.
Qwen4-Max ou Hy4 Flash é mais barato por tarefa de agente concluída?
Por tentativa, o Hy4 Flash é cerca de 20x mais barato; a Tencent afirma que ele custa um vigésimo do Hy4 completo por tarefa e um oitavo do DeepSeek-V4.1-Flash-1017 no preço de pico (Tencent). Na conta ilustrativa acima, ele continua cerca de 8x mais barato por sucesso esperado, mas o Qwen4-Max pode vencer quando menos falhas e menos correções compensam o preço dos tokens.