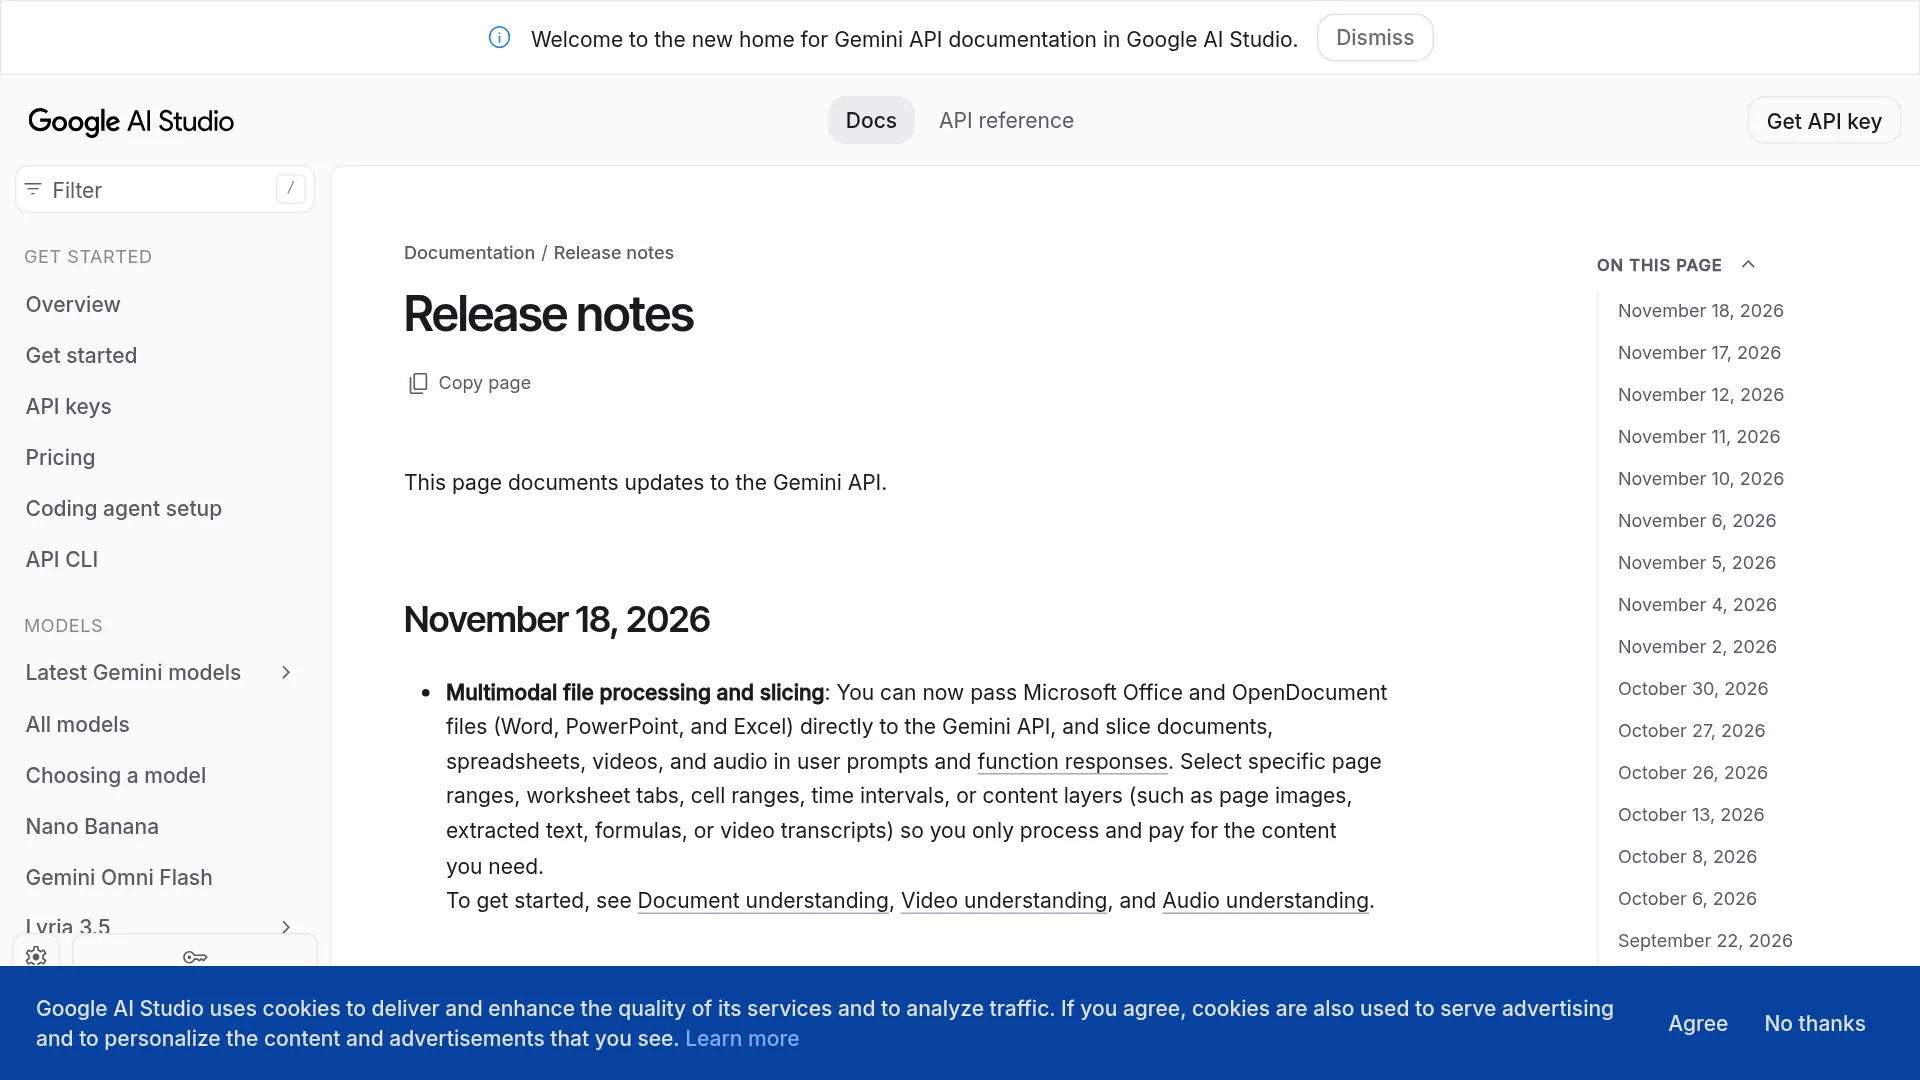
Se você ainda converte toda planilha em CSV antes de chamar a API do Gemini, essa etapa pode ser eliminada. Desde 18 de novembro de 2026, a API aceita arquivos do Word, Excel e PowerPoint diretamente — e, segundo o changelog do Google AI Studio, é possível “processar e pagar apenas” pelo recorte selecionado.
Para economizar de verdade, é preciso informar os seletores explicitamente. Caso contrário, a API ainda pode processar o arquivo inteiro, como observa o leitor @zg0820.
Por que o fluxo antigo com Excel dava problema
Até então, o comportamento documentado lia apenas a primeira planilha como CSV. Na prática, era necessário reorganizar as abas ou dividir o arquivo:
“A documentação ainda diz que apenas a primeira planilha de um XLSX é lida, como CSV.” — @aitrackerbot
A atualização de 18 de novembro substitui esse improviso pela entrada direta de arquivos do Office e do OpenDocument, com suporte a recortes definidos no prompt e nas respostas de funções (análise do DocsWatch).
O que muda de fato na atualização de 18 de novembro
A entrada adiciona dois recursos à expansão de 5 de novembro, que já havia incluído PPT, ODP e ODS:
- Entrada direta de arquivos do Office e OpenDocument. Word, PowerPoint e Excel podem ser enviados sem conversão para PDF ou texto.
- Recorte de conteúdo. É possível selecionar intervalos de páginas, abas de planilhas, intervalos de células em formato A1, intervalos de tempo ou camadas como imagens de páginas, texto extraído, fórmulas e transcrições.
Os recortes funcionam tanto nos prompts quanto em partes de FunctionResponse. Assim, uma ferramenta pode devolver apenas um intervalo de uma planilha, em vez do workbook inteiro (resumo do AI Index).
Quais arquivos podem ser enviados e em quais modelos
A página de requisitos de entrada do Firebase, atualizada em 18 de novembro de 2026 UTC, associa o suporte a arquivos do Office aos modelos Gemini 4.x (documentação do Firebase AI Logic):
| Família | Extensões | Tipo MIME |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Básicos | .pdf, .txt | application/pdf, text/plain |
Limites oficiais — o recorte não os amplia:
- 50 MB por arquivo, 1.000 páginas por arquivo e 3.000 arquivos de documentos por requisição.
- 20 MB no total da requisição para dados inline em base64; arquivos maiores precisam de URLs do Cloud Storage.
Uma observação da comunidade, mantida separada por não ter sido verificada: um leitor do changelog relata um limite específico para arquivos do Office de cerca de 2.000 páginas ou slides (@lawson_ste3476). O Google não documentou essa restrição; não projete sua solução com base nela.
Word e PowerPoint: intervalos de páginas e escolha da camada
DocumentMetadata foi encontrado em documentos públicos do Discovery em v1beta/v1alpha, mas não aparece na versão estável v1 (relatório de schema da ORIENS):
startPage: primeira página, começando em 1 e com limite inclusivo.endPage: última página, começando em 1 e com limite inclusivo.contentLayers:PAGE_IMAGE(imagem renderizada; padrão informado quando há metadados, mas nenhuma camada é definida) ouPAGE_TEXT(texto extraído).
Use PAGE_IMAGE quando o layout, os slides ou páginas digitalizadas forem importantes. Para texto pesquisável, como contratos, prefira PAGE_TEXT. O Firebase documenta o modelo por trás desse comportamento: PDFs são tratados como imagens, uma página conta como uma imagem, e imagens com no máximo 384 px nos dois lados custam 258 tokens (documentação do Firebase AI Logic).
Excel: planilhas, intervalos de células e três modos de camada
SpreadsheetMetadata é associado à parte do arquivo fornecida via inline_data ou file_data, dentro de uma Part de entrada ou de uma FunctionResponsePart, de acordo com o schema do Discovery (relatório de schema da ORIENS):
sheetIndex: ordem da planilha no workbook, começando em 1. O texto do Discoveryv1betadiz que todas as planilhas são usadas quando o campo é omitido; já os textos dos SDKs de Python e JavaScript mencionam a primeira planilha. Defina esse campo sempre.visibleCells: intervalo A1, comoA1:G35; se omitido, considera a área ocupada da planilha selecionada.contentLayers:DATA(valores, células mescladas e formatação),FORMULAS(expressões e resultados calculados) eVISUAL(imagem renderizada). O padrão informado é[DATA, FORMULAS].
Para auditorias, use DATA junto com FORMULAS. Se o contexto visual e as células mescladas importarem, acrescente VISUAL. Para uma consulta pontual, mantenha o intervalo em visibleCells o mais restrito possível.
Envie apenas o recorte: exemplo em Python com REST
Os nomes dos campos abaixo correspondem à revisão 20261116 do Discovery. O formato ainda é beta e não está disponível na versão estável v1; confirme a compatibilidade com o SDK instalado antes de usar em produção.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Para Word, substitua por "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} e use o tipo MIME do .docx. O PowerPoint usa o mesmo formato de documentMetadata, com o tipo MIME do .pptx e números de página correspondentes aos slides.
Como funciona a conta: quando o recorte realmente reduz o custo
O changelog e as notas de preços do Firebase não mencionam um SKU separado para recortes. A economia vem dos tokens de entrada evitados, cobrados pelas tarifas padrão. O changelog registra o preço de gemini-4-hydrogen em US$ 1,50 por 1 milhão de tokens de entrada.
Estimativa ilustrativa para um relatório de 200 páginas em que apenas as páginas 12 a 18 importam — o valor de 800 tokens por página de texto é uma hipótese deste exemplo, não uma tarifa documentada:
- Antes: 200 páginas como imagens x mínimo de 258 tokens por imagem de página = 51.600 tokens de entrada. Custo: 51.600 / 1.000.000 x US$ 1,50 = US$ 0,0774.
- Depois: 7 páginas como texto extraído x 800 tokens estimados = 5.600 tokens de entrada. Custo: 5.600 / 1.000.000 x US$ 1,50 = US$ 0,0084.
- Economia: cerca de 89% na entrada desta requisição, antes dos tokens de saída. Substitua o valor pela densidade de páginas medida no seu caso.
Faça o benchmark do tamanho dos intervalos no seu próprio workbook: muitas chamadas pequenas com recortes podem acabar custando mais do que um único intervalo bem escolhido (@zg0820).
Para usar com segurança: checklist de validação e migração
Uma operação de upload concluída não prova que o arquivo foi interpretado corretamente. Valide cada pipeline:
- Comprove o parsing. Peça de volta a quantidade de linhas, o nome da planilha ou o número de páginas e compare com o arquivo original.
- Defina todos os seletores. Informe
sheetIndex,visibleCellsou o intervalo de páginas econtentLayers. - Escolha a camada de acordo com a pergunta. Gráficos e layout precisam de
VISUALouPAGE_IMAGE; auditorias precisam deDATAmaisFORMULAS; buscas precisam dePAGE_TEXT. - Teste intervalos inválidos em staging. O schema não informa se uma página ou intervalo inválido gera erro, é ajustado automaticamente ou retorna vazio.
- Respeite os limites de upload. Um arquivo de 60 MB continuará ultrapassando o limite de 50 MB. Para mais de 20 MB inline, use URLs do Cloud Storage.
- Migre nesta ordem. Troque divisores de Excel por
sheetIndexmaisvisibleCells; substitua rasterizadores de relatórios por intervalos de páginas comPAGE_TEXT— deixandoPAGE_IMAGEpara questões de layout —; e altere retornos de ferramentas com o arquivo inteiro para respostas de função com recortes.
Os materiais citados não esclarecem o tratamento de linhas ocultas, células mescladas, gráficos, imagens incorporadas nem arquivos protegidos por senha, habilitados para macros ou corrompidos. Esses casos não são descritos no anúncio dos recortes nem na página de requisitos de entrada do Firebase indicada acima. Teste-os com seus próprios modelos.
Perguntas frequentes
Também posso recortar conteúdo dentro de respostas de funções?
Sim. As ferramentas podem retornar uma URI de arquivo junto com SpreadsheetMetadata ou DocumentMetadata, fazendo o modelo enxergar apenas o trecho relevante. Isso combina bem com fluxos de agentes que trabalham com documentos.
Qual versão da API oferece suporte a recortes?
O recurso foi observado no Discovery v1beta e v1alpha, revisão 20261116, mas não na versão estável v1. Fixe as versões e teste no modelo escolhido antes de levar para produção.
Por que o Gemini diz que não consegue acessar meu arquivo enviado?
Confira o tipo MIME, o tamanho e os seletores explícitos com base na tabela e nos limites acima. Depois, peça ao modelo que repita os nomes das planilhas ou a quantidade de páginas para confirmar que o parsing funcionou.
Leia também: guia da API Gemini 4 Carbon vs Hydrogen para escolher o modelo que ficará por trás do seu pipeline de arquivos do Office.