Rodando em high, o Neon é a opção com melhor custo-benefício para agentes que lidam com contexto longo quando reduzir respostas erradas é prioridade; Astra e Sol ainda saem mais baratos por tarefa. Esta é uma síntese feita no dia do lançamento, com base em especificações oficiais, rankings e testes independentes. Não testei o Neon pessoalmente.
O Neon é um Carbon mais rápido para agentes — com uma troca bem clara
O Gemini 4 Neon chegou em 18 de novembro de 2026 como gemini-4-neon, ocupando a posição intermediária da família Gemini 4, entre Hydrogen e Carbon, segundo o Google e o 9to5Google. O Google afirma que ele conclui tarefas de ponta a ponta mais rapidamente que o Carbon, com custo menor por tarefa. Funcionários da DeepMind também o descrevem como mais barato e veloz que o Carbon (@_mohansolo). O modelo aparece em 3º lugar no Artificial Analysis Index, com 61 pontos em xhigh, e em 2º no Agent Arena, com 1336 pontos em mais de 4.200 sessões. Os materiais de lançamento analisados não publicaram pontuações do Opus 5.5 e do Fable 5.2 no mesmo ranking do Arena. Por isso, a comparação direta abaixo combina posições em índices com testes usando as mesmas tarefas.
Preço, janela de contexto e onde usar
O Neon custa US$ 3 por milhão de tokens de entrada, US$ 15 por milhão de tokens de saída e US$ 0,15 por milhão de tokens de entrada em cache, segundo o Google. A janela de contexto é de 1.048.576 tokens, com limite de 65.536 tokens por resposta. Os níveis de raciocínio são low, medium, high (padrão) e xhigh; níveis mais altos podem consumir mais tokens de raciocínio e aumentar a conta. O padrão high é documentado na explicação de níveis da DataCamp e nas notas de API da SpringPrompt.
O acesso é pago e não há plano gratuito, de acordo com a verificação da API feita pela eesel. Segundo o Google e o 9to5Google, o Neon está disponível na API paga do AI Studio, no Gemini para empresas, no Antigravity (Pro/Ultra), no app Gemini (Pro/Ultra, que substitui o Argon), no Android Studio e no Cursor. No CursorBench, ele alcança 63,7% com o esforço padrão, contra 57,3% do Hydrogen, segundo o Cursor.
| Modelo | Entrada / saída por 1 milhão | Raciocínio padrão |
|---|---|---|
| Gemini 4 Neon | US$ 3 / US$ 15, cache US$ 0,15 | high |
| Gemini 4 Hydrogen | US$ 1,50 / US$ 7,50 | high |
| Gemini 4 Carbon | US$ 2 / US$ 10 até 30 de novembro; depois, US$ 4 / US$ 20 | medium |
| Claude Opus 5.5 | US$ 4 / US$ 20, configuração máxima testada | máximo testado |
| GPT-6.2 Sol | US$ 2 / US$ 10, configuração máxima testada | máximo testado |
Os preços dos concorrentes e as indicações de melhor configuração foram compilados na tabela comparativa da eesel. A partir de 1º de dezembro, o Neon será 25% mais barato por token que o Carbon. Mais detalhes: preços da API do Neon.
Use a API para fixar o nível de raciocínio; deixe o app ou o Antigravity gerenciar a cota. Os relatos sobre cota servem apenas como referência informal para planejamento: cerca de 1–3% da cota Pro por conversa, contra aproximadamente 5% em uma execução de 10 minutos com 3 subagentes, segundo relatos de usuários.
Benchmarks: Neon contra Opus 5.5, Fable 5.2 e Sol
As pontuações foram divulgadas pelos fornecedores via Google e compiladas pela eesel e pela DataCamp.
| Teste | Neon | Concorrente | Conclusão |
|---|---|---|---|
| Vals Index | 70,9%, 2º lugar | Fable ~71,3% | Perto do topo |
| AutomationBench | 56,3%, 1º lugar | Opus 42,5%, Sol 41,3% | Liderança em agentes |
| GraphWalks 256K–1M | 95,2% | Opus 66,8%, Sol 80,1% | Liderança em contexto longo; repita primeiro o teste com seu arquivo mais extenso, já que alguns usuários do Argon relatam resumos excessivos (tópico) |
| Terminal-Bench 4.1 | 65,2% | Opus 65,8% | Quase empate, Opus +0,6 |
| FrontierCode 2.0 | 46,2% | Opus 47,3% | Opus +1,1 |
| CursorBench 4.1 | 63,7–65,4% | Opus 58,1% | Neon lidera no esforço padrão |
O custo por tarefa muda completamente a leitura dos preços por token, segundo a Artificial Analysis, via eesel:
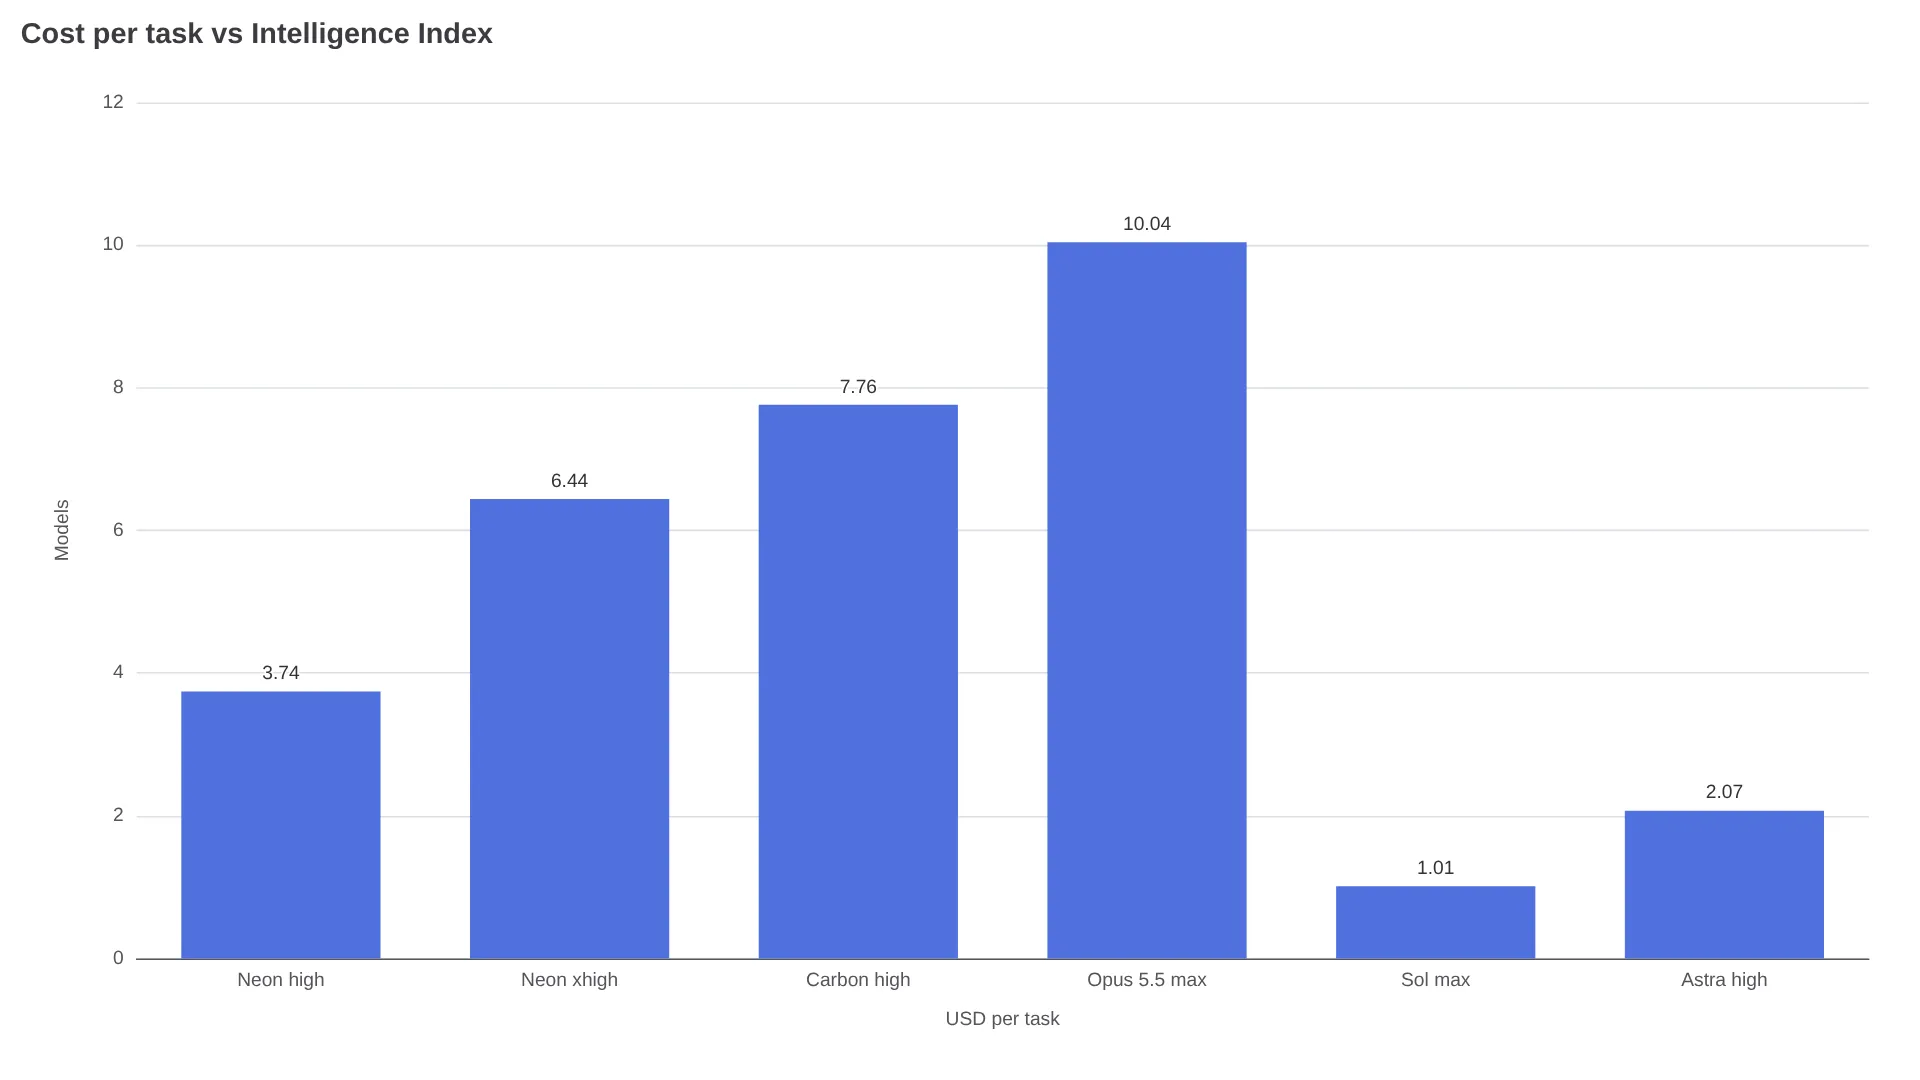
O Neon em high marcou 59,6 por US$ 3,74 em 14,8 minutos; o Carbon em high marcou 60,0 por US$ 7,76 em 37,2 minutos; o Opus no máximo marcou 59,1 por US$ 10,04; o Astra em high marcou 60,1 por US$ 2,07; e o Sol no máximo marcou 57,3 por US$ 1,01. O Neon em xhigh chega a 61,4 por US$ 6,44 em 21,5 minutos. Use high, a menos que 1,8 ponto extra valha US$ 2,70 e mais 6,7 minutos para você.
Neon vs. Fable 5.2: os primeiros relatos apontam para papéis divididos
No SWE-sweep com o harness do fornecedor (harness do Antigravity), o Neon marcou 39,0%, contra 10,1% do Opus e 8,3% do Sol. No harness compartilhado do mini-SWE, foram 12,8% contra 11,6% do Sol e 3,6% do Opus, segundo a DataCamp. Grande parte da diferença chamativa vem do harness, não apenas do modelo.
"Estou usando o Fable 5.2 como orquestrador e desenvolvedor, com o Neon como agente de programação, e é a melhor combinação que já usei." — u/1969Stingray (tópico)
Na prática, relatos informais favorecem o Fable na orquestração e o Neon na implementação; valide essa divisão no seu repositório. No AA-Omniscience, o Neon registra 14% de respostas erradas em vez de recusar, contra 50% do Opus, 55% do Sol, 58% do Astra e do Fable. Por outro lado, sua cobertura fica em 59–60% de respostas corretas, contra 66% do Astra e 77% do Fable, segundo a eesel.
Testes práticos: xadrez, catálogos e 105 bugs reais
| Teste | Resultado | Limitação |
|---|---|---|
Página de xadrez, 3 execuções em medium (DataCamp) | Neon acertou 3/3 por US$ 0,83–US$ 1,06; Carbon acertou 1/3, com dois casos atingindo o limite de 65 mil tokens; 16 partidas, nenhum movimento ilegal | Uma única tarefa; o Carbon provavelmente termina com o modo em segundo plano |
| CatalogBench factual (SpringPrompt) | 78,6% pronto para publicação em 3 execuções, 1º lugar entre 35; lê especificações diretamente das embalagens | Vendas: 32,1%; apresentações: 24º lugar; pesquisas: 22º lugar dentro do orçamento |
| 105 bugs replantados (@PawelHuryn) | Neon em xhigh: 63; Astra: 62,7; Fable: 58; Carbon: 57,3 | Um único avaliador |
A SpringPrompt usou medium no OpenRouter, enquanto a API do Google adota high por padrão; por isso, o nível de detalhamento varia. Há relatos isolados de vazamento no AI Studio (tópico). Para conversas, o tempo medido pela eesel coloca o primeiro token do Neon em xhigh após 56,5 segundos. Para respostas interativas, prefira medium ou Hydrogen.
Escolha conforme o trabalho
| Carga de trabalho | Escolha | Motivo |
|---|---|---|
| Agentes complexos, documentos longos e refatorações | Neon high | 59,6 por US$ 3,74, 2º lugar no Agent Arena e 3/3 no xadrez |
| Projetos com horizonte mais longo | Carbon, segundo o posicionamento da família pelo Google | O Google reserva o Carbon para os projetos mais difíceis; não há aqui um teste de prova com a mesma tarefa |
| Orquestração + programação | Fable na liderança + agentes de programação com Neon | Combinação baseada nos relatos acima; valide antes |
| Menor custo por tarefa | Sol no máximo, US$ 1,01; Astra em high, US$ 2,07, com pontuação maior | Ambos tiveram taxas maiores de respostas erradas no AA-Omniscience |
| Chat interativo | Hydrogen ou Neon em medium | A latência até o primeiro token em xhigh é alta demais para chat |
| Uso regulado | Aguarde a documentação | O relatório completo de segurança ainda estava pendente em 19 de novembro; aprove apenas depois de conferir os documentos exigidos |
Teste você mesmo em uma tarde
Rode o mesmo prompt e os mesmos arquivos, com o mesmo orçamento de raciocínio, no Neon em high, no modelo que você usa atualmente e em uma alternativa barata. Registre sucesso, custo, tempo e respostas erradas. Para a sua fila de trabalho, essa comparação vale mais do que qualquer ranking. Para os cálculos do Opus: análise do Opus 5.5 e análise do Fable 5.2.