Desde 19 de novembro de 2026, uma chave de API já basta para colocar um mundo jogável no ar — mas uma demonstração de dois minutos custa cerca de US$ 12, e o cenário começa a perder a memória depois de um minuto. A API do Genie 4 está disponível pela Gemini Interactions API e pelo Google AI Studio. Por enquanto, ela faz mais sentido para protótipos interativos curtos do que para jogos persistentes.
API do Genie 4: o que chegou em 19 de novembro
O Google liberou o acesso para desenvolvedores em 19 de novembro de 2026, pela Interactions API da Gemini API (v1beta) e pelo Google AI Studio — um dia depois do acesso ao Project Genie para assinantes do AI Ultra, em 18 de novembro. O identificador do modelo é models/genie-4, segundo a documentação do Genie no AI Studio.
É preciso ter uma chave da Gemini API associada a um plano pago. O Genie 4 não oferece camada gratuita, e o Google classifica essa interface como v1beta — ou seja, o formato das requisições e as cotas ainda podem mudar.
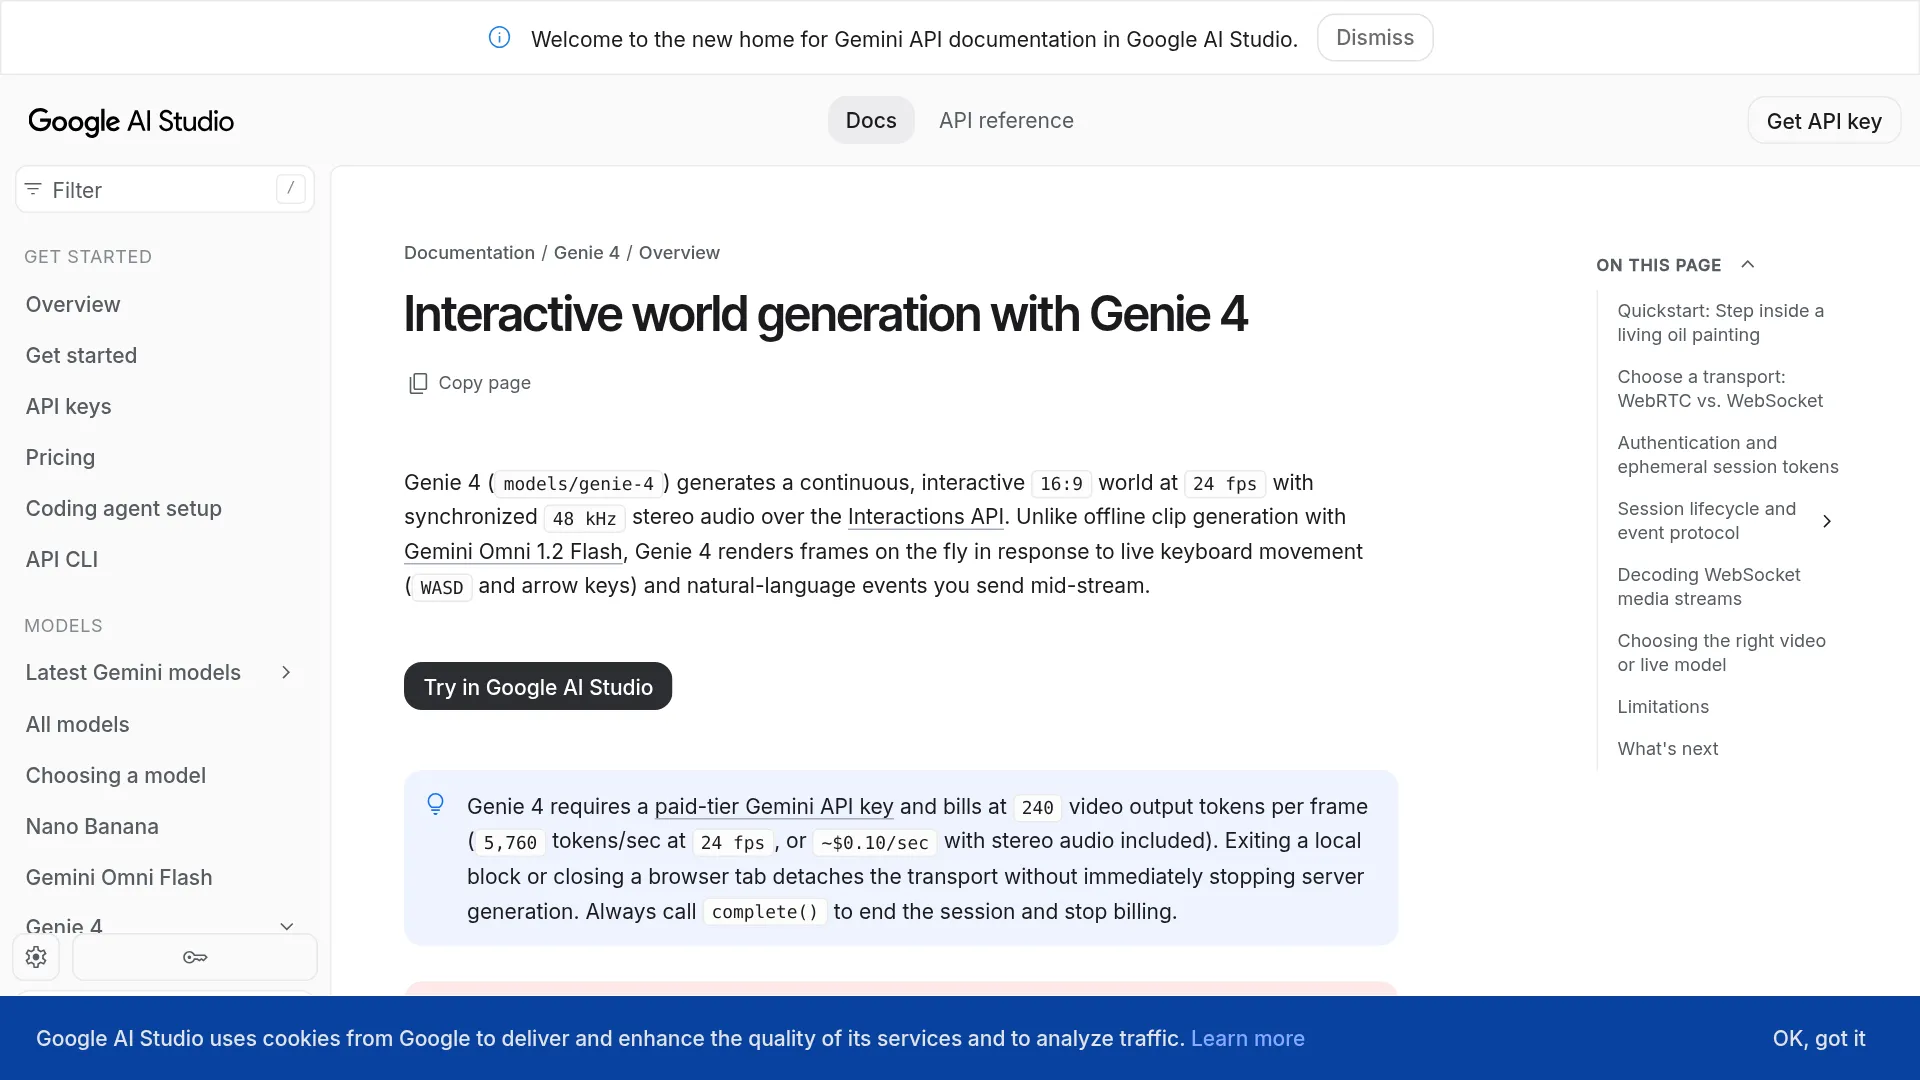
De acordo com o anúncio oficial, o Genie 4 gera um mundo contínuo em 16:9, com resolução de 1280x720, 24 fps e áudio estéreo sincronizado em 48 kHz, incluindo sons ambientes, efeitos e falas de personagens. O mundo pode começar a partir de um prompt de texto, de uma imagem de referência em 16:9 ou dos dois. Durante a sessão, o usuário pode controlá-lo com WASD ou as setas do teclado e enviar prompts que alteram o clima, a iluminação, os objetos e os acontecimentos. Diferentemente da geração de vídeo offline, o Genie 4 renderiza os quadros em resposta a comandos ao vivo.
Quanto custa uma sessão do Genie 4 na prática
O preço do Genie 4 é calculado por tokens, mas o número que realmente importa no planejamento é o tempo. A documentação do Genie no AI Studio informa US$ 1,50 por milhão de tokens de entrada, US$ 9,00 por milhão de tokens de saída de texto e US$ 17,50 por milhão de tokens de saída de vídeo. O vídeo é cobrado a 240 tokens por quadro. Considerando o fluxo completo, a documentação estima um custo efetivo de cerca de US$ 0,10 por segundo.
| Uso | Tarifa cobrada |
|---|---|
| Tokens de entrada | US$ 1,50 / 1 milhão de tokens |
| Tokens de saída de texto | US$ 9,00 / 1 milhão de tokens |
| Tokens de saída de vídeo | US$ 17,50 / 1 milhão de tokens |
| Consumo de tokens de vídeo a 24 fps | 240 x 24 = 5.760 tokens / segundo |
| Custo efetivo do streaming | ~US$ 0,10 / segundo, estimativa combinada da documentação |
O vídeo domina a conta: 5.760 / 1.000.000 x US$ 17,50 = US$ 0,1008 por segundo apenas em tokens de vídeo. Por isso, a documentação arredonda o custo combinado de vídeo e áudio para cerca de US$ 0,10 por segundo. Isso equivale a aproximadamente US$ 6,05 por minuto e US$ 12,10 por uma sessão completa de 120 segundos, antes dos tokens usados em prompts e diálogos.
Para dimensionar o orçamento: uma demonstração em uma landing page com dez acessos de 30 segundos consumiria cerca de 300 segundos, ou aproximadamente US$ 30 em geração de mundo. Uma hora de geração contínua fica em torno de US$ 363. E o dinheiro não é o único limite: as cotas também entram na conta. A análise de lançamento da AICoder informa que o Tier 1 permite 2 sessões simultâneas e 50 requisições por dia; o Tier 2, 5 sessões e 250 requisições; e o Tier 3, 10 sessões e 1.000 requisições. Confira seu nível na documentação de limites de taxa antes de fazer testes de carga, porque as cotas da versão beta podem mudar.
Até os testes básicos são cobrados. O melhor caminho é começar pelo playground Live do AI Studio e só depois migrar para uma integração com chave.
WebRTC ou WebSocket: escolha o transporte conforme o local da renderização
| Recurso | WebRTC | WebSocket |
|---|---|---|
| Ideal para | Jogar no navegador com controle pelo teclado | Processamento no servidor, gravação e mídia personalizada |
| SDK | @google/genai no JavaScript/TypeScript do navegador | google-genai assíncrono em Python, @google/genai no Node |
| Mídia | Vídeo RTP nativo + áudio Opus em <video> | step.delta em JSON com JPEG em base64 + PCM Int16 de 48 kHz |
| Comportamento da latência | Menor latência; UDP + buffer de jitter | Maior latência; bloqueio de fila do TCP em caso de perda |
| Limite de payload | Limite SCTP de 64 KB; confira o tamanho final da seed codificada | Payloads JSON maiores são aceitos |
A comparação acima segue a documentação do Genie no AI Studio: WebRTC é apresentado como a opção padrão para jogar no navegador com boa resposta, enquanto WebSocket é indicado para captura e pipelines personalizados.
O padrão seguro é o mesmo nos dois casos, segundo a seção de autenticação da documentação do Genie. O servidor chama interactions.create, gera um token efêmero para uma única sessão e envia ao navegador apenas o ID da interação e esse token. Nunca coloque uma chave de longa duração no código do cliente. O WebSocket padrão do navegador não consegue anexar o cabeçalho x-goog-api-key; por isso, as conexões no navegador usam o token de sessão auth_tokens/....
O ciclo mínimo de uma sessão, conforme a documentação do ciclo de vida, é este:
- Servidor: chama
interactions.createcommodels/genie-4. - Servidor: gera o
auth_tokende uma única sessão e envia o ID e o token ao navegador. - Cliente: chama
interactions.connectusando WebRTC ou WebSocket. - Cliente: envia exatamente um
world_setupcomworld_prompte, opcionalmente, umareference_imageem 16:9. - Cliente: controla o mundo com eventos de teclado
user_actione eventos de textoinput. - Cliente ou servidor: chama
complete()para interromper a geração e a cobrança.
As teclas mantidas pressionadas continuam valendo até o envio de key_up, e os clientes devem desativar a repetição automática do sistema operacional. Ações personalizadas em E, Q ou Espaço não têm um comportamento de pulo pronto no exemplo da documentação — elas são enviadas como entradas de texto descritivas.
A armadilha da cobrança é mais importante que o formato do código. Segundo a seção de ciclo de vida da documentação, complete() interrompe a geração no servidor e a cobrança, enquanto cancel() aborta imediatamente. Já detach() apenas fecha o socket local e não deve ser usado como forma de interromper a cobrança. Fechar a aba do navegador desconecta o transporte, mas não garante que a geração será encerrada. Sempre chame complete() ou cancel() explicitamente.
As imagens usadas como seed exigem atenção no WebRTC. A documentação menciona o limite SCTP de 64 KB e recomenda manter pequena a seed final codificada em base64 — aproximadamente metade desse orçamento depois da expansão de cerca de 33% causada pelo base64. Verifique no código o tamanho do payload codificado, em vez de confiar apenas na resolução; seeds grandes devem usar WebSocket.
4 limites que podem derrubar sua demonstração
Segundo a seção de limitações, o modelo trabalha com uma janela temporal deslizante, e não com um grafo de cena 3D persistente. Antes de prometer qualquer coisa aos usuários, projete a experiência levando quatro restrições em conta.
1. Limite rígido de 120 segundos. Toda sessão termina em 120 segundos, de acordo com os limites da documentação. Encadear sessões novas pode prolongar a experiência, mas não preserva exatamente o estado da cena, porque as sessões não podem ser retomadas. A configuração inicial do mundo leva vários segundos antes da chegada do primeiro quadro; o quickstart da documentação mostra cerca de 5–9 segundos.
2. Deriva após 60–90 segundos e alterações ao desviar o olhar. A documentação alerta que a estabilidade visual pode piorar depois de 60–90 segundos. Além disso, deixar de olhar para um ponto por 8 segundos ou mais, ou girar 360 graus, pode deslocar marcos, portas e botões. No exemplo do canal, virar 180 graus e retornar pode reorganizar os prédios ao fundo. Placas, medidores, relógios e contagens exatas são os primeiros elementos a se deformar. A recomendação é descrever mudanças contínuas, em vez de fazer cortes bruscos de câmera, e repetir prompts curtos ao longo de cerca de 1,5 segundo, com uma pausa de aproximadamente 2 segundos, porque o planejamento do mundo processa o texto nos limites dos passos.
3. Sensibilidade à latência e à região. O Genie 4 é servido a partir dos Estados Unidos, da Europa Ocidental e do Japão. Segundo a documentação, a resposta é melhor com ida e volta abaixo de ~150 ms na América do Norte, na Europa ocidental e central e no Leste Asiático. Acima desse limite, o controle fica lento e a taxa de quadros pode cair. Posicione os relays do backend perto de uma região atendida e teste a latência do WebRTC a partir da localização do público. Em condições de baixa latência, a resposta do teclado é documentada em ~0,2–0,5 segundo, e a dos eventos de texto, em ~1–2 segundos.
4. Tela fixa e conteúdo bloqueado. A saída é limitada a 16:9, 720p e 24 fps. Não há modo retrato, taxa de quadros configurável, entrada ao vivo de microfone ou webcam, chamadas de função, grounding com Search, saídas estruturadas nem retomada de sessão. Prompts ou seeds com pessoas identificáveis, figuras públicas ou propriedade intelectual de marcas podem ser bloqueados ou encerrar um stream. Toda saída recebe uma marca-d'água SynthID imperceptível.
"Está bonito, não parece conteúdo genérico, mas não me importo com os exemplos específicos e selecionados do Google... Quero ver algum sujeito aleatório chamado Steve usando isso ao vivo no YouTube, talvez aproveitando ideias do chat, e ver como funciona nesse cenário sem exemplos escolhidos a dedo" — u/RobXSIQ, pedindo testes ao vivo e improvisados em vez de demonstrações selecionadas
Faça esse teste sem roteiro antes do lançamento: entre no mundo, olhe para outro lado por 10 segundos, gire 360 graus, envie três eventos de texto conflitantes em sequência e observe o que muda de lugar.
Vale a pena criar algo com o Genie 4 nesta semana?
O Genie 4 funciona melhor para mundos curtos, controláveis e descartáveis. A própria comparação da documentação do Google delimita seu espaço em relação a dois modelos irmãos: o Gemini Omni 1.2 Flash, voltado para clipes offline, e o Gemini 3.8 Live, voltado para agentes de voz.
| Objetivo | Use este | Por quê |
|---|---|---|
| Protótipo jogável, passeio espacial, experimento no navegador, playground para agentes | Genie 4 pela Interactions API | Controle ao vivo a 24 fps + áudio nativo; é a opção desta comparação que aceita WASD e texto durante a execução |
| Clipe refinado de 3–15 s, edição/extensão até 30 s, upscale para 1080p/4K | Gemini Omni 1.2 Flash pela Interactions API | Fluxo de edição offline com até 6 imagens de referência; edição offline e resolução de saída maior |
| Agente de voz com microfone/câmera, ferramentas e grounding | Gemini 3.8 Live pela Live API | Compreensão bidirecional de áudio/vídeo + chamadas de ferramentas; o Genie 4 não oferece esses recursos |
Bons primeiros usos incluem moodboards interativos, protótipos de level design, ambientes de teste para robótica ou agentes — em que um mundo falso e seguro é melhor que um ambiente real — e demonstrações de até dois minutos. Não é uma boa escolha para estado persistente em multiplayer, inventários ou sinalizações exatos, treinamentos longos, tela cheia vertical em celulares e qualquer projeto que dependa de seeds reproduzíveis.
Existe uma camada gratuita para a API do Genie 4?
Não. O Genie 4 exige uma chave da Gemini API associada a um plano pago, e a documentação estima o custo efetivo em cerca de US$ 0,10 por segundo de mundo transmitido com áudio.
O navegador pode chamar o Genie 4 sem expor a chave da API?
Sim, usando tokens efêmeros. O servidor cria a interação e gera um token de sessão única; o navegador se conecta com esse token de curta duração, nunca com a chave de longa duração.
Uma sessão do Genie 4 pode durar mais de 2 minutos?
Não. As sessões são limitadas a 120 segundos, a estabilidade costuma diminuir depois de 60–90 segundos e as sessões não podem ser retomadas. É possível encadear sessões novas para criar fluxos mais longos, mas o estado da cena não será preservado exatamente.
Fechar a aba interrompe a cobrança do Genie 4?
Não de forma confiável. Segundo a documentação, fechar a aba desconecta o transporte, mas a geração no servidor pode continuar. Sempre chame complete() ou cancel() para encerrar a cobrança.
Checklist operacional antes do lançamento: crie as interações no servidor, gere tokens por sessão, envie um único world_setup, desative a repetição automática do teclado, reserve cerca de US$ 0,10/s mais os tokens de diálogo, posicione os relays perto das regiões atendidas nos EUA, na Europa ou no Japão e finalize toda sessão com complete(). O equilíbrio é entre a sensação de “entrar no prompt” e uma memória curta com cobrança por segundo.