 AIREITER
Um modelo de 594B de parâmetros que ativa apenas 17B por token parece uma pechincha. O Inkling 2 Small custa US$ 0,30 por 1M de tokens de entrada, mas, por enquanto, só pode ser acessado pelo Tinker e não supera o DeepSeek-V4.1-Flash-1017 em programação. Na prática, o público ideal é mais restrito do que o post de lançamento sugere. Esta avaliação se baseia no relatório de lançamento e nos preços do Tinker; ainda não foi possível fazer testes independentes de latência e qualidade das respostas.
O que o Inkling 2 Small traz na prática
O Inkling 2 Small é o modelo pequeno de segunda geração da Thinking Machines Lab, baseado em Mixture-of-Experts e anunciado em 5 de novembro de 2026. Ele combina 594B de parâmetros totais com 17B de parâmetros ativos, aceita texto e imagem e oferece esforço de raciocínio variável para agentes que executam tarefas de longo horizonte (Thinking Machines Lab).
| Especificação | Inkling 2 Small |
|---|---|
| Arquitetura | Mixture-of-Experts |
| Parâmetros totais / ativos | 594B / 17B |
| Modalidades de entrada | Texto + imagem (sem áudio) |
| Controle de raciocínio | Esforço variável (avaliado em 0.99 / xhigh) |
| Encoder de visão | 292M de parâmetros, patches 20x20, pooling 2x2 |
| Formato numérico | NVFP4 em NVIDIA GB300 NVL72 |
| Contexto de treinamento | 256K tokens com compactação (trajetórias de benchmark de até 1M) |
| Artificial Analysis Index | 31 (segundo o anúncio) |
Apesar do volume total de pesos de 594B, o Tinker o precifica como um modelo pequeno.
Como testar agora: só no Tinker; pesos chegam na próxima semana
Hoje, o Inkling 2 Small está disponível exclusivamente pela plataforma Tinker da Thinking Machines Lab, incluindo Playground, fine-tuning e sampling. Os pesos para download ainda não foram liberados: checkpoints completos sob licença Apache 2.0 estão previstos para a próxima semana, condicionados a testes externos de segurança e red teaming (Thinking Machines Lab).
Na prática, isso implica três pontos:
- O anúncio de lançamento oferece acesso apenas pelo Tinker. Não há lançamento oficial no Hugging Face ou em GGUF, nem rota anunciada por provedores terceiros.
- Checkpoints iniciais foram testados publicamente sob o nome Fledge-Alpha via OpenCode (Thinking Machines Lab); portanto, rastros da comunidade identificados como Fledge-Alpha se referem a esta família de modelos.
- Quem pretende hospedar o modelo por conta própria deve esperar: os materiais de lançamento citados não trazem números de throughput nem de time-to-first-token, e não há orientação oficial sobre VRAM ou receita de quantização.
Preços no Tinker e a comparação relevante
No modo serverless, o Inkling 2 Small custa US$ 0,30 por 1M de tokens de entrada, US$ 0,03 por 1M de tokens de entrada em cache e US$ 1,00 por 1M de tokens de saída, com contexto de 256K. São as menores tarifas serverless de saída e de entrada em cache entre os três modelos hospedados pela Thinking Machines Lab (Thinking Machines Lab).
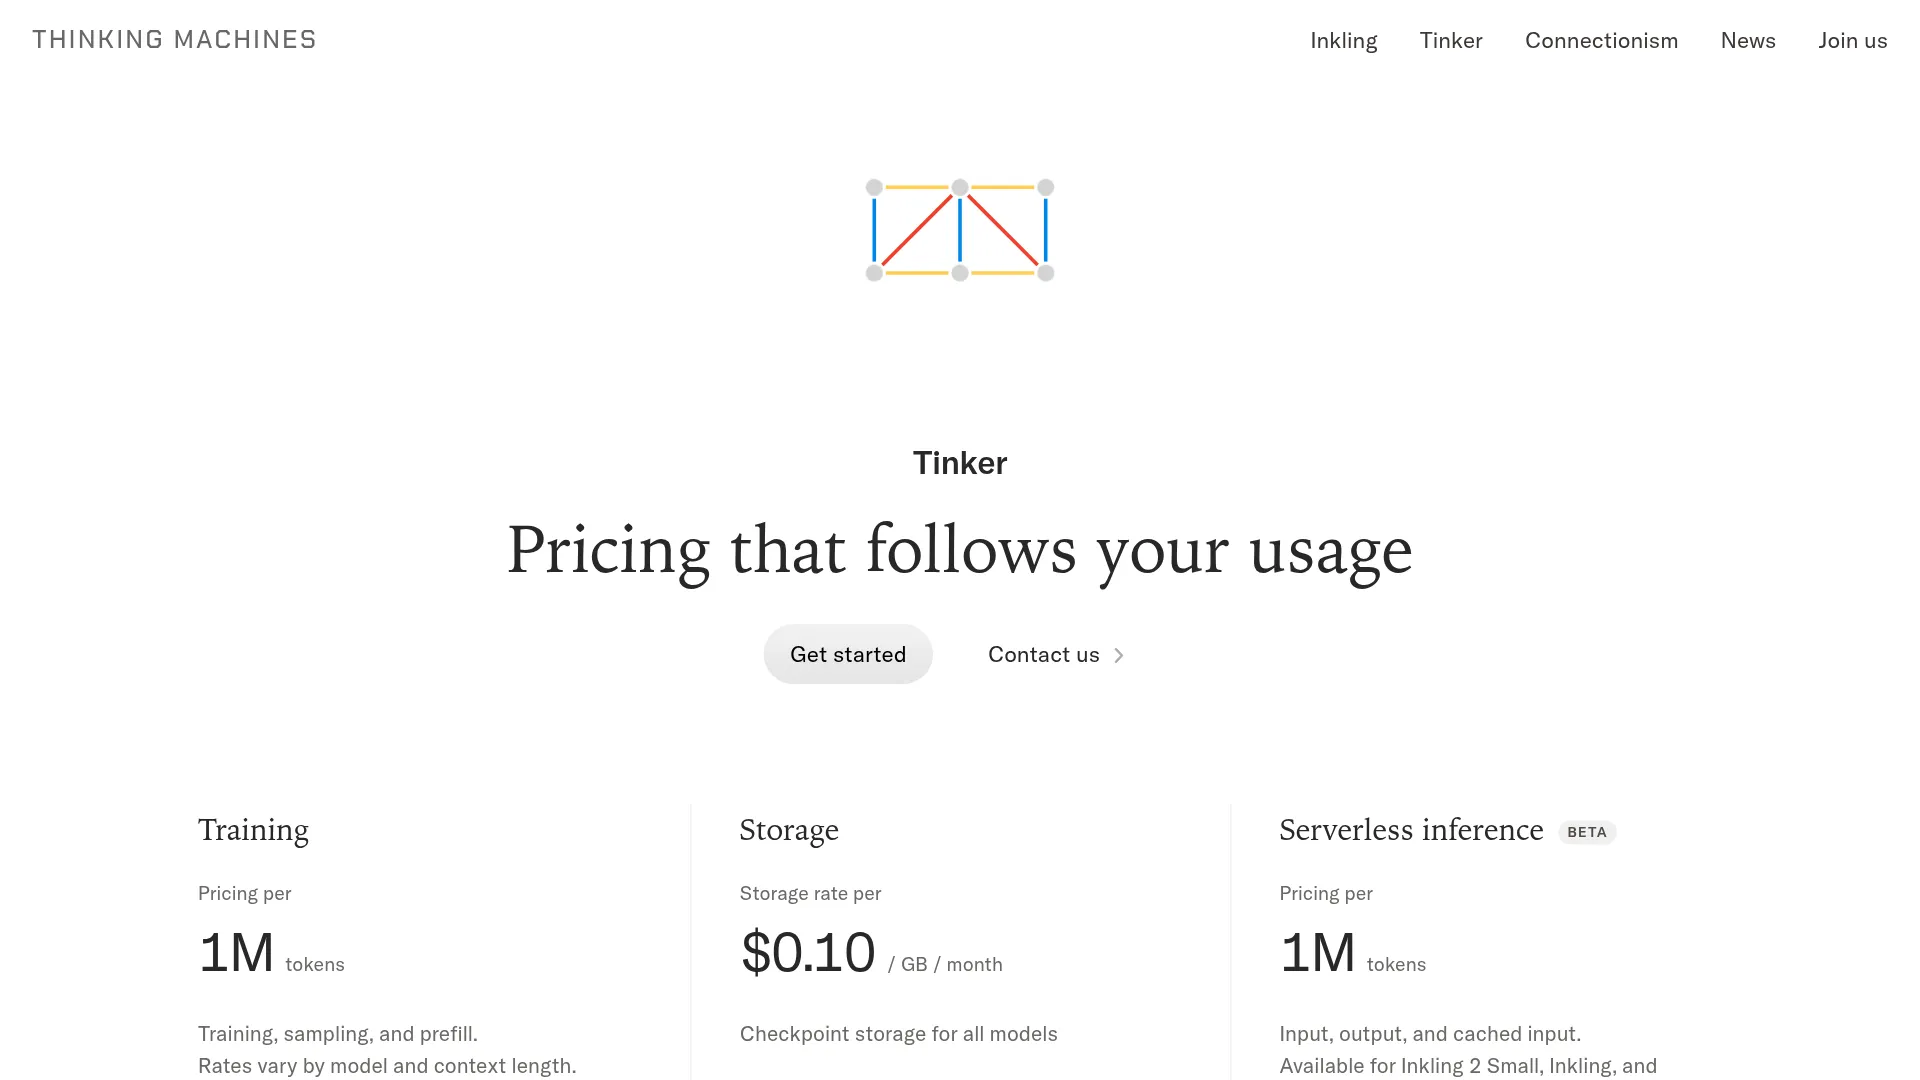
| Modelo (serverless, 256K) | Entrada / 1M | Cache / 1M | Saída / 1M |
|---|---|---|---|
| Inkling 2 Small | US$ 0,30 | US$ 0,03 | US$ 1,00 |
| Inkling-Small (gen 1) | US$ 0,30 | US$ 0,06 | US$ 1,20 |
| Inkling (flagship) | US$ 1,00 | US$ 0,17 | US$ 4,05 |
Com 80% de acertos de cache, 1M de tokens de entrada custam cerca de US$ 0,084 (200K x US$ 0,30 mais 800K x US$ 0,03). Rollouts longos com compactação são os que mais se beneficiam: o fornecedor informa mediana de 43K tokens por rollout e p99 de 1,5M nesse regime de treinamento (Thinking Machines Lab).
Benchmarks: onde lidera e onde o DeepSeek Flash vence
As pontuações abaixo vêm do relatório do fornecedor, que divulga tanto as derrotas quanto as vitórias (Thinking Machines Lab).
| Benchmark | Inkling 2 Small | Melhor rival na tabela |
|---|---|---|
| FrontierCode v2.0 | 25,4% | 28,5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72,1% | 77,0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86,3% | 88,2% Kimi K3 |
| Vibe Code Bench v1.1 | 81,6% | 87,7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28,7% | Lidera o grupo (Kimi K3 26,9%) |
| LongBench v2 | 70,6% | Lidera o grupo (Kimi K3 69,0%) |
| AA-Omniscience (pontuação / sem alucinação) | 16,1 / 73,3% | Maior taxa sem alucinação no grupo |
| Snapshot do DesignArena Web | 1.340 (3º) | 1.366 Muse Wonder (líder) |
| JobBench / Vals Legal / Vals Finance | 70,5% / 73,9% / 61,5% | Lidera os grupos exibidos |
| Terminal Bench Science | 5,7% | 12,9% DeepSeek-V4.1-Flash-1017 |
Os 70,6% no LongBench v2 sustentam a promessa de contexto longo, enquanto os 28,7% no HLE-Diamond são evidência de bom desempenho em raciocínio difícil. Nos testes corporativos, CoreCraft (71,8%) e DAYJOB Finance (14,3%) lideram seus grupos exibidos, ao lado de JobBench e Vals. Há ressalvas: no DiligenceBench, os 58,1% ficam atrás dos 59,0% do Muse Spark Open; no kernel autoresearch, o resultado é 6,02x contra 18,80x do Claude Opus 5.5; e o laboratório reconhece verbosidade, organização irregular, seleção imperfeita de ferramentas e excesso de recusas (FORTRESS 20,4 contra 3,2 do GLM-5.3).
O que mudou desde o Inkling-Small
O número total de parâmetros mais que dobrou, de 276B para 594B, enquanto os parâmetros ativos passaram de 12B para 17B. O comportamento em relação a alucinações melhorou, mas a entrada de áudio foi removida. O novo modelo aceita apenas texto e imagens; a primeira geração recebia WAV de 16 kHz (Thinking Machines Lab).
Os números do fornecedor apontam para uma melhora em factualidade, embora as gerações usem métricas diferentes. A geração um registrou cerca de 20,6% no SimpleQA Verified e uma pontuação Omniscience negativa (eesel AI). O Inkling 2 Small lidera seu grupo com taxa de 73,3% sem alucinação, embora o laboratório ainda alerte para verbosidade e excesso de recusas (Thinking Machines Lab).
Relatos de self-hosting da primeira geração servem como contexto, não como evidência sobre a v2:
"Dei uma chance no Unsloth Studio, em Q4K_XL. Ele está indo muito bem em conversas multilíngues." — u/VotZeFuk no tópico de lançamento do Inkling-Small de primeira geração (Reddit)
O piso de 89 GB em 2-bit da primeira geração veio de builds comunitários do Unsloth (eesel AI); com 594B de parâmetros totais, os requisitos da v2 seguem desconhecidos até que os pesos e as receitas sejam publicados.
Seu agente deve chamar o Inkling 2 Small?
A decisão de roteamento depende mais do formato da carga de trabalho do que da posição agregada nos benchmarks.
| Sua carga de trabalho | Usar o Inkling 2 Small? | Por quê |
|---|---|---|
| Agentes de programação de longo horizonte com feedback visual | Teste via Tinker | O treinamento com compactação e os loops de iteração visual combinam com esse perfil |
| Pesquisa corporativa, finanças e redação jurídica com retrieval | Teste primeiro | Lidera JobBench, Vals Legal/Finance e DAYJOB Finance nas tabelas do fornecedor; valide com seus documentos |
| Fine-tuning em tarefas no estilo de sumarização | Teste (apenas avaliação do fornecedor) | Atingiu a qualidade final da primeira geração em 75 etapas no teste de 200 etapas do fornecedor (Thinking Machines Lab) |
| Programação pura no estilo SWE-bench, buscando a menor taxa de erro | Não; use DeepSeek-V4.1-Flash-1017 | 72,1% contra 77,0% no DeepSWE e 25,4% contra 28,5% no FrontierCode |
| Perguntas e respostas factuais sem retrieval ou guardrails | Não, ainda não | Os 16,1 de Omniscience geral ficam atrás do melhor rival; mantenha RAG com roteamento por confiança |
| Necessidade de failover entre múltiplos provedores | Não; espere | Há apenas a rota Tinker de um único fornecedor, sem rotas de terceiros anunciadas |
As pontuações de alinhamento melhoraram em relação às antecessoras (comportamento inadequado interno de 14,9 contra 66,8 a 75,2; menor é melhor), mas ainda ficam atrás dos 0,8 do GPT-6.1 Sol (Thinking Machines Lab).
Perguntas frequentes sobre o Inkling 2 Small
O Inkling 2 Small já tem pesos abertos?
Não. Em 5 de novembro de 2026, os pesos permanecem fechados no Tinker; pesos sob Apache 2.0 estão prometidos para a próxima semana, dependendo dos testes de segurança.
Qual é a diferença em relação ao Inkling-Small?
594B/17B contra 276B/12B, sem entrada de áudio, 73,3% sem alucinação e US$ 1,00 contra US$ 1,20 por 1M de tokens de saída.
Quanto custa a API por 1M de tokens?
US$ 0,30 para entrada, US$ 0,03 para entrada em cache e US$ 1,00 para saída, com contexto de 256K no serverless do Tinker.
Posso executá-lo localmente?
Ainda não; não foram publicados pesos, receitas nem orientações de VRAM.
Leitura relacionada: review de programação do DeepSeek-V4.1-Flash-1017 e preços da API do Kimi K3.1 Pro.