 AIREITER
No papel, o Kimi K3.1 Pro, da Moonshot, reúne o que se espera de um modelo forte para programação e agentes: contexto de 1 milhão de tokens, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Nos workloads relatados durante a semana de lançamento, o uso da API sob demanda saiu muito mais barato que a assinatura de US$ 39.
O que é o Kimi K3.1 Pro na prática
O Kimi K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot AI. Lançado em 23 de outubro de 2026, ele sucede o Kimi K3 após treinamento posterior. Segundo a Moonshot, trata-se de um modelo mixture-of-experts de classe 3T voltado a programação de longo horizonte, fluxos de ferramentas 3D e CAD, análise de documentos financeiros e agentes com múltiplas etapas.
A janela de contexto tem 1.048.576 tokens, compartilhados entre entrada, tokens de raciocínio e saída. Ou seja, não são 1M de entrada mais 1M de saída. Os produtos da Moonshot aceitam texto, imagens e vídeo como entrada; pela API, o modelo retorna texto, código e chamadas de ferramentas, enquanto softwares externos, como Blender, engines de jogos e ferramentas de PDF, geram o artefato visual. O raciocínio está sempre ativo, com os níveis low, high e max em reasoning_effort; o padrão é max.
A Moonshot prometeu disponibilizar os pesos abertos até 4 de novembro, mas a verificação da TheQuery em 24 de outubro não encontrou checkpoint para download nem licença final. A ArtificialWatch também classificou a licença como desconhecida. Até que um checkpoint e uma licença sejam publicados, o plano é usar a API hospedada.
Preços da API: Standard e Highspeed sem confusão
Na plataforma de API da Kimi, o Kimi K3.1 Pro Standard custa US$ 2 por milhão de tokens de entrada sem cache e US$ 10 por milhão de tokens de saída. O Kimi K3.1 Pro Highspeed dobra as tarifas dos tokens medidos, para US$ 4 na entrada e US$ 20 na saída, mas mantém a leitura de entrada em cache por US$ 0,20. A divisão de US$ 2/US$ 10 e US$ 4/US$ 20 também aparece na ArtificialWatch e na tabela de preços da AI/ML API.
| Operação (por 1M de tokens) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Entrada sem cache | US$ 2,00 | US$ 4,00 |
| Saída, incluindo raciocínio | US$ 10,00 | US$ 20,00 |
| Leitura de entrada em cache | US$ 0,20 | US$ 0,20 |
| Gravação em cache, duração de 5 minutos | US$ 2,00 | US$ 4,00 |
| Gravação em cache, duração de 1 hora | US$ 4,00 | US$ 8,00 |
Há três detalhes de cobrança mais importantes que o preço de tabela. Primeiro: as tarifas não variam com o tamanho do contexto, e a duração padrão do cache é de cinco minutos. Ao reutilizar um prefixo de prompt dentro dessa janela, o custo cai de US$ 2,00 para US$ 0,20. Segundo: tokens de raciocínio são cobrados pela tarifa de saída; portanto, max em um longo rastreio de agente pode dominar a conta. Terceiro: as cobranças da API são separadas das assinaturas Kimi e Kimi Code. A checagem da TheQuery no guia da Batch API constatou que o K3.1 Pro não estava listado, então não presuma que há desconto de lote.
Com essas tarifas, um exemplo de volume fixo custa pouco: 100.000 tokens de entrada sem cache (US$ 0,20) mais 10.000 tokens de saída (US$ 0,10) totalizam US$ 0,30 antes de gravações de cache, ferramentas, tentativas novamente e impostos.
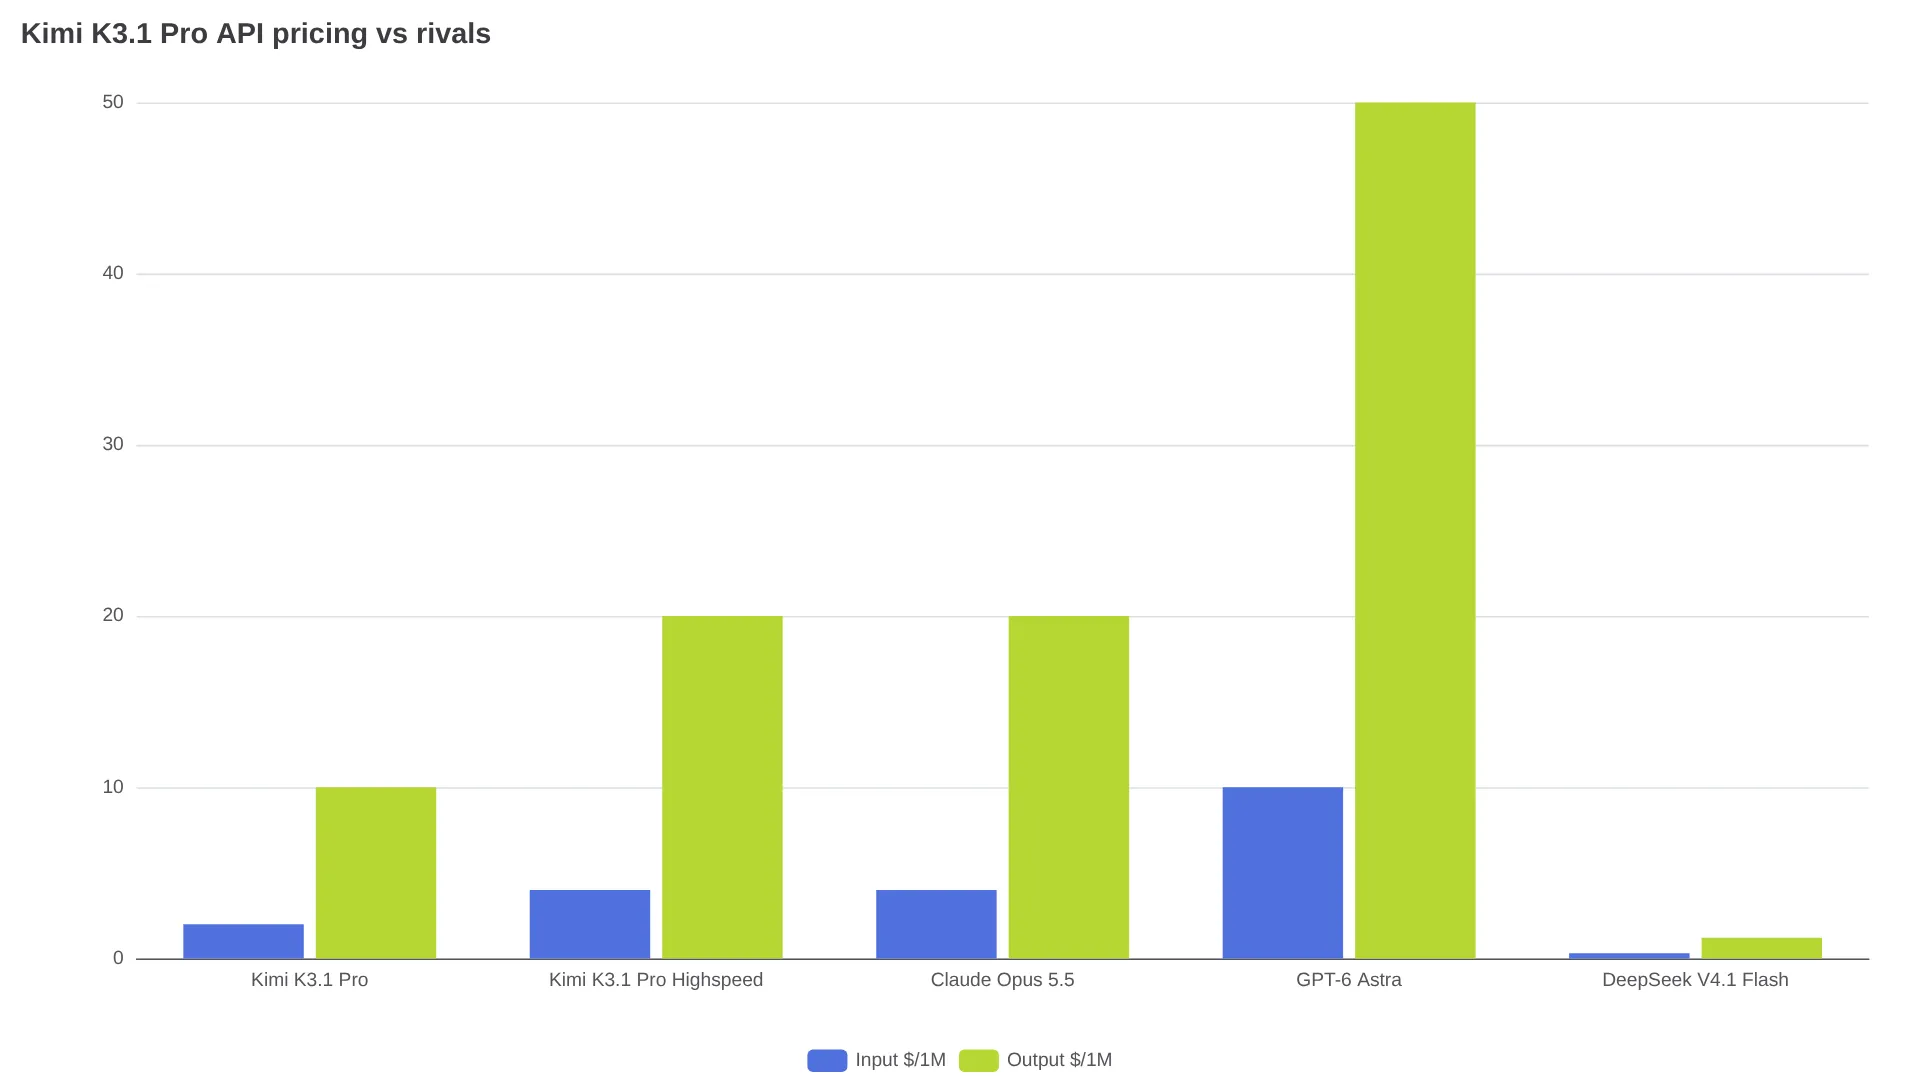
Na comparação com rivais, o K3.1 Pro Standard é 33% mais barato que o Kimi K3 (US$ 3/US$ 15), custa metade do Claude Opus 5.5 (US$ 4/US$ 20) e um quinto do GPT-6 Astra (US$ 10/US$ 50), segundo a comparação da ArtificialWatch. O DeepSeek V4.1 Flash supera todos os rivais listados em preço, a US$ 0,30/US$ 1,20 segundo a tabela da AI/ML API, mas seus resultados nos benchmarks da próxima seção ficam muito atrás. O Highspeed empata exatamente com o preço do Opus 5.5; por isso, só vale a pena quando o ganho de velocidade alegado de 2-3x reduz uma tarefa limitada por latência o bastante para compensar o dobro no custo de tokens.
Por que a assinatura de US$ 39 esgota tão rápido — e a API não
O preço da API pareceu justo no lançamento; a assinatura, não. Vários usuários pagantes relataram que a cota de 5 horas desapareceu após um ou dois prompts, enquanto cotas mensais eram consumidas por uma única tarefa de programação.
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech, consumo de cota relatado por usuário
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab, assinante do plano de US$ 39
Um usuário relatou ter gasto US$ 400 em assinaturas para quatro prompts e estimou que o mesmo trabalho custaria US$ 29 pela API. Outro informou que uma única tarefa de animação consumiu a maior parte da cota de 5 horas. Para desenvolvedores, a conclusão é direta: avalie o K3.1 Pro pela API sob demanda — Moonshot, OpenRouter ou Vercel AI Gateway —, em que 100 mil tokens de entrada mais 10 mil de saída custam US$ 0,30 antes de tentativas novamente e ferramentas. Não faça essa avaliação pela cota de uma assinatura, que mede o mesmo raciocínio de forma muito mais restritiva.
Benchmarks: os números e as ressalvas do fornecedor
Todos os resultados principais abaixo foram divulgados pela Moonshot, salvo indicação contrária. Os testes rodaram com esforço máximo de raciocínio, temperatura 1.0 e top-p 0.95. Diferenças pequenas dependem da configuração: os concorrentes foram avaliados com harnesses distintos — Kimi Code para o Kimi, Claude Code para os demais e Codex para o GPT-6 Astra no OfficeQA —, como documenta a AI/ML API.
| Avaliação | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% | 42,3% |
| SWE-Marathon v1.1 | 51,7% | 46,3% | 42,5% | 40,0% |
| Agents' Last Exam v1.1 | 43,2% | 42,6% | 32,8% | 37,7% |
| OfficeQA Pro v2 | 64,4% | 62,2% | 54,4% | 40,4% |
| BenchCAD com ferramentas | 92,7% | 96,2% | 95,9% | 81,6% |
O Kimi lidera em três de cinco testes e fica 0,7 ponto atrás no Terminal-Bench — diferença que a TheQuery observa ser menor que o erro-padrão de 2,6 pontos relatado pela Anthropic para o Opus. Os 92,7% no BenchCAD representam sobreposição de voxels em um subconjunto de 1.000 casos de modelos abertos. Já os números do Claude foram importados de system cards, e não obtidos em uma nova execução uniforme, segundo as notas metodológicas da AI/ML API.
Em factualidade, o Kimi Hallu Bench interno da Moonshot aponta erro de 5,4% por afirmação para o K3.1 Pro no conjunto Standard, contra 4,2% do GPT-6 Astra. No conjunto Hard with-tools, os números são 8,3% e 5,5%, respectivamente, conforme a tabela Hallu da AI/ML API. Isso equivale a uma redução relativa de 65% diante da taxa de 23,4% do K3 no conjunto difícil, mas o Astra continua à frente nas duas divisões. Portanto, mantenha o Astra na lista curta quando uma única afirmação incorreta compromete o resultado. Todos são testes adversariais de estresse, não probabilidades de erro no uso cotidiano.
O único dado independente disponível no lançamento veio da Artificial Analysis, que atribuiu 55 ao K3.1 Pro em seu Intelligence Index e o colocou em 4º lugar no geral, atrás de Claude Opus 5.5, Sonnet 5.5 e Muse Wonder Full. Essa posição sustenta a tese de "quase fronteira pela metade do preço" sem depender apenas dos testes do fornecedor.
Como chamar a API sem pagar além do necessário
O Kimi K3.1 Pro é compatível com OpenAI, então a migração se resume a trocar a base URL e o ID do modelo. A base oficial é https://api.moonshot.ai/v1, com os IDs kimi-k3.1-pro e kimi-k3.1-pro-highspeed, conforme a checagem de endpoint da TheQuery e o guia de configuração da AI/ML API. Gateways de terceiros usam IDs com namespace, como moonshot/kimi-k3.1-pro no Requesty ou moonshotai/kimi-k3.1-pro na Vercel.
O quickstart fixa temperatura em 1.0 e top-p em 0.95, recomendando omiti-los em vez de tentar ajustá-los, segundo as notas da TheQuery sobre o comportamento da API. Para controlar custos, ajuste reasoning_effort: comece com low em testes exploratórios, suba para high quando a tarefa falhar e deixe max, o padrão, para a execução final. Um orçamento de 8.192 tokens em max_completion_tokens pode devolver uma resposta visível bem menor, pois o raciocínio oculto consome o mesmo orçamento à tarifa de US$ 10 por milhão.
Checklist para controlar custos, conforme as orientações da AI/ML API sobre uso de ferramentas e tokens:
- Preserve a mensagem completa do assistente entre etapas de ferramentas, incluindo
reasoning_contentdurante streaming, e retorne os resultados das ferramentas antes da próxima chamada. - Reutilize prefixos de prompt dentro da janela de cache de 5 minutos para reduzir a entrada repetida a US$ 0,20 por milhão.
- Meça o custo por resultado aceito, não por token.
- Um modelo mais barato por token que exige duas tentativas novamente não é mais barato.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Uma recarga de US$ 1 libera o acesso, sujeito a limites de taxa por nível, e o acesso empresarial vem desativado por padrão até ser habilitado por um administrador, segundo a checagem da TheQuery sobre o comportamento da API. Quanto à privacidade, a auditoria da Opper sobre a rota da Moonshot informa que o conteúdo é retido e os dados de clientes são usados em treinamento por padrão, sem opção de retenção zero de dados nessa rota. Não envie dados confidenciais ou regulados por ela sem salvaguardas contratuais.
Vale usar? O trade-off que entra na conta
| Se você precisa de | Escolha | Motivo |
|---|---|---|
| Execuções de programação de classe fronteira pelo menor custo | API do Kimi K3.1 Pro | Lidera o SWE-Marathon pela metade do preço do Opus, com 1M de contexto compartilhado |
| Menor latência | Kimi K3.1 Pro Highspeed | Ganho de velocidade alegado de 2-3x, mas custo de tokens exatamente 2x maior |
| Menos erros factuais | GPT-6 Astra | 4,2% contra 5,4% no Hallu Standard, por 5x o preço |
| Tokens mais baratos, com resultados mais fracos | DeepSeek V4.1 Flash | US$ 0,30/US$ 1,20, mas o menor resultado em quatro dos cinco benchmarks listados |
| Hospedagem própria | Aguarde | Pesos prometidos para 4 de novembro, com licença desconhecida |
Se a Moonshot publicar os pesos completos sob uma licença permissiva até 4 de novembro, a hospedagem própria poderá mudar a conta entre cotas e API. Desenvolvedores comparando modelos de programação com contexto longo também devem consultar o melhor LLM para agentes de programação em 2026 antes de se comprometerem.
Perguntas frequentes sobre a API do Kimi K3.1 Pro
Quanto custa a API do Kimi K3.1 Pro?
O Kimi K3.1 Pro Standard custa US$ 2 por milhão de tokens de entrada sem cache e US$ 10 por milhão de tokens de saída. Leituras de entrada em cache custam US$ 0,20 por milhão. O Highspeed dobra as tarifas de entrada, saída e gravação em cache, mas mantém a leitura em cache a US$ 0,20.
Qual é a diferença entre o K3.1 Pro e o Highspeed?
O Highspeed anuncia a mesma inteligência com velocidade de atendimento 2-3x maior, pelo dobro do preço de entrada e saída: US$ 4/US$ 20 contra US$ 2/US$ 10. A tabela ao vivo de provedores da Vercel indica menor latência e maior throughput no Highspeed, mas a alegação de velocidade da Moonshot não conta com uma comparação independente de conclusão de tarefas.
Quais são os IDs dos modelos na API?
Use kimi-k3.1-pro e kimi-k3.1-pro-highspeed na API oficial da Kimi, ou equivalentes com namespace, como moonshot/kimi-k3.1-pro, em gateways de terceiros. Integrações existentes com o K3 precisam trocar os IDs explicitamente.
O uso da API está incluído em uma assinatura Kimi?
Não. As cobranças da API são separadas das assinaturas Kimi e Kimi Code, e usuários da semana de lançamento constataram que as cotas da assinatura eram muito mais restritivas que os tokens sob demanda para o mesmo trabalho.
É possível desativar o raciocínio?
Não. O Kimi K3.1 Pro sempre raciocina; low, high e max apenas reduzem o nível de deliberação, sendo max o padrão. Para solicitações curtas sem raciocínio, use outro modelo.
A API é compatível com OpenAI?
Sim. Aponte um cliente do SDK da OpenAI para https://api.moonshot.ai/v1, ou para a base URL de um gateway, defina o ID do modelo e faça streaming com stream=True. Temperatura 1.0 e top-p 0.95 são fixados pelo quickstart. Ajuste reasoning_effort e max_completion_tokens em vez disso.