 AIREITER
Um agente de programação que lê arquivos, executa testes e repete o ciclo até chegar a uma solução pode consumir entre 50.000 e 200.000 tokens por issue resolvida. Considerando os $30/M de tokens de saída do GPT-5.6 Sol, só essa parcela já custa de $1.50 a $6 por tarefa. O DeepSeek V4 Pro cobra $0.87/M na saída — cerca de 1/34 do valor —, embora sua confiabilidade em tarefas de várias etapas ainda não tenha sido avaliada de forma independente com a mesma profundidade aplicada a Claude ou GPT. A seguir, a comparação de seis modelos por benchmarks públicos de programação, preços de API verificados, limites de contexto e o tipo de fluxo de agente mais adequado para cada um.
Os seis modelos que importam para agentes de código em 2026
Cada modelo combina resultados de benchmarks obtidos em fontes oficiais ou rankings públicos com preços de API verificados em agosto de 2026. Quando o modelo exato não tem uma pontuação publicada, foi usada a variante disponível mais próxima, identificada explicitamente como referência.
1. Claude Opus 5 — Para máxima qualidade
O Claude Opus 5 mantém a liderança da família Claude no ranking oficial do SWE-bench Verified. Seu antecessor, Claude 4.5 Opus, alcançou 76.8% com o harness mini-SWE-agent. É uma boa referência para o patamar esperado do Opus 5, mas ainda não há resultados de SWE-bench Verified publicados especificamente para ele. O Opus 5 oferece janela de contexto de 1 milhão de tokens e saída máxima de 128K tokens. Com preço de $5/M na entrada e $25/M na saída, é a opção mainstream mais cara desta lista. Faz sentido quando uma refatoração malsucedida em vários arquivos custa mais horas de trabalho humano do que o gasto com tokens. Para alterações rotineiras em alto volume, não é a melhor escolha.
2. GPT-5.6 Sol — Especialista em tarefas de terminal
O GPT-5.6 Sol (ID do modelo gpt-5.6-sol) custa $5/M de entrada e $30/M de saída, com janela de contexto de 1.05 milhão de tokens. Na comparação de benchmarks publicada pela xAI, o GPT-5.6 Sol Max lidera no Terminal-Bench v3.0, com 34.6% contra 26% do Grok 4.6, e também no DeepSWE v1.1, com 73%. São os benchmarks mais relevantes para loops de agentes orientados por terminal. O preço é a contrapartida: a $30/M de saída, Sol é o modelo mais caro do grupo. A OpenAI também informa resultados no SWE-bench Pro de 64.6% para Sol e 63.4% para Terra, a variante intermediária, o que pode ajudar quem procura uma opção OpenAI mais barata para tarefas menos exigentes.
3. Grok 4.6 — Melhor custo-benefício para agentes de longa duração
Lançado em 12 de agosto de 2026, o Grok 4.6 foi pensado para fluxos de agentes que rodam por mais tempo. Segundo o anúncio da xAI, ele empata com o GPT-5.6 Sol Max no Artificial Analysis Intelligence Index, com 61, e supera o rival no CursorBench v3.2 (69.9% contra 67.2%), FrontierCode v1.1 (61.3% contra 60.6%) e APEX-Agents (57.5% contra 56.7%). Cobrando $2/M de entrada e $6/M de saída, entrega desempenho de benchmark comparável ao GPT-5.6 Sol Max por cerca de um quinto do custo de saída. O ponto fraco é a execução pura no terminal: seus 26% no Terminal-Bench v3.0 ficam bem abaixo dos 34.6% do Sol Max. Se o fluxo do seu agente gira mais em torno de IDEs, como Cursor e Grok Build, do que do terminal, o Grok 4.6 é a opção desta lista com melhor relação entre qualidade e preço. A variante "fast" dobra os preços para $4/$12 em troca de menor latência. A janela de contexto é de 500K tokens.
4. DeepSeek V4 Pro — A escolha para orçamentos apertados
O DeepSeek V4 Pro é o modelo de patamar frontier mais barato disponível via API: $0.435/M de entrada e $0.87/M de saída, com entrada em cache caindo para $0.003625/M. A janela de contexto de 1 milhão de tokens e a saída máxima de 384K tokens o tornam viável para tarefas no escopo de um repositório inteiro. Não há benchmark público de agentes em múltiplas etapas que compare o DeepSeek V4 Pro com Claude ou GPT sob a mesma profundidade de harness. Por isso, antes de adotá-lo para refatorações complexas, valide no seu próprio ambiente a confiabilidade das chamadas de ferramentas em sessões longas. Para equipes com restrição de orçamento ou como modelo de primeira passagem em uma arquitetura de roteamento, a conta fecha muito bem. Nas refatorações mais difíceis, envolvendo vários arquivos e nas quais confiabilidade vale mais do que o preço dos tokens, espere escalar a tarefa para outro modelo.
5. Gemini 3.1 Pro — Para ler contextos gigantes
O Gemini 3.1 Pro Preview do Google, disponível na API Gemini, custa $2/M de entrada e $12/M de saída para prompts com menos de 200K tokens. Acima desse limite, os preços sobem para $4/$18. Seu grande diferencial é a capacidade de contexto: a janela de 2 milhões de tokens do Gemini é a maior entre os modelos listados, adequada para analisar uma base de código inteira em uma única passada. Como referência para o patamar esperado do 3.1 Pro, o Gemini 3 Flash marcou 75.8% no SWE-bench Verified em um recorte de junho de 2026 da Tembo, atrás apenas do Claude 4.5 Opus. A consistência das chamadas de ferramentas do Gemini em loops extensos de agentes ainda não foi medida com a mesma profundidade de Claude ou GPT; teste-o no seu harness antes de colocá-lo em produção em fluxos de várias etapas.
6. Kimi K3 — A alternativa de pesos abertos
O Kimi K3, da Moonshot AI, obteve 70.8% no SWE-bench Verified no mesmo recorte de junho de 2026. Entre os modelos de pesos abertos, ficou abaixo do GLM-5, com 72.8%, e do MiniMax M2.5, com 75.8%. Por ser um modelo de pesos abertos, pode ser hospedado pela própria equipe quando o código não pode sair da rede da empresa. A API hospedada da Moonshot também oferece o K3, mas o preço específico varia conforme a configuração de implantação. Para ambientes locais com GPUs adequadas, o K3 combinado a um harness leve como o OpenCode entrega um agente de programação capaz sem custo de API por token.
Preços de API e custo por issue resolvida
O preço por token conta apenas metade da história. Para agentes de programação, o número que interessa é o custo por tarefa concluída: quanto custa resolver uma issue real do GitHub em um loop de agente.
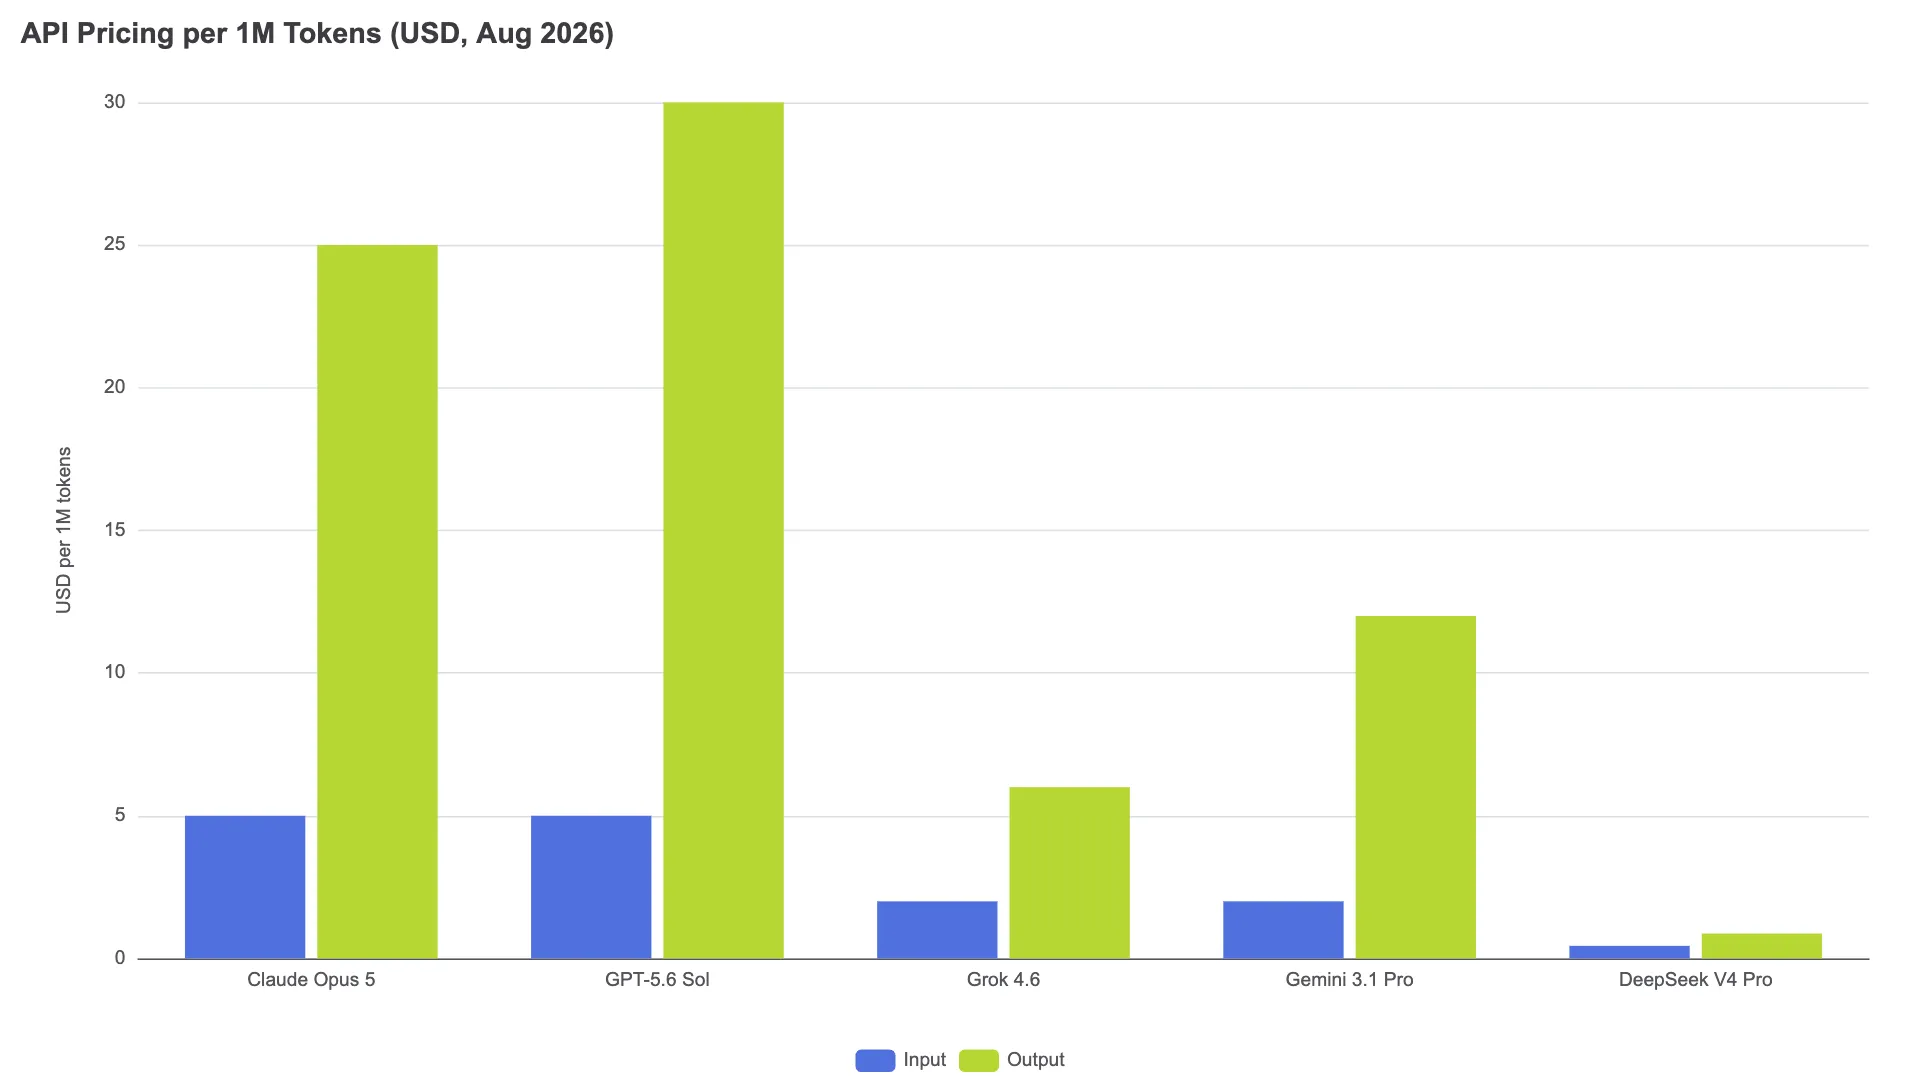
Um loop típico de agente — ler arquivos, planejar, editar, rodar testes e corrigir falhas — consome aproximadamente 50K a 200K tokens por issue resolvida, sendo 30% a 50% desse total tokens de saída. Esses números são estimativas do setor, baseadas em análises de loops de agentes da Tembo e de outras fontes. O consumo real depende do tamanho do repositório, da duração da suíte de testes e da eficiência do harness. Usando o ponto médio de 125K tokens totais, sendo 75K de entrada e 50K de saída, este é o custo por issue resolvida em cada modelo:
| Modelo | Custo de entrada | Custo de saída | Total por tarefa |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
O Kimi K3 ficou fora da tabela porque seu custo depende inteiramente de usar a API hospedada da Moonshot ou fazer self-hosting nas próprias GPUs; não há um único preço de tabela para comparar. O Grok 4.6 ocupa um ponto especialmente interessante a $0.45: iguala a pontuação do GPT-5.6 Sol Max no Artificial Analysis Intelligence Index por cerca de um quarto do custo por tarefa do Sol.
As estimativas não incluem novas tentativas, descontos para tokens em cache, overhead de chamadas de ferramentas nem infraestrutura. Na prática, um modelo que exige mais tentativas ou correções humanas por tarefa custará mais do que seu preço por token sugere. Por isso, rotear trabalhos rotineiros para DeepSeek ou Grok e escalar refatorações difíceis para Opus pode funcionar melhor do que se comprometer com um único modelo.
Qual modelo usar em cada fluxo de agente
Não existe um modelo único que sirva para todos os fluxos. Veja qual conectar a cada tipo de trabalho do agente.
Ciclos rápidos e alterações rotineiras. Use o Gemini 3.5 Flash ($1.50/$9 por M tokens) ou Claude Sonnet 5 para trabalhos frequentes e de baixo risco: explicações de erros, pequenas funções novas, esqueletos de testes e atualizações de documentação.
Refatoração profunda e arquitetura. Claude Opus 5 é a escolha quando a tarefa envolve mudanças em vários arquivos, dependências entre módulos ou decisões de arquitetura nas quais um palpite errado representa horas de depuração. Seus principais diferenciais são a precisão em seguir instruções e a capacidade de manter coerência de contexto em sessões longas.
Agentes autônomos de longa duração. O Grok 4.6 foi desenvolvido exatamente para esse cenário. Conforme o anúncio da xAI, seu desenvolvimento priorizou trajetórias sustentadas de agentes com comportamento de autoverificação. A $0.45 por tarefa, é possível deixá-lo trabalhar por mais tempo sem a pressão de custo criada pelos $1.88 por tarefa do GPT-5.6 Sol. Para fluxos pesados em terminal, a liderança do GPT-5.6 Sol no Terminal-Bench, com 34.6%, faz dele a escolha mais segura.
Orçamento limitado e self-hosting. Via API, o DeepSeek V4 Pro é a escolha padrão para equipes sensíveis a custo, com $0.077 por tarefa. Para organizações que não podem enviar código a APIs externas, hospede um modelo de pesos abertos como Kimi K3 (70.8% no SWE-bench Verified) ou MiniMax M2.5 (75.8%). O segmento de pesos abertos reduziu a diferença para os líderes de pesos fechados a poucos pontos percentuais no SWE-bench Verified.
O harness pode limitar o desempenho do modelo
O harness usado pelo agente — Claude Code, Codex CLI, Cursor ou uma ferramenta open source como OpenCode — controla quatro aspectos que o modelo não controla: gestão de contexto, incluindo quando compactar e o que preservar; definições e roteamento de ferramentas; padrões de recuperação de erros; e fluxos de revisão e aprovação. Como observa a análise da Tembo, a pontuação de um modelo em um harness controlado como mini-SWE-agent pode não refletir sua taxa real de resolução em uma configuração diferente. É por isso que benchmarks que mantêm o harness constante são mais úteis para comparar modelos do que pontuações divulgadas por fornecedores que misturam ganhos do modelo e do harness.
Antes de trocar de modelo, audite seu harness. Verifique se o agente compacta o contexto de forma eficiente, se as definições das ferramentas estão claras e se a recuperação de erros faz novas tentativas de modo sensato, em vez de entrar em loop.
Perguntas frequentes
Qual LLM é mais barato para agentes de programação?
O DeepSeek V4 Pro, a $0.435/M de entrada e $0.87/M de saída, é a opção de patamar frontier mais barata. O custo é de aproximadamente $0.08 por tarefa resolvida pelo agente.
Como testar modelos de agentes de programação no meu próprio repositório?
Separe de 20 a 30 issues representativas do seu backlog real, misturando correções de bugs, recursos novos e refatorações. Execute cada modelo no harness escolhido e nas mesmas tarefas. Acompanhe três métricas: taxa de resolução, ou seja, se o patch do agente passou nos testes; consumo de tokens por tarefa; e tempo até a conclusão. Essa avaliação específica do repositório é mais preditiva do que qualquer benchmark público.