 AIREITER
Para quem precisa baixar e rodar um checkpoint por conta própria nesta semana, a escolha entre esses dois modelos ainda não existe: apenas o MiniMax M3.1 Flash tem pesos abertos disponíveis. A Moonshot promete liberar os pesos do Kimi K3.1 Pro até 4 de novembro de 2026, mas, por enquanto, só o modelo da MiniMax pode ser baixado do Hugging Face.
Hoje, só o MiniMax tem pesos no Hugging Face
A MiniMax publicou os pesos do M3.1 Flash por volta de 22–23 de outubro de 2026 no Hugging Face, sob a licença minimax-community. A cobertura de lançamento também informa disponibilidade no ModelScope (Cocoloop). Já o blog técnico oficial da Kimi diz que o Kimi K3.1 Pro está disponível hoje pelo Kimi.com, aplicativos, Kimi Code e API da Kimi, enquanto os pesos completos ficam para até 4 de novembro de 2026 (kimi.com).
MiniMax M3.1 Flash e Kimi K3.1 Pro: diferenças dos checkpoints
O M3.1 Flash Open Weights é um MoE multimodal nativo, com aproximadamente 428 bilhões de parâmetros totais e 23 bilhões ativos por token. Ele recebe texto, imagens e vídeo, gera texto e suporta até 1 milhão de tokens de contexto (post de lançamento da MiniMax). O Kimi K3.1 Pro é oficialmente apresentado como um MoE da classe de 3T, também com janela de contexto de 1 milhão de tokens (kimi.com). Os números de 2,8T de parâmetros totais e 104B ativos vêm da cobertura de lançamento, não de uma divulgação de parâmetros da própria Moonshot (ArtificialWatch, ExplainX).
| Item | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Parâmetros totais / ativos | ~428B / 23B por token | Classe 3T; cobertura de lançamento reporta 2,8T / 104B ativos |
| Repositório no Hugging Face | MiniMaxAI/MiniMax-M3.1-Flash, disponível | Nenhum em 24 de outubro de 2026; previsto até 4 de novembro |
| Tamanho do download | Cerca de 252 GB | Desconhecido; na densidade do MiniMax (~0,59 GB por B de parâmetros), um checkpoint de 2,8T seria da classe dos TB |
| Contexto | Até 1M de tokens, dependendo da implantação | 1M de tokens |
| Entradas / saída | Texto, imagem e vídeo como entrada; texto como saída | Multimodal, saída em texto; modalidades exatas em self-hosting ainda não confirmadas |
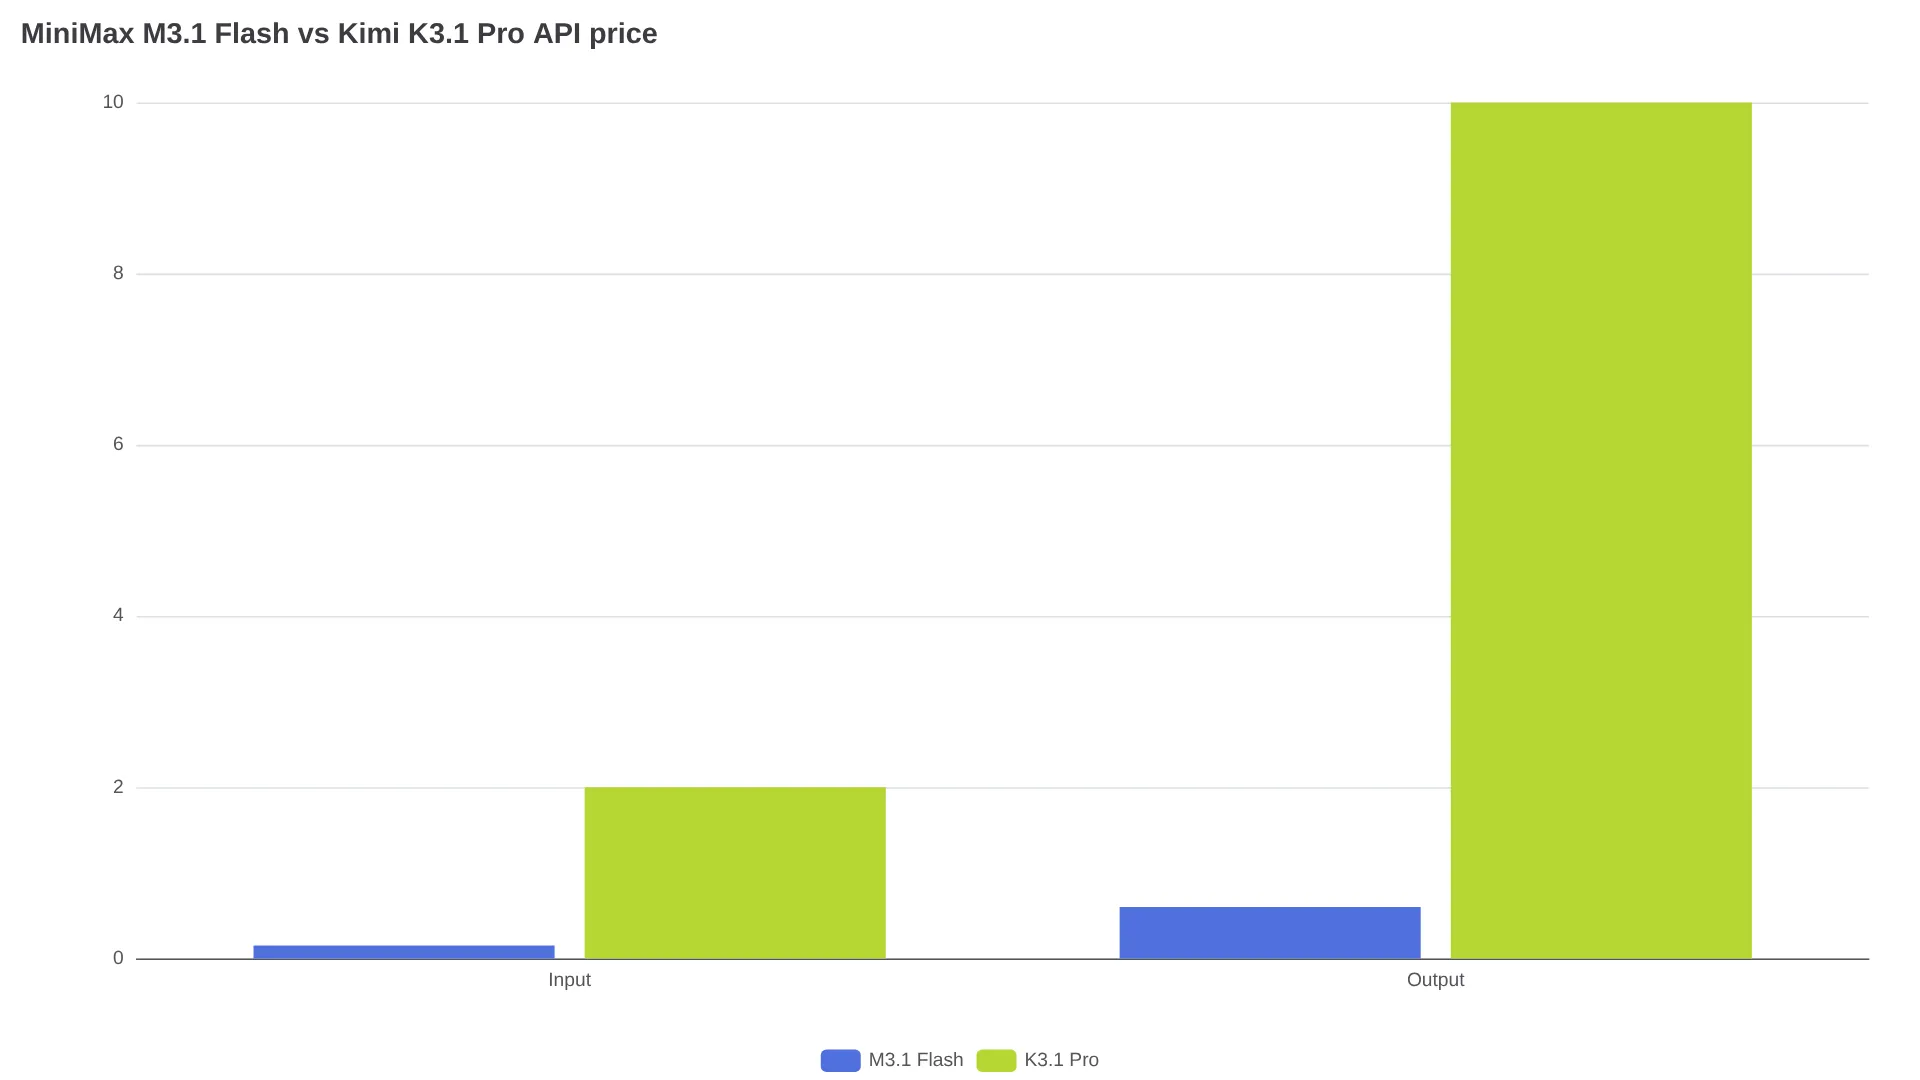
| Preço oficial de API | US$ 0,15 de entrada / US$ 0,60 de saída / US$ 0,015 em cache por 1M de tokens (MiniMax) | US$ 2 de entrada / US$ 10 de saída por 1M de tokens, segundo reportado (ArtificialWatch) |
| Receitas de serving | SGLang, vLLM, TokenSpeed; FlagOS para múltiplos chips | Não anunciadas; IDs de modelo na API: kimi-k3.1-pro / kimi-k3.1-pro-highspeed (documentação da Kimi) |
| Amostragem recomendada | Temperature 1.0, top-p 0.95; raciocínio de low a max | Esforço máximo de raciocínio, temp 1.0, top-p 0.95, conforme a configuração de benchmark da Kimi |
Para baixar o checkpoint da MiniMax, use o comando oficial:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashAntes de rodar benchmarks, confira se o conjunto completo de arquivos foi baixado, incluindo a cabeça de draft DSpark, tokenizer e arquivos de configuração. A MiniMax alerta que os resultados se aplicam aos pesos oficiais e que quantizações de terceiros podem se comportar de forma diferente.
Nos benchmarks, considere todos os números abaixo como informados pelo fornecedor, salvo quando houver indicação de fonte independente:
| Benchmark | M3.1 Flash (fornecedor) | Concorrente citado pelo fornecedor |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (empate) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Um retrato independente citado coloca o M3.1 Flash no meio do pelotão, com 53,78% e a 16ª posição entre 26 modelos, além de resultados fracos em tarefas de longo horizonte (Vals). No gráfico da própria Kimi, o K3.1 Pro lidera 6 dos 14 testes exibidos, incluindo Agents' Last Exam (43.2) e SWE Marathon (51.7), e marca 65.7 no Terminal-Bench 4.0.
Quanto custa hospedar um download de 252 GB
O repositório ocupa cerca de 252 GB. Com 4 bits por peso, os 428B de parâmetros representam aproximadamente 214 GB antes de cache KV e buffers de runtime; portanto, planeje usar várias GPUs da classe de 80 GB antes de chegar a um contexto realmente utilizável. A conta da NVIDIA RTX Spark aponta para uma DGX Station ou um cluster de 4x DGX Spark de 128 GB para execuções locais (post no X). Pessoas fazendo self-hosting no X observam que um download de 252 GB, somado a essa exigência de hardware, tira o modelo do alcance de desktops comuns, enquanto a API continua barata (@bufcapy).
Antes de alugar hardware, vale fazer a conta da API, porque a API da MiniMax é excepcionalmente barata. A US$ 0,15 por entrada e US$ 0,60 por saída a cada 1M de tokens, um dia com 10M de tokens de entrada e 2M de saída custa 10 × US$ 0,15 + 2 × US$ 0,60 = US$ 2,70, ou aproximadamente US$ 81/mês.
A fórmula do ponto de equilíbrio é o custo mensal do cluster dividido pelo custo da API por token. A US$ 0,15 por 1M de tokens de entrada, cada US$ 150/mês de aluguel equivalem a 1B de tokens de entrada; a US$ 0,60 por 1M de tokens de saída, cada US$ 600/mês equivalem a 1B de tokens de saída. Inclua sua própria cotação de aluguel e o tempo de engenharia: self-hosting só vence quando sua fatura mensal de API, nessas tarifas, ultrapassa esse total ou quando a política exige que os pesos permaneçam dentro do seu perímetro. Para a Kimi, o contraste é ainda maior: o preço reportado de US$ 2/US$ 10 por 1M de tokens torna a rota hospedada cerca de 13x mais cara que a MiniMax na entrada e aproximadamente 17x na saída. Assim, um futuro checkpoint de 2,8T de parâmetros precisaria de throughput sustentado muito alto para justificar armazenamento na classe dos TB e um cluster multinó.
O que o self-hosting entrega desde o primeiro dia
O suporte dos frameworks no lançamento é real, mas incompleto. O model card cita SGLang, vLLM e TokenSpeed, além do FlagOS para implantação em múltiplos chips, com imagens Docker para SGLang. As integrações com Transformers, KTransformers, unsloth e ATOM ainda estavam em andamento no lançamento. Um responsável por implantação observou que a configuração de exemplo do vLLM para H100/H200 mira 256K tokens, não o 1M completo, deixa a entrada de vídeo desativada e não habilita a decodificação especulativa DSpark (@sancaksofttech). É o mesmo download, mas nem toda configuração libera todos os recursos.
Uma preocupação recorrente no r/LocalLLaMA é que "Flash" descreve a economia de inferência, e não um modelo pequeno:
Com quantização, ele cabe em 256GB? Torcendo para que sim — u/BawbbySmith no r/LocalLLaMA
A cláusula da licença que pesa antes do hardware
O M3.1 Flash tem pesos abertos, não é open source. A LICENSE do repositório, identificada como minimax-community — veja o arquivo LICENSE — permite uso não comercial livremente. Para uso comercial, é obrigatório exibir com destaque "Built with MiniMax M3.1-Flash" e enviar um aviso único à MiniMax. Organizações ou produtos com mais de US$ 20M de receita anual precisam de autorização prévia por escrito, e usos militares são proibidos.
Para ferramentas internas, essa exigência é leve; para hospedagem comercial, pode ser um bloqueio, já que o selo e a barreira de receita são mais difíceis de atender. A licença da Kimi segue desconhecida até a liberação dos pesos em 4 de novembro. A Moonshot já informou em seu blog técnico que o checkpoint aberto será diferente do modelo de API, pois dados de treinamento relacionados a segurança cibernética foram removidos dos pesos abertos (kimi.com). Leia os dois arquivos LICENSE antes de construir sobre eles.
Qual modelo faz sentido para o seu cenário
| Sua situação | Escolha |
|---|---|
| Precisa dos pesos nesta semana para avaliação local, base de fine-tuning ou implantação isolada da rede | MiniMax M3.1 Flash — é a única opção baixável entre os dois |
| Agentes de programação sensíveis a custo, com carga variável | API da MiniMax a US$ 0,15/US$ 0,60 — faça self-hosting apenas com volume alto e sustentado |
| Programação de fronteira em tarefas de longo horizonte e você pode esperar | Avalie agora a API do Kimi K3.1 Pro; decida sobre self-hosting após chegarem os pesos, a licença e o tamanho real em 4 de novembro |
| Produto comercial hospedado | Primeiro valide juridicamente a atribuição exigida pela MiniMax e a autorização acima de US$ 20M; a Kimi não permite decisão antes de publicar sua licença |
| GPU de consumidor ou um único Mac | Não há receita validada para um único dispositivo citada — use a API, a menos que esteja preparado para testar uma configuração sem suporte |
Perguntas frequentes
Onde baixar oficialmente os pesos do MiniMax M3.1 Flash?
O repositório oficial é MiniMaxAI/MiniMax-M3.1-Flash no Hugging Face, com espelho no ModelScope. Para baixar, use hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Existe um repositório oficial do Kimi K3.1 Pro no Hugging Face?
Não. Em 24 de outubro de 2026, não há repositório público com os pesos do K3.1 Pro; o blog técnico da Moonshot promete os pesos completos até 4 de novembro de 2026.
Posso usar o MiniMax M3.1 Flash comercialmente?
Sim, com condições: exiba "Built with MiniMax M3.1-Flash", envie um aviso único e obtenha autorização prévia por escrito acima de US$ 20M de receita anual; usos militares são proibidos. Confirme os termos na LICENSE do repositório com assessoria jurídica.
Ele roda em uma GPU de consumidor ou em Apple Silicon?
A orientação de implantação citada não inclui uma configuração validada para uma única GPU de consumo; as estimativas exigem várias GPUs de 80 GB para pesos quantizados e cache KV. A NVIDIA aponta uma DGX Station ou um cluster de 4x DGX Spark de 128 GB.
Ele funciona com vLLM ou SGLang hoje?
Ambos contam com receitas desde o lançamento, assim como TokenSpeed e FlagOS para execuções em múltiplos chips. Mas as configurações de exemplo podem limitar o contexto a 256K, desativar a entrada de vídeo ou deixar o DSpark desligado — consulte a receita atual do model card para seu hardware.
O contexto completo de 1M está disponível em self-hosting?
O máximo anunciado é de 1M de tokens, mas o comprimento utilizável depende da memória das GPUs e da configuração de serving. Reserve explicitamente margem para o cache KV em cargas de trabalho de contexto longo.
Leitura relacionada: MiniMax M3.1 Flash Open Weights: guia de download, execução e custos, Guia de preços da API do Kimi K3.1 Pro, Kimi K3 Open Weights