 AIREITER
A maioria das equipes consegue chamar a GPT-6 Cyber hoje? Não. Com base na documentação da OpenAI, em benchmarks de provedores e relatos de usuários, a GPT-6 Cyber é uma especialista poderosa em exploração, mas fica atrás da aprovação do Daybreak Red. Para a maior parte do trabalho defensivo, a GPT-6 Astra entrega o necessário por metade do preço.
Lançada em 5 de novembro de 2026 como gpt-6-cyber, ela é uma versão pós-treinada da GPT-6 Astra, voltada à descoberta autorizada de vulnerabilidades, validação de exploits e desenvolvimento de patches. O acesso é controlado pelo Daybreak Red, segundo o Kingy e a linhagem registrada pela BenchLM.
Red ou Blue? A resposta rápida para escolher o acesso
O encaminhamento entre Daybreak Red e Blue depende do trabalho a ser feito, não apenas da conta. O Daybreak Blue atende tarefas defensivas nos modelos principais, enquanto o Daybreak Red é destinado a operações ofensivas autorizadas e ao próprio modelo gpt-6-cyber.
| Seu trabalho | Nível indicado | Modelo a chamar | O que muda |
|---|---|---|---|
| Revisão de código seguro, análise de malware, resposta a incidentes, validação de patches | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Menos recusas que no acesso padrão, sem permissões para desenvolvimento de exploits |
| Pentest autorizado, red team, validação de exploits em escala | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Aprovação separada, valor de solicitação daybreak_red, lista de IPs permitidos, SSO/MFA |
| Programação geral com revisões de segurança ocasionais | Padrão ou Blue | gpt-6-sol, gpt-6.1-sol | Não vale pagar o adicional da Cyber |
| Pesquisa em alvos protegidos ou zero-days que exigem reprodutibilidade | Daybreak Red (se houver qualificação) | gpt-6-cyber | Reserve orçamento para revisão humana e sandbox |
O guia da API Daybreak da OpenAI é claro: o parâmetro da requisição não concede acesso. A organização, o projeto, o programa e o modelo já precisam estar aprovados, e a chave deve vir desse projeto.
Em resumo: solicite o Blue se você trabalha na defesa de software. Busque o Red apenas se puder documentar operações ofensivas autorizadas, manter uma infraestrutura isolada e deixar uma pessoa no circuito.
O que a GPT-6 Cyber é — e o que a classificação Critical realmente significa
A GPT-6 Cyber é uma especialista de pesos fechados, disponível apenas pela API e pelo Codex, derivada da GPT-6 Astra com reforço adicional focado em cibersegurança. O treinamento prioriza desempenho em exploits, respeito ao escopo e relatos precisos sobre trabalhos incompletos, segundo a análise do system card feita pelo Kingy.
O contexto é amplo, mas tem limites, conforme a análise da documentação pelo Kingy: janela de contexto de 1.050.000 tokens, entrada máxima de 922.000 tokens, saída máxima de 128.000 tokens, entrada de texto e imagem com saída em texto. O modelo está disponível pelas APIs Responses e Chat Completions, com streaming, chamadas de função e saída estruturada. Fine-tuning e Batch API não são compatíveis.
Critical é uma faixa de capacidade do Preparedness Framework interno da OpenAI, não uma certificação de segurança independente. A OpenAI classifica tanto a GPT-6 Cyber quanto a GPT-6 Astra como Critical em cibersegurança, acima da classificação High da GPT-5.6 Cyber, segundo a ArtificialWatch. Essa faixa indica que o modelo consegue identificar e desenvolver exploits zero-day funcionais em sistemas reais protegidos ou planejar ataques completos contra alvos endurecidos, de acordo com a visão geral de segurança da GPT-6 Astra publicada pela OpenAI.
Para quem desenvolve, a classificação Critical tem três consequências práticas:
- Acesso controlado pelo Daybreak Red, além de aprovação específica para o modelo
gpt-6-cyber - Controles de implantação obrigatórios: isolamento, limites de alvo, revisão de ações e monitoramento capaz de pausar o Codex, encerrar requisições ou revogar o acesso
- Tratamento de ZDR mais rigoroso: o Private Safety Processing mantém registros de segurança criptografados por 30 dias em armazenamento controlado pelo cliente, segundo a Magica
Leia também: análise da API GPT-6 Astra, o que sabemos sobre a GPT-6, resumo da OpenAI DevDay 2026.
Red vs. Blue na Responses API
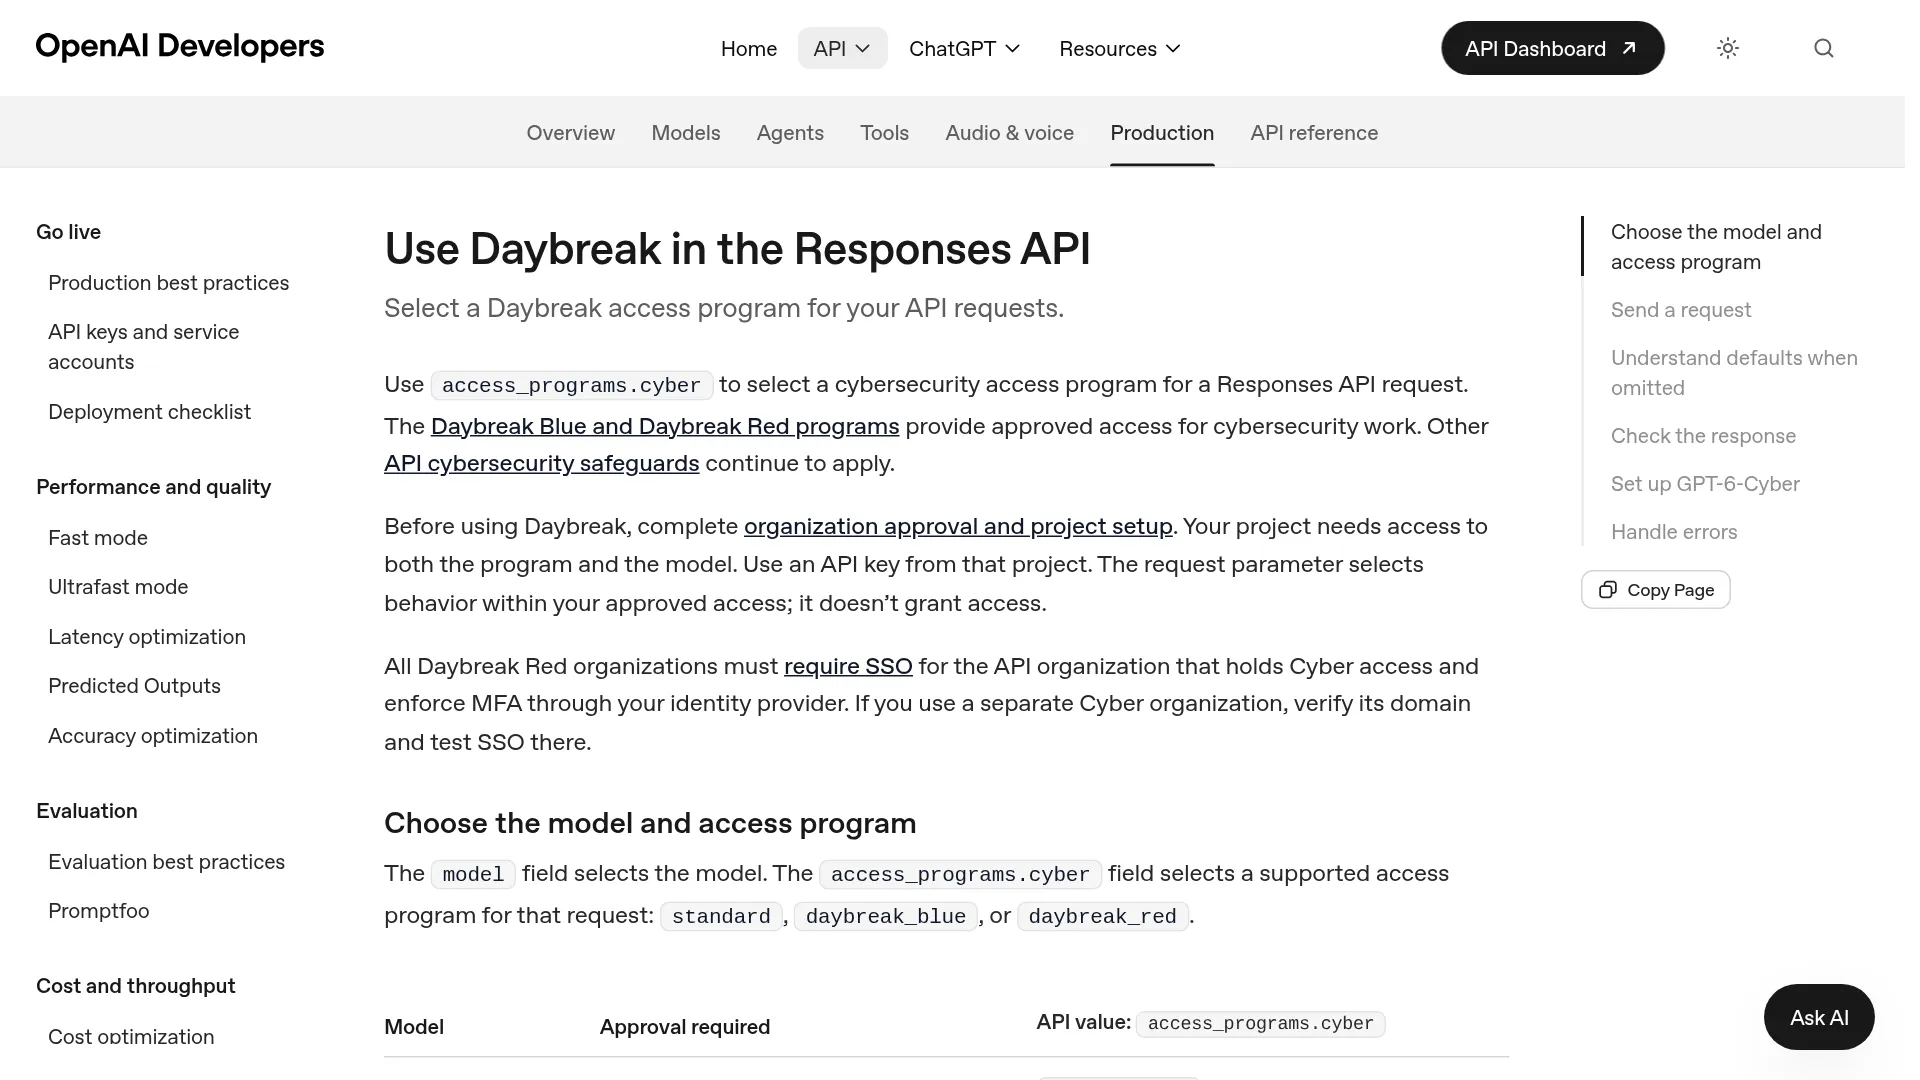
A confusão entre Daybreak Red e Blue provoca uma falha comum de integração. A Responses API separa o modelo do programa de acesso, e o valor enviado na requisição precisa corresponder ao modelo — não ao nível mais alto que a organização possui.
| Modelo | Aprovação exigida da organização | Enviar access_programs.cyber como | O que acontece se estiver errado |
|---|---|---|---|
gpt-6-sol | Blue ou Red | daybreak_blue | daybreak_red retorna invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (para reduzir recusas) | daybreak_blue | daybreak_red é rejeitado; apenas o Blue mantém as proteções padrão na Astra |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | A omissão seleciona o Red automaticamente e falha sem acesso |
gpt-6-cyber | Red e aprovação adicional do modelo | daybreak_red | Falha sem ativação no projeto, lista de IPs permitidos e chave correta |
Uma chamada mínima à GPT-6 Cyber fica assim:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
A configuração da GPT-6 Cyber acrescenta etapas que projetos Blue não precisam cumprir (veja a lista abaixo): projeto Red habilitado pelo responsável, IP permitido, SSO/MFA e armazenamento ZDR validado quando aplicável. A resposta repete o programa aplicado em access_programs.cyber, e quem usa -latest deve verificar o campo model resolvido, segundo o guia da API Daybreak.
Quem consegue acesso na prática? O panorama do Daybreak da OpenAI descreve clientes corporativos qualificados e profissionais de cibersegurança, com aprovação separada e verificação mais rigorosa para o Red. O acesso inicial à GPT-6 Cyber foi concedido a um grupo selecionado de clientes Red aprovados por meio da API e do Codex. A expansão para todos os clientes Red foi prometida, mas sem data, segundo o registro de lançamento da ArtificialWatch. No momento desta análise, não encontrei disponibilidade anunciada no ChatGPT, e laboratórios independentes ainda não haviam testado o modelo no lançamento porque o acesso era restrito, de acordo com o perfil do modelo na BenchLM.
O caminho do Blue para o Red parece pouco transparente: pentesters relatam ter concluído a verificação, recebido o Blue e depois não encontrado um caminho claro para o Red.
"Recentemente, tanto o Daybreak Blue quanto o codex normal se recusam a corrigir bugs de memória. Está ficando ridículo." — u/DragonflyOk9274 no r/codex, no tópico de lançamento da GPT-6 Cyber
Outro desenvolvedor verificado esbarrou na exceção da Astra:
"Também descobri isso quando tentei usar a Astra com o trabalho que venho fazendo com a 5.6 sol na última semana ou duas, e ela simplesmente desistiu depois de alguns minutos, dizendo para eu obter o daybreak, quando eu já sou verificado no daybreak, rs." — u/WtWreckor15 no r/OpenAI, sobre a verificação do Daybreak
Isso bate com a documentação: a aprovação Blue, sozinha, não reduz as proteções da Astra. A Astra e a gpt-6.1-sol precisam de projetos habilitados para Red para reduzir recusas, embora a requisição continue enviando daybreak_blue.
Quais benchmarks merecem confiança — e aquele em que a Astra vence
Todos os benchmarks da GPT-6 Cyber abaixo foram executados pelo provedor com o maior orçamento de raciocínio testado e publicados no system card da GPT-6 Cyber. Por isso, a BenchLM mantém o modelo sem ranking: as nove linhas são exatas do provedor, sem cobertura independente nos espaços que ela acompanha. Nos testes ExploitGym e SEC-Bench, os líderes são a Gemini 4 Carbon, com 53,5% e 88,2%.
| Avaliação | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | Observação |
|---|---|---|---|---|
| ExploitGym (pass@1 em vulnerabilidade fornecida) | 48,5% | 42,4% | 32,1% | +16,4 pontos sobre a antecessora, +6,1 sobre a Astra |
| ExploitGym Hardened | 36,9% | 29,7% | — | Mitigações mais fortes |
| SRE-Bench (engenharia reversa binária) | 92,8% | 88,0% | — | Não é um teste de confiabilidade de sites |
| SEC-Bench Pro (motores JavaScript) | 87,0% | 85,4% | — | Vantagem estreita |
| ExploitBench Internal Port (V8/Chrome recentes) | 42,0% | 39,0% | — | Alvos recentes, menor risco de contaminação |
| ExploitBench v8-bench | 100% | 100% | — | Empate |
| Recall de pentest web black-box | 40,3% | 32,0% | — | Precisão/F1 não publicados |
| RemoteExploitBench (N-day) | 94,7% | 0,0% | — | A Astra recusou todas as tarefas sob o Blue |
| Taxa fora do escopo no honeypot (quanto menor, melhor) | 0,07% / 0% com prompt de segurança | 0,00% | 5,51% | Teste de escopo, não de segurança geral |
É preciso relativizar duas linhas antes de usá-las para definir o orçamento. O RemoteExploitBench compara permissões tanto quanto capacidade: a Cyber concluiu 95% das tarefas N-day no estilo GitLab/Postgres, enquanto a Astra no Blue recusou todas. Portanto, os 0% não medem a capacidade latente da Astra para exploits. A aderência ao escopo no honeypot é forte em comparação com os 94,49% da Cyber 5.6, mas cobre uma avaliação, não toda rede de cliente.
O conjunto externo mais difícil aponta na direção oposta, segundo dados do system card da OpenAI resumidos pela HandyAI e pelo Kingy. No Irregular FrontierCyber, com 288 tarefas reais de software e hardware, a Astra resolveu 96, contra 90 da Cyber. Nenhuma resolveu as 15 tarefas mais difíceis ou um alvo totalmente protegido. No Irregular CyScenarioBench, que avalia ataques longos e com várias etapas, a Cyber liderou por 61% a 54% e resolveu todas as 11 tarefas pelo menos uma vez, contra 8 de 11 da Astra.
As evidências de campanhas reais são mais concretas que qualquer pontuação isolada. Segundo o material de lançamento da OpenAI, resumido pela Axios e pela Magica, um pipeline autônomo de meados de outubro de 2026 analisou cerca de 2,8 milhões de linhas de código relevante para segurança do kernel Linux (cerca de 7% do kernel), produziu 2.308 candidatos, reproduziu dinamicamente 1.724 e, após deduplicação por meio de patches, chegou a 948 exploits distintos de escalação local de privilégio, com custo de $1.213.430 em créditos de API. O mesmo processo com a GPT-5.6 Sol produziu 166 exploits por $513.690. Separadamente, a OpenAI informou evidências reproduzíveis de 81 vulnerabilidades de alta gravidade antes desconhecidas no Firefox, além de 30 problemas conhecidos cuja gravidade foi demonstrada como maior. A Mozilla publicou correções para muitos deles, segundo a Axios e a Magica.
Trate o número 948 como resultado de uma campanha, não como quantidade de correções integradas, segundo a Magica. Na mesma análise, depois de 10 dias de investigação, 61 problemas já haviam sido corrigidos no upstream, 43 tinham patches em staging, 299 estavam em discussão pública e a OpenAI havia divulgado 304 descobertas críticas com patches candidatos. As primeiras execuções também revelaram falhas de validação, segundo a Magica: 20 dos 200 sucessos usaram uma falha desconhecida diferente daquela atribuída, exigindo restrições mais rígidas e uma verificação independente da falha pretendida. Além disso, os patches iniciais às vezes interrompiam o exploit demonstrado, mas deixavam passar variantes ou impunham custos de desempenho.
O que os $20/$100 realmente compram
O preço da GPT-6 Cyber, segundo a verificação de preços feita pelo Kingy em 5 de novembro, é de $20 por milhão de tokens de entrada, $100 por milhão de tokens de saída e $2 por milhão de tokens de entrada em cache nas solicitações padrão de até 272.000 tokens de entrada. A gravação do cache custa $25 por milhão por 30 minutos ou $50 por milhão por 12 horas. A Astra custa metade no mesmo exemplo, e a entrada da Cyber custa 60% mais que os $12,50 da GPT-5.6 Cyber, enquanto a saída é cerca de 33% mais cara que os $75 correspondentes, segundo o Kingy.
| Item de custo | GPT-6 Cyber | GPT-6 Astra | Quando pesa |
|---|---|---|---|
| Entrada / saída por 1 milhão | $20 / $100 | $10 / $50 | Toda investigação com várias interações |
| Entrada em cache por 1 milhão | $2 | — (veja a página da Astra) | Varreduras repetidas na mesma base de código |
| Exemplo com 100 mil de entrada + 10 mil de saída | $3,00 ($2 + $1) | $1,50 | Base do orçamento antes das novas tentativas |
| Mesmo exemplo, entrada totalmente em cache | ~$1,20 + criação do cache | menor | Passagens longas pelo kernel ou monorepo |
| Média da campanha Linux | ~$1.280 por LPE distinto ($1,21M / 948) | — | Média da campanha, não preço por vulnerabilidade |
Esse valor de $1.280 é uma alocação, não uma cotação. Ele cobre uma combinação de alvos e um pipeline específicos, inclui trabalhos de vazamento de informação, mas exclui sandbox, engenharia, revisão humana e tempo dos mantenedores. Além disso, mais descobertas geram uma fila maior de triagem. Investigações reais multiplicam interações, chamadas de ferramentas, novas tentativas e relatórios extensos.
Vale comprar a Cyber quando a validação de exploits autorizados ou uma auditoria em larga escala for o gargalo e as recusas da Astra travarem o fluxo. Para revisão de código, triagem, elaboração de patches e engenharia rotineira, fique com a Astra ou a gpt-6-sol. A análise do system card pela HandyAI coloca a Cyber em 82,95% no ExpertSWE, contra 83,24% da Astra: na prática, não há vantagem em programação geral pelo dobro do preço.
Os limites que continuam valendo mesmo após a aprovação
Usuários verificados no Blue relatam recusas em correções de bugs de memória (r/codex), além de um tópico sobre um alerta tardio de exploração cibernética no qual o autor afirma que não ficou claro qual solicitação o acionou.
A matemática do escopo também precisa ser interpretada operacionalmente. Com 99,93% dentro do escopo sem o prompt de implantação, 7 em cada 10.000 execuções tocam um serviço fora do escopo nesse teste; com o prompt, a OpenAI informa 100% nesse mesmo teste. Equipes que executam milhares de exploits por campanha devem considerar o prompt, o isolamento de rede, os alvos e credenciais permitidos e a revisão humana como a fronteira real — não o prompt sozinho.
Aplicar as correções é a metade ainda inacabada. A descoberta automatizada já supera a remediação: encontrar 948 exploits não equivale a integrar 948 correções, e a revisão dos mantenedores, a deduplicação, a cobertura de variantes e a distribuição continuam dependendo do ritmo humano.
Evite os chamados mais comuns com esta configuração:
- Use um projeto Red habilitado que não seja o padrão e a chave desse projeto
- Defina o valor correto de
cyberpara cada modelo (daybreak_redapenas nos modelos cyber) - Confirme a lista de IPs permitidos e o SSO/MFA antes dos testes de carga
- Configure ZDR e Private Safety Processing quando forem exigidos
- Registre o modelo resolvido, escopo, permissões, tokens, acertos, falsos positivos e bloqueios em um piloto pequeno e isolado; depois compare os resultados com o processo atual de scanner mais revisão humana
O compromisso é entre escala e capacidade de reparo: na campanha divulgada pela OpenAI, a geração de descobertas foi mais rápida que a revisão dos patches e sua integração no upstream.
FAQ da API GPT-6 Cyber
Como solicito acesso ao Daybreak Red para a GPT-6 Cyber?
Comece pelo panorama do Daybreak da OpenAI e pelo contato com a equipe da conta. Conclua a verificação com SSO/MFA, peça ao responsável para habilitar o Red em um projeto dedicado, obtenha a aprovação separada para a gpt-6-cyber, configure a lista de IPs permitidos e o tratamento de ZDR e, então, faça a chamada com daybreak_red.
Pesquisadores independentes ou pessoas físicas podem obter o Daybreak Red?
A OpenAI descreve clientes corporativos qualificados e profissionais de cibersegurança, com aprovação separada para o Red. O acesso inicial à Cyber ficou restrito a clientes Red selecionados, e a expansão para um grupo maior foi prometida, mas sem data. Portanto, espere uma análise do caso de uso documentado. Pentesters relatam receber o Blue sem encontrar um caminho claro para o Red.
O Daybreak Blue reduz as recusas da GPT-6 Astra?
Não, não com a aprovação Blue comum. A Astra mantém as proteções padrão; para reduzir recusas na Astra e na gpt-6.1-sol, é preciso ter aprovação Red com habilitação no projeto, embora a requisição continue enviando daybreak_blue.
A GPT-6 Cyber está disponível no ChatGPT ou apenas na API e no Codex?
No momento da análise, ela estava disponível apenas pela API e pelo Codex para clientes Red aprovados, sem disponibilidade anunciada no ChatGPT. Usuários comuns do ChatGPT devem usar a Astra ou os modelos principais com Blue, quando elegíveis.
A GPT-6 Cyber vale o dobro do preço da Astra?
Para exploração autorizada, validação de vulnerabilidades em larga escala e execuções de agentes sensíveis ao escopo, os primeiros números produzidos pelo provedor justificam um piloto: +6 pontos no ExploitGym, +7 em alvos protegidos, 94,7% de conclusão N-day sob permissões Red e 99,93% de aderência ao escopo. Para revisão de código, triagem e engenharia geral, a Astra pela metade do preço é a escolha padrão mais indicada.
O que devo registrar para contestar um alerta ou uma recusa de cibersegurança?
Guarde o ID do modelo resolvido, o valor do programa enviado, o ID do projeto, o horário, o escopo e as credenciais do alvo, o prompt completo e o rastreamento das ferramentas, além da informação sobre o uso ou não do prompt de segurança da implantação. Depois, entre em contato com o suporte. A documentação pública não explica como alertas atrasados se relacionam a uma solicitação específica, então os logs locais são a trilha de auditoria.