 AIREITER
ChatGPT나 OpenAI API를 쓰다가 upstream connect error or disconnect/reset before headers를 만났다면, 대개 원인은 OpenAI 측 인프라에 있습니다. 이 메시지는 OpenAI 엣지에 있는 프록시인 Envoy가 내보내는 것으로, 프록시가 OpenAI 백엔드에서 정상적으로 쓸 수 있는 응답을 받지 못했다는 뜻입니다. ChatGPT 웹에서는 흔히 Error Code 111로 표시됩니다. 핵심은 reset reason: 뒤의 내용이며, before headers는 응답 헤더 하나도 도착하기 전에 프록시가 연결을 포기했다는 의미입니다. 즉, 이 503 뒤에는 실제 백엔드 응답이 아니라 Envoy 자체의 오류 메시지만 있습니다. OpenAI 인프라를 직접 고칠 수는 없지만, reset reason과 브라우저인지 코드인지에 따라 다음 대응은 달라집니다.
사용 중인 경로별로 이렇게 대응하세요:
- ChatGPT 웹/앱: status.openai.com에서 상태를 확인한 뒤 새로고침하거나 새 세션을 시작합니다.
- 코드에서 OpenAI API 사용: reset reason을 확인하고 요청 ID를 남긴 뒤 재시도 정책을 적용합니다.
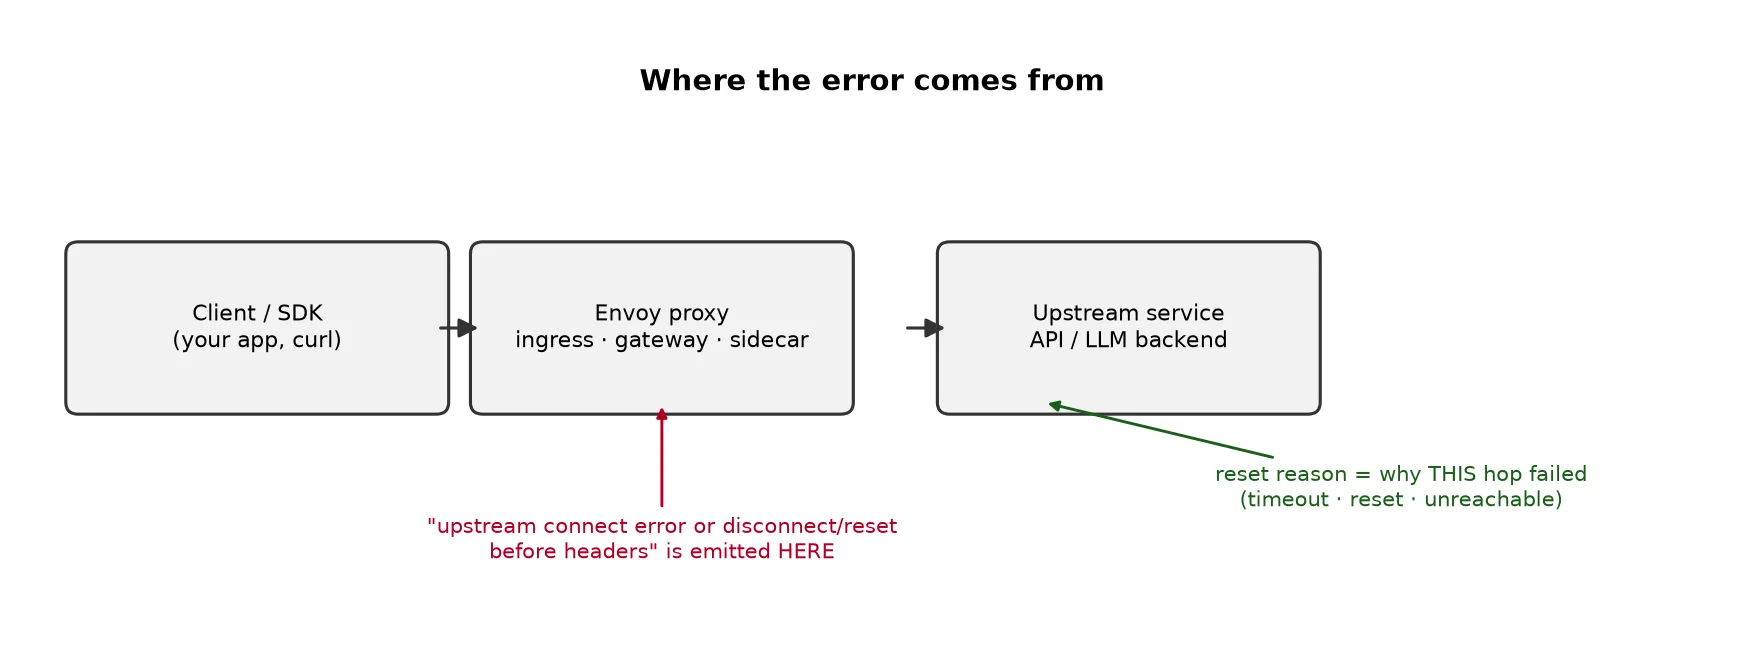
이 오류가 실제로 뜻하는 것
Envoy는 사용자와 OpenAI 백엔드 사이에 위치합니다. 요청이 들어오면 Envoy는 백엔드 연결을 열고 요청을 전달한 뒤 응답 헤더를 기다립니다. 그런데 헤더가 돌아오기 전에 연결이 실패하거나 끊기고, 시간 초과가 나거나, 용량 제한에 걸리면 Envoy가 이 메시지와 함께 HTTP 503을 반환합니다. 경우에 따라서는 502로 보이기도 합니다. ChatGPT 장애 화면, openai.InternalServerError 스택 트레이스, 에이전트 로그에서 이 오류를 볼 수 있는 이유입니다.
문구는 조금씩 다를 수 있습니다. retried and the latest reset reason이 포함됐다면 Envoy가 이미 재시도했고, 마지막 시도가 왜 실패했는지를 알려주는 것입니다. 어느 쪽이든 OpenAI 프록시가 자체 백엔드에서 응답을 받지 못했다는 보고이지, 프롬프트나 요청 본문이 잘못됐다는 뜻은 아닙니다.
reset reason별 원인과 대응법
reset reason을 보면 OpenAI 프록시에서 어떤 일이 발생했는지, 재시도가 의미 있는 상황인지 판단할 수 있습니다.
| reset reason | OpenAI 프록시에서 발생한 일 | 권장 대응 |
|---|---|---|
connection timeout | 백엔드가 제시간 안에 연결을 수락하지 못함 | 백오프를 적용해 재시도하고 상태 페이지 확인 |
overflow | 용량 또는 속도 제한 도달, 즉 백엔드 과부하 | 동시성을 낮추고 백오프 후 재시도 |
connection failure / remote connection failure | 백엔드에 연결할 수 없거나 연결이 거부됨 | 재시도하고, 계속되면 상태 확인 및 신고 |
connection termination / connection reset | 요청 처리 도중 백엔드가 연결을 닫음 | 재시도, 보통 장애 상황과 함께 발생 |
protocol error | OpenAI 측 프로토콜 문제 | 재시도하고 지속되면 요청 ID와 함께 신고 |
OpenAI 커뮤니티 보고에서 특히 자주 보이는 것은 overflow와 connection timeout입니다. 순간적으로 요청이 몰릴 때 백엔드 용량이 한계에 닿는 상황과 잘 맞아떨어집니다. 어느 경우도 내 컴퓨터에서 무언가를 바꾼다고 해결되지는 않습니다. 상태 확인, 백오프, 페일오버가 실질적인 대응 수단입니다.
ChatGPT 웹·앱에서 Error Code 111이 뜰 때
가장 먼저 status.openai.com을 확인하세요. 장애가 게시돼 있다면 기다리는 것이 기본 해결책입니다. 다만 특정 계정에서만 계속 발생한다면 지원팀에 문의할 만합니다. 상태가 정상이라면 페이지를 새로고침하고, 새 탭을 열거나, 로그아웃 후 다시 로그인해 보세요. 오래된 세션이 이미 죽은 연결을 붙잡고 있을 수 있습니다. 네트워크를 바꾸거나 VPN·회사 프록시를 끄는 방법은 그 중간 계층이 실제로 연결을 끊고 있을 때만 도움이 됩니다. OpenAI 문제라고 단정하기 전에 한 번 확인해 볼 수 있는 정도입니다.
코드에서 OpenAI API를 호출할 때
API에서는 이 문제가 간헐적으로, 그리고 부하에 따라 나타나는 경우가 많습니다. openai-python 이슈 트래커의 한 개발자는 시간당 수백 건을 요청하는 환경에서 호출의 약 5%가 openai.InternalServerError: upstream connect error or disconnect/reset before headers로 실패했고, 나머지 95%는 성공했다고 보고했습니다. 이런 부분 실패율은 백엔드 포화를 시사합니다. 대량 임베딩이나 대규모 문서 수집처럼 배치 비중이 높은 작업은 동시성을 끌어올리기 때문에 더 자주 부딪힐 수 있습니다. 대개 요청 페이로드를 바꾸기보다 재시도 정책을 두는 편이 해법이며, 높은 부하에서는 동시성 제어와 배치 작업 큐잉도 그만큼 중요합니다.
지원 요청으로 넘기기 전에는 공급자 측 문제임을 확인할 수 있도록 기록을 남겨 두세요. 타임스탬프, 엔드포인트와 모델, HTTP 상태 코드와 본문, x-request-id, SDK 버전, 진행 중인 요청 수, 그리고 실패 시점이 게시된 장애와 겹치는지를 확보하면 됩니다. 그다음 운영 환경에서도 버틸 수 있는 재시도 정책을 적용하세요.
import random, time
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI()

def with_retry(fn, max_attempts=5, cap=30.0):
    for attempt in range(max_attempts):
        try:
            return fn()
        except (APIConnectionError, APIStatusError) as e:
            status = getattr(e, "status_code", None)
            # retry connection drops and 5xx (incl. this 503); never blindly retry 4xx
            if isinstance(e, APIStatusError) and status and status < 500 and status != 429:
                raise
            if attempt == max_attempts - 1:
                raise
            retry_after = float(getattr(e, "response", None).headers.get("retry-after", 0)) if getattr(e, "response", None) else 0
            backoff = retry_after or min(cap, 0.5 * 2 ** attempt) * (0.5 + random.random())
            time.sleep(backoff)
OpenAI SDK는 일시적 오류를 자체적으로 재시도합니다. 설정값은 max_retries이고 기본값은 2입니다. 따라서 호출을 별도 재시도 로직으로 감싸기 전, 예를 들어 OpenAI(max_retries=0)처럼 이를 의도적으로 설정해야 합니다. 그렇지 않으면 SDK 재시도와 자체 재시도가 겹칩니다. 전체 시도 횟수는 3~5회로 제한하고 전체 동시성도 제한하세요. 재시도가 overflow를 촉발한 요청 폭주를 더 키우지 않게 하기 위해서입니다. 429는 Retry-After를 따르고, 408/409는 같은 작업을 반복해도 안전할 때만 재시도하세요. 멱등성이 없거나 스트리밍 방식인 호출은 특히 주의해야 합니다. 무작정 재시도하면 작업이 중복되거나 일부만 소비한 스트림이 다시 재생될 수 있습니다.
클라이언트에서는 어떻게 보이나
항상 Envoy의 503 본문까지 받는 것은 아닙니다. 그 전에 연결이 끊길 수 있기 때문입니다. 응답하지 않는 엔드포인트에 curl -v를 실행하면 Request completely sent off 뒤에 curl: (52) Empty reply from server가 반환될 수 있습니다. 요청은 나갔지만 아무 응답도 돌아오지 않은 상태입니다. 반면 Envoy가 직접 반환하는 오류는 본문에 upstream connect error... 텍스트를 담은 503입니다. 공개 보고도 같은 양상을 보입니다. OpenAI 서브레딧에서는 한 사용자가 "Network connection lost"와 함께 정확히 retried and the latest reset reason: connection timeout 문구를 게시했고, 요청량이 많은 상황의 openai-python 트래커에도 동일한 메시지가 InternalServerError로 남아 있습니다.
우회 경로를 고려할 시점
문제가 나는 구간은 OpenAI 게이트웨이와 백엔드 사이이므로, 단일 엔드포인트를 사용한다면 재시도와 백오프가 할 수 있는 거의 전부입니다. 다른 선택지는 이중화입니다. 한 업스트림에서 시간 초과나 overflow가 발생하면 다른 백엔드로 페일오버하는 계층을 거치는 방식입니다. OpenRouter와 AIReiter 같은 멀티 프로바이더 게이트웨이는 여러 모델 제공업체를 앞단에 두고 느려진 제공업체를 우회합니다. 이는 OpenRouter가 기반으로 삼는 멀티 프로바이더 라우팅 모델과 같은 방식입니다. 따라서 특정 업스트림이 느려질 때 사용자에게 503을 그대로 노출하는 대신 다른 경로로 보낼 수 있습니다. 물론 대가도 분명합니다. 홉이 하나 추가되고, 라우터 자체의 가용성에 의존하게 되며, 가격·데이터 처리·관측성 차이도 검토해야 합니다. 그래도 특정 제공업체 하나의 불안정성에 노출되는 정도는 줄일 수 있습니다.
FAQ
ChatGPT Error Code 111은 무엇인가요?
일부 ChatGPT 사용자는 이 메시지와 함께 "Error Code 111"이라는 라벨을 봅니다. OpenAI 프록시가 백엔드에서 응답을 받지 못했다는 뜻으로, 서버 측 문제입니다. status.openai.com을 확인하고 페이지를 새로고침하세요.
왜 부하가 있을 때나 무작위로만 발생하나요?
부하에 따라 발생하는 실패는 보통 overflow인 용량 또는 속도 제한, 혹은 백엔드 포화로 연결 시간이 제한 시간을 넘긴 경우를 뜻합니다. 둘 다 동시성이 높아질 때 나타나므로, 같은 코드가 대부분의 경우 정상 작동하는 이유도 여기에 있습니다.
VPN이나 방화벽이 원인일 수 있나요?
사용자와 OpenAI 사이에서 그 계층이 실제로 연결을 끊는 경우에만 그렇습니다. 네트워크를 바꿔 원인을 배제해 볼 가치는 있지만, 실제 OpenAI 장애나 API 측 503을 해결하지는 못합니다.
429 속도 제한 오류와 같은 문제인가요?
아닙니다. 429는 명시적인 속도 제한 응답을 받은 경우입니다. 이 503은 쓸 수 있는 응답이 아예 돌아오지 않았다는 뜻입니다. 429에서는 Retry-After를 따르고, 503에서는 백오프 후 재시도하세요.
"retried and the latest reset reason"은 무슨 뜻인가요?
Envoy가 이미 해당 요청을 재시도했고, 마지막 시도가 실패한 이유가 뒤에 표시된다는 뜻입니다. 일회성 순간 오류보다는 OpenAI 측의 지속적인 백엔드 문제를 가리킵니다.