 AIREITER
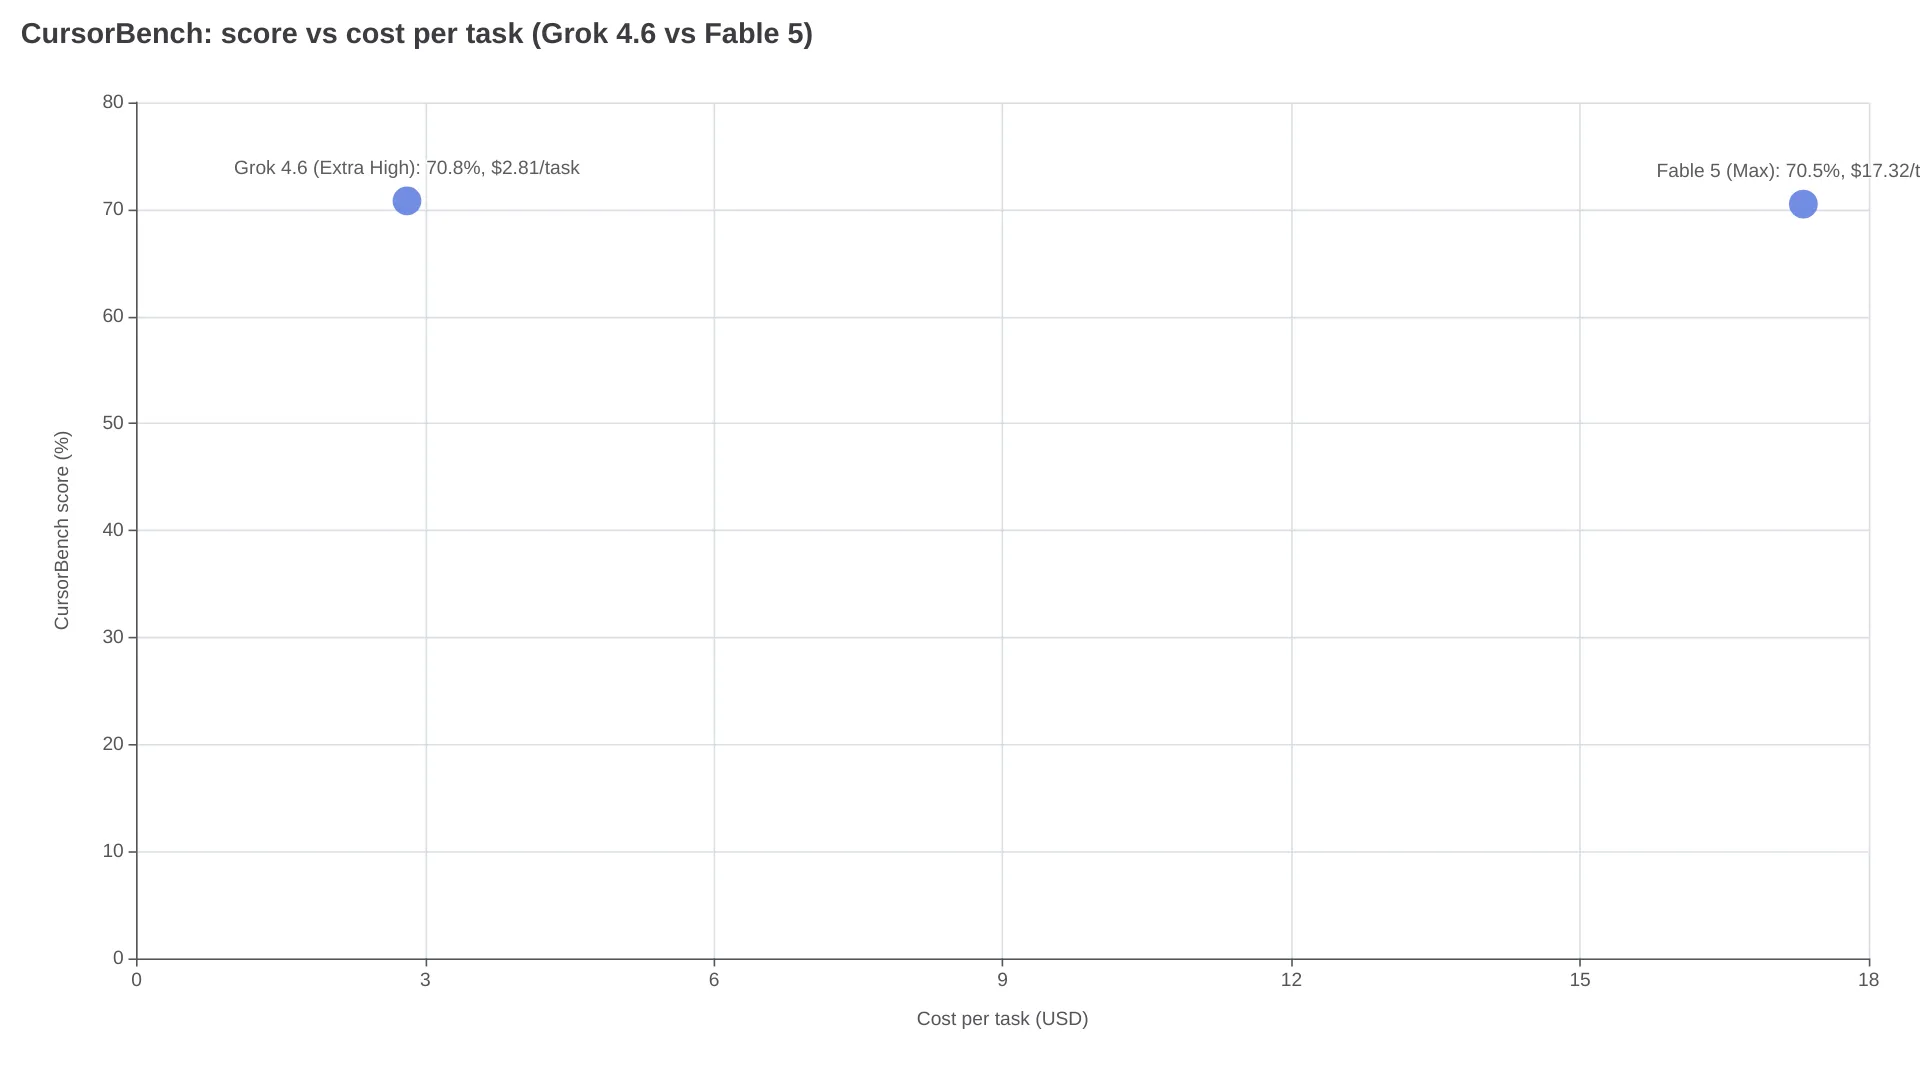
Grok 4.6 Extra High는 CursorBench에서 완료된 작업당 $2.81의 비용으로 70.8%를 기록했다. Fable 5 Max는 같은 에이전트 하네스에서 70.5%를 기록했지만 작업당 비용은 $17.32였다. 코딩 에이전트 성능은 사실상 동률인데, 작업 하나를 처리하는 비용은 6배나 차이 난다. 다만 Fable 5가 여전히 앞서는 영역이 있다. Artificial Analysis의 종합 지능 지수 1위를 유지하고 있으며, 컨텍스트 윈도우도 두 배 더 크다.
Grok 4.6은 어떻게 Fable 5를 따라잡았나
두 달 전만 해도 이 비교의 결론은 분명했다. 2026년 7월 Artificial Analysis는 Intelligence Index에서 Grok 4.5에 56점, Fable 5에 62점을 줬다. 6점 차이였다. 2026년 8월 출시된 Grok 4.6은 공개된 벤치마크 변화를 기준으로 약 5점 오른 ~59점을 기록한 것으로 추정된다. GPT-5.6 Sol과 비슷한 수준이며, Fable 5와의 격차도 약 3점으로 줄었다.
코딩 에이전트 성능에서는 차이가 더 좁혀졌다. Fable 5는 2026년 6월 Cursor에 추가되면서 CursorBench에서 72.9%라는 당시 최고 기록을 세웠다(r/accelerate). 이전 최고 기록보다 8점 높은 수치였다. 이후 Grok 4.6이 출시된 뒤 2026년 8월 r/cursor에 올라온 맞대결에서는 Grok 4.6 Extra High가 70.8%, Fable 5 Max가 70.5%를 기록했다. 같은 에이전트 하네스에서 나온 결과인 만큼 사실상 동률이다. 다만 이 비교를 직접 실행한 Cursor 사용자는 다음과 같은 의문을 남겼다.
"Grok 4.6을 보면서 이런 생각이 들었다. CursorBench 점수에서 모델이 차지하는 비중은 얼마나 되고, 하네스가 차지하는 비중은 얼마나 될까?" - r/cursor 스레드, 2026년 8월
벤치마크 점수는 기본 모델만 평가하는 것이 아니다. 프롬프트 구성, 도구, 재시도까지 포함한 에이전트 전체 스택의 결과다. 게다가 Fable 5의 출시 당시 72.9% 기록과 8월의 70.5% 기록은 서로 다른 설정에서 나온 수치다. 따라서 두 결과 모두 방향성을 보여주는 참고 자료로 보는 편이 안전하다.
작업당 비용에서는 Grok 4.6이 압도적이다
2026년 8월 비교에서 가장 눈여겨볼 부분은 작업당 비용이다.
| 측정 항목 (CursorBench) | Grok 4.6 Extra High | Fable 5 Max |
|---|---|---|
| 점수 | 70.8% | 70.5% |
| 작업당 비용 | $2.81 | $17.32 |
| 작업당 단계 수 | 46 | 72 |
Fable 5는 거의 같은 점수에 도달하기 위해 에이전트 단계를 57% 더 수행했다. 단계가 늘어나면 그만큼 추론 토큰도 증가하기 때문에 비용 차이로 이어진다. 두 모델을 번갈아 사용한 개발자들이 단순한 토큰 단가만으로는 에이전트를 비교하기 어렵다고 말하기 시작한 이유다.
"AI 에이전트를 비교할 때 $/토큰이라는 기준은 점점 맞지 않는 방식이 되고 있다." - r/grok 스레드 제목, 2026년 8월
토큰 단가를 보면 비용 격차의 일부를 설명할 수 있다. Anthropic API에서 Fable 5의 가격은 입력 토큰 100만 개당 $10, 출력 토큰 100만 개당 $50이다. Grok 4.5의 xAI API 공개 가격은 200K 토큰 이하 프롬프트 기준 입력 $2, 출력 $6(토큰 100만 개당)이었다. xAI는 4.6에 대한 별도 요금표를 공개하지 않았으며, r/grok 커뮤니티에서는 4.6을 두고 "Sol 수준의 성능을 API 가격의 일부만으로 제공한다"는 평가가 나왔다. 등급별 Fable 5 전체 요금은 Fable 5 API 가격 정리에서 확인할 수 있다.
실제 사용에서는 Grok의 가격 우위가 다소 줄어드는 경우도 있다. 200K 토큰을 넘는 프롬프트에서는 Grok 가격이 대략 두 배로 올라가며, xAI가 공개한 요금 기준으로 이 구간은 입력 $4, 출력 $12(토큰 100만 개당)다. 또 이미 Fable 5를 중심으로 작업 흐름을 구성했다면 모델을 바꾸기 전에 구조적으로 Fable 5 토큰 비용을 줄이는 방법도 있다.
Fable 5가 여전히 앞서는 영역
| 영역 | 근거 | 사용자 관점의 의미 |
|---|---|---|
| 지능 지수 | Fable 5는 AA Intelligence Index에서 여전히 1위다. Fable 5는 62점, Grok 4.6은 약 59점이다. | 기존 6점 차이 중 3점 정도는 Grok 4.6의 상승 이후에도 남아 있다. |
| 컨텍스트 윈도우 | Fable 5는 1,000,000토큰, Grok은 500,000토큰의 컨텍스트를 제공한다. | 대형 저장소와 작업 이력을 한 번에 담을 수 있다. 다만 200K 토큰 초과 구간에서는 Grok의 가격 우위가 줄어든다. |
| 어려운 작업의 안정성 | TryAI의 빌드 테스트에서 Fable 5는 3D 루빅스 큐브를 첫 시도에 구현했고 가장 좋은 SVG를 만들었다. Grok 4.5는 재실행이 필요했다. Goldie Bench에서는 47개 원샷 작업 중 Fable 5가 20-17로 앞섰으며, 셰이더와 GPU 물리 빌드에서 0.8-1.6점 차이로 승리했다. | 요구사항이 모호하고 재시도 없이 한 번에 처리해야 하는 작업에서는 Fable 5의 추론 상한이 드러난다. |
속도, 지연 시간, 처리량
TryAI가 같은 제공자 라우팅과 400토큰 제한을 적용하고, 프롬프트 유형별로 3회씩 실행해 측정한 결과다.
| 측정 항목 | Grok 4.5 | Fable 5 |
|---|---|---|
| 첫 토큰까지 걸린 시간 | 0.44초 | 3.47초 |
| 처리량 | 110 tok/s | 28 tok/s |
| 응답당 비용 | $0.00002 | $0.00009 |
| 성공률 | 100% | 100% |
Grok은 110 tok/s를 기록했다. GPT-5.5와 Opus 4.8의 약 두 배이며, Fable 5의 28 tok/s와 비교하면 약 네 배다. Artificial Analysis는 최대 수준의 추론을 적용했을 때 Fable 5의 첫 답변 토큰까지 걸리는 시간이 113.68초로, Grok의 8.68초보다 훨씬 길다는 더 가혹한 수치도 제시한다. 다만 스트리밍이 시작된 뒤의 디코딩 속도는 Fable 5가 63.1 tok/s로 Grok의 58.9 tok/s보다 조금 빠르다. 실제 체감으로 옮기면 Grok은 대화형 작업 루프에서 즉각적으로 반응하고, Fable 5는 긴 사고 과정을 먼저 수행한 뒤 그만큼의 시간을 지불하는 방식이다.
접근 방식과 구독, 에이전트 도구 생태계
Fable 5는 Anthropic API, Claude Code, Cursor를 통해 사용할 수 있으며, API를 제외한 대부분의 사용에서는 정액제 Claude Pro 구독으로 이용할 수 있다. CLAUDE.md, 플러그인, 스킬, MCP 서버로 이어지는 Claude Code 생태계는 수년간 다듬어져 성숙도가 높다.
Grok 4.6은 xAI API와 Grok Build CLI(curl -fsSL https://x.ai/cli/install.sh | bash)로 제공되며, X Premium 구독에는 채팅 사용 권한이 포함된다. ClockedCode에 따르면 Grok Build는 별도 설정 없이 기존 CLAUDE.md 파일, Claude Code 플러그인, 스킬, MCP 서버, 에이전트, 훅을 읽는다. -p 플래그를 사용하면 CI에서 헤드리스로 실행할 수 있고, 임베딩을 위한 Agent Client Protocol도 제공한다. 생태계 자체는 더 젊지만 Claude Code와의 호환성 덕분에 호환되는 설정이라면 마이그레이션 비용은 거의 없다.
두 서비스 모두에서 기억해야 할 결제상의 현실도 있다. Claude Pro와 X Premium은 정액제이므로, 실제 작업량에서 적용되는 사용량 제한이 요금표 자체보다 중요하다.
상황별 추천
| 사용 상황 | 추천 모델 | 이유 |
|---|---|---|
| 대량으로 반복 실행하며 요구사항이 명확한 코딩 작업 | Grok 4.6 | CursorBench 동률 성능에서 작업당 비용이 $2.81 대 $17.32다. |
| 대형 저장소에서 정확성이 중요한 작업 | Fable 5 | 1M 컨텍스트 윈도우, 지능 지수 1위, 첫 시도 성공률 우위 |
| 빠른 반복이 필요한 대화형 에이전트 세션 | Grok 4.6 | 첫 토큰까지 0.44초, 110 tok/s |
| 모호한 원샷 빌드와 고난도 추론 | Fable 5 | TryAI의 가장 어려운 작업과 Goldie Bench 맞대결에서 승리 |
| API 예산이 제한된 경우 | Grok 4.6 | 출력 토큰 가격이 Fable 5의 약 8분의 1이다. |
내 결론은 이렇다. 범위가 명확하고 반복적인 작업에는 Grok 4.6을 기본값으로 두고, 잘못된 답변의 비용이 토큰 비용보다 큰 작업에는 Fable 5를 배정하는 방식이 적절하다. 실제 사용량이 많은 팀이라면 둘 중 하나만 고집하기보다 대표 작업의 크기, 재시도율, 완료 작업당 비용을 기준으로 라우팅하는 편이 낫다.
FAQ
코딩에서는 Grok 4.6이 Fable 5보다 나은가?
CursorBench에서는 사실상 동률이다. 2026년 8월 비교에서 Grok 4.6 Extra High는 70.8%, Fable 5 Max는 70.5%를 기록했다. 하지만 Fable 5는 여전히 Artificial Analysis의 종합 지능 지수에서 앞서고(62 대 ~59), 가장 어려운 원샷 작업에서도 우세하다. 따라서 어느 쪽이 더 나은지는 병목이 작업당 비용인지, 아니면 정확성의 상한선인지에 따라 달라진다.
Grok 4.6이 Fable 5보다 저렴한가?
그렇다. 완료된 CursorBench 작업 기준으로 약 6배 저렴하다($2.81 대 $17.32). 토큰 단가 비교에서는 xAI가 별도의 4.6 요금표를 공개하지 않았기 때문에 Grok 4.5의 공개 가격을 사용했다. 출력 토큰 100만 개당 Grok은 $6, Fable 5는 $50이다. 다만 200K 토큰을 넘으면 Grok 가격이 대략 두 배로 오르면서 격차가 줄어든다.
컨텍스트 윈도우가 더 큰 모델은 무엇인가?
Fable 5다. Fable 5는 1,000,000토큰, Grok은 500,000토큰을 지원한다. 전체 코드베이스를 컨텍스트에 유지해야 하는 작업에서는 이 차이가 Grok의 가격 우위보다 중요할 수 있다.
Grok Build에서 기존 Claude Code 설정을 사용할 수 있나?
가능하다. Grok Build는 별도의 포팅 없이 CLAUDE.md, Claude Code 플러그인, 스킬, MCP 서버, 에이전트, 훅을 자동으로 읽는다. Grok 전용 설정을 위한 자체 .grok/ 디렉터리도 추가한다.
Grok 4.5 벤치마크를 Grok 4.6 성능의 대리 지표로 봐도 되나?
성능 자체를 판단하는 기준으로는 적절하지 않다. Grok 4.6은 4.5보다 Intelligence Index에서 약 5점 상승했고, Fable 5와의 6점 격차를 약 3점으로 줄였다. 4.5가 분명히 뒤처졌던 CursorBench에서는 Fable 5 Max와 동률을 기록했다. 이 글에 포함된 속도와 토큰 단가 수치는 동등한 Grok 4.6 측정 결과가 아직 공개되지 않았기 때문에 Grok 4.5 기준이다.
쉽게 해소되지 않는 트레이드오프
이 비교의 어떤 벤치마크도 저장소가 50,000줄이고 요구사항이 모호하며, 실패 한 번에 디버깅 시간이 한 시간씩 늘어나는 상황에서도 비용 우위가 유지된다고 단정해주지는 않는다. Fable 5의 1M 컨텍스트와 더 높은 지능 상한선은 바로 이런 상황을 위한 것이다. Grok 4.6의 저렴한 작업 처리와 Fable 5의 비싼 확실성이 맞서는 구도이며, 격차가 충분히 커서 대부분의 팀은 두 모델을 모두 운영하게 된다.
관련 글: Grok 4.6 vs GPT-5.6 · Grok 4.6 vs Opus 5 · Claude Sonnet 5 vs Fable 5