 AIREITER
스크린샷과 UI까지 다루는 에이전트라면 GLM-5.3-Flash, 긴 입력을 반복 재사용하는 텍스트·코드 워크로드라면 DeepSeek V4 Flash가 더 잘 맞는다. 단일 벤치마크 점수보다 실제 작업 방식과 과금 구조가 선택에 더 큰 영향을 준다.
비교 전 모델 ID부터 확인해야 한다
이 비교의 대상은 GLM-5.3-Flash(glm-5.3-flash)와 DeepSeek의 프로덕션 API 모델 deepseek-v4-flash다. DeepSeek 공식 가격 페이지에서는 후자를 DeepSeek-V4-Flash-0731로 표기한다. DeepSeek V4 Pro와 별도 엔드포인트인 deepseek-v4-flash-vision-exp는 여기서 다루는 메인 Flash 모델의 대체재가 아니다. Ox Alpha의 정체, 하드웨어 제한, 프리뷰 관련 주의사항은 AIReiter GLM-5.3-Flash review에서 확인할 수 있다.
용도별로 빠르게 고르면
| 우선순위 | 추천 모델 | 이유 |
|---|---|---|
| 스크린샷-코드 변환, UI 점검, 비디오·파일 입력 | GLM-5.3-Flash | 하나의 모델에서 이미지·비디오·파일을 네이티브로 입력받음 |
| 캐시 적중률이 높은 텍스트 전용 대량 처리 | DeepSeek V4 Flash | 공식 캐시 입력 단가가 더 낮고, 특히 비피크 시간대에 유리함 |
| GLM 프로모션 기간의 신규 입력·출력 비중이 큰 트래픽 | GLM-5.3-Flash | 프로모션 입력·출력 단가가 DeepSeek 공식 캐시 미스·출력 단가보다 낮음 |
| 터미널 중심 코딩과 보수적인 프로덕션 선택 | DeepSeek V4 Flash | 버전이 명시된 퍼블릭 베타 경로와 공식 Flash 평가 결과를 제공 |
| 시각 정보를 보는 브라우저·컴퓨터 사용 에이전트 | GLM-5.3-Flash | 코딩·도구 사용 루프 안에서 시각 피드백을 바로 처리할 수 있음 |
| 100만 토큰 텍스트 컨텍스트 | 기본값으로는 둘 다 아님 | 둘 다 1M급 컨텍스트를 내세우므로 실제 프롬프트 크기에서 검색 성능을 검증해야 함 |
| 텍스트·코드·이미지를 하나의 모델로 처리 | GLM-5.3-Flash | 주요 멀티모달 경로에 별도 비전 엔드포인트가 필요 없음 |
공식 사양에서 확인되는 차이
Z.AI 모델 문서와 Z.AI 가격 페이지는 GLM의 모델 사양과 과금을 설명한다. DeepSeek 쪽 정보는 Models & Pricing 문서와 변경 로그에서 Flash 버전 및 기능을 확인할 수 있다.
| 사양 | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| API 모델 ID | glm-5.3-flash | deepseek-v4-flash |
| 공개 버전 | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| 컨텍스트 윈도우 | 1M 토큰 | 1M 토큰 |
| 공식 문서상 최대 출력 | 128K 토큰 | 384K 토큰 |
| 주요 입력 유형 | 텍스트, 이미지, 비디오, 파일 | 텍스트와 코드, 비전은 별도 실험 모델 |
| 출력 | 텍스트 | 텍스트 |
| 추론 제어 | Thinking 활성화, reasoning_effort 지원 | Thinking·Non-thinking 모드, low·high·max effort |
| 도구 및 구조화 출력 | Function calling, 스트리밍, 컨텍스트 캐싱, JSON 출력 | Tool calls, JSON 출력, Responses API, Anthropic API 호환 |
| 가중치 | 제공사가 공개 가중치 배포 | 제공사가 공개 가중치 배포 |
GLM의 총 320B 파라미터와 활성 18B 파라미터는 희소 전문가 아키텍처를 설명하는 수치이며, 18B 로컬 체크포인트를 의미하지는 않는다. DeepSeek의 공식 Flash 가격 페이지에는 이에 대응하는 파라미터 수가 공개되어 있지 않다.
GLM은 메인 모델 경로에서 시각 입력을 받는다. 반면 DeepSeek는 deepseek-v4-flash-vision-exp를 별도로 제공하므로, 라우팅과 테스트 방식도 달라진다.
코딩·에이전트 평가는 두 갈래로 봐야 한다
터미널 에이전트는 저장소 작업과 도구 실행 능력을 검증한다. 비주얼 에이전트는 여기에 렌더링된 UI와 GUI 상태를 해석하는 능력까지 요구한다.
터미널과 저장소 작업
Z.ai의 출시 표와 DeepSeek의 공식 7월 31일 업데이트에는 다음 결과가 제시되어 있다.
| 벤치마크 | GLM-5.3-Flash | DeepSeek V4 Flash | 근거 상태 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | 각 제공사가 별도로 보고한 평가 |
| DeepSWE | 63.4 | 54.4 | 각 제공사가 별도로 보고한 평가 |
| Toolathlon Verified | 78.4 | 70.3 | 각 제공사가 별도로 보고한 평가 |
| AutomationBench | 48.8 | 25.1 | 각 제공사가 별도로 보고한 평가 |
| Agents’ Last Exam | 26.3 | 25.2 | 각 제공사가 별도로 보고한 평가 |
제공사 발표 수치만 놓고 보면 GLM이 앞선다. 다만 평가 하네스가 서로 다르므로, 이 결과는 후보를 추리는 데 활용하되 최종 선택의 근거로 단정해서는 안 된다.
독립 테스트를 보면 결론은 한쪽으로 기울지 않는다. Composio가 8월 27일 수행한 30개 다단계 에이전트 작업 테스트에서는 GLM-5.3-Flash가 21/30, DeepSeek V4 Flash가 20/30을 완료했다. DeepSeek는 30개 작업 중 19개에서 가장 빨랐고, 성공 작업당 보고 비용은 DeepSeek 약 $0.028, GLM 약 $0.06이었다. 이 수치는 두 제공사가 아닌 Composio의 테스트에서 나온 것이다.
속도, 재현성, 그리고 방어 가능한 초기 선택지가 중요한 터미널 중심 에이전트라면 DeepSeek V4 Flash부터 시작하는 편이 좋다. 첫 시도에서의 수정 품질이나 더 폭넓은 도구 동작이 비용 차이만큼 가치 있는지 확인하려면 GLM도 함께 측정해야 한다.
도구 사용, 브라우저 상태, 시각 피드백
에이전트가 자신이 만든 결과물을 직접 확인해야 한다면 GLM 쪽이 제품 구조상 더 잘 맞는다. Z.ai는 모델이 스크린샷이나 렌더링된 인터페이스를 읽고, 구현을 수정한 뒤, 다시 결과를 점검하는 루프를 설명한다. 스크린샷-코드 변환, 프런트엔드 디버깅, 브라우저 사용, 문서 작업, 일부 3D 워크플로에 해당한다.
DeepSeek는 deepseek-v4-flash를 통해 텍스트·코드 기반 에이전트 작업을 처리할 수 있다. 하지만 시각 입력은 별도 경로인 deepseek-v4-flash-vision-exp가 필요하다. 기존 파이프라인에 비전 라우팅이 이미 있다면 이 분리는 문제가 아닐 수 있다. 반대로 소스 코드, 브라우저 스크린샷, 비디오를 엔드포인트 전환 없이 오가는 에이전트라면 GLM이 더 깔끔하다. 이 사이트의 DeepSeek V4 Flash Vision Exp API guide에서 대안 경로를 다룬다.
벤치마크 이후 실제 사용자 경험
커뮤니티 의견은 절대적인 승자보다 트레이드오프를 가리킨다. 한 사용자는 이틀간 GLM-5.3-Flash를 집중 사용한 뒤, 작은 컨텍스트에서는 성능이 좋지만 프롬프트가 커질수록 안정감이 떨어졌다고 했고, 이미지 지원은 장점으로 꼽았다.
“When it grows bigger, it starts to act anxious and sloppy.” — @XBToshi, 공개 비교에서 GLM-5.3-Flash를 이틀간 집중 사용한 경험을 공유
이는 실패율을 뜻하는 데이터가 아니라 일화적 관찰이다. 다만 벤치마크 표만으로는 보이지 않는 실패 양상을 짚어 준다. 큰 컨텍스트 한도가 곧 안정적인 멀티턴 에이전트 동작을 보장하지는 않는다.
작은 규모의 Ollama 실험에서도 제공사별 쿼터 단위 기준으로는 DeepSeek가 우세했다. 다만 작성자는 그 단위를 API 달러 비용과 동일시하지 않았다.
지연 시간과 서빙 데이터는 결론을 바꿀 수 있다
이 두 정확한 모델을 동일 하네스에서 비교한 p50 지연 시간이나 처리량 데이터는 공개되지 않았다. Pro, Vision-Exp 또는 다른 경로의 결과를 가져와 적용해서는 안 된다. Composio 테스트에서 DeepSeek가 30개 에이전트 작업 중 19개에서 가장 빨랐던 것은 유용한 신호지만, 처리량 지표는 아니다. 대화형 어시스턴트는 첫 유효 도구 호출까지의 시간을, 배치 작업은 승인된 결과가 나올 때까지의 전체 경과 시간을 측정하는 편이 좋다.
토큰 단가와 완료 작업당 비용은 다르다
공식 요금표를 보면 “DeepSeek가 더 저렴하다”는 식의 결론은 지나치게 단순하다. Z.AI는 2026년 9월 9일 24:00 UTC+8까지 GLM-5.3-Flash 50% 프로모션을 안내한다. DeepSeek는 캐시 적중과 미스를 구분하고, 피크·비피크 시간대별로 가격을 책정한다.
아래 금액은 모두 100만 토큰당 미국 달러 기준이다.
| 과금 항목 | GLM-5.3-Flash 프로모션 | GLM-5.3-Flash 정가 | DeepSeek V4 Flash 비피크 | DeepSeek V4 Flash 피크 |
|---|---|---|---|---|
| 신규 입력/캐시 미스 | $0.075 | $0.15 | $0.22 | $0.44 |
| 캐시 입력 | $0.015 | $0.03 | $0.007 | $0.014 |
| 출력 | $0.25 | $0.50 | $0.66 | $1.32 |
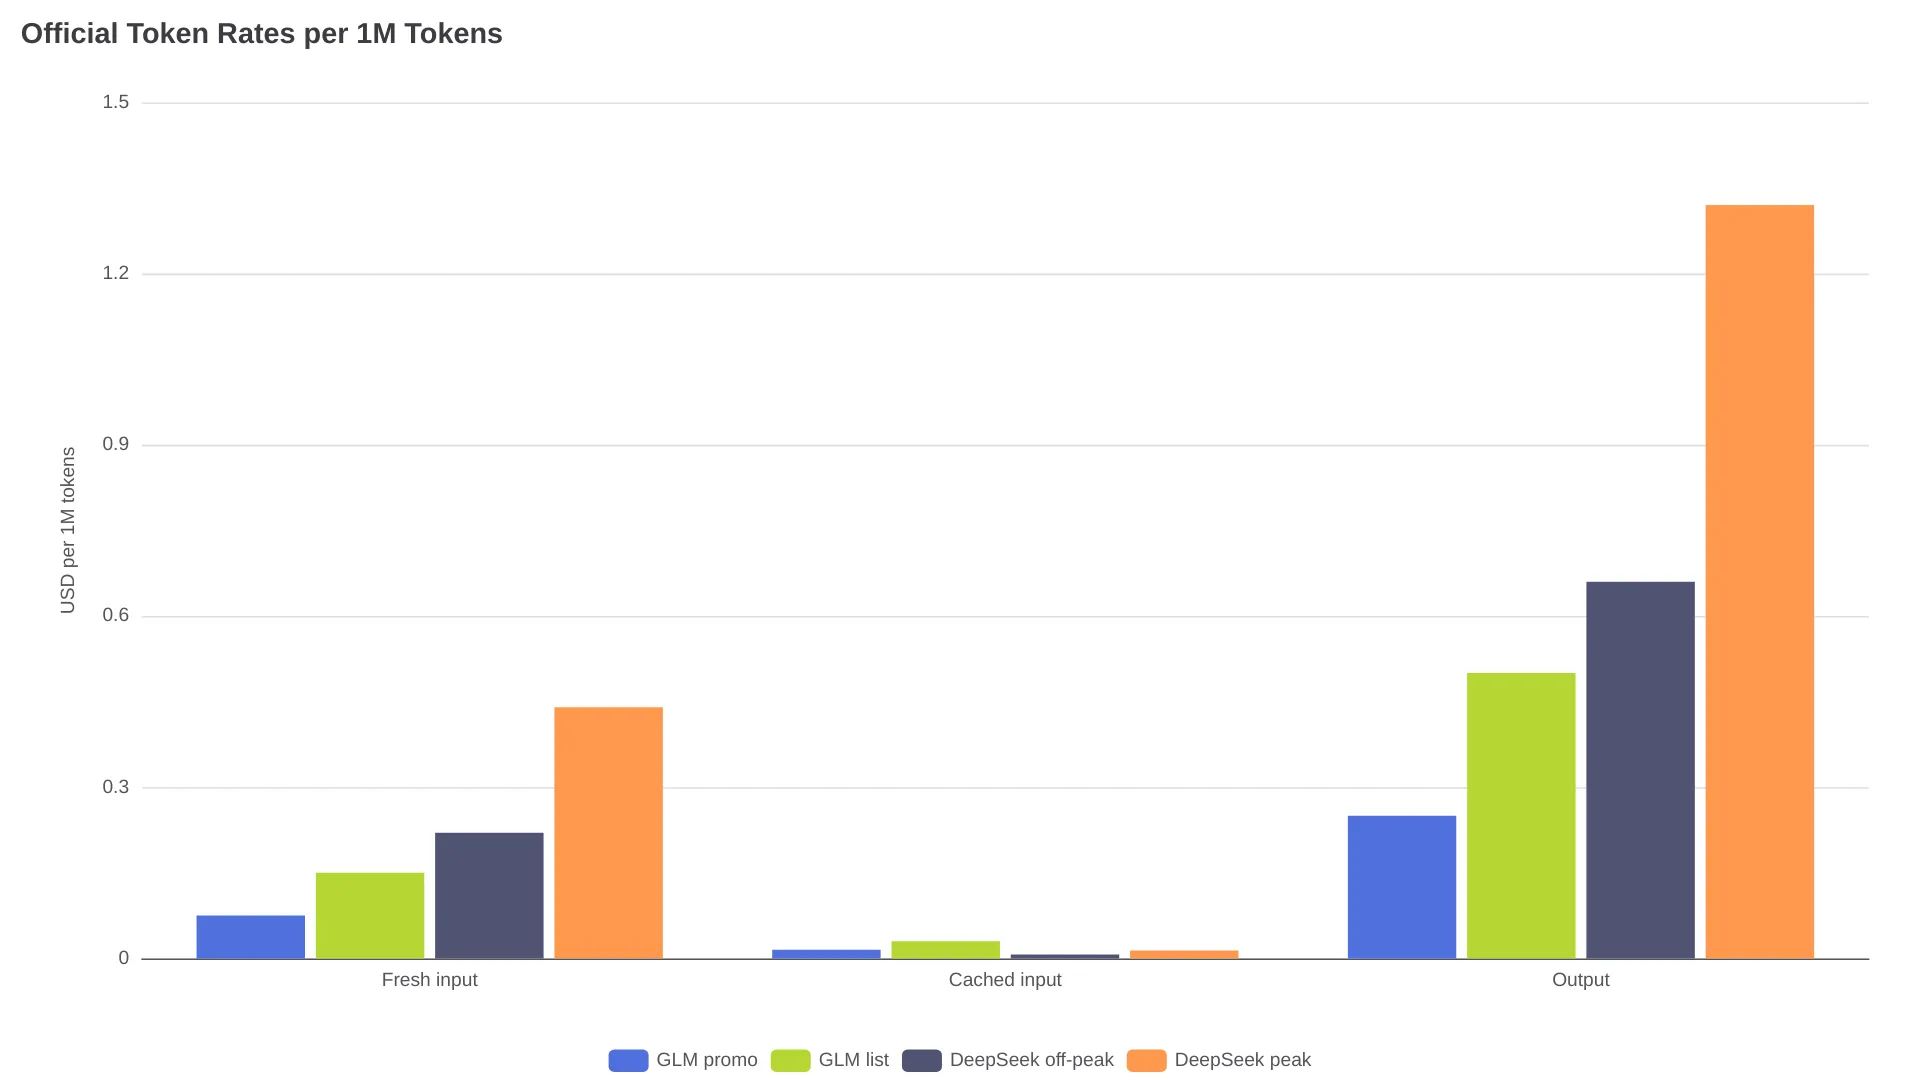
DeepSeek의 피크 시간은 월요일부터 금요일까지 01:00–04:00 UTC 및 06:00–10:00 UTC이며, 나머지 시간은 모두 비피크다. 공식 표에는 V4 Flash의 동시성 한도도 2,500으로 제시되어 있다. GLM 가격 페이지에는 기간 한정 무료 캐시 입력 저장이 표시되지만, 공통 동시성 수치는 별도로 안내하지 않는다.
- 캐시 입력 가격은 DeepSeek가 우세하다. 모든 대응 시간대에서 그렇다.
- 신규 입력과 출력 가격은 GLM 프로모션이 유리하다. DeepSeek의 공식 캐시 미스·출력 단가보다 낮다.
- 프로모션 종료 후에도 GLM의 정가 신규 입력·출력 단가는 DeepSeek의 비피크 표기 요금보다 낮다.
- DeepSeek가 가장 강한 가격 경쟁력을 보이는 경우는 짧은 출력과 높은 캐시 비중의 입력 중심 트래픽이며, 특히 비피크 시간에 예약 실행할 수 있을 때다.
입력 10M / 출력 2M 예시
도구 수수료나 재시도 없이, 신규 입력 1,000만 토큰과 출력 200만 토큰을 사용한다고 가정해 보자.
| 모델 및 과금 경로 | 계산 | 합계 |
|---|---|---|
| GLM 프로모션 | 10 × $0.075 + 2 × $0.25 | $1.25 |
| GLM 정가 | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek 비피크, 캐시 미스 | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek 피크, 캐시 미스 | 10 × $0.44 + 2 × $1.32 | $7.04 |
입력 1,000만 토큰이 전부 캐시 적중이라면 DeepSeek 비피크 총액은 $1.39(10 × $0.007 + 2 × $0.66)가 된다. GLM 프로모션 총액은 $0.65(10 × $0.015 + 2 × $0.25)다. 입력 대비 출력 비율이 훨씬 높고 출력이 짧아질수록 DeepSeek의 캐시 이점은 더 중요해진다.
DeepSeek의 낮은 청구액이 결정적인 경우
대부분의 요청이 길고 안정적인 시스템 프롬프트나 저장소 프리픽스를 재사용하고, 짧은 답변을 생성하며, 피크 시간이 아닌 때에 실행할 수 있다면 DeepSeek V4 Flash를 선택할 만하다. 분류, 추출, 요약, 일상적인 텍스트 전용 자동화는 스크린샷 기반 에이전트보다 이 패턴에 더 잘 맞는다.
GLM의 추가 기능이 전체 비용을 낮출 수 있는 경우
이미지, 문서, 비디오 처리에 별도 비전 요청이 필요했다면 GLM은 파이프라인 비용을 줄일 수 있다. 긴 코드 패치를 생성하는 에이전트에서는 프로모션 출력 단가도 의미가 있다. 다만 어떤 모델이 완료 작업당 비용에서 보편적으로 이긴다고 가정하지 말고, 실제 청구 토큰, 수정 루프, 승인 작업률로 검증해야 한다.
긴 컨텍스트는 수용량일 뿐 품질 보증이 아니다
양쪽 공식 문서 모두 1M 토큰 컨텍스트 윈도우를 명시하므로, 컨텍스트 크기만으로는 무승부다. DeepSeek는 384K 최대 출력을, Z.AI의 모델 문서는 GLM-5.3-Flash에 대해 128K 최대 출력을 안내한다. 이 차이는 비정상적으로 긴 생성을 허용하는 애플리케이션에서만 중요하다.
Z.ai는 GLM-5.3 대비 어텐션 연산량이 3.01배 낮고 KV 캐시 크기가 4.44배 작다고 발표했다. 동시에 GLM의 KV 캐시는 DeepSeek V4 Flash보다 여전히 약간 크다고 언급한다. 이런 제공사 주장은 DeepSeek 대비 지연 시간이나 검색 품질의 우위를 입증하지는 않는다.
검색 성능, 도구 완료율, 승인 작업률은 50K, 200K, 그리고 실제 최대 프롬프트 크기에서 아래 게이트의 승인 규칙을 적용해 테스트해야 한다.
기본 모델을 정하거나 둘 다 라우팅하라
| 워크로드 | 먼저 테스트할 모델 | 폴백 또는 에스컬레이션 |
|---|---|---|
| 텍스트 전용 분류·추출 | DeepSeek V4 Flash | 포맷이나 품질이 실패하면 GLM |
| 캐시 비중이 높은 저장소 채팅 | DeepSeek V4 Flash | 어려운 수정 턴에는 GLM |
| 터미널 코딩 에이전트 | DeepSeek V4 Flash | 첫 시도 완료가 중요하면 GLM |
| 스크린샷-코드 변환 | GLM-5.3-Flash | 텍스트 전용 후속 작업은 DeepSeek |
| 브라우저·컴퓨터 사용 에이전트 | GLM-5.3-Flash | 비시각적 계획 단계는 DeepSeek |
| 비디오·이미지·파일 기반 분석 | GLM-5.3-Flash | 별도 경로를 허용할 수 있다면 DeepSeek Vision Exp |
| 긴 텍스트와 짧은 출력 | DeepSeek V4 Flash | 검색 성능이 저하되면 GLM |
| 프로모션 기간의 긴 코드 생성 | GLM-5.3-Flash | 캐시 적중 경제성이 압도적이면 DeepSeek |
프로덕션 워크로드를 바꾸기 전에는 작은 규모라도 동일 하네스 게이트를 실행하자.
- 정확한 ID를 고정한다.
glm-5.3-flash와deepseek-v4-flash를 사용하고, 라우터가 Pro나 Vision-Exp로 조용히 대체하지 않도록 한다. - 성공 작업과 최근 실패 사례를 포함한 실제 작업 20~50개를 사용한다. 제품이 에이전트형이라면 도구 사용 작업을 최소 다섯 개 포함한다.
- 통과율, 수정 루프, 도구 호출 누락, 첫 유효 행동까지 걸린 시간, 총 입력·출력 토큰, 캐시 적중률을 기록한다.
- 승인된 작업당 비용을 비교한 뒤, 타임아웃과 실패율이 안정될 때까지 다른 모델은 폴백으로 유지한다.
Z.AI 빠른 시작 가이드와 DeepSeek 첫 API 호출 가이드는 OpenAI 호환 접근 방식을 문서화한다. 단, 추론 제어, 비전 경로, 과금 의미는 서로 동일하지 않다.
구매자가 자주 묻는 질문
GLM-5.3-Flash는 Ox Alpha와 같은 모델인가?
Z.ai는 익명으로 테스트했던 Ox Alpha가 GLM-5.3-Flash였다고 공식적으로 밝혔다. 프리뷰 라우팅, 쿼터, 엔드포인트 동작을 공개 모델의 영구 사양으로 봐서는 안 된다.
라우팅 표로 먼저 후보를 정한 뒤, 고정된 ID와 실제 실패 사례, 동일한 하네스로 기본 선택을 검증하자. GLM-5.3-Flash review는 정체성과 배포 근거를, DeepSeek V4 Flash Vision Exp API guide는 별도 시각 입력 경로를 다룬다.