 AIREITER
정식 공개 전부터 익명 모델 Ox Alpha가 개발자 커뮤니티를 돌았습니다. 이제 Z.ai가 이 실험 모델에 공식 이름을 붙였습니다. 바로 GLM-5.3-Flash입니다. 다만 ‘Flash’라는 이름만 보고 가벼운 모델이라고 생각하면 곤란합니다. 토큰마다 실제로 활성화되는 파라미터는 18B지만, 공개 체크포인트 전체 규모는 약 320B에 달해 로컬 구동에는 여전히 상당한 하드웨어가 필요합니다.
결론부터 말하면, Ox Alpha는 GLM-5.3-Flash의 프리뷰였다
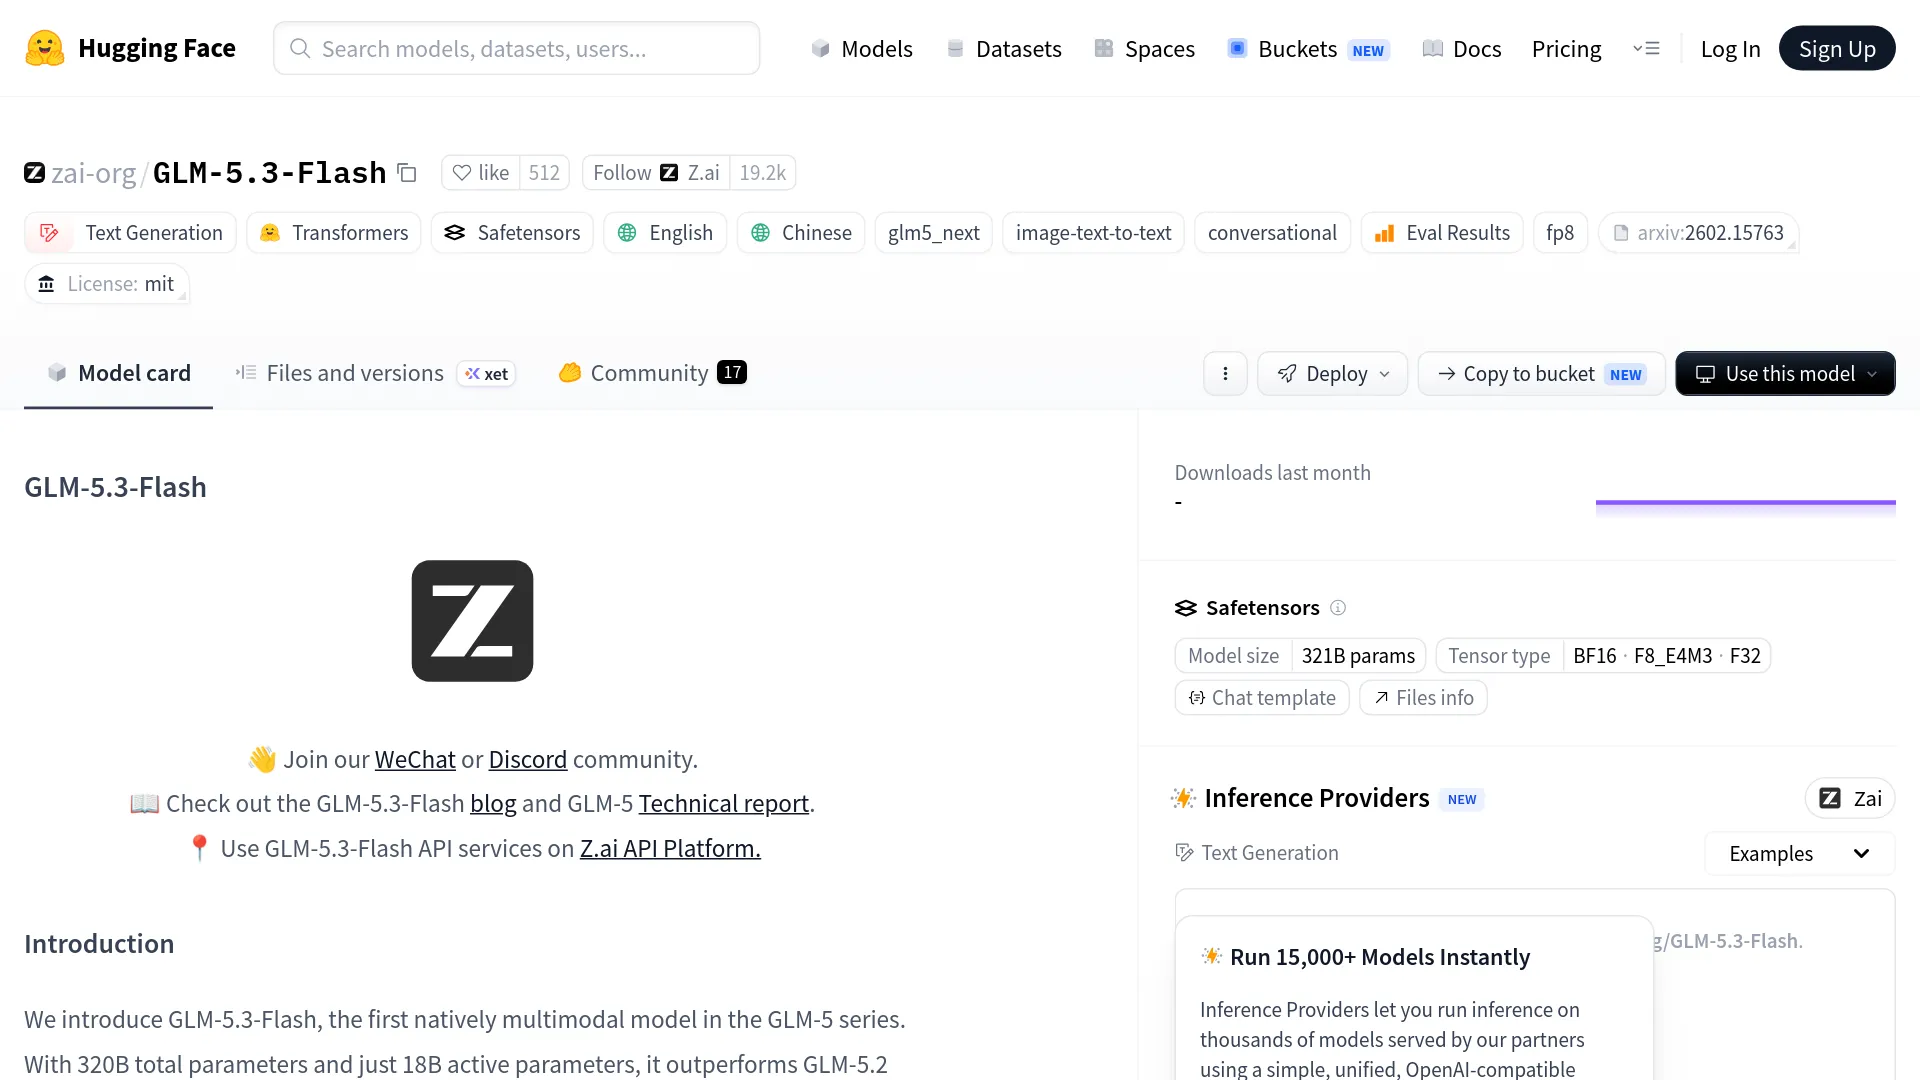
Z.ai는 2026년 8월 26일 발표에서 OpenCode와 OpenRouter를 통해 익명으로 먼저 공개했던 Ox Alpha가 GLM-5.3-Flash였다고 밝혔습니다. 공식 Hugging Face 모델 카드에는 이제 공개 체크포인트와 MIT 라이선스, 멀티모달 입력, 로컬 서빙 관련 자료가 등록돼 있습니다.
따라서 Ox Alpha에 대한 기존 사용기는 정식 출시 모델의 확정 사양이 아니라 프리뷰 단계에서 얻은 참고 자료로 보는 편이 정확합니다. Ox Alpha는 별도의 라우팅, 트래픽, 운영 조건에서 제공됐기 때문에 당시의 속도나 쿼터, 정책 관련 경험이 모든 GLM-5.3-Flash 엔드포인트에 그대로 적용된다고 보기는 어렵습니다.
“저에게 달라진 건 없습니다. 두 모델 모두 32GB RAM 시스템에서는 너무 큽니다.” — r/LocalLLaMA의 u/dampflokfreund
GLM-5.3-Flash 핵심 사양
| 항목 | GLM-5.3-Flash |
|---|---|
| 공식 출시일 | 2026년 8월 26일 |
| 이전 프리뷰 이름 | Ox Alpha / ox-alpha |
| 모델 구성 | 전체 320B 파라미터, 토큰당 18B 활성화 |
| 컨텍스트 윈도 | 1,048,576토큰(1M) |
| 입력 | 텍스트, 이미지, 동영상 |
| 출력 | 텍스트 |
| 라이선스 | MIT |
| 공식 체크포인트 | zai-org/GLM-5.3-Flash |
| API 입력 요금 | 토큰 1M개당 $0.15 |
| 캐시 입력 요금 | 토큰 1M개당 $0.03 |
| API 출력 요금 | 토큰 1M개당 $0.50 |
Hugging Face 페이지에는 저장된 모델 규모가 약 321B 파라미터로 표시되지만, 모델 설명에서는 320B-A18B라는 표기를 사용합니다. 전자는 전체 저장 용량, 후자는 토큰마다 실제 계산에 참여하는 파라미터 수를 가리킵니다. 따라서 활성 파라미터가 18B라고 해서 이 체크포인트가 18B급 로컬 모델이 되는 것은 아닙니다.
Ox Alpha에서 정식 공개 모델로 바뀐 점
Z.ai에 따르면 GLM-5.3-Flash는 정식 출시 전에 Ox Alpha라는 익명 이름으로 OpenCode와 OpenRouter에서 운영되며 실제 사용 피드백을 수집했습니다. 당시 OpenRouter 등록 정보에는 멀티모달 입력과 긴 컨텍스트를 지원하는 프리뷰 모델로 소개됐고, 가격은 한시적으로 $0였습니다. 이번 공개로 제공 주체와 체크포인트, 라이선스를 공식적으로 확인할 수 있게 됐습니다.
다만 프리뷰와 정식 모델은 서로 다른 운영 환경입니다. 토크나이저가 일치하거나 GLM 계열 API 오류가 나타난다는 사실은 계보를 추정하는 근거가 될 수 있지만, 익명 요청마다 최종 가중치가 사용됐는지, 동일한 라우팅 계층을 거쳤는지까지 증명하지는 못합니다. 이제 배포와 재현성 검증의 기준은 공개된 공식 체크포인트입니다.
‘Flash’라는 이름 뒤에 있는 구조
GLM-5.3-Flash는 희소 혼합 전문가 구조에 초장문 컨텍스트 처리 비용을 낮추기 위한 어텐션 변경을 결합했습니다. Z.ai가 공개한 구성은 전체 320B 파라미터, 활성 파라미터 18B, 45개 레이어, 하이브리드 희소·선형 어텐션, IndexPool 검색, Manifold-Constrained Hyper-Connections(mHC)입니다. 모델 카드에는 30T 토큰 규모의 멀티모달 사전 학습 데이터로 학습했다는 설명도 담겨 있습니다.
Z.ai는 GLM-5.3 대비 1M 컨텍스트에서 어텐션 연산량이 3배 줄고 KV 캐시가 4.4배 작아진다고 설명합니다. 이는 모델 구조에 대한 제조사 측 주장이지, 어떤 하드웨어에서도 동일하게 보장되는 지연 시간은 아닙니다. 실제 속도는 컨텍스트 길이와 동시 요청 수, 이미지 전처리, 서빙 스택에 따라 달라집니다.
이 모델의 멀티모달 기능은 단순히 ‘이미지를 보는 챗봇’이라고 부르는 것보다 에이전트 작업에서 더 의미가 큽니다. Z.ai가 상정한 활용 방식은 에이전트가 렌더링된 인터페이스나 브라우저 상태, 문서 같은 시각 자료를 확인한 뒤 코드나 결과물을 수정하는 흐름입니다. 공식 모델 카드에는 이미지 입력 예제가 포함돼 있고, 공개 모델 및 배포 문서에는 동영상 입력도 지원한다고 안내돼 있습니다.
벤치마크가 보여주는 것과 보여주지 않는 것
공식 발표와 모델 카드는 특히 코딩 및 에이전트 작업에서 강력한 결과를 제시합니다. 모델 카드에 표시된 주요 수치는 TerminalBench 2.1 84.3, DeepSWE 63.4, HLE 55.3입니다. Z.ai 발표 자료는 Artificial Analysis Intelligence Index 57, AutomationBench 48.8, Z.ai Code Bench 최대 노력 설정 29.0도 함께 보고합니다.
| 벤치마크 | GLM-5.3-Flash | 비교 모델 또는 기준 | 출처 및 한계 |
|---|---|---|---|
| TerminalBench 2.1 | 84.3 | GLM-5.2: 81.0; Claude Opus 4.8: 85.0 | Z.ai/모델 카드 결과. 하네스와 토큰·시간 예산의 영향을 받음 |
| DeepSWE v1.1 | 63.4 | GLM-5.2: 46.2 | 보고된 평가 결과. 모든 저장소에 일반화할 수 없음 |
| AutomationBench | 48.8 | GLM-5.2: 26.2 | 특정 벤치마크 버전으로 진행한 평가 결과 |
| Z.ai Code Bench, 최대 노력 | 29.0 | Claude Opus 4.8: 29.5 | Z.ai 환경에서 거의 동급이라는 주장 |
| Artificial Analysis Intelligence Index v4.1.1 | 57 | Z.ai는 Claude Opus 4.8과 비슷한 수준이라고 설명 | 외부 지수. 코딩에만 특화된 점수가 아님 |
각 결과는 서로 다른 하네스와 컨텍스트 제한, 타임아웃, 평가 방식을 사용합니다. 따라서 하나의 절대적인 리더보드처럼 비교하기보다는 방향성을 확인하는 자료로 보는 것이 맞습니다. 가장 타당한 결론은 GLM-5.3-Flash가 코딩 에이전트 평가에서 GLM-5.2보다 크게 개선됐다는 근거를 확보했다는 것이지, 모든 최상위 모델을 압도한다는 뜻은 아닙니다.
초기 커뮤니티 테스트에도 같은 주의가 필요합니다. @prz_chojecki는 226개 ErdosBench 문제 전체에서 Ox Alpha가 GLM-5.2보다 높은 점수를 냈다고 보고했습니다. 이런 관찰은 직접 테스트할 항목을 고르는 데는 유용하지만, 자신이 사용하는 도구와 저장소를 통제된 환경에서 평가하는 일을 대신할 수는 없습니다.
초기 사용자들이 확인한 현실적인 한계
‘Flash’는 대화형 응답 속도보다는 활성 연산량과 비용 측면을 더 잘 설명하는 이름에 가깝습니다. r/opencodeCLI의 실제 사용자들은 익명 프리뷰 기간에 강력한 코딩 성능을 경험하는 동시에 답답할 정도로 긴 대기 시간도 보고했습니다. 다만 이는 공식 지연 시간 벤치마크가 아니라 특정 제공업체와 작업 부하에서 나온 경험담입니다.
“메인 모델보다 훨씬 느린데 어떻게 ‘Flash’라고 부를 수 있죠?” — r/opencodeCLI의 u/ahriad
운영 측면에서 가장 중요한 신호는 부하가 걸린 상태에서 장시간 실행되는 에이전트의 안정성입니다. @solomonneas는 7일간 진행한 테스트에서 49번 시도 중 30번의 빌드가 성공했고, 14번은 타임아웃으로 실패했다고 보고했습니다. 이것만으로 공식 API의 고정 실패율을 증명할 수는 없지만, 몇 시간씩 실행되는 작업에는 대체 경로를 마련해야 한다는 근거는 됩니다.
벤치마크 수치가 가리기 쉬운 로컬 배포의 한계도 있습니다. 공식 FP8 체크포인트는 런타임과 KV 캐시 오버헤드를 제외하고도 약 306 GiB입니다. 전체 320B 모델인 만큼 토큰당 18B 파라미터만 활성화되더라도 로컬 구동에는 대용량 메모리 인프라가 필요합니다.
API, 호스팅 서비스, 로컬 배포 선택지
호스팅 방식으로 사용할 경우 Z.ai 가격표는 GLM-5.3-Flash의 요금을 입력 토큰 1M개당 $0.15, 캐시된 입력 토큰 1M개당 $0.03, 출력 토큰 1M개당 $0.50로 안내합니다. 한시적인 50% 프로모션에서는 입력 $0.075, 캐시 입력 $0.015, 출력 $0.25가 적용되며, 2026년 9월 9일 24:00(UTC+8)에 종료됩니다. 예산을 산정하기 전에는 프로모션 종료일이 명시돼 있으므로 Z.AI 공식 가격표를 확인해야 합니다.
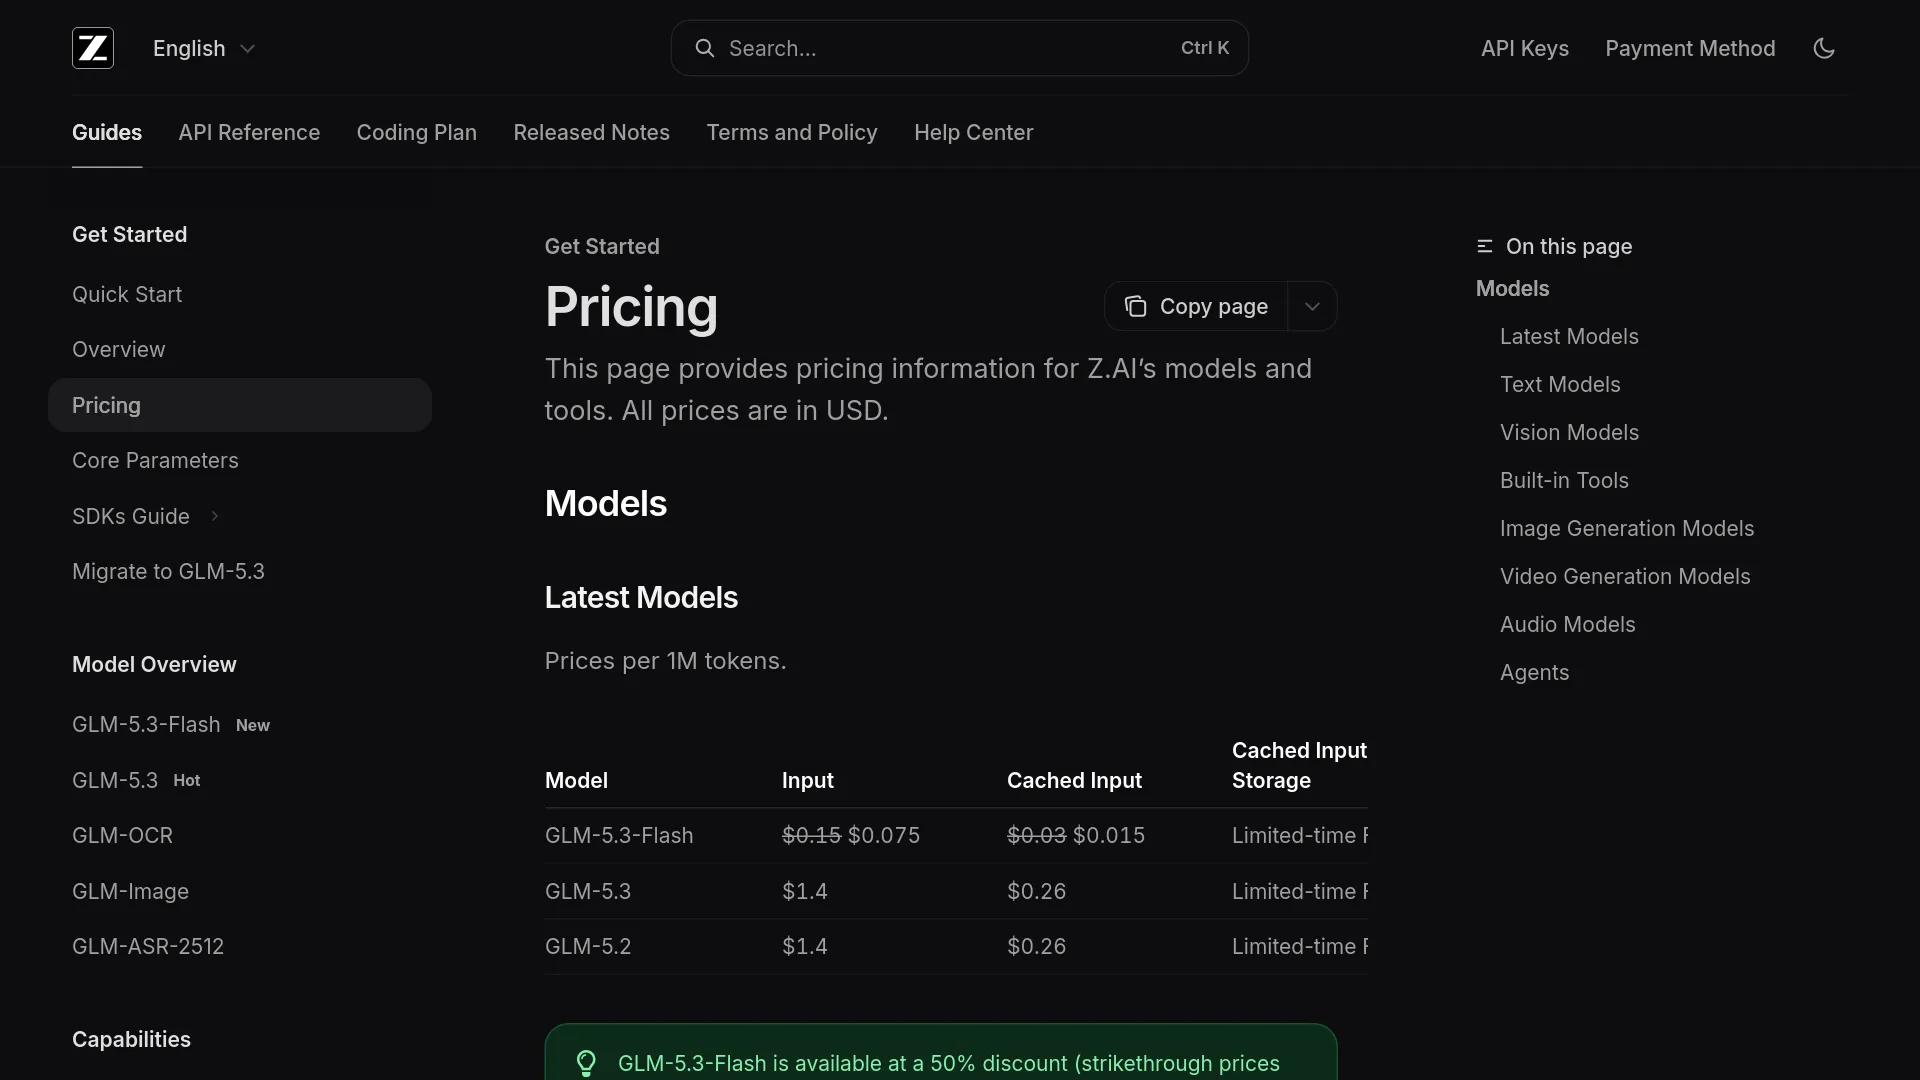
공식 가격표는 Ox Alpha 프리뷰 당시의 한시적 무료 가격과 별개입니다. 간단한 예로 입력 10M 토큰과 출력 2M 토큰을 정가로 처리하면 다른 제공업체 수수료를 제외하고 $2.50입니다. 계산식은 10 × $0.15 + 2 × $0.50입니다. 제공업체가 해당 토큰을 캐시 입력으로 과금한다면 입력 비용은 더 낮아질 수 있습니다.
로컬 서빙도 가능하지만, 노트북에 내려받아 실행하는 수준의 작업은 아닙니다. 공식 vLLM 레시피는 FP8 가중치에 약 306 GiB, 기본 FP8 배포에 386GB VRAM, BF16에는 772GB가 필요하다고 안내합니다. 지원 경로에서는 현재 NVIDIA Hopper 이상 GPU, 최신 FlashInfer 버전, 통합이 진행되는 동안 사용할 전용 vLLM 이미지도 요구합니다.
KTransformers 튜토리얼은 CPU-GPU 이기종 추론, 공식 FP8 가중치 직접 사용, 최소 350GB의 여유 시스템 메모리를 설명합니다. 튜토리얼의 단일 GPU 예시는 오프로딩 구성일 뿐, 소비자용 GPU 한 장에 모델 전체를 담을 수 있다는 의미는 아닙니다. 또한 검증된 501,025토큰 설정을 사용하며, 멀티모달 요청 하나당 이미지 8장 또는 동영상 1개로 제한합니다.
| 배포 방식 | 문서에서 확인되는 지원 범위 | 주요 제약 |
|---|---|---|
| Z.ai API | 종량제 호스팅 액세스. 일반 및 프로모션 토큰 요금 공개 | 요청 제한, 지역별 약관, 현재 프로모션을 확인해야 함 |
| vLLM | FP8/BF16 서빙, OpenAI 호환 엔드포인트, 텐서 병렬화, 멀티모달 경로 | 대용량 NVIDIA 인프라 필요. 현재 레시피는 Hopper 이상을 대상으로 함 |
| KTransformers | CPU-GPU 이기종 추론 및 FP8 로딩 | 가중치 약 306 GiB. 시스템 메모리 최소 350GB 권장 |
| Ollama/LM Studio/llama.cpp 생태계 | 모델 카드에서 양자화 배포판과 호환 도구를 안내 | 양자화 지원 여부와 속도는 빌드별로 다름 |
지금 GLM-5.3-Flash를 써볼 만한 사람
비용에 민감한 코딩 에이전트와 장문 컨텍스트 엔지니어링을 시험하려는 사람에게 적합합니다. 낮은 정가, 1M 컨텍스트, GLM-5.2 대비 개선된 것으로 보고된 성능을 고려하면 저장소 분석, 여러 파일을 아우르는 수정, 테스트 생성, 반복적인 에이전트 호출에 유력한 후보입니다. 다만 자체 성공률이 안정될 때까지는 승인 테스트와 대체 모델을 함께 운영하는 편이 좋습니다.
텍스트 전용 GLM 모델이 병목인 멀티모달 기술 작업에도 유용합니다. 이미지와 동영상 입력을 활용하면 에이전트가 브라우저 출력, UI 레이아웃, 다이어그램, 문서, 렌더링 결과물을 직접 확인할 수 있습니다. 다만 동영상 생성 모델은 아닙니다. 시각 입력을 분석한 뒤 텍스트나 코드를 출력하는 모델입니다.
‘활성 파라미터 18B’라는 숫자만 보고 데스크톱용 모델이라고 선택해서는 안 됩니다. 전체 체크포인트는 약 320B 파라미터이며, 로컬 서빙에는 컨텍스트와 런타임 오버헤드를 제외하고도 수백 GB의 저장 공간 또는 메모리가 필요합니다. 이미 대용량 추론 하드웨어를 운영 중인 경우가 아니라면 호스팅 API가 대체로 더 간단하고 경제적인 선택입니다.
검증되지 않은 프리뷰 엔드포인트에 기밀 코드를 보내지 마세요. 공개된 GLM-5.3-Flash는 Z.ai가 제공하는 모델임을 확인할 수 있지만, 제공업체의 약관과 데이터 보존 정책, 요청 라우팅 방식은 여전히 중요합니다. 프로덕션 트래픽을 보낼 때는 해당 엔드포인트의 최신 데이터 정책을 기록하고, 공식 API나 운영 조건을 감사할 수 있는 제공업체를 사용해야 합니다.
자주 묻는 질문
Ox Alpha와 GLM-5.3-Flash는 정확히 같은 모델인가요?
Z.ai는 GLM-5.3-Flash가 과거 Ox Alpha라는 이름으로 프리뷰됐던 모델이라고 공식적으로 밝혔습니다. 초기 Ox Alpha의 동작은 참고 자료로 활용할 수 있지만, 프리뷰 당시의 라우팅과 제한을 공개 모델의 사양으로 간주해서는 안 됩니다.
GLM-5.3-Flash는 오픈 소스인가요?
공식 Hugging Face 체크포인트는 MIT 라이선스로 공개됐고, Z.ai는 로컬 서빙 관련 자료도 제공합니다. 운영 관점에서 정확한 표현은 ‘오픈 웨이트’입니다. 가중치는 공개돼 있지만 전체 모델을 실행하려면 여전히 상당한 인프라가 필요합니다.
GLM-5.3-Flash를 로컬에서 실행하려면 메모리가 얼마나 필요한가요?
공식 FP8 가중치는 런타임과 KV 캐시 오버헤드를 제외하고 약 306 GiB를 차지합니다. vLLM 레시피는 기본 FP8 배포에 386GB VRAM을 제시하고, KTransformers는 이기종 추론에 최소 350GB 시스템 메모리를 권장합니다.
API 입력 요금이 정말 토큰 1M개당 $0.15인가요?
그렇습니다. Z.AI 공식 가격표는 입력 $0.15, 캐시 입력 $0.03, 출력 $0.50으로 안내합니다. 50% 프로모션은 2026년 9월 9일(UTC+8)까지 적용되는 것으로 표시돼 있습니다.
GLM-5.3-Flash가 다른 Flash 모델보다 빠른가요?
현재 공개된 자료만으로 보편적인 지연 시간 순위를 확정할 수는 없습니다. 초기 사용자들은 느리거나 타임아웃으로 끝나는 에이전트 세션을 보고했으므로, 실제 사용하는 제공업체 경로에서 첫 토큰까지의 시간, 완료 시간, 재시도 횟수, 작업 승인률을 직접 측정해야 합니다.
GLM-5.3-Flash는 이미지와 동영상을 지원하나요?
지원합니다. Z.ai와 공식 모델 카드는 텍스트, 이미지, 동영상 입력과 텍스트 출력을 설명합니다. 로컬 서빙 문서에는 KTransformers 설정 기준으로 요청 하나당 이미지 최대 8장 또는 동영상 1개라는 제한도 안내돼 있습니다.
수백 GB급 추론 장비를 새로 마련하지 않고도 GLM-5.3-Flash의 비용 경쟁력과 멀티모달 기능을 사용하고 싶다면 호스팅 API가 적합합니다. 로컬 서빙은 이미 필요한 인프라를 갖춘 경우에만 시험하는 편이 좋습니다. 장시간 실행되는 에이전트 작업에는 검증된 대체 모델을 준비하세요. 현재 공개된 근거는 성능과 가격 측면에서 더 강하고, 지속적인 대화형 안정성에 대해서는 아직 제한적이기 때문입니다.