 AIREITER
가볍게 시작하려면 입력 토큰 100만 개당 $0.04인 호스팅 API가 가장 간단하다. 다만 새 오픈 웨이트 체크포인트가 공개되면서 로컬 추론도 현실적인 선택지가 됐다. 단, 3B 모델과 600M 모델 사이에는 품질 격차가 뚜렷하다.
Liquid d1의 세 가지 선택지는 서로 대체재가 아니다
Liquid AI는 현재 세 가지 관련 옵션을 제공한다. 독점형 호스팅 d1 서비스, 오픈 웨이트 d1-3B, 실험적 오픈 웨이트 d1-omni-600M이다. Liquid AI는 호스팅 모델이 다운로드 가능한 두 체크포인트 중 어느 하나와 동일하다고 밝히지 않았다. 따라서 벤치마크나 지연 시간 수치는 반드시 해당 결과를 낸 모델에 한정해 해석해야 한다.
| 선택지 | 접근 방식 및 가격 | 입력 | 공개된 컨텍스트 | 적합한 용도 |
|---|---|---|---|---|
호스팅 d1 | Liquid API; 입력 토큰 100만 개당 $0.04, 출력 토큰 과금 없음 | Liquid에서 직접 텍스트 및 이미지 지원 | Vercel 기준 66K | 빠른 통합, 사실상 미미한 추론 비용, 모델 운영 불필요 |
d1-3B | 웨이트 다운로드 가능, 토큰당 모델 사용료 없음 | 텍스트, JSON, 이미지 | 32,768 토큰 | 최고의 로컬 품질, 비전, 프로덕션 평가 |
d1-omni-600M | 실험적 웨이트 다운로드 가능, 토큰당 모델 사용료 없음 | 텍스트+이미지 또는 텍스트+오디오 | 16,384 토큰 | 작은 풋프린트, 음성 명령 실험, 제약적인 엣지 디바이스 |
세 모델 모두 문장을 생성하는 대신, 입력된 질문에 판단을 내린다. noul은 yes 확률을, choice는 이름 붙은 선택지별 확률을, score는 순서가 있는 평가 기준에서 확률 가중 위치를 반환한다. 라우팅, 모더레이션, 검사, 가드레일, 스코어링에 적합하며 채팅 모델이나 코딩 모델을 대체하는 용도는 아니다.
추천은 분명하다. 파일럿에는 호스팅 d1을 쓰고, 데이터가 로컬에 머물러야 하거나 네트워크 홉 없는 지연 시간이 필요하다면 d1-3B를 선택하자. 오디오가 필수이거나 풋프린트가 결정적인 제약일 때를 제외하면 d1-omni-600M은 실험용으로 보는 편이 맞다.
API 요금과 로컬 운영비, 무엇이 다른가
Liquid AI d1 API의 가격은 입력 토큰 100만 개당 $0.04다. 이 서비스는 텍스트 생성 대신 결정을 반환하므로 출력 토큰 요금은 없다. 입력 토큰 1억 개를 처리하면 게이트웨이 수수료를 제외하고 $4, 10억 개면 $40이 든다.
$0.04/M 토큰이라는 가격에서는 추론 비용만 놓고 볼 때 셀프호스팅이 유리해지는 경우가 드물다. 로컬 배포는 프라이버시, 오프라인 사용, 온디바이스 지연 시간, 커스터마이징, 지속적인 높은 활용률이 필요할 때 선택할 이유가 있다.
두 오픈 체크포인트에는 공식 호스팅 토큰 단가가 없다. 리뷰 시점에 Hugging Face 페이지에도 추론 제공자가 표시되지 않았다. 따라서 호스팅 d1 요금을 d1-3B 또는 d1-omni-600M의 가격처럼 제시해서는 안 된다.
호스팅 서비스는 이미지도 입력으로 과금한다. Liquid AI 기준으로 32×32픽셀 패치당 1.5토큰이므로, 1024×1024 이미지는 질문 텍스트 이전에 1,536토큰이 계산된다. $0.04/M 기준 이미지 부분의 비용은 약 $0.00006144다. 질문마다 별도 프롬프트로 과금되며, 연결된 이미지도 각 프롬프트에 포함된다.
오픈 웨이트라고 해서 제약이나 비용이 없는 것은 아니다
두 저장소는 Apache 2.0이나 MIT가 아닌 Liquid AI의 lfm1.0 라이선스를 사용한다. Liquid AI의 일반 가격 정책에 따르면 다운로드 모델은 연간 회사 매출 $10 million 미만인 경우 상업적으로 무료 사용할 수 있다. 그보다 큰 조직이라면 “open-weight”라는 표현만으로 사용 권한을 추정하지 말고 최신 상업 조건을 확인해야 한다.
로컬 운영 예산에는 GPU나 디바이스 구매 비용, 유휴 용량, 모니터링, 업데이트, 인력 시간을 포함해야 한다. 호스팅 비용은 작고 사용량에 따라 변하지만, 로컬 비용은 대부분 고정비다.
d1-3B는 품질, omni는 풋프린트를 택하는 모델
공식 Open d1 발표에 따르면 Decision Index v0.2.1 점수는 d1-3B가 48.57, d1-omni-600M이 15.95다. Liquid AI는 두 모델 모두 공식 스코어러로 평가했지만, 결과는 공식 리더보드 제출 결과는 아니다.
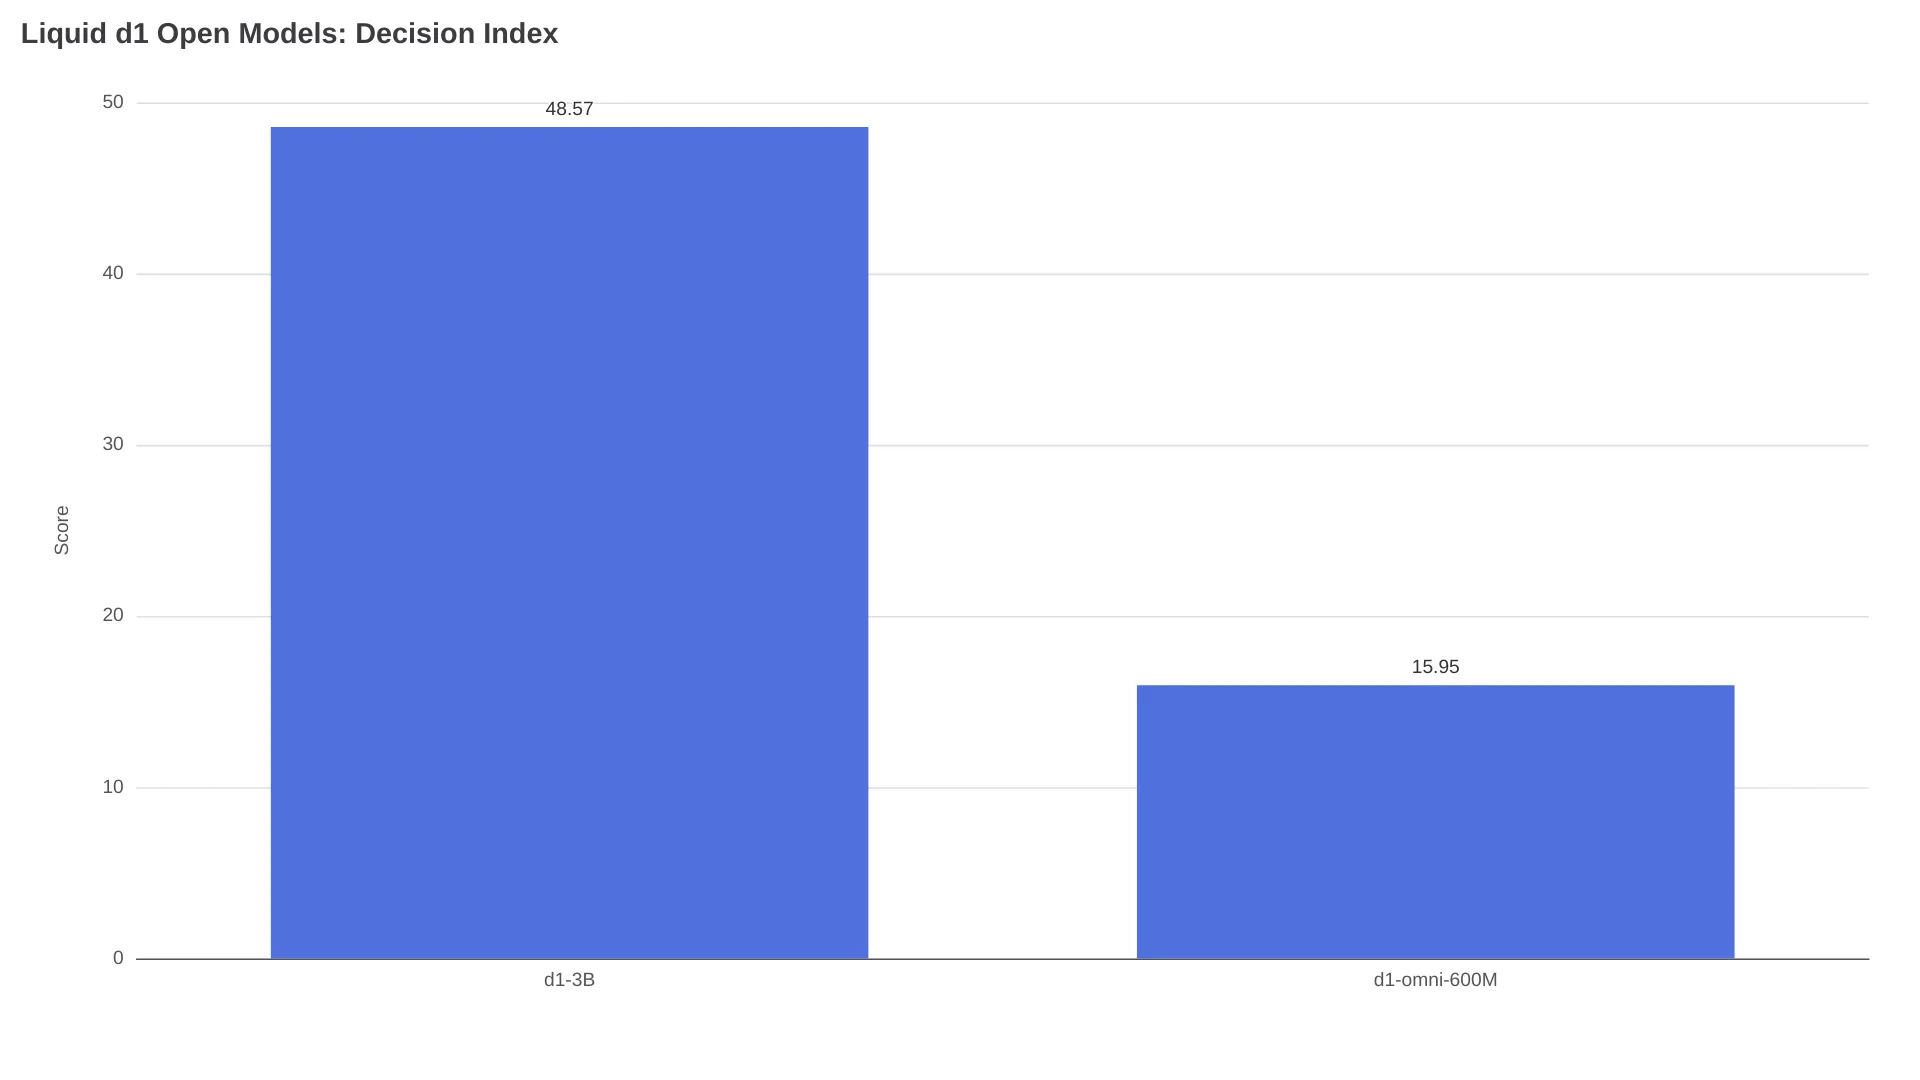
작은 모델이 모든 영역에서 낮은 성능을 보이는 것은 아니다. Liquid AI가 공개한 7개 텍스트 벤치마크 평균은 d1-3B가 82.9, d1-omni-600M이 78.4다. Omni는 Civil Comments에서 95.8 대 93.0, PAWS-X에서 79.5 대 76.9로 앞섰고, 나머지 5개 과제에서는 3B가 우세했다. 하지만 Decision Index의 훨씬 큰 격차는 일부 분류 과제에서의 강점만으로 600M 체크포인트를 3B의 범용 대체재로 볼 수 없음을 보여준다.
| 사양 | d1-3B | d1-omni-600M |
|---|---|---|
| 상세 파라미터 수 | 3.12B | 587M |
| 풀 프리시전 저장소/웨이트 크기 | 저장소 6.27 GB, 웨이트 6.25 GB | F32 모델, 약 0.6B 파라미터 |
| 컨텍스트 | 32,768 | 모달리티 간 공유 16,384 |
| 이미지 사용 시 텍스트 허용량 | 모델 컨텍스트 내에서 사용 | 이미지 사용 시 상태 및 질문 텍스트가 896토큰으로 제한 |
| 오디오 | 미지원 | 16 kHz 모노 클립 1개, 최대 30초 |
| 이미지와 오디오 동시 입력 | 해당 없음 | 미지원, ValueError 발생 |
| 공식 속도 표 | 제공 | 미제공, 초기 연구 릴리스 |
d1-omni-600M 모델 카드에 따르면 이 모델은 float32로 학습됐다. Float16에서는 텍스트 243개, 이미지 214개, 오디오 416개 행에서 최상위 답변이 유지됐다. 반면 bfloat16은 텍스트 행의 0.8%, 오디오 행의 1.7%에서 최상위 답변이 달라졌다. dtype은 단순 최적화 옵션이 아니라 검증해야 할 변수다.
로컬 배포는 설치보다 검증 과정이 더 길다
두 모델 카드는 단일 상태용 system_one과 묶음 요청용 system_one_batch를 제공한다. 가장 짧은 d1-3B 실행 경로에는 Transformers 5.14 이상, PyTorch, TorchVision, Pillow, 그리고 저장소가 제공하는 커스텀 코드가 필요하다.
- 문서에 명시된 의존성을 설치한다.
pip install "transformers>=5.14" torch torchvision pillow- 원격 저장소 코드 실행을 허용해 모델을 불러온다.
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- 채팅 프롬프트가 아니라 이름이 있는 결정 요청을 보낸다.
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])trust_remote_code=True는 해당 저장소의 Python 코드가 서빙 프로세스에서 실행된다는 뜻이다. 프로덕션에서는 변동되는 브랜치를 그대로 불러오기보다 검토한 커밋을 고정해야 한다. d1-3B 저장소는 llama.cpp, Ollama, LM Studio 호환 런타임용 양자화 파일도 연결한다. 다만 커뮤니티 양자화 아티팩트는 공식 BF16 웨이트와 별개로 공급망과 정확도 측면에서 판단해야 할 대상이다.
d1-3B 모델 카드는 RTX 4090에서 질문 1개를 처리하는 웜 콜 시간이 8 ms, Apple M5 Pro에서 30 ms, Jetson Orin Nano에서 50 ms라고 제시한다. 3.4K토큰 상태는 같은 기기에서 각각 102 ms, 640 ms, 1,640 ms가 걸렸다. GPU 수치는 20회 실행의 중앙값이며, 4090의 8 ms 결과는 컴파일된 CUDA 그래프를 사용했다. 새 입력 형태에서는 컴파일 또는 커널 선택 오버헤드가 발생한다.
d1-omni-600M에는 공식 속도 표가 없다. 브라우저 포트에서는 네 가지 결정 기준으로 댓글 하나당 약 180 ms가 보고됐다.
“I didn't test it against other machines yet, just my MBP M4 Pro.” — u/FinancialAd1961 on Reddit
이 단일 기기 결과는 브라우저 실행 가능성을 보여줄 뿐이며, 브라우저·GPU·양자화·배치 크기 전반의 성능을 뜻하지는 않는다.
API는 간편하지만 모델 정체성은 별개로 봐야 한다
직접 호스팅 접근에서는 https://api.liquid.ai/decisions/v1/systemone 엔드포인트에 모델 d1을 사용한다. Vercel에서는 liquid/d1을 쓰며, 해당 페이지에는 66K 컨텍스트와 동일한 $0.04/M 입력 요금이 표시된다. Liquid의 10월 5일 발표에 따르면 당시 Vercel과 OpenRouter는 텍스트 전용이었고, Liquid의 직접 API는 이미지를 받을 수 있었다.
오픈 체크포인트는 동일한 결정 개념을 로컬 Python 메서드로 제공하지만, 인터페이스가 유사하다고 행동까지 같다는 뜻은 아니다. 확률 차이만으로도 자동화 임계값의 경계를 넘길 수 있다. 평가한 모든 분기에서 정확한 모델 ID, 리비전, dtype, 확률, 임계값을 기록해야 한다.
따라서 마이그레이션은 다음 네 단계로 진행하는 것이 좋다.
- 모호한 사례와 비용이 큰 오류를 포함해, 실제 프로덕션 분포에서 라벨된 데이터셋을 만든다.
- 각 후보 모델에 동일한 상태, 질문 스키마, 기준을 적용한다.
- 전체 벤치마크 점수가 아니라 거짓 양성과 거짓 음성의 비용을 기준으로 임계값을 정한다.
- 파괴적 작업, 금융 작업, 접근 제어 또는 안전 관련 작업을 허용하기 전에 우승 모델을 섀도우 모드로 검증한다.
어떤 Liquid d1을 선택해야 할까?
대부분의 팀에는 호스팅 API가 기본 추천이다. 소규모 파일럿에서 로컬 서빙 프로젝트를 정당화하기에는 토큰 가격이 너무 낮고, 드라이버·양자화·워밍업·용량 관리 작업도 피할 수 있다.
| 요구 사항 | 추천 | 이유 |
|---|---|---|
| 가장 빠른 프로덕션 도입 | 호스팅 d1 | 관리형 엔드포인트와 명확한 입력 요금 |
| 데이터가 디바이스 또는 네트워크 밖으로 나가면 안 됨 | d1-3B | 가장 강력한 오픈 체크포인트와 로컬 실행 |
| 공개된 오픈 모델 중 최고 의사결정 품질 | d1-3B | Decision Index 48.57, omni는 15.95 |
| 음성 명령 분류 | d1-omni-600M | 여기서 오디오를 지원하는 유일한 옵션이며 최대 30초 |
| 가장 작은 실험용 풋프린트 | d1-omni-600M | 587M 파라미터, 단 공식 지연 시간 표는 없음 |
| 자유 형식 설명 또는 생성형 액션 | 해당 없음 | 결정 단계 뒤에 생성형 모델을 추가해야 함 |
600M 풋프린트나 오디오 경로가 반드시 필요한 경우가 아니라면 omni보다 d1-3B를 선택하자. 파라미터를 5분의 1로 줄이는 매력은 있지만, 32.62점의 Decision Index 격차와 omni의 실험적 상태를 없애지는 못한다.
Liquid AI d1 FAQ
Liquid AI d1은 무료인가?
호스팅 d1 서비스는 입력 토큰 100만 개당 $0.04이며 출력 토큰 요금은 없다. 오픈 체크포인트는 토큰당 요금 없이 다운로드할 수 있지만, LFM 1.0 상업 조건과 로컬 컴퓨팅 비용은 여전히 적용된다.
d1-3B와 d1-omni-600M은 호스팅 d1 API 모델인가?
Liquid AI는 두 체크포인트 중 어느 것도 호스팅 d1과 동일하다고 문서화하지 않았다. 모델 ID, 컨텍스트, 벤치마크, 배포 경로가 서로 다른 관련 제품으로 다뤄야 한다.
Liquid d1을 Ollama에서 실행할 수 있나?
d1-3B 모델 페이지는 llama.cpp, Ollama, LM Studio 및 호환 애플리케이션용 양자화 파일을 연결한다. 공식 Transformers 경로를 대체하기 전에는 양자화 주체, 소스 리비전, 결정 API 지원 여부, 정확도를 확인해야 한다.
d1-3B는 오디오를 지원하나?
아니다. d1-3B는 텍스트, JSON, 이미지를 받는다. d1-omni-600M은 텍스트와 이미지 또는 텍스트와 최대 30초 오디오 클립 1개를 받을 수 있지만, 이미지와 오디오를 한 요청에 함께 넣을 수는 없다.
로컬 d1 실행에는 VRAM이 얼마나 필요한가?
Liquid는 d1-3B용 6.25 GB BF16 웨이트 파일을 공개했지만, 단일한 범용 VRAM 요구량은 제시하지 않는다. 런타임 오버헤드, 이미지 인코더 상태, 컨텍스트 길이, 배치 크기, 정밀도, 양자화에 따라 총량이 달라진다. 파일 크기를 최대 VRAM 사용량과 동일시하지 말고, 실제 사용할 구성에서 측정해야 한다.
어떤 경로를 택하든 중요한 결정을 자동화하기 전에 라벨된 프로덕션 데이터로 확률 임계값을 검증해야 한다.
관련 글: 호스팅 Liquid AI d1 API 리뷰에서는 직접 엔드포인트, 이미지 과금, 타입이 지정된 요청 계약을 더 자세히 다룬다.