 AIREITER
GLM-5.3-Flash의 입력 토큰 100만 개당 $0.15라는 가격만 보고 도입 여부를 판단하기는 이르다. 캐시 적중률, 출력 토큰 비중, 강제 적용되는 추론, 약 320B 파라미터 규모의 체크포인트까지 함께 따져야 API와 오픈 웨이트 중 실제 배포 환경에 맞는 선택지를 고를 수 있다.
현재 적용 중인 GLM-5.3-Flash 요금
Z.AI 공식 가격 페이지에 따르면 GLM-5.3-Flash는 신규 입력 토큰 100만 개당 $0.15, 캐시된 입력 토큰 100만 개당 $0.03, 출력 토큰 100만 개당 $0.50이다. UTC+8(싱가포르 시간) 기준 2026년 9월 9일 24:00까지는 한시적으로 50% 할인도 적용된다.
| GLM-5.3-Flash 과금 항목 | 정가 / 100만 토큰 | 프로모션가 / 100만 토큰 |
|---|---|---|
| 신규 입력 | $0.15 | $0.075 |
| 캐시된 입력 | $0.03 | $0.015 |
| 출력 | $0.50 | $0.25 |
| 캐시 입력 저장 | 한시적 무료 | 한시적 무료 |
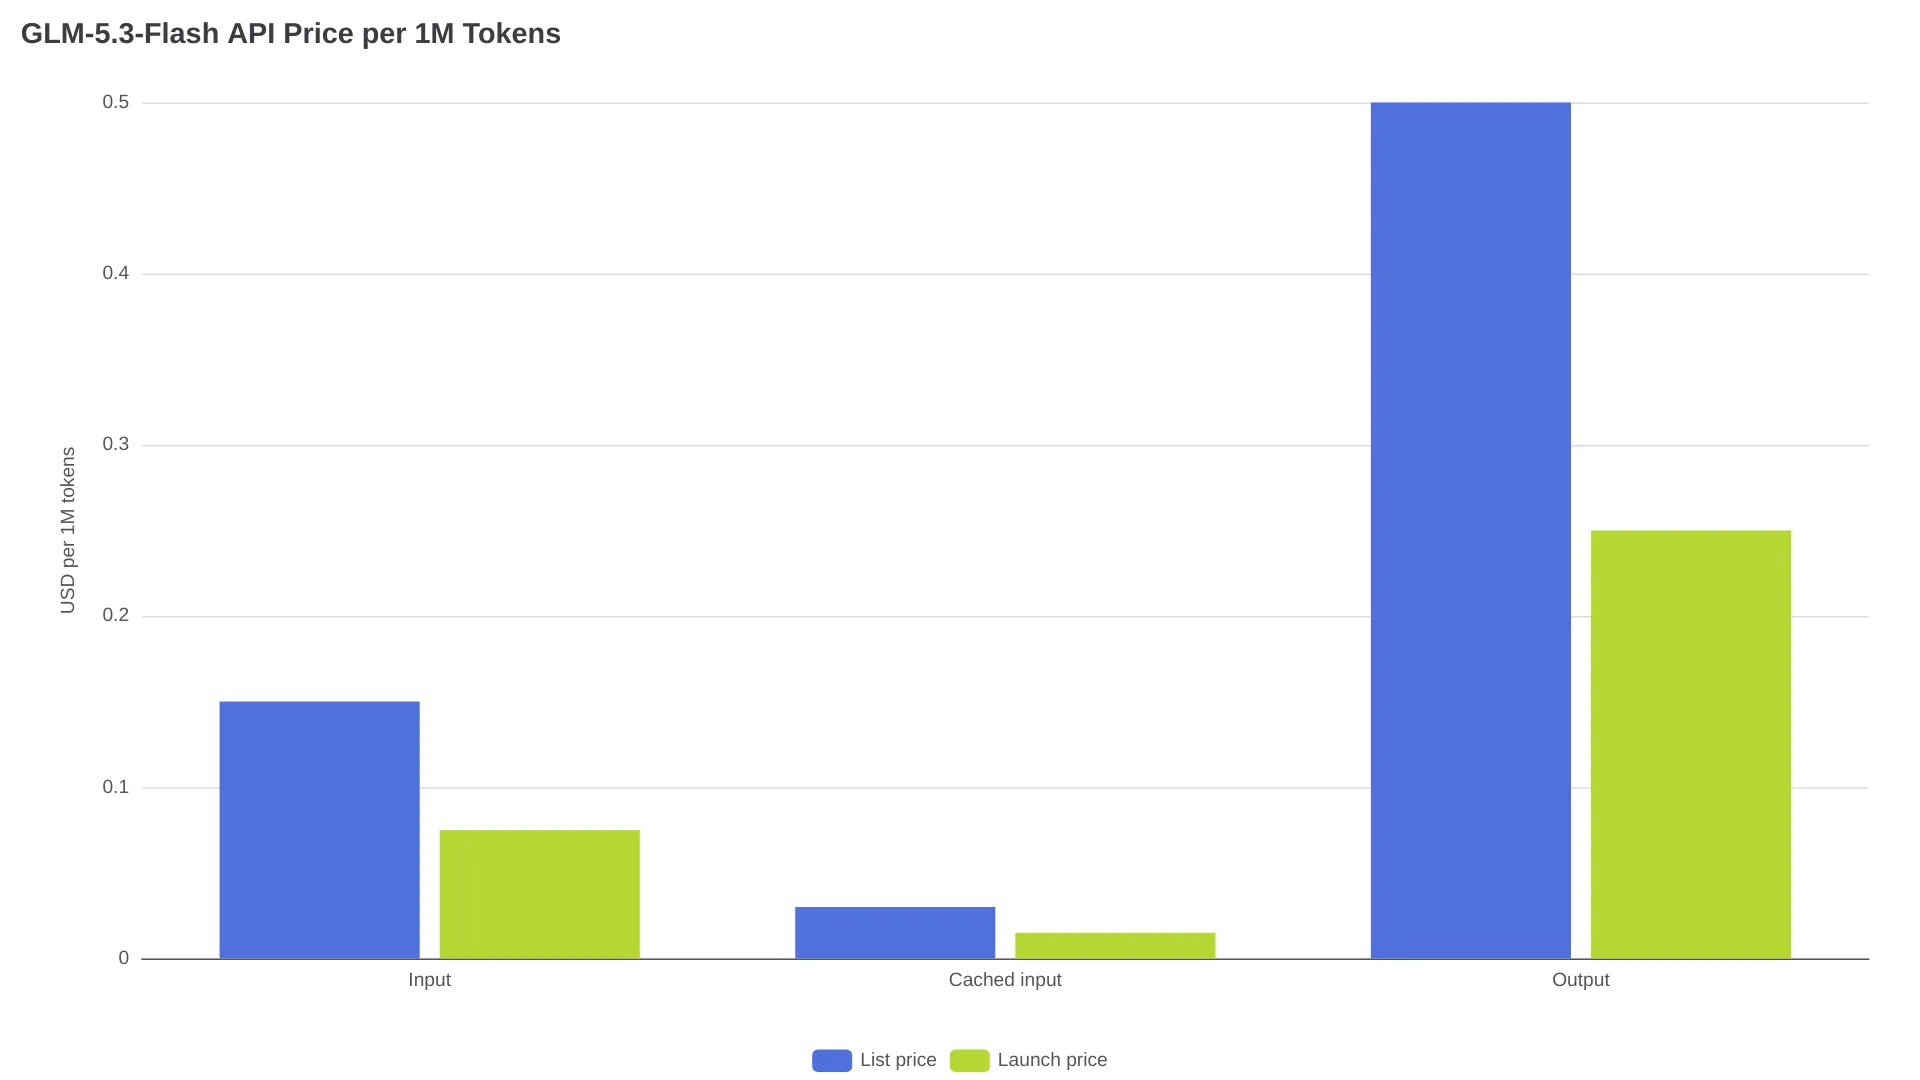
50% 인하는 운영 예산의 기준값이 아니라 기간 한정 프로모션으로 봐야 한다. Z.AI의 출시 발표에서는 ox-alpha를 이전 프리뷰 식별자로 안내한다.
같은 공식 표에서 일반 GLM-5.3의 요금은 입력 $1.40, 캐시 입력 $0.26, 출력 $4.40으로 제시된다. 정가 기준으로 Flash는 입력과 출력 모두 약 89% 저렴하다. 다만 이는 가격 차이일 뿐, 두 모델의 품질·지연 시간·운영 특성이 동일하다는 뜻은 아니다.
구매하는 것은 경량 로컬 모델이 아니라 API 접근권
GLM-5.3-Flash는 총 320B 파라미터와 토큰당 18B 활성 파라미터를 갖춘 MIT 라이선스 오픈 웨이트 멀티모달 모델이다. 공식 Hugging Face 모델 카드에는 공개 체크포인트 zai-org/GLM-5.3-Flash와 로컬 서빙 경로가 문서화돼 있다. Z.AI는 출시 자료에서 100만 토큰 컨텍스트 윈도우와 텍스트·이미지·비디오 입력을 설명한다.
여기서 ‘18B 활성’은 선택된 전문가가 수행하는 연산량을 뜻할 뿐, 전체 메모리 사용량을 의미하지 않는다. 실제 로컬 구동 가능 여부는 전체 가중치, KV 캐시, 런타임 오버헤드, 멀티모달 처리, 컨텍스트 길이에 따라 달라진다.
| 접근 방식 | 제공 내용 | 주요 제약 |
|---|---|---|
| Z.AI API | 입력·캐시 입력·출력 토큰 기준으로 과금되는 호스팅 추론 | 계정 한도와 추론 지연 시간 |
| 공식 체크포인트 | 셀프 호스팅 또는 커스터마이징을 위한 MIT 라이선스 가중치 | 정밀도와 양자화 방식에 따라 대용량 메모리 인프라 필요 |
| 커뮤니티 양자화 빌드 | 일부 로컬 런타임용으로 용량을 줄인 파일 | 빌드 품질, 모달리티 지원, 속도, 호환성이 제각각 |
낮은 토큰 단가와 낮은 호스팅 비용은 서로 다른 주장이다. 트래픽이 간헐적이면 API는 요청이 발생할 때만 비용을 내지만, 셀프 호스팅은 유휴 시간에도 서빙 용량을 확보해 둬야 한다.
실제 워크로드에서의 API 과금 방식
GLM-5.3-Flash 비용은 신규 입력, 캐시로 인식된 입력, 생성 출력의 구성에 따라 달라진다.
cost = (new_input_tokens / 1,000,000 × input_rate)
     + (cached_input_tokens / 1,000,000 × cached_rate)
     + (output_tokens / 1,000,000 × output_rate)
정가 기준 신규 입력 1,000만 토큰과 출력 200만 토큰을 사용하면 총비용은 $2.50이다. 입력 $1.50, 출력 $1.00으로 계산된다. 프로모션 기간에는 같은 사용량이 $1.25다.
| 워크로드 | 정가 계산식 | 정가 합계 | 프로모션 합계 |
|---|---|---|---|
| 신규 입력 10M + 출력 2M | $1.50 + $1.00 | $2.50 | $1.25 |
| 신규 입력 2M + 캐시 입력 8M + 출력 2M | $0.30 + $0.24 + $1.00 | $1.54 | $0.77 |
| 신규 입력 100K + 출력 10K | $0.015 + $0.005 | $0.020 | $0.010 |
Artificial Analysis가 제시하는 100만 토큰당 $0.10의 혼합 비용은 캐시 적중·입력·출력 비율을 7:2:1로 정해 계산한 값이다. 워크로드 비교에는 유용하지만, 모든 GLM-5.3-Flash 사용 사례에 적용되는 단일 요금은 아니다.
캐시 절감은 실제로 캐시가 적중해야만 발생한다. Z.AI의 Chat Completion 응답 스키마는 usage.prompt_tokens_details.cached_tokens를 제공하므로, 운영 비용 집계에서는 반복돼 보이는 프롬프트가 할인될 것이라고 가정하지 말고 이 필드를 기록해야 한다. r/opencodeCLI의 한 사용자는 출시 직후의 가격 경쟁력을 다음과 같이 표현했다.
“9월 9일까지 50% 할인 중이고, 컨텍스트 소비량은 dsv4f보다 훨씬 낫다...” — u/CriteriumA, Reddit 토론
할인 종료일은 Z.AI 요금표로 확인되지만, 비교와 사용 경험은 해당 댓글 작성자의 의견이다. 안정적으로 반복되는 컨텍스트는 캐시 재사용률을 높일 수 있어도 출력, 재시도, 도구 사용, 계정 한도 비용까지 없애주지는 않는다.
간단한 예산 산정표
예산은 신규 입력, 캐시 입력, 출력, 유료 도구의 네 항목으로 나눠 예측하는 편이 좋다. Z.AI는 Web Search를 사용당 $0.01로 책정하므로, 에이전트가 검색을 반복하면 토큰만으로 계산한 예상치를 넘어설 수 있다.
| 월간 사용 가정 | 정가 계산식 | 월 비용 |
|---|---|---|
| 신규 입력 100M + 출력 20M | 100 × $0.15 + 20 × $0.50 | $25.00 |
| 신규 입력 20M + 캐시 입력 80M + 출력 20M | 20 × $0.15 + 80 × $0.03 + 20 × $0.50 | $23.40 |
| Web Search 100회 호출 | 100 × $0.01 | $1.00 |
이는 단순 산술 예시일 뿐 쿼터가 아니다. 재시도와 중간에 종료된 에이전트 실행 비용은 따로 더해야 한다. 출력량이 많다면 작은 프롬프트 접두어를 최적화하는 것보다 현실적인 max_tokens 값을 지정하고, 적합한 경우 reasoning_effort를 낮추는 편이 더 큰 영향을 줄 수 있다.
마이그레이션 전 확인할 Z.AI API 제약
공식 Z.AI API의 일반 베이스 URL은 https://api.z.ai/api/paas/v4/이며, 채팅 완료 엔드포인트는 https://api.z.ai/api/paas/v4/chat/completions다. 인증에는 Bearer API 키를 사용한다. Z.AI는 API 소개 문서에서 커스텀 베이스 URL을 활용한 OpenAI 호환 Python, Node.js, Java 클라이언트 패턴을 안내한다.
현재 Chat Completion 레퍼런스의 thinking 및 reasoning 설명에는 GLM-5.3-FLASH가 언급되지만, 렌더링된 모델 enum에는 glm-5.3-flash가 표시되지 않는다. 반면 공식 가격 페이지와 출시 자료에는 Flash SKU가 올라와 있다. 운영 트래픽을 전환하기 전, 작은 요청으로 정확한 호스팅 모델 ID를 먼저 테스트해야 한다.
| 연동 항목 | 확인된 제약 사항 |
|---|---|
| 테스트할 호스팅 모델 ID | glm-5.3-flash; 실제 계정 스키마에서 수락되는지 확인 필요 |
| 호스팅 엔드포인트 | https://api.z.ai/api/paas/v4/chat/completions |
| 인증 | Authorization: Bearer YOUR_API_KEY |
| Thinking | GLM-5.3-FLASH는 thinking이 활성화되며, 깊이는 reasoning_effort로 제어 |
| 추론 강도 | low, high, max |
최대 max_tokens | 현재 파라미터 레퍼런스 기준 131,072 |
| Coding Plan | 별도 키, 엔드포인트, 크레딧 체계를 사용하며 일반 API 잔액이 아니다. Z.AI의 Coding Plan 빠른 시작 가이드 참고 |
Z.AI는 max를 기본 reasoning effort로 설정한다. 추론 강도에 따라 토큰 단가가 바뀌지는 않지만, 출력 사용량과 대기 시간에는 영향이 있을 수 있다. 계정 한도는 Z.AI가 계정별 레이트 리밋 대시보드에서 확인하도록 안내하며, 모든 API 계정에 적용되는 단일 수치의 상한은 공개 가이드에 제시하지 않는다.
오픈 웨이트와 호스팅 API, 어떻게 고를까
공식 모델 카드는 Transformers, vLLM, SGLang, TokenSpeed, KTransformers용 로컬 서빙 레시피를 제공한다. 하지만 이 레시피만으로 일반 소비자용 GPU에서 실용적으로 배포할 수 있다는 결론을 낼 수는 없다.
트래픽이 간헐적이거나 대용량 메모리 추론 하드웨어가 없다면 호스팅 API를 쓰는 편이 낫다. 반대로 사용률이 꾸준히 유지되거나 데이터 처리 통제의 가치가 운영비를 정당화한다면 분산 또는 로컬 서빙을 검토할 수 있다. 저정밀 텍스트 빌드는 공식 멀티모달 구성을 그대로 재현하지 못할 수 있다.
셀프 호스팅이 경제성을 갖는 시점
GetDeploying의 추정치에 따르면 4비트 배포에는 GPU 메모리 약 192GB, 8비트에는 약 384GB, BF16에는 768GB가 필요하다. MI300X 구성은 시간당 $2.90, 계속 가동할 경우 월 약 $2,088으로 추산하며, 입력 대비 출력 비율이 5:1일 때 API와 셀프 호스팅의 손익분기점은 시간당 약 1,400만 토큰으로 제시한다.
이는 Z.AI의 하드웨어 보장이 아니라 제3자 추정이다. 4비트 192GB 구성은 여유가 적은 것으로 표시돼 있으며, KV 캐시, 런타임 오버헤드, 멀티모달 처리, 배치 처리, 유휴 시간에 따라 손익분기점은 달라질 수 있다. 로컬 추론을 선택하기 전에는 시간당 인프라 비용, 사용률, 시간당 실효 토큰 처리량, 캐시 적중률, 완료 작업당 비용을 함께 비교해야 한다.
GLM-5.3-Flash와 GLM-5.3의 선택 기준
Flash와 일반 GLM-5.3는 요금표와 배포 포지션이 다르다.
| 비교 항목 | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| 정가 입력 가격 | $0.15 / 1M | $1.40 / 1M |
| 정가 캐시 입력 | $0.03 / 1M | $0.26 / 1M |
| 정가 출력 가격 | $0.50 / 1M | $4.40 / 1M |
| 기간 한정 프로모션 | 2026년 9월 9일 UTC+8까지 50% 할인 | 동일한 Flash 프로모션은 표시되지 않음 |
| 오픈 웨이트 체크포인트 | 공식 MIT 체크포인트 등록 | 별도 모델 목록이므로 동일 가중치라고 추정하면 안 됨 |
| 멀티모달 포지셔닝 | 네이티브 멀티모달, Z.AI가 이미지·비디오 입력 설명 | 일반 GLM-5.3의 지원 범위는 별도로 확인 |
| 로컬 배포 | 대형 체크포인트와 대용량 메모리 서빙 필요 | 해당 모델의 자체 문서와 배포 가이드 사용 |
토큰 비용, 멀티모달 입력, 오픈 웨이트 경로가 중요하고 애플리케이션이 강제 추론 및 공급자 제약을 수용할 수 있다면 우선 Flash를 선택하는 편이 좋다. 일반 GLM-5.3는 더 높은 요금이 해당 애플리케이션에 중요한 기능 또는 신뢰성 차이로 이어지는지 측정한 뒤 선택해야 한다.
FAQ
현재 GLM-5.3-Flash API 가격은 얼마인가요?
공식 정가 기준 입력은 100만 토큰당 $0.15, 캐시 입력은 $0.03, 출력은 $0.50이다. 위 요금표에는 기간 한정 50% 할인 가격도 함께 정리했다.
캐시 입력에는 $0.03 요금이 적용되나요?
그렇다. Z.AI가 해당 토큰을 캐시된 입력으로 인식했을 때 적용된다. 캐시 입력 저장은 별도로 한시적 무료로 표시돼 있으므로, 저장 상태와 캐시 적중 과금을 같은 개념으로 묶으면 안 된다.
GLM-5.3-Flash는 오픈소스인가요?
정확히는 MIT 라이선스의 오픈 웨이트 체크포인트다. 라이선스는 폭넓은 사용을 허용하지만, 총 320B 파라미터 모델인 만큼 상당한 메모리, 호환 소프트웨어, 서빙 용량은 여전히 필요하다.
일반 노트북에서 GLM-5.3-Flash를 실행할 수 있나요?
실용적인 풀 정밀도 배포는 어렵다. 제3자 추정에서도 4비트 기준 GPU 메모리 약 192GB가 필요하며, 활성 파라미터가 18B라는 사실이 전체 체크포인트의 저장 및 런타임 비용을 없애주지는 않는다.
GLM-5.3-Flash가 GLM-5.3보다 빠른가요?
‘Flash’라는 이름은 비용과 활성 연산 측면의 포지션을 뒷받침할 뿐, 모든 상황에서의 지연 시간 보장을 뜻하지는 않는다. Artificial Analysis는 측정 환경에서 Z.AI 경유 출력 속도를 초당 48.7토큰, 첫 응답 토큰까지의 시간을 42.57초로 보고했다. 체감 응답 시간은 추론 시간과 워크로드 형태가 좌우할 수 있다.
Coding Plan도 같은 API 잔액을 제공하나요?
아니다. Z.AI의 Coding Plan 빠른 시작 가이드는 별도의 Coding Plan 키와 엔드포인트, 공식 지원 도구 및 제품으로 제한된 접근 방식을 문서화한다. Coding Plan 구독을 공개 API의 토큰당 달러 예산으로 직접 환산해서는 안 된다.
트래픽이 간헐적이고 이미 비용을 지불한 하드웨어가 없다면 API가 위험이 적은 경로다. 로컬 서빙은 지속적인 사용률, 메모리, 데이터 통제 요구 사항에 따라 경제성이 달라지는 별개의 선택이다.