 AIREITER
녹음 파일을 바로 쓸 수 있는 텍스트로 바꾸거나, 마이크 입력을 받아 실시간 자막을 만들고 싶다면 Gemini 3.5 Transcribe를 검토해볼 만합니다. 잡음과 말버릇을 다듬는 기능, 사용자 어휘 지정, 다국어 처리에서 장점이 있지만 파일 전사와 실시간 전사는 사용 한도가 크게 다릅니다. 보관용 녹취록에는 파일 API가, 짧고 지연 시간이 중요한 세션에는 Live API가 더 잘 맞습니다.
결론부터 말하면: 실시간 자막이 아니라면 파일 API를 고르자
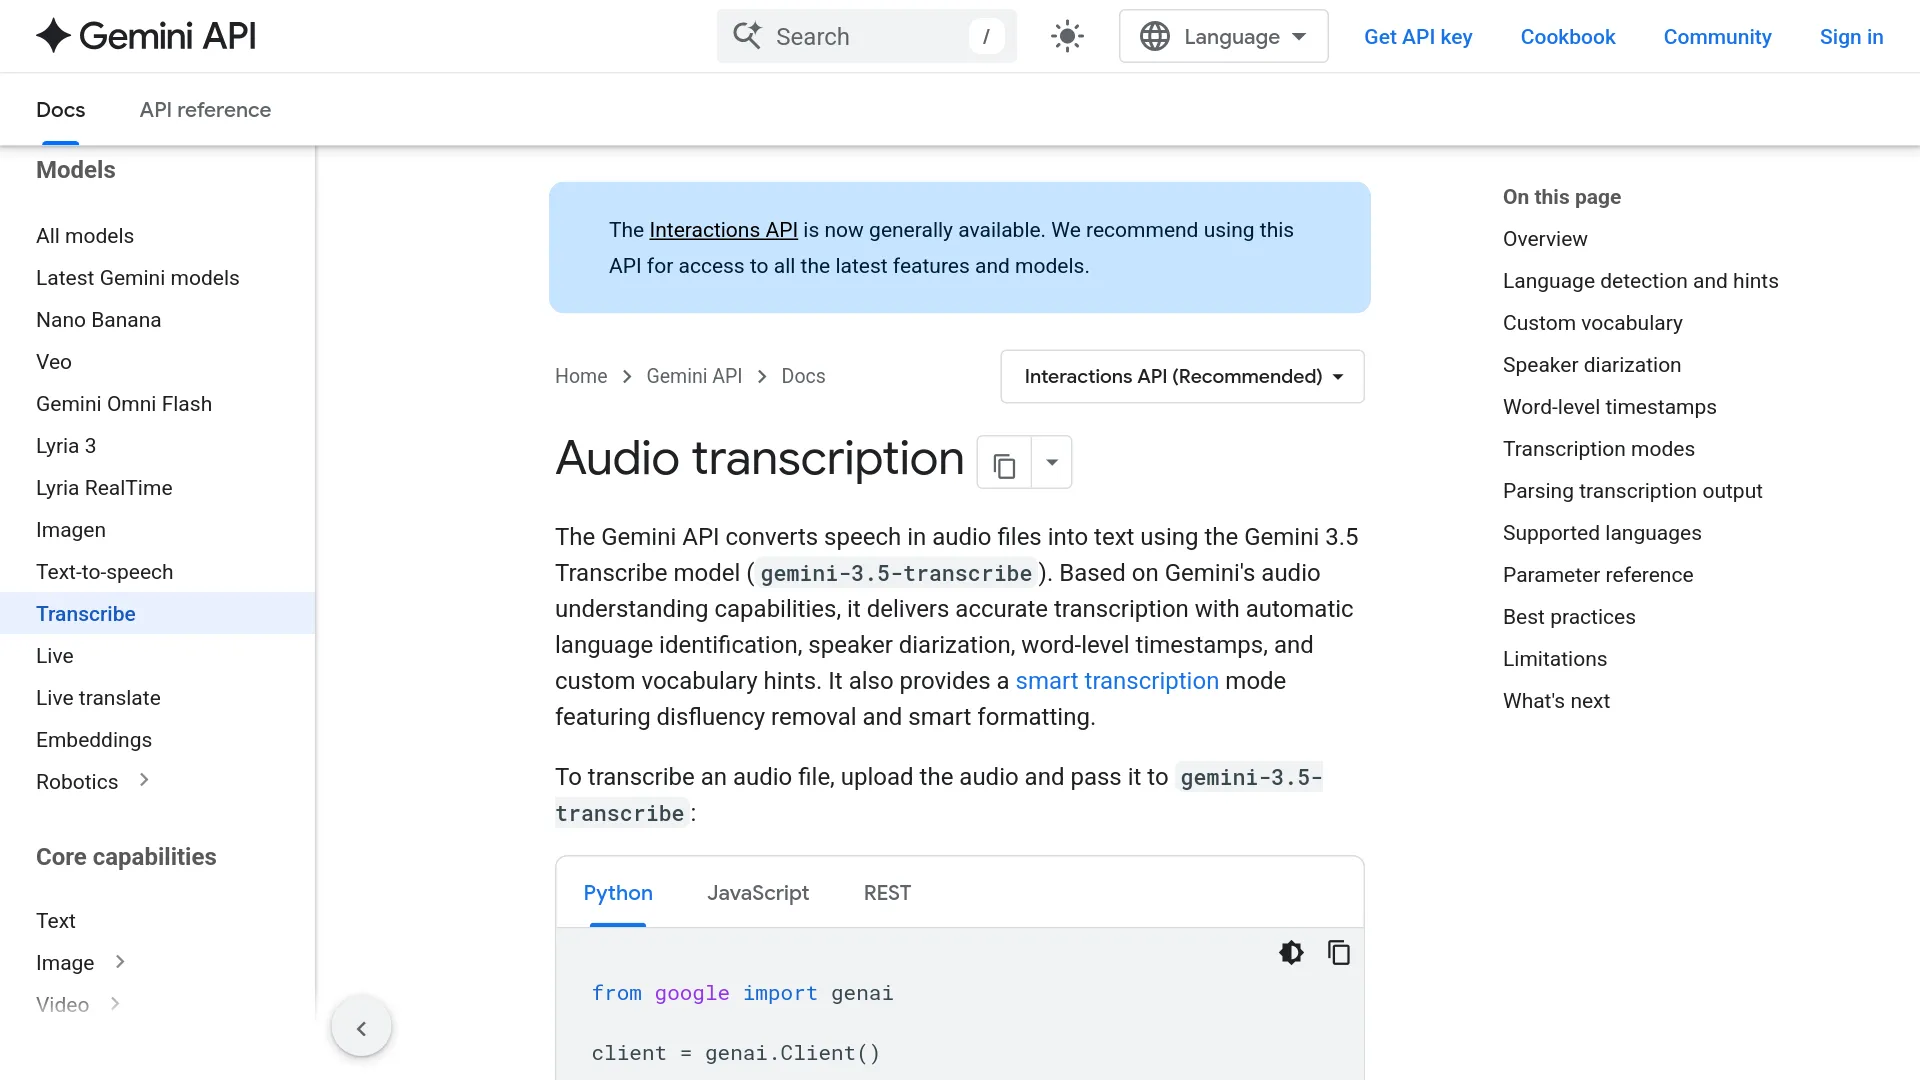
Gemini 3.5 Transcribe는 Google의 전용 음성-텍스트 변환 모델 제품군입니다. 2026년 8월 26일 기준 퍼블릭 프리뷰로 제공되고 있으며, Google은 녹음 파일 처리와 실시간 오디오 처리에 대해 서로 다른 모델 ID, 전송 방식, 출력 이벤트와 제약 조건을 안내하고 있습니다.
| 필요한 작업 | 모델 ID | API 경로 | 주요 제약 |
|---|---|---|---|
| 회의, 통화, 업로드한 녹음 파일 | gemini-3.5-transcribe | Interactions API | 일반 단일 요청은 최대 1시간, 화자 분리 또는 단어 단위 타임스탬프 사용 시 30분 |
| 실시간 자막, 마이크 입력, 음성 UI | gemini-3.5-transcribe-live | Live API | 연속 세션 10분, 실시간 화자 분리 및 단어 단위 타임스탬프 미지원 |
회의 아카이브, 통화 분석, 자막 제작이 목적이라면 gemini-3.5-transcribe부터 시작하는 편이 좋습니다. 반대로 자막 미리보기나 푸시 투 토크 인터페이스를 만들려면 gemini-3.5-transcribe-live를 사용하세요. Google의 녹음 오디오 전사 가이드와 Live API 가이드는 두 워크플로를 별도로 설명합니다.
아직은 프리뷰로만 제공된다
Google은 2026년 8월 26일 Gemini 3.5 Transcribe를 발표했으며, 개발자 API는 Google AI Studio와 Google Antigravity에서 퍼블릭 프리뷰로 제공된다고 안내하고 있습니다. 기업용 접근은 Gemini Enterprise Agent Platform을 통한 프리뷰로도 제공됩니다. 아직 정식 출시 단계가 아니므로 지역별 지원 범위, 쿼터, 안정성이 일반 제공 음성 서비스와 다를 수 있습니다. 중요한 물량을 투입하기 전에 실제 사용 환경을 대표하는 오디오로 먼저 검증하는 것이 안전합니다.
Gemini 3.5 Transcribe 가격을 실제 단위로 계산하기
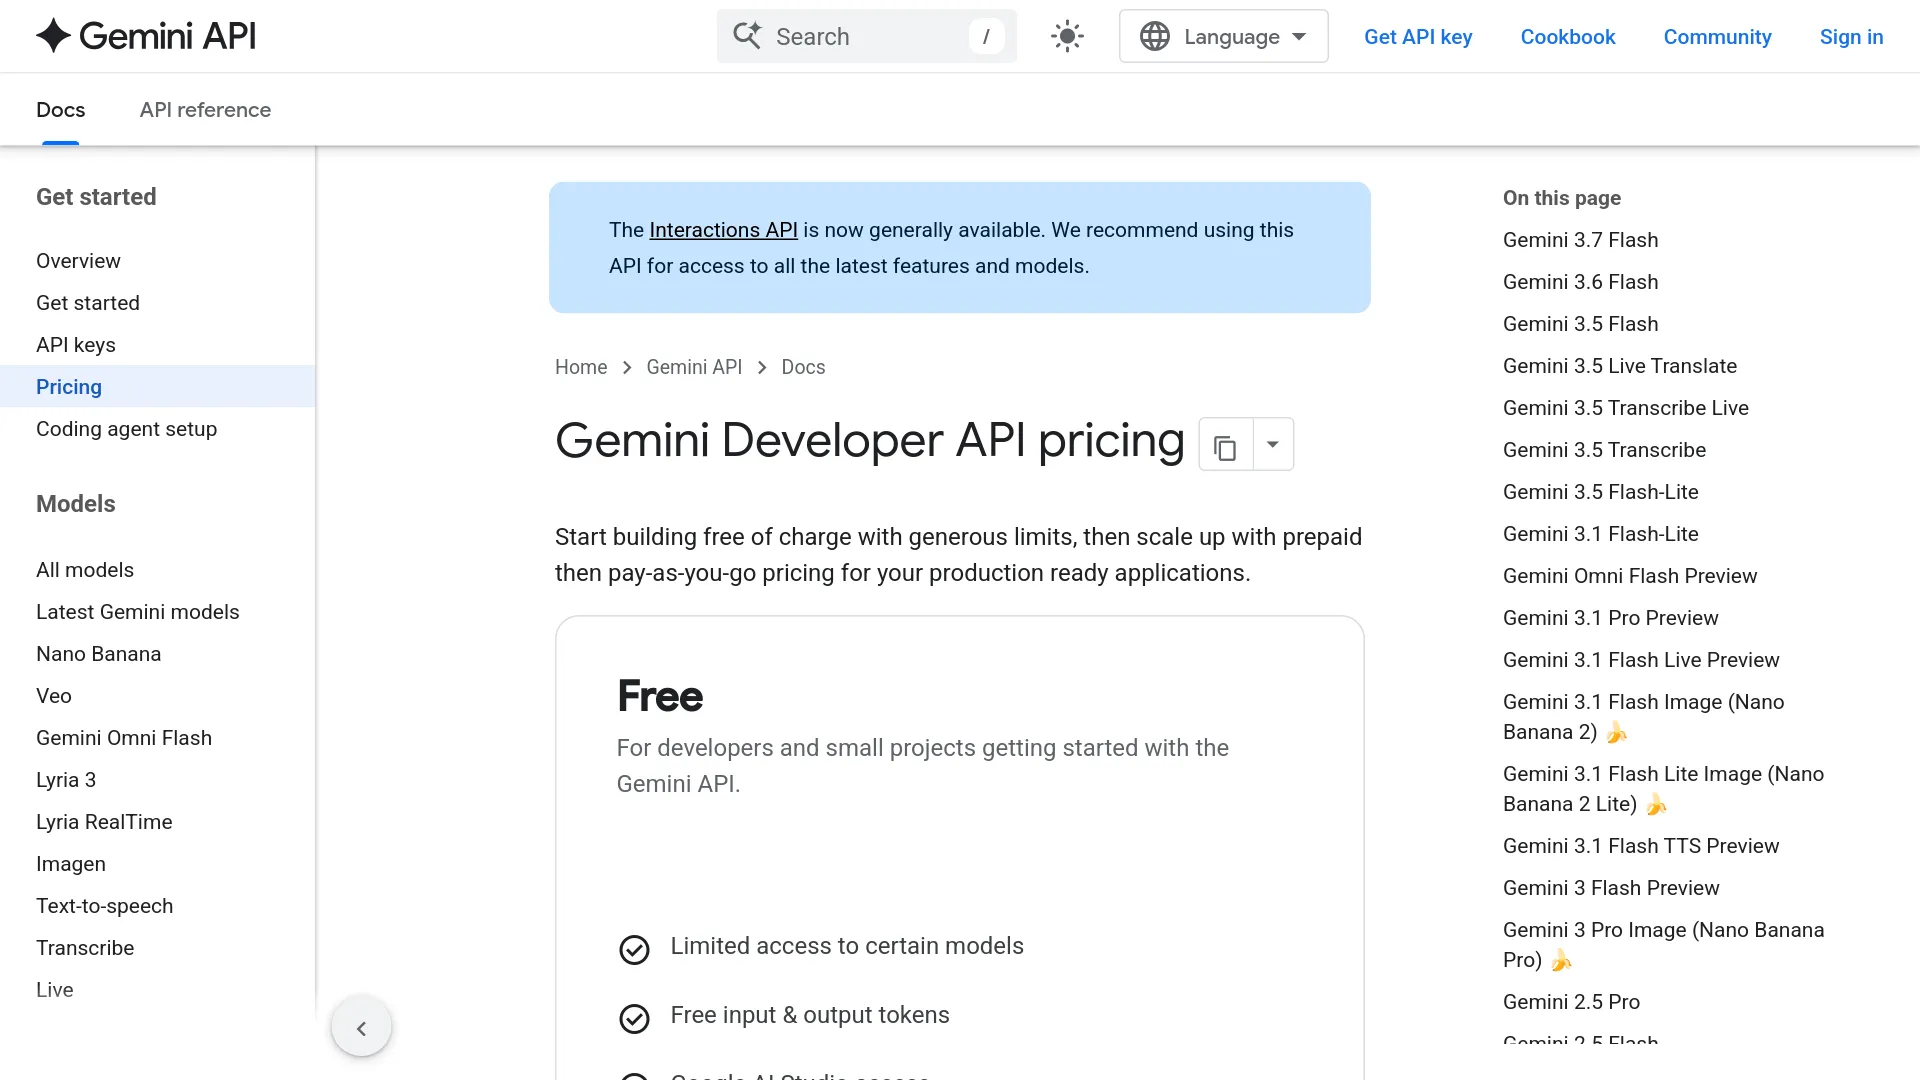
Google의 Gemini API 가격 페이지는 고정된 전사 요금이 아니라 토큰 기반 요금을 안내합니다. 현재 가격 기준으로 gemini-3.5-transcribe는 오디오 입력 토큰 100만 개당 $2, 텍스트 출력 토큰 100만 개당 $12입니다.
Google의 오디오 문서에 따르면 오디오는 초당 32토큰, 즉 분당 오디오 토큰 1,920개로 계산됩니다. 따라서 텍스트 출력 및 기타 과금 토큰을 제외하면 오디오 입력 비용은 토큰 100만 개당 $2 기준으로 분당 약 $0.00384입니다.
| 모델 | 공개된 가격 기준 | 참고용 혼합 추정치 | 참고용 1시간 추정치 |
|---|---|---|---|
gemini-3.5-transcribe | 오디오 입력 토큰 100만 개당 $2 + 텍스트 출력 토큰 100만 개당 $12 | 분당 약 $0.005 | 시간당 약 $0.30 |
gemini-3.5-transcribe-live | 실시간 오디오 및 텍스트 처리에 대한 토큰 기반 과금 | 분당 약 $0.009 | 시간당 약 $0.54 |
혼합 추정치는 전사 결과의 분량에 따라 달라지므로, 분당 고정 요금이 아니라 예산을 잡기 위한 참고값으로 봐야 합니다. 출력이 길거나 컨텍스트를 반복해서 전달하거나 추가 지시를 많이 넣으면 실제 청구액이 달라질 수 있습니다. 프리뷰 단계의 가격은 변경될 수 있으므로 대규모 사용을 시작하기 전에 최신 가격표를 확인하세요.
실무에서 중요한 기능별 차이
말한 그대로 옮길까, 읽기 좋게 다듬을까
VERBATIM은 Google의 전사 문서에서 기본 모드로 지정되어 있습니다. 추임새, 반복, 멈춤, 말더듬, 말하다가 고쳐 말한 표현까지 원문에 가깝게 보존합니다. 녹취록 자체가 기록이나 증거가 되거나, 자막 원본 또는 품질 관리 입력으로 사용될 때 적합합니다.
SMART는 가독성을 높이는 정리 모드입니다. 말버릇과 불필요한 반복을 제거하고, 자기 정정을 반영하며, 구두점과 문단 구조를 추가합니다. 날짜, 통화, 숫자, 목록, 문단도 보기 좋은 형태로 정리할 수 있습니다. 예를 들어 “Tuesday—no, Wednesday”라는 발화가 정리된 결과에서는 “Wednesday”가 될 수 있습니다.
Smart 모드는 화자 분리나 단어 단위 타임스탬프와 함께 사용할 수 없습니다. 읽기 좋은 회의록과 감사 추적성을 모두 확보해야 한다면 먼저 verbatim 결과를 받아 원본으로 보관하고, 별도의 사본을 정리하는 방식이 좋습니다.
사용자 어휘와 언어 전환 처리
Google은 코드 스위칭을 포함해 85개 이상의 로케일에서 자동 언어 감지를 지원한다고 설명합니다. 언어를 알고 있다면 en-US나 es-ES 같은 BCP-47 코드를 전달해 인식 방향을 지정할 수 있습니다.
사용자 어휘에는 최대 1,000개 용어를 등록할 수 있지만, Google의 실무 가이드는 보통 100개 이하일 때 결과가 가장 좋다고 안내합니다. 일반적인 단어를 무작정 나열하기보다는 고유한 제품명, 약어, 사람 이름, 의학 용어, 기술 용어를 등록하는 편이 효과적입니다.
화자 라벨과 단어 단위 타임스탬프
녹음 파일 전사는 화자 정보와 단어별 타이밍을 함께 반환할 수 있습니다. API 문서에 명시된 최대 화자 수는 8명입니다. 다만 Google의 출시 게시물은 최대 3명까지의 화자 식별을 강조하고 있으며, 3명 이상 화자에 대한 식별 지원은 실험적 기능으로 표시합니다.
단어 타임스탬프는 verbatim 모드에서 활성화되며 각 단어의 시작 및 종료 오프셋을 제공합니다. Google은 타임스탬프를 사용하면 전체 전사 정확도가 낮아질 수 있다고 경고합니다. 화자 분리나 타임스탬프를 활성화하면 일반적인 오디오 길이 제한도 1시간에서 30분으로 줄어듭니다.
| 요구사항 | 지원 여부 | 주의사항 |
|---|---|---|
| 녹음 파일의 화자 라벨 | 지원 | 문서상 최대 8명, 3명 초과 화자 식별은 실험적 기능 |
| 녹음 파일의 단어 단위 타임스탬프 | 지원 | Verbatim 모드에서만 사용 가능하며 정확도가 낮아질 수 있음 |
| 실시간 전사의 화자 라벨 | 미지원 | 화자 식별이 중요하다면 녹음 파일 방식 사용 |
| 실시간 전사의 단어 단위 타임스탬프 | 미지원 | 실시간 출력은 점진적으로 전달되며 발화 단위로 처리됨 |
| 라벨 또는 타임스탬프와 Smart 모드 조합 | 미지원 | 이런 주석이 필요하면 Verbatim 선택 |
Gemini 3.5 Transcribe API로 녹음 파일 보내기
Google의 녹음 오디오 가이드는 세 단계로 구성됩니다. 먼저 파일을 업로드하고, 반환된 파일 URI를 Interactions API에 전달한 뒤, interaction.output_text에서 완료된 전사 결과를 읽는 방식입니다.
- Files API로 오디오를 업로드합니다. 몇 초보다 긴 녹음이나 여러 번 재사용할 파일에는 이 방식을 사용하세요.
audio/mp3같은 MIME 타입과 함께 반환된 파일 URI를 보관합니다.- Interactions API를 통해
gemini-3.5-transcribe에 URI를 전달합니다. - 텍스트 결과를 읽고, 필요한 경우
word_info주석을 확인해 화자 및 타이밍 데이터를 가져옵니다.
공식 SDK를 이용한 업로드 및 전사 흐름은 다음 예제처럼 간단하게 구성할 수 있습니다.
from google import genai

client = genai.Client()
file = client.files.upload(file="path/to/sample.mp3")

interaction = client.interactions.create(
    model="gemini-3.5-transcribe",
    input=[{
        "role": "user",
        "content": [{
            "type": "audio",
            "uri": file.uri,
            "mime_type": file.mime_type,
        }],
    }],
)

print(interaction.output_text)
Files API 업로드가 FILE_URI를 반환한 뒤에는 다음처럼 간단한 REST 요청을 보낼 수 있습니다.
curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.5-transcribe",
    "input": [{
      "role": "user",
      "content": [{
        "type": "audio",
        "uri": "FILE_URI",
        "mime_type": "audio/mp3"
      }]
    }]
  }'
정리된 전사 결과가 필요하다면 다음처럼 transcription configuration에 Smart 모드를 추가합니다.
{
  "generation_config": {
    "transcription_config": {
      "mode": { "type": "smart" },
      "language_codes": ["en-US"],
      "custom_vocabulary": ["Kubernetes", "BigQuery", "Acme Ledger"]
    }
  }
}
화자 라벨과 단어별 타이밍이 필요할 때는 대신 Verbatim 모드를 사용합니다.
{
  "generation_config": {
    "transcription_config": {
      "mode": {
        "type": "verbatim",
        "diarization_mode": "speaker",
        "timestamp_granularities": ["word"]
      }
    }
  }
}
Smart 설정에 화자 분리나 타임스탬프를 함께 넣으면 안 됩니다. 문서에 명시된 모드 규칙상 단순한 출력 형식의 문제가 아니라 설계 단계에서 선택해야 하는 조건입니다.
실시간 전사는 어떻게 동작하나
Live API는 gemini-3.5-transcribe-live를 사용해 양방향 스트리밍 연결을 엽니다. 클라이언트가 오디오를 계속 보내면 다음 두 종류의 텍스트 이벤트를 받습니다.
interim_input_transcription: 자막이나 UI 미리보기에 사용할 수 있는, 계속 갱신되는 저지연 가설 결과입니다.input_transcription: 전사 결과로 확정되어 애플리케이션 상태나 최종 녹취록에 반영할 텍스트입니다.
Google의 실시간 가이드는 원시 16비트 PCM, 16kHz, 모노, 리틀엔디언 오디오를 요구합니다. 청크는 약 100밀리초 단위로 보내고, 청크당 프레임 수는 약 1,024~2,048개를 권장합니다. 브라우저와 모바일 클라이언트에서는 일반 API 키를 노출하지 말고 제한된 임시 토큰을 사용해야 합니다. Google 예제에서는 1회용 토큰과 30분 만료 시간을 사용합니다.
실시간 엔드포인트는 자동 언어 감지, BCP-47 힌트, 사용자 어휘, VERBATIM 또는 SMART 출력을 지원합니다. 반면 실시간 화자 분리와 단어 단위 타임스탬프는 지원하지 않습니다. 연속 세션은 10분으로 제한되므로 더 긴 스트림을 처리하려면 애플리케이션에서 세션을 나누고 전사 결과를 이어 붙여야 합니다.
발화의 시작과 끝을 구분하는 방법은 Live API에서 세 가지를 제공합니다.
- 자동 VAD: 서버가 음성 시작과 종료를 감지합니다.
- 하이브리드 VAD: 클라이언트 감지기가 음성 종료를 알리고, 서버 감지는 보조 수단으로 남겨둡니다.
- 수동 VAD: 푸시 투 토크 인터페이스에서 음성 활동의 시작과 종료 이벤트를 직접 보냅니다.
초기 성능 자료로 확인할 수 있는 것과 없는 것
Google은 Artificial Analysis를 통해 스트리밍 4.0%, 비스트리밍 2.6%의 평균 WER을 제시합니다. 또한 출시 게시물에서 FLEURS 기준 스트리밍 WER 5.50%, 비스트리밍 WER 5.04%를 보고했으며, Chirp 3보다 최종 전사 결과가 나오는 시간이 70% 개선됐다고 설명합니다.
다만 이 수치는 Google이 직접 보고했거나 인용한 출시 자료이지, Gemini 3.5 Transcribe를 독립적으로 동일 조건에서 비교한 결과는 아닙니다. 공개된 koedesk STT 벤치마크는 Gemini 3.5 Flash와 다른 엔진을 측정했지만 Gemini 3.5 Transcribe를 직접 평가하지는 않았습니다.
초기 사용자들이 주로 확인하는 부분은 파일 및 실시간 처리 길이 제한, WER 측정에 사용한 참조 전사, 조용한 구간에서 전화번호나 주문 ID를 얼마나 안정적으로 인식하는지입니다. 평균 WER만 믿기보다는 실제 오디오를 사용해 이름, ID, 숫자, 화자 전환, 타이밍, 지연 시간을 따로 검증해야 합니다.
Gemini 3.5 Transcribe를 선택할 때와 기다려야 할 때
| 상황 | 적합성 | 권장 시작 구성 |
|---|---|---|
| 깔끔한 회의록이나 받아쓰기 | 높음 | File API, SMART, 알고 있다면 명시적인 언어 힌트 |
| 법률, 컴플라이언스, 보관용 기록 | 조건부 | File API, VERBATIM; 중요한 구간은 수동 검토 |
| 여러 화자가 참여한 녹음 통화 | 조건부 | File API, VERBATIM + 화자 분리; 세션을 30분 이내로 유지 |
| 단어 단위로 동기화된 자막 | 조건부 | File API, VERBATIM + 단어 타임스탬프; 타이밍과 정확도 검증 |
| 실시간 자막 | 짧은 세션에 적합 | Live API, 확정 이벤트만 최종 텍스트에 반영 |
| 장시간 실행되는 음성 에이전트 | 추가 엔지니어링 필요 | 10분 제한 전에 세션을 분할하고 재연결 처리 |
| 오프라인 또는 기밀 데이터의 로컬 처리 | 부적합 | 문서화된 방식은 Google 서비스로 오디오를 전송하므로 자체 호스팅 ASR 경로 검토 |
Gemini 3.5 Transcribe는 전사가 더 큰 작업 흐름의 첫 단계일 때 가장 잘 맞습니다. 음성을 정리하고, 기술 용어를 보존하고, 화자를 구분한 뒤 구조화된 텍스트를 다음 단계로 넘기는 방식입니다. 반대로 저렴한 단순 전사만 필요하거나 반드시 오프라인으로 처리해야 한다면 적합성이 떨어집니다.
Gemini 3.5 Transcribe API 자주 묻는 질문
Gemini 3.5 Transcribe는 무료인가요?
Google은 Gemini API 사용량에 대해 무료 티어를 제공한다고 안내하지만, 쿼터와 모델 제공 여부는 변경될 수 있습니다. 유료 사용은 토큰 기반으로 과금되며, 현재 가격 페이지에는 녹음 전사 모델이 분당 약 $0.005, 실시간 모델이 분당 약 $0.009라는 참고용 혼합 추정치가 표시되어 있습니다.
파일 모델과 실시간 모델은 어떻게 다른가요?
gemini-3.5-transcribe는 Interactions API를 통해 업로드한 녹음 파일을 처리하며 녹음 오디오의 화자 분리와 단어 타임스탬프를 지원합니다. gemini-3.5-transcribe-live는 Live API를 통해 원시 PCM 오디오를 스트리밍하고 중간 결과와 최종 이벤트를 반환합니다. 실시간 세션은 10분으로 제한되며 실시간 화자 분리와 단어 단위 타임스탬프는 지원하지 않습니다.
3시간짜리 녹음을 한 번의 요청으로 처리할 수 있나요?
전용 녹음 전사 구성으로는 처리할 수 없습니다. 일반 단일 요청의 제한은 1시간이며, 화자 분리나 단어 타임스탬프를 사용하면 30분으로 줄어듭니다. 더 긴 파일은 애플리케이션에서 나누고, 구간 사이의 컨텍스트와 화자 연속성을 직접 관리해야 합니다.
Gemini 3.5 Transcribe를 오프라인에서 사용할 수 있나요?
문서에 안내된 방식은 오디오를 Google 서비스로 업로드하거나 스트리밍하는 구조입니다. Google은 Gemini 3.5 Transcribe의 오프라인 또는 자체 호스팅 버전을 설명하지 않습니다.
가장 안전한 첫 통합 방법
깔끔하게 녹음된 데모 클립이 아니라 실제 업무에서 사용하는 오디오의 일부로 시작하세요. 같은 음성을 두 번 실행해 한 번은 정확한 보존을 위한 Verbatim 모드로, 다른 한 번은 읽기 편한 결과를 위한 Smart 모드로 처리해보는 것이 좋습니다. 고유명사, 숫자, 화자 전환, 타임스탬프 오차, 비용을 각각 따로 측정하세요.
원본 전사 결과는 기준 데이터로 보관하고, 사용자에게 보여줄 회의록에는 Smart 결과를 활용하세요. 업로드 실패나 프리뷰 모델 변경에 대비한 대체 경로도 마련해야 합니다. Live API로 넘어갈 때는 클라이언트가 100밀리초 PCM 청크, 중간 결과와 최종 이벤트의 차이, 임시 토큰, 10분 세션 경계를 모두 처리할 수 있는지 먼저 확인하세요.