 AIREITER
Eleven v3는 2026년 2월 2일 알파를 마치고 정식 출시(GA)됐다. ElevenLabs API에서 호출할 모델 ID는 eleven_v3다. 가격만 보면 ElevenLabs와 fal.ai 모두 1,000자당 $0.10으로 같다. 따라서 선택 기준은 단가가 아니라 과금 방식, 동시성, 사용할 수 있는 음성이다. GA에서는 실질적인 개선도 있었다. GA 발표에 따르면 27개 카테고리·8개 언어 벤치마크에서 구조화된 텍스트 오류율은 15.3%에서 4.9%로 낮아졌다. 다만 통합 설계 시에는 요청당 5,000자 제한과, 제작사조차 실시간 용도에는 적합하지 않다고 밝힌 모델이라는 두 가지 제약을 전제로 해야 한다.
Eleven v3 API로 할 수 있는 일
Eleven v3 API는 단일 화자 음성 생성과 스트리밍, 다화자 오디오를 위한 create-dialogue 및 stream-dialogue 엔드포인트까지 총 네 가지 표면을 제공한다. 70개 이상의 언어를 지원하며, 텍스트 안에 오디오 태그를 넣어 감정과 말투를 지시할 수 있다. GA 시점에는 안정성도 높아져, ElevenLabs 자체 테스트에서는 72%의 사례에서 알파 빌드보다 선호됐다.
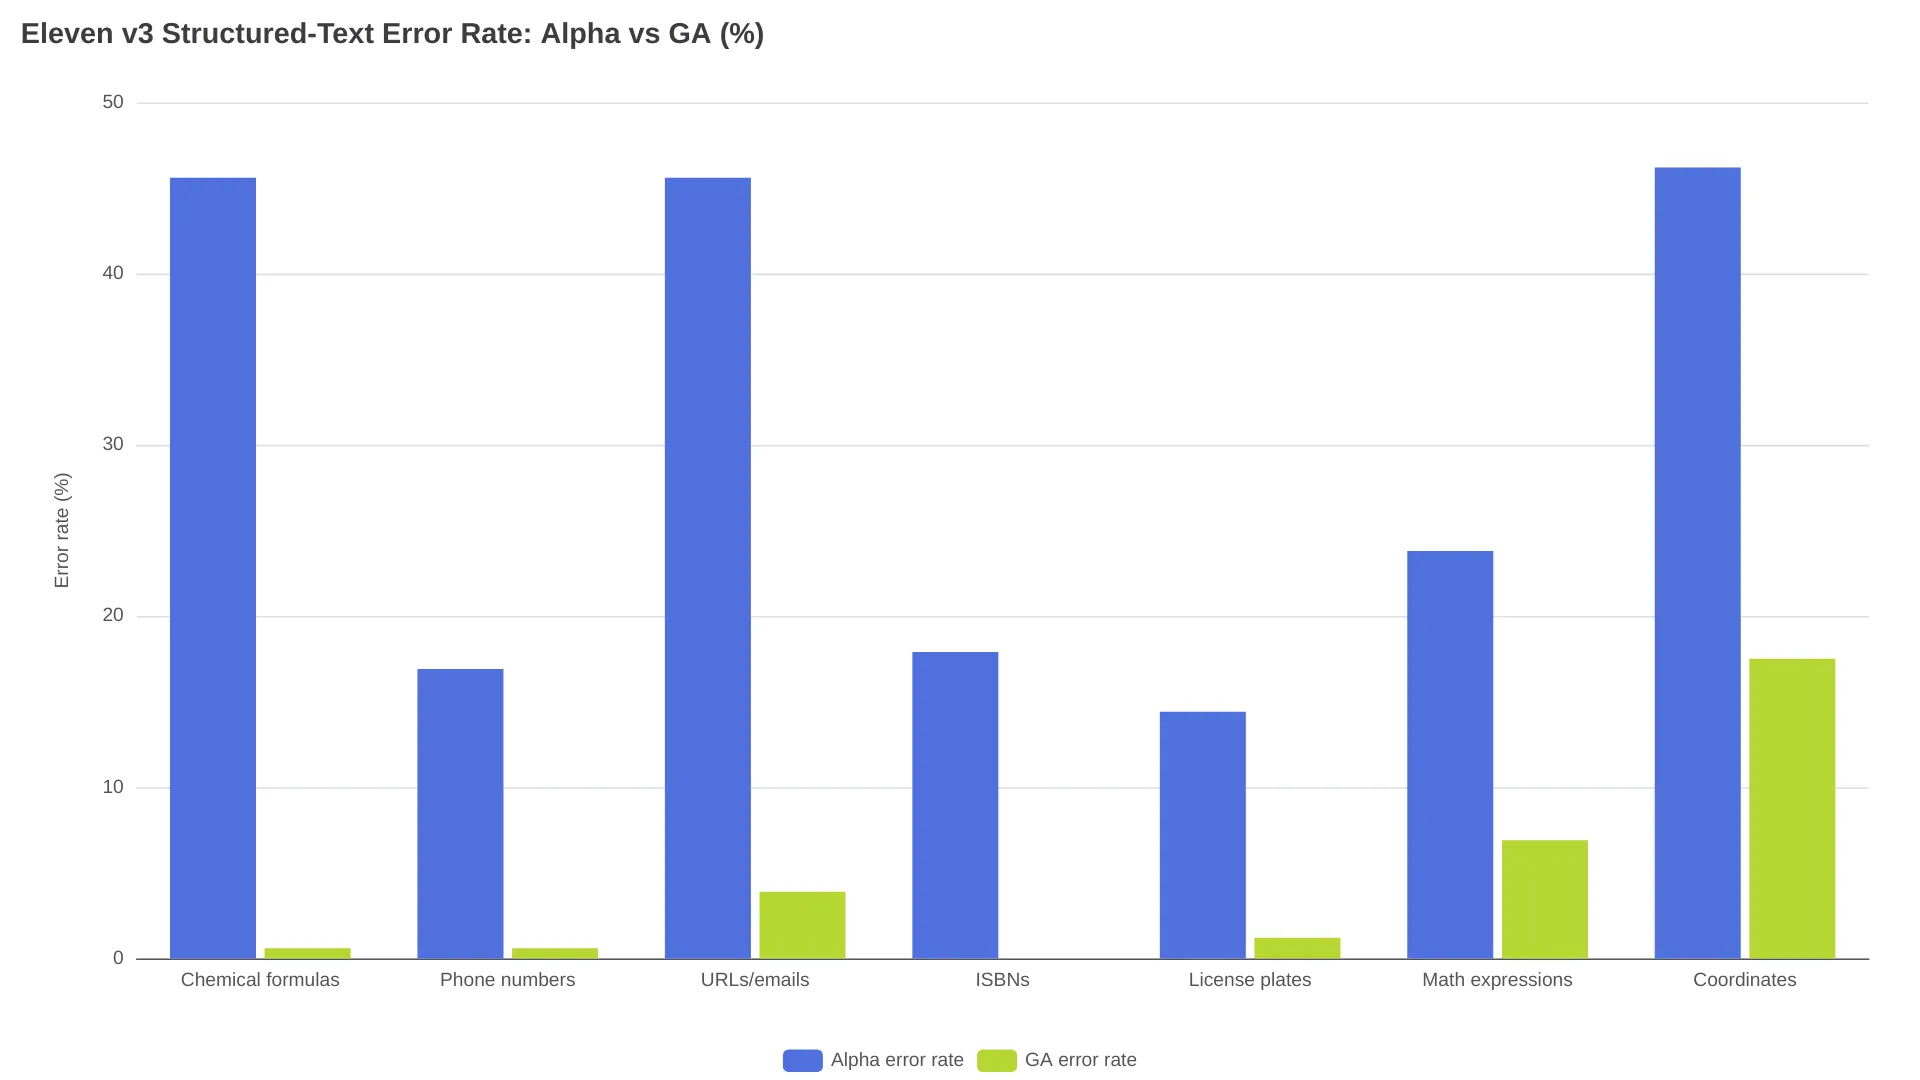
구조화된 텍스트에 v3를 쓰려면 벤치마크의 카테고리별 결과를 확인하는 편이 좋다. 화학식 오류율은 45.6%에서 0.6%로, 전화번호는 16.9%에서 0.6%로 떨어졌고 ISBN은 오류율 0을 기록했다. 반면 지리 좌표는 여전히 17.5%로 취약하며, 수식은 6.9%다. 내레이션에는 무난할 수 있지만 좌표가 많은 콘텐츠라면 위험 부담이 있다.
아래 표는 공식 모델 레퍼런스를 기준으로 Eleven v3가 다른 모델 사이에서 차지하는 위치를 정리한 것이다.
| 모델 | 모델 ID | 지원 언어 | 요청당 최대 글자 수 | 명시된 지연 시간 | 1,000자당 가격 |
|---|---|---|---|---|---|
| Eleven v3 | eleven_v3 | 70+ | 5,000(약 5분) | ~250–300 ms(티어별) | $0.10 |
| Eleven v3 Conversational | Text-to-Dialogue WebSocket 경유 | 70+ | n/a | ~280 ms | $0.10 |
| Multilingual v2 | eleven_multilingual_v2 | 29 | 10,000(약 10분) | ~250–300 ms | $0.10 |
| Flash v2.5 | eleven_flash_v2_5 | 32 | 40,000(약 40분) | ~75 ms | $0.05 |
문서 간 불일치도 하나 알아둘 필요가 있다. 가격 페이지는 "Multilingual v2/v3"를 40,000자 티어 제한으로 묶어 표기하지만, 모델 레퍼런스에서 Eleven v3의 요청당 한도는 5,000자다. v3에서는 모델별 수치인 5,000자를 실제 제한으로 봐야 한다. 40,000자를 전제로 설계한 장문 파이프라인은 실패한다.
가격 비교: ElevenLabs 공식 API와 fal.ai
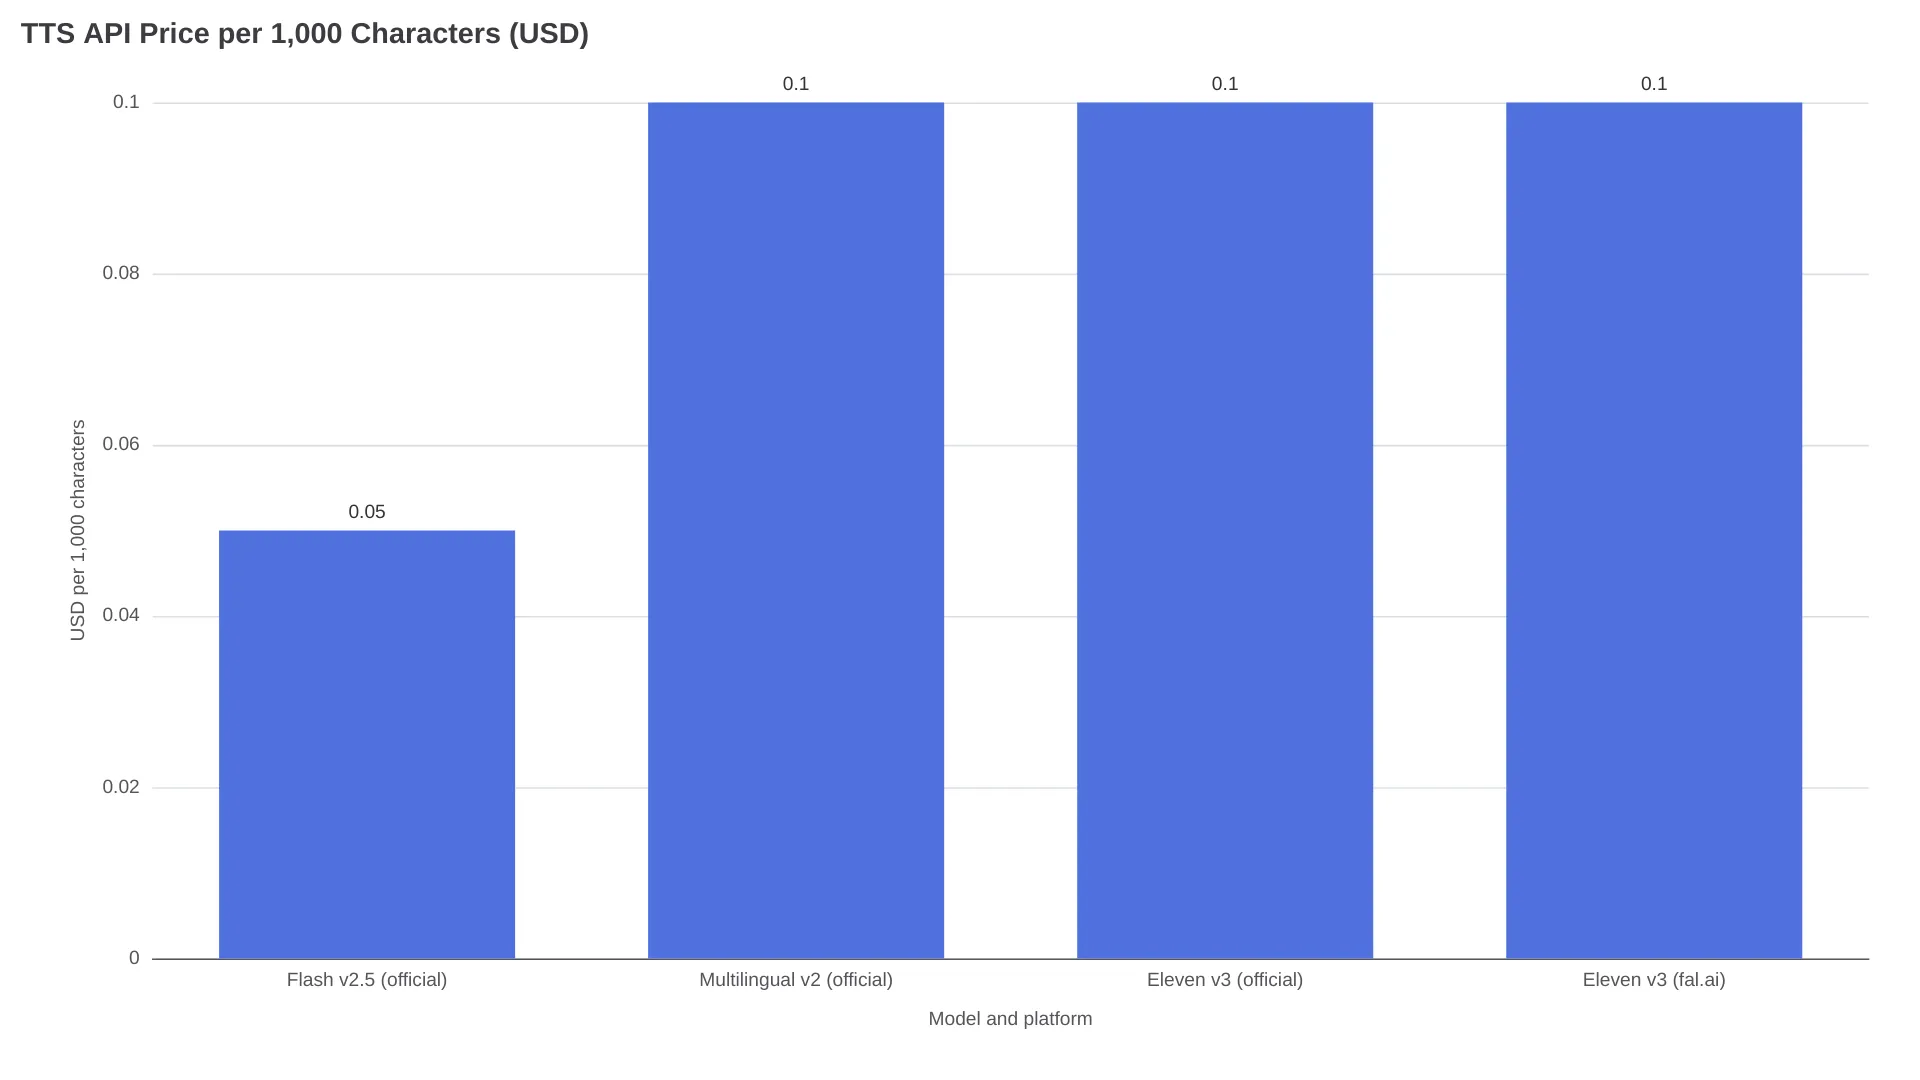
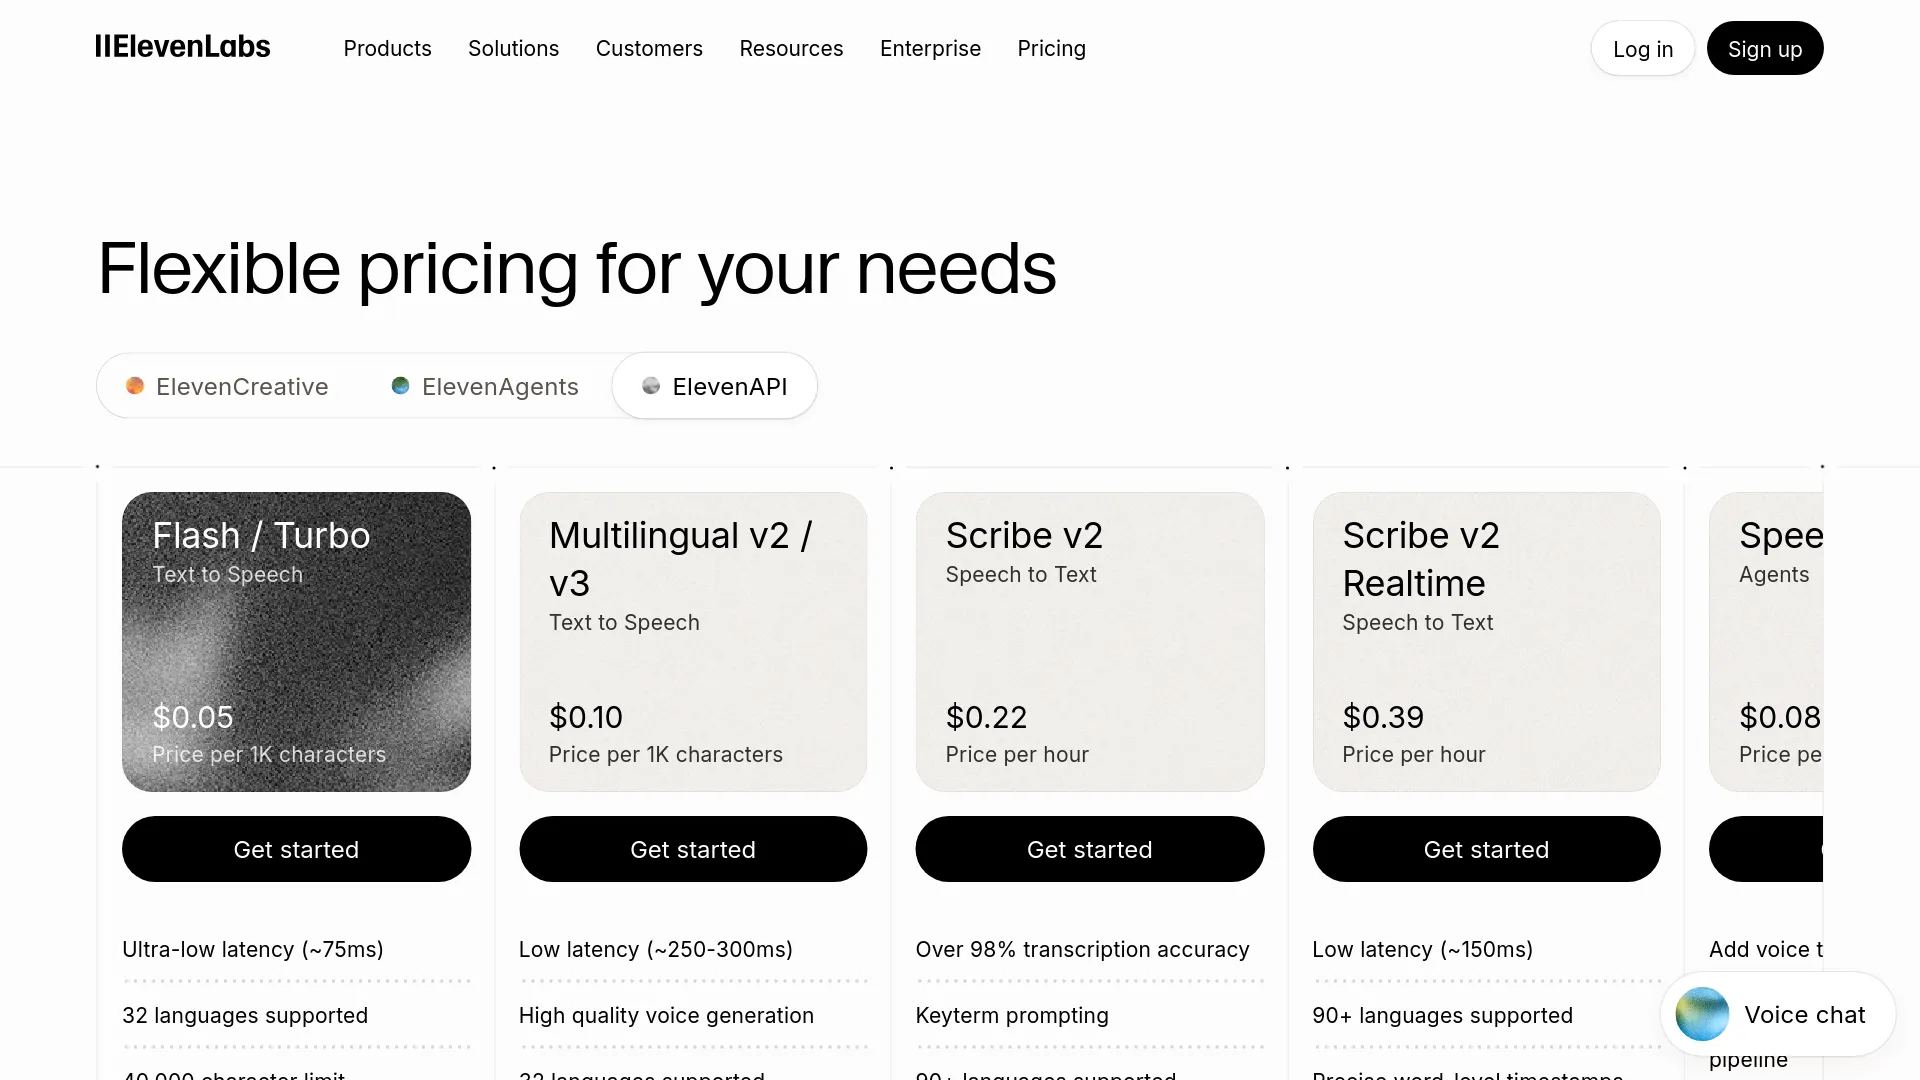
Eleven v3의 단가는 양쪽 모두 1,000자당 $0.10이다. 같은 계열에서 더 저렴한 모델은 1,000자당 $0.05인 Flash v2.5뿐이다. 실제 차이는 과금 구조와 병렬 처리 방식에서 나온다.
| ElevenLabs 공식 | fal.ai | |
|---|---|---|
| 단가(Eleven v3) | $0.10 / 1k chars | $0.10 / 1k chars |
| 과금 방식 | 포함 크레딧이 있는 구독 플랜 또는 종량제 | 완전 종량제; "좌석 라이선스, 구독, 최소 사용량 없음" |
| 무료 티어 | 월 10k Multilingual chars(Flash는 20k) | 모델 페이지에 별도 명시 없음 |
| 플랜 예시 | Creator 월 $22(첫 달 $11), Multilingual 220k chars | n/a |
| 최상위 플랜 | Business 월 $990, Multilingual 9.9M chars | n/a |
| 동시성 | 플랜별 차등: Free는 Multilingual 요청 2개 동시 처리, Scale/Business는 15–30개, Enterprise는 맞춤 설정 | 서버리스 큐 방식; 모델 페이지에는 계정별 제한이 문서화되지 않음 |
| 큐 처리 페널티 | 한도 초과 요청은 큐에 들어가며, "일반적으로" ~50 ms가 추가됨 | 배치 작업용 웹훅 지원 Queue API |
| 제어 항목(문서화된 스키마 및 사용자 보고) | ID로 음성 지정, stability(v3에서는 3단계라는 사용자 보고) | Voice, stability, similarity_boost, speed, language_code, apply_text_normalization, seed, timestamps, output_format |
| 스타트업 프로그램 | 12개월 무료, 33M characters, 더 높은 동시성 | n/a |
공식 API에서는 플랜 티어가 동시성도 결정한다. Free 키로 병렬 v3 요청을 보내면 동시 요청은 2개뿐이라 배치 처리 성능이 크게 제한된다. 반면 fal은 이런 배치 작업을 겨냥해 서버리스 큐와 웹훅 콜백을 제공한다. 두 플랫폼의 가격 문서 모두 공백이나 대괄호 오디오 태그가 과금 글자 수에 포함되는지는 밝히지 않는다. 예산은 포함된다고 가정해 잡는 편이 안전하다.
v3를 가끔만 쓰고 다른 모델도 이미 fal에서 운영 중이라면, 플랫폼 차원에서의 판단은 fal.ai 리뷰에서 더 자세히 다뤘다.
오디오 태그로 감정과 연기 지시하기
오디오 태그는 텍스트에 직접 삽입하는 대괄호 지시문이다. 모델은 이를 읽어야 할 단어가 아니라 연기 지시로 해석한다. fal 모델 페이지에 나온 최소 예시는 다음과 같다.
[slowly] Back then... [chuckles] we had no phones.
[whispers] Just dirt roads and [coughs] big dreams.
[sad] Then it happened.| 분류 | 작동하는 예시 |
|---|---|
| 감정 | [happy], [sad], [excited], [angry], [sarcastically], [nervous], [happily] |
| 말투와 전달 방식 | [whispers], [shouting], [shouts], [slowly], [quickly], [softly] |
| 비언어적 소리 | [laughs], [chuckles], [sighs], [gasps], [coughs], [gulps], [clears throat], [applause] |
| 억양 | [british accent], [southern accent], [strong canadian accent] |
공식 프롬프팅 문서에서 확인할 수 있는 핵심 원칙은 세 가지다. 첫째, 정식 태그 목록은 없다. 태그는 자연어 지시이며, ElevenLabs도 공개 예시 밖에 더 효과적인 태그가 있을 수 있다고 말한다. 외우기보다 테스트하는 편이 낫다. 둘째, SSML break 태그는 지원하지 않는다. 속도와 쉼은 문장부호, 말줄임표, 줄바꿈으로 조절해야 한다. 셋째, 효과는 음성과 문맥에 따라 달라진다. 실제 문제가 생기는 지점도 바로 여기다.
"V3 is amazing, certainly the most human sounding" "it still feels like a Beta release to me" — u/ConcertNeat8147, 같은 게시물에서 남긴 두 문장, v3에 관한 r/ElevenLabs 현장 보고
같은 스레드에서 경력 20년의 소프트웨어 엔지니어인 u/poundingCode는 감정 태그를 추가했을 때 화자의 억양이 완전히 바뀌는 경우가 있다고 전했다. ElevenLabs 직원 계정은 "현재 모두 작업 중인 부분"이라고 답했다.
아래는 같은 스레드에서 제작자들이 공유한 우회 방법이다. 공식 가이드가 아니라 커뮤니티 경험이라는 점은 구분해야 한다.
- 워밍업 문장을 앞에 넣는다. 톤과 피치를 설정하는 의미 없는 문장을 앞에 붙인 뒤 후편집에서 잘라낸다. 음성이 생성 후 몇 초가 지나야 "안정되는" 경우가 많다는 설명이다.
- 끝에
end.를 덧붙인다. 본문 끝에 줄바꿈과end.를 추가한 뒤 오디오에서 잘라낸다. 마지막 단어가 잘리는 현상을 막는 용도다. - 문장을 말줄임표로 끝낸다. 문장 끝을 "..."로 마무리하면 단어 말미에서 발생하는 잘림이 줄어든다는 보고가 있다.
- stability를 최대로 설정한다. v3의 stability 제어는 3단계이며, 가장 높은 설정은 생성 초반의 음성 드리프트를 줄인다.
통합 설계에 영향을 주는 제한 사항
- 가장 중요한 제한은 5,000자다. 한 요청은 약 5분 분량의 오디오가 최대다. 오디오북이나 장문 파이프라인은 텍스트를 청크로 나눠야 하며, 절이나 문장 중간이 아니라 문장 또는 문단 경계에서 자르는 것이 좋다. 태그는 자신이 지시하는 텍스트와 같은 청크에 남겨야 한다. 더 크고 적은 수의 요청이 필요하다면 Multilingual v2는 10,000자까지 허용한다.
- 공식 API의 동시성은 플랜 기능이다. 모델 레퍼런스에 따르면 Free 키는 Multilingual 티어 요청 2개(Flash는 4개)를 동시에 처리할 수 있다. Scale과 Business는 15–30개, Enterprise는 맞춤 한도를 협의한다. 한도를 넘기면 큐잉으로 "일반적으로" ~50 ms가 더해진다. 같은 문서는 동시성 5가 대화형 워크로드에서 약 100개의 동시 오디오 브로드캐스트를 지원한다는 용량 산정 기준도 제시한다. 요청 하나당 페널티는 작지만, 배치 규모에서 용량을 부족하게 잡으면 타격이 크다.
- fal은 최대 입력 크기를 전혀 명시하지 않는다. Eleven v3 페이지에는 엔드포인트, 파라미터, 포맷이 적혀 있지만 입력 상한, 큐 보관 기간, 재시도 동작은 없다. 긴 텍스트를 제출하는 것을 막지는 않지만, 성공을 보장하지도 않는다.
- 타임스탬프 지원은 플랫폼별로 갈린다. fal의 입력 스키마에는 단어별 정렬 데이터를 반환하는
timestamps불리언이 있다. 자막이나 립싱크에 유용하다. 공식 API에서는 v3 대화 출력에 타임스탬프가 제공되지 않으며, 개발자들이 이를 공개적으로 지적했다(r/ElevenLabs: "v3 API, no timestamps?"). 현재 정렬 데이터가 필요하다면 문서화된 경로는 fal의 파라미터다.
- 실시간 사용은 아직 선택지가 아니다. ElevenLabs는 높은 지연 시간과 일관성 변동을 이유로 v3가 실시간 및 대화형 사용에 적합하지 않다고 밝힌다. 공식적으로 제시된 선택지는 에이전트용 ~75 ms Flash v2.5, 또는 상호작용 환경에서도 표현력이 필요할 때 WebSocket으로 쓰는 ~280 ms Eleven v3 Conversational이다. 실시간 v3 버전은 로드맵에 있으며("we're working on a real-time version"), GA 발표 시점에는 출시되지 않았다.
- 상업적 사용. 알파 기간에는 개발자들이 v3 출력물의 상업적 이용 가능 여부를 공개적으로 문의했다. GA 발표 후 모델은 모든 플랫폼에서 열렸고, fal은 해당 엔드포인트를 상업적 사용 가능으로 명시한다.
첫 요청 보내기: 공식 SDK와 fal 클라이언트
퀵스타트에 나온 공식 경로는 다음과 같다.
pip install elevenlabsfrom elevenlabs import ElevenLabs
client = ElevenLabs(api_key="YOUR_ELEVENLABS_API_KEY") # or ELEVENLABS_API_KEY env var
audio = client.text_to_speech.convert(
voice_id="JBFqnCBsd6RMkjVDRZzb", # "George"
text="[whispers] The first move is what sets everything in motion.",
model_id="eleven_v3",
output_format="mp3_44100_128",
)fal 경로는 fal.run 엔드포인트에 fal-client를 사용한다.
pip install fal-clientimport fal_client
result = fal_client.subscribe(
"fal-ai/elevenlabs/tts/eleven-v3",
arguments={
"text": "[whispers] The first move is what sets everything in motion.",
"voice": "Rachel", # default voice
"stability": 0.5, # 0–1, lower = more expressive variation
"timestamps": True, # per-word alignment data
},
)
print(result["audio"]["url"]) # hosted MP3 URL두 플랫폼 모두 클라이언트 측 코드에 API 키를 넣지 말라고 명시적으로 경고한다. 요청은 자체 서버를 거쳐 프록시해야 한다. 스트리밍이 필요하면 공식 API에는 stream-speech 엔드포인트가 있고, fal은 fal.stream과 배치 작업용 웹훅 Queue API를 제공한다.
상황별로 어떤 엔드포인트를 골라야 할까?
| 상황 | 선택 |
|---|---|
| 직접 복제한 음성(PVC/IVC)이나 ID로 지정한 디자인 음성이 필요하다 | 공식 API: 맞춤 음성은 워크스페이스 내 ID로 참조한다. fal 페이지는 프리셋 음성 이름만 문서화한다. |
| 이미 포함 크레딧이 있는 ElevenLabs 플랜을 구독 중이다 | 공식 API: 포함 글자 수는 이미 지불한 비용이며, fal 호출마다 새 비용이 발생한다. |
| 구독 없이 오디오북·더빙을 배치 처리하고 완료 웹훅이 필요하다 | fal: 종량제 큐와 웹훅 흐름이 정확히 이 사례를 겨냥한다. |
| 이미지·영상·TTS 모델을 하나의 스택과 API 키로 운영하고 싶다 | fal: v3도 다른 fal 모델과 같은 클라이언트에서 호출한다. |
| 음성 에이전트 또는 지연 시간이 중요한 모든 작업 | v3 TTS 엔드포인트는 둘 다 부적합: Flash v2.5(~75 ms) 또는 Eleven v3 Conversational(~280 ms)을 사용한다. |
| Enterprise 요구 사항(SOC 2, HIPAA BAA, 맞춤 속도 제한, IP 허용 목록) | 공식 API: 가격 페이지에 Enterprise 플랜 기능이 문서화돼 있다. fal 모델 페이지는 해당 엔드포인트에 어떤 인증이 적용되는지 밝히지 않는다. |
FAQ
Eleven v3의 모델 ID는 무엇인가요?
eleven_v3다. 표준 텍스트 음성 변환 엔드포인트에서 model_id로 전달한다. 다화자 대화는 모델 파라미터가 아니라 별도 Text-to-Dialogue 엔드포인트를 사용한다.
Eleven v3 API는 스트리밍을 지원하나요?
지원한다. 공식 API는 생성되는 대로 오디오를 반환하는 stream-speech 엔드포인트를 제공하며, fal도 동일 모델에 fal.stream을 제공한다. 그렇다고 스트리밍이 v3를 실시간 사용에 안전하게 만들어 주는 것은 아니다. 공식 가이드에서는 여전히 대화형 용도로 Flash v2.5 또는 Eleven v3 Conversational을 권한다.
Eleven v3의 글자 수 제한은 얼마인가요?
공식 모델 레퍼런스 기준 요청당 5,000자이며, 오디오 약 5분에 해당한다. 가격 페이지의 40,000자 수치는 Multilingual 티어 그룹에 대한 값이지 v3 개별 모델의 제한이 아니다.
Eleven v3 API 비용은 얼마인가요?
두 경로 모두 1,000자당 $0.10이다. 10,000자 분량의 스토리는 $1.00, 1M자 분량의 오디오북은 $100이다. 공식 API는 플랜 크레딧으로 비용을 상쇄할 수 있다(Creator 월 $22에는 Multilingual 220k characters 포함). fal은 구독제가 없다.
Eleven v3에서 복제 음성을 사용할 수 있나요?
공식 API에서는 가능하다. Professional, 복제, 디자인 음성은 voice ID로 참조한다. 다만 실제 호환성은 달라질 수 있다. r/ElevenLabs 사용자들은 기존 Professional Voice Clone이 v3에서 다른 화자처럼 들리기도 한다고 보고하며, 제작자가 V3 호환성을 표시한 PVC가 가장 안정적으로 유지되는 경향이 있다고 말한다. fal 스키마는 음성 이름 또는 ID를 받지만 프리셋 음성만 문서화하므로, 비공개 ElevenLabs voice ID는 여기서 문서화되지 않은 영역이다.
Eleven v3는 실시간 음성 에이전트에 적합한가요?
아니다. ElevenLabs는 높은 지연 시간과 일관성 변동을 이유로 v3를 실시간 및 대화형 용도에 부적합하다고 명시한다. Flash v2.5(~75 ms, 32개 언어) 또는 Eleven v3 Conversational(~280 ms, 70개 이상 언어, 오디오 태그 제어)을 사용해야 한다.
웹사이트에서 들은 것과 API의 Eleven v3 음성이 다른 이유는 무엇인가요?
음성 미리듣기는 직접 입력한 텍스트에서 나올 결과를 대표하지 못한다는 불만이 r/ElevenLabs 현장 보고에서 반복적으로 나온다. v3 출력은 생성마다 눈에 띄게 달라질 수도 있다. 실제 프로덕션에 적용하기 전, 후보 음성마다 실제 스크립트 청크와 운영에 사용할 stability 설정으로 테스트해야 한다.
함께 읽기: Qwen Audio 3 TTS API 가이드 · Replicate 가격 및 대안 · fal.ai 리뷰 2026