 AIREITER
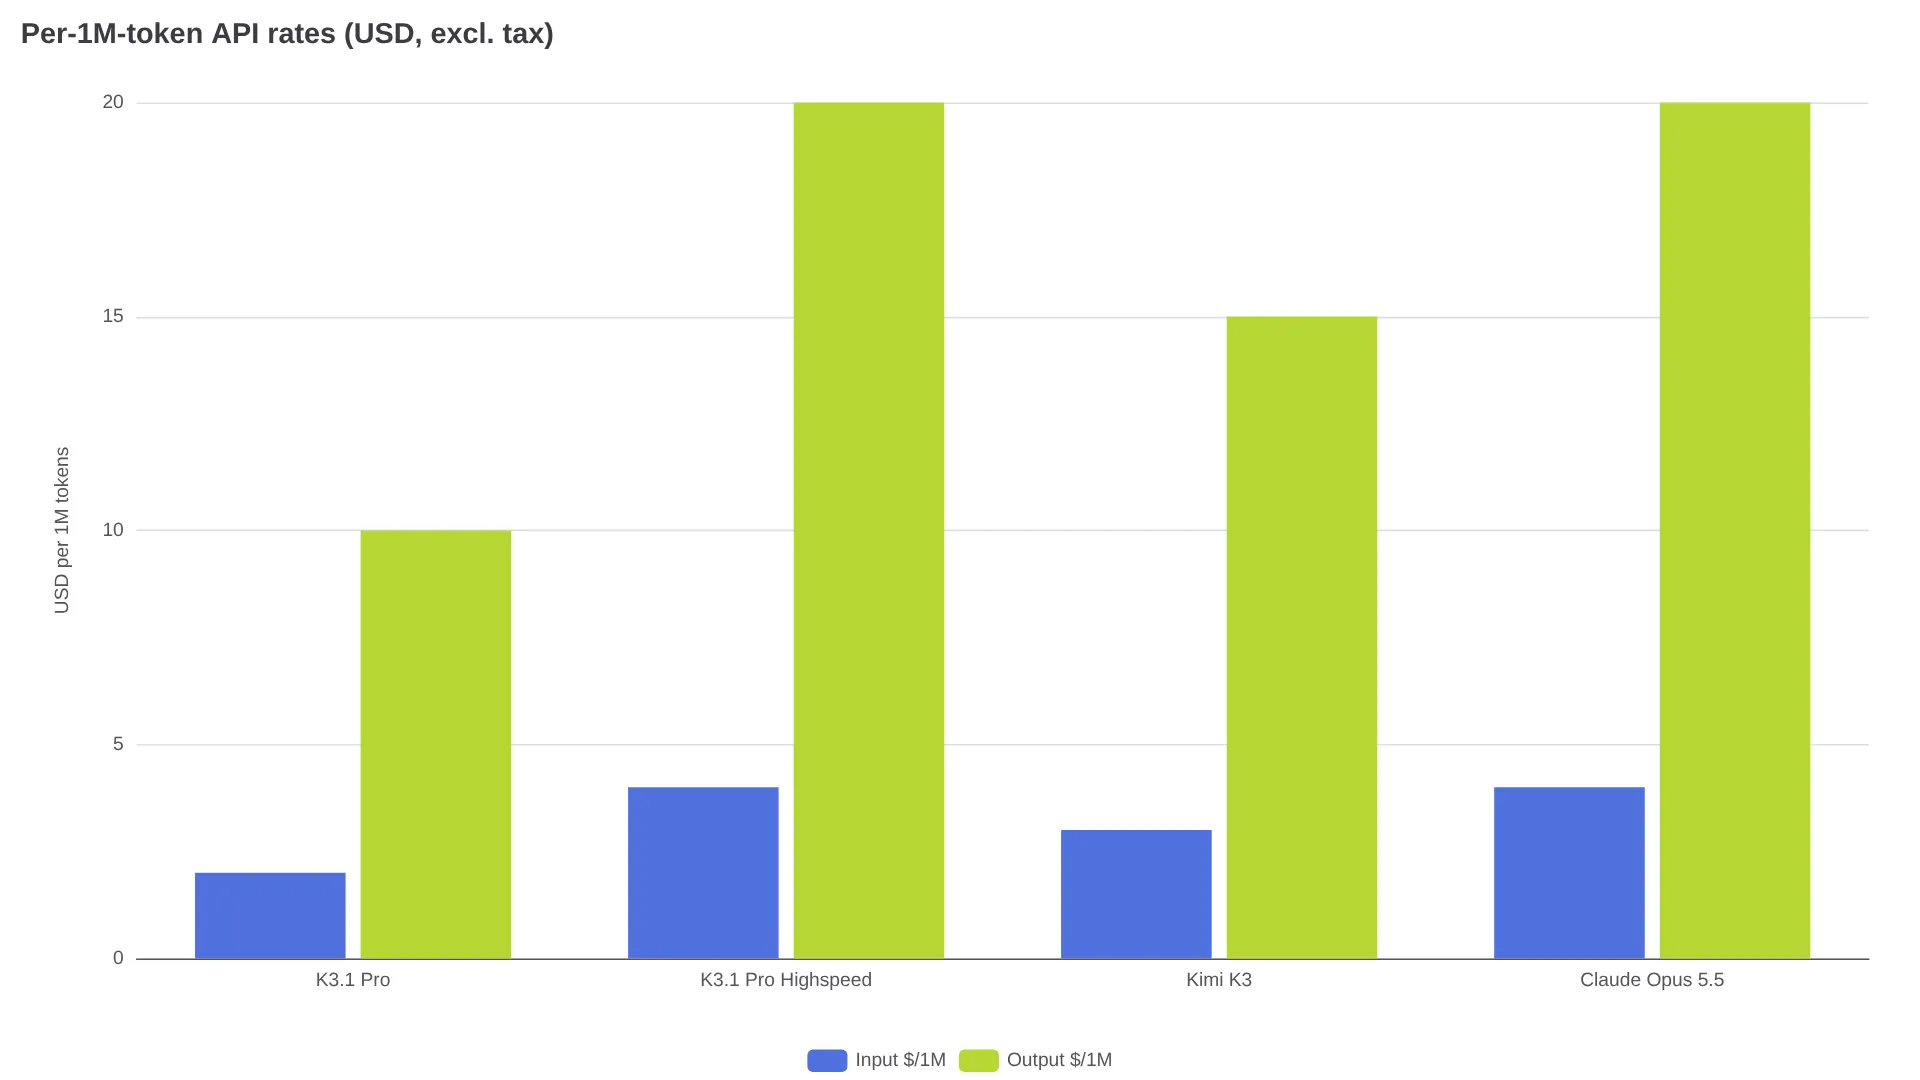
Il prezzo delle API di Kimi K3.1 Pro sembra semplice, ma il conto finale dipende soprattutto da reasoning e cache: $2 per 1M di token in input e $10 per 1M in output nel piano Standard, il doppio per Highspeed e appena $0,20 per 1M di token letti dalla cache su entrambi i livelli (platform.kimi.ai).
| Modello | Input / 1M | Output / 1M | Lettura cache / 1M | Scrittura cache 5 min / 1M | Scrittura cache 1 ora / 1M |
|---|---|---|---|---|---|
Kimi K3.1 Pro (kimi-k3.1-pro) | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed) | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (generazione precedente) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Le tariffe sono espresse in USD per 1M di token, al netto delle imposte, e restano fisse anche sull'intero contesto da 1M di token: non è previsto alcun sovrapprezzo per i contesti lunghi, secondo il listino ufficiale di Kimi (kimi.ai).
Una richiesta con contesto da 100K costa $0,30: il resto arriva in fattura
Prendiamo un caso semplice: 100.000 token di input non presenti in cache e 10.000 token di output costano $0,20 più $0,10, quindi $0,30. È il calcolo diretto basato sulle tariffe ufficiali di $2/$10. Per richieste reali si può usare questa formula, riferita al piano Standard; con Highspeed vanno raddoppiate le tariffe di input, output e scrittura:
Totale = (input_non_in_cache x 2 + letture_cache x 0.20 + scritture_5m x 2
  + scritture_1h x 4 + (output_visibile + output_reasoning) x 10) / 1M
  + ricerche x 0.004
La formula riprende il dettaglio ufficiale dei costi Kimi: input non in cache, hit della cache, scritture con TTL diversi e output (kimi.ai), a cui si aggiungono $0,004 per ogni chiamata Web Search. Il pagamento è a consumo e viene calcolato richiesta per richiesta (kimi.ai): se una richiesta viene ripetuta, il contatore riparte da capo. Su K3.1 Pro il reasoning è sempre attivo e viene fatturato come output. In pratica, anche le tracce di ragionamento nascoste consumano lo stesso budget da $10/1M della risposta visibile. Una risposta da 10.000 token con 40.000 token di reasoning nascosto viene quindi fatturata come 50.000 token di output, cioè $0,50. Anche un report reale con 935 token in input e 56.097 in output, costato $0,5628, è quasi perfettamente coerente con la tariffa di $10/1M per l'output (x.com).
L'altro elemento che spesso sfugge è la cache. I prefissi memorizzati per la prima volta generano un costo di scrittura; quando lo stesso prefisso viene riutilizzato senza modifiche durante la finestra prevista, la lettura scende a $0,20/1M. La durata predefinita della cache è di cinque minuti, con la possibilità di scegliere un'ora per ogni chiamata (kimi.ai). Se cambia un prefisso all'inizio del contesto, può diventare inutilizzabile anche tutto ciò che segue (kimi.ai). Per verificare che gli hit siano stati effettivamente applicati bisogna controllare il dettaglio d'uso della singola richiesta, distinguendo token letti dalla cache e token non memorizzati: una formulazione simile, da sola, non garantisce il riutilizzo.
Prezzi API di Kimi K3.1 Pro a confronto: Standard contro Highspeed
Highspeed offre la stessa intelligenza dichiarata e lo stesso contesto da 1M di token, ma con una velocità indicata come circa 2-3 volte superiore. Il prezzo, però, raddoppia per input, output e scritture della cache (platform.kimi.ai), come spiegato da Moonshot nel post di lancio (kimi.ai).
L'unica tariffa che non raddoppia è quella per la lettura dalla cache: entrambe le varianti costano $0,20 per 1M di token in input già memorizzati. La differenza si sente soprattutto nei loop degli agenti che ripetono lunghi prompt di sistema e definizioni degli strumenti: il riutilizzo costa uguale su entrambi i piani, mentre token nuovi e reasoning costano il doppio su Highspeed.
Per stimare correttamente la spesa bastano tre punti fermi:
- La fatturazione API è a consumo, con conteggi separati per input e output, ed è distinta dagli abbonamenti Kimi e dai piani Kimi Code. Il credito di un abbonamento non può quindi pagare le chiamate API (kimi.ai).
- Le API sono compatibili con OpenAI e usano gli ID modello
kimi-k3.1-proekimi-k3.1-pro-highspeed, disponibili all'indirizzohttps://api.moonshot.ai/v1e anche tramite gateway comemoonshotai/kimi-k3.1-prosu OpenRouter e Vercel AI Gateway. - Le chiamate opzionali a Web Search costano $0,004 ciascuna, oltre ai token; i file caricati non hanno un costo diretto, ma il loro contenuto elaborato viene fatturato come input. L'accesso alle API si attiva dopo una ricarica minima di $1 e prevede limiti di velocità a livelli (kimi.ai).
Quando il prezzo doppio di Highspeed ha senso e quando è solo denaro sprecato
Highspeed conviene soltanto quando il tempo d'attesa vale più dei token. Sessioni di coding interattivo, assistenti in tempo reale e demo rivolte agli utenti possono giustificare il prezzo di $4/$20: in questi casi la latenza fa parte del prodotto. Batch notturni, agenti eseguiti senza supervisione e sessioni di valutazione dovrebbero invece restare sul piano Standard da $2/$10, con tariffe per token circa dimezzate. La soglia è semplice: Highspeed ha senso solo quando il valore del tempo risparmiato supera il costo aggiuntivo, che nei carichi dominati dall'input equivale più o meno a un'altra fattura Standard completa.
Prima di cambiare piano, conviene intervenire sul reasoning. L'API supporta reasoning_effort con i livelli low, high e max; quest'ultimo è il valore predefinito ed è quello usato nei benchmark riportati da Moonshot (datacamp.com). Passare un test da max a high, o da high a low, riduce i token di reasoning nei compiti semplici senza pagare il sovrapprezzo di Highspeed. È meglio mantenere lo stesso livello per tutta la sessione, perché cambiarlo a metà invalida la cache del contesto (datacamp.com).
Alcune segnalazioni della community rendono concreto il compromesso. Un utente giapponese ha confrontato attività equivalenti: Opus 5.5 ha impiegato 14:32, contro i 27:53 di Kimi K3.1 Pro, con una qualità dell'output molto simile. La sua conclusione è stata riservare Kimi ai lavori in cui si può aspettare:
Avrebbe dovuto costare la metà, ma i tempi d'attesa erano quasi il doppio. ... Opus 5.5 ha impiegato 14 minuti e 32 secondi, Kimi K3.1 Pro 27 minuti e 53 secondi. A essere onesti, il risultato era molto simile. Io affiderei a Kimi solo i lavori per cui posso aspettare. — @rutinelabo (x.com)
Gli utenti di Reddit descrivono un divario analogo: circa 80 tok/s su Highspeed contro circa 30 tok/s sul piano Standard, definendo però il livello veloce molto costoso:
E ancora una volta il modello ha una versione ad alta velocità che costa un occhio della testa e corre molto più rapidamente di quanto l'occhio riesca a leggere (80 t/s), mentre la versione normale viaggia a 30 t/s quando va bene. — u/Kiverty (reddit.com)
La regola pratica è questa: partire da K3.1 Pro Standard, ridurre prima reasoning_effort e pagare Highspeed solo nelle sessioni in cui c'è una persona ad aspettare.
Self-hosting dopo il 4 novembre: cosa comporta davvero un modello da 3T
Moonshot dichiara che i pesi completi di Kimi K3.1 Pro saranno rilasciati entro il 4 novembre 2026 e descrive il modello come appartenente alla classe 3T, con una finestra di contesto da 1M di token (kimi.com). Al 2 novembre non risultava ancora disponibile alcun repository ufficiale di K3.1 Pro nell'organizzazione Moonshot su Hugging Face, raggiungibile da huggingface.co/moonshotai: erano presenti Kimi K3 e i modelli precedenti, mentre nei risultati comparivano soltanto fork non ufficiali. Anche licenza finale, formati dei file e opzioni di quantizzazione restano da confermare; i tracker di terze parti li indicano come sconosciuti in attesa del rilascio ufficiale (ctrlaltorion.com).
È proprio la scala a rendere difficile battere il prezzo delle API con il self-hosting. K3.1 Pro è il successore post-trained di Kimi K3, un modello mixture-of-experts da 2,8T di parametri, e l'etichetta da 3T punta nella stessa direzione (datacamp.com). I parametri complessivi di un modello MoE non corrispondono a quelli attivi per ogni token, quindi con le informazioni disponibili non è ancora possibile calcolare in modo affidabile la VRAM necessaria su una singola workstation.
Meglio usare un punto di pareggio simbolico invece di inventare un prezzo per le GPU:
API_mese = token_mensili_1M x blended_$/1M (dalla formula sopra)
Il self-hosting conviene quando costo_mensile_cluster < API_mese con utilizzo sostenuto
Con $2/1M per l'input e $10/1M per l'output, 1 miliardo di token in input più 100 milioni in output costano $2.000 più $1.000, cioè circa $3.000 di consumo API. Il self-hosting può convenire ai team che possiedono già un cluster adeguato, eseguono inferenze ad alto volume in modo continuativo o devono mantenere i dati on-premise. Per chi non dispone di quel cluster e di un utilizzo sostenuto, la formula sopra favorirà di norma le API a consumo: meglio aspettare checkpoint e licenza ufficiali prima di pianificare altro.
Due trappole di fatturazione che continuano a colpire gli utenti
La prima è il reasoning fatturato come output, già incluso nella formula precedente. Per tenere sotto controllo la spesa si può limitare l'esecuzione con max_completion_tokens, iniziare i test con low, passare a high solo in caso di insuccesso e riservare max all'esecuzione finale più difficile.
La seconda riguarda il consumo delle quote in abbonamento rispetto alla prevedibilità delle API. Diversi utenti paganti raccontano di aver esaurito in pochi minuti una disponibilità di cinque ore durante attività di coding impegnative; un utente del piano più costoso ha riferito di aver consumato l'intera quota mensile in sei ore (reddit.com). Il 25 ottobre Moonshot ha riconosciuto il problema, scusandosi per i limiti di velocità e il consumo non necessario della quota, concedendo un ripristino una tantum del 25% e riducendo le chiamate ridondanti dei subagenti e la lunghezza degli output (x.com). Per reasoning e coding intensivi, il consumo API misurato — $0,30 per ogni unità da 100K token in input e 10K in output — resta più prevedibile di quote in abbonamento che possono sparire durante un'unica attività.
FAQ sui prezzi API di Kimi K3.1 Pro
Quanto costa Kimi K3.1 Pro per 1M di token?
Il piano Standard costa $2.00 per l'input, $10.00 per l'output, $0.20 per la lettura di input dalla cache, $2.00 per la scrittura nella cache da 5 minuti e $4.00 per la scrittura nella cache da 1 ora, ogni 1M di token e prima delle imposte (kimi.ai).
Qual è la differenza tra K3.1 Pro e Highspeed?
Highspeed offre la stessa intelligenza dichiarata e lo stesso contesto da 1M, ma una velocità indicata come circa 2-3 volte superiore. Costa $4.00 per l'input e $20.00 per l'output ogni 1M di token; anche le scritture nella cache raddoppiano, mentre le letture dalla cache restano a $0.20 (platform.kimi.ai).
Quali sono gli ID dei modelli API?
Usa kimi-k3.1-pro per il piano Standard e kimi-k3.1-pro-highspeed per il livello veloce sull'endpoint OpenAI-compatible di Moonshot. I gateway lo indicano come moonshotai/kimi-k3.1-pro (openrouter.ai).
L'utilizzo delle API è incluso in un abbonamento Kimi?
No. La fatturazione API è separata dagli abbonamenti Kimi e dai piani Kimi Code, con chiavi e saldi distinti: i crediti dell'abbonamento non possono pagare le chiamate API (kimi.ai).
Si può disattivare il reasoning per ridurre i costi?
No. K3.1 Pro esegue sempre il reasoning. Il controllo della spesa passa da reasoning_effort (low, high, max, con max come valore predefinito) e da max_completion_tokens, non dalla disattivazione del ragionamento (datacamp.com).
Quando arriveranno i pesi open e conviene aspettare?
Moonshot punta al 4 novembre 2026, ma al 2 novembre non risultavano pubblicati né un repository ufficiale su Hugging Face né la licenza finale. Per ora conviene pianificare sull'API e rivalutare il self-hosting solo dopo la pubblicazione del checkpoint e della licenza ufficiali.
Approfondimenti: Kimi K3.1 Pro API: guida a prezzi, benchmark e Highspeed per il confronto completo dei benchmark, Prezzi di Kimi K3 per le tariffe della generazione precedente e la pagina API di Kimi K3 per chiamare i modelli Kimi con una sola chiave.