 AIREITER
Opus 5.5 vince sulla qualità, GPT-6.1 Sol sul prezzo di listino, ma solo finché ogni richiesta resta sotto i 272K token di input. Superata quella soglia, la sovrattassa per il contesto lungo riduce quasi del tutto il vantaggio di Sol. E diversi utenti di Codex riferiscono che, sul tempo effettivo necessario per completare un’attività, Sol sembra comunque più lento.
Entrambi i modelli sono disponibili oggi. Anthropic ha lanciato Claude Opus 5.5 il 22 settembre 2026, come primo modello della serie Claude 5.5, mentre OpenAI ha lanciato GPT-6.1 Sol il 29 settembre 2026 con API ID gpt-6.1-sol. Le sole tabelle delle specifiche non bastano: a determinare davvero il costo sono il limite del contesto lungo, il livello di ragionamento e il comportamento delle quote negli abbonamenti.
La risposta in 30 secondi
Scegli Claude Opus 5.5 quando una patch sbagliata o gonfiata costa più dei token: migrazioni lunghe, audit su più repository e agenti senza supervisione. Scegli GPT-6.1 Sol per lavori ad alto volume e ben delimitati, con meno di 272K token di input per richiesta: automazione dei ticket, estrazione da PDF e workflow aziendali.
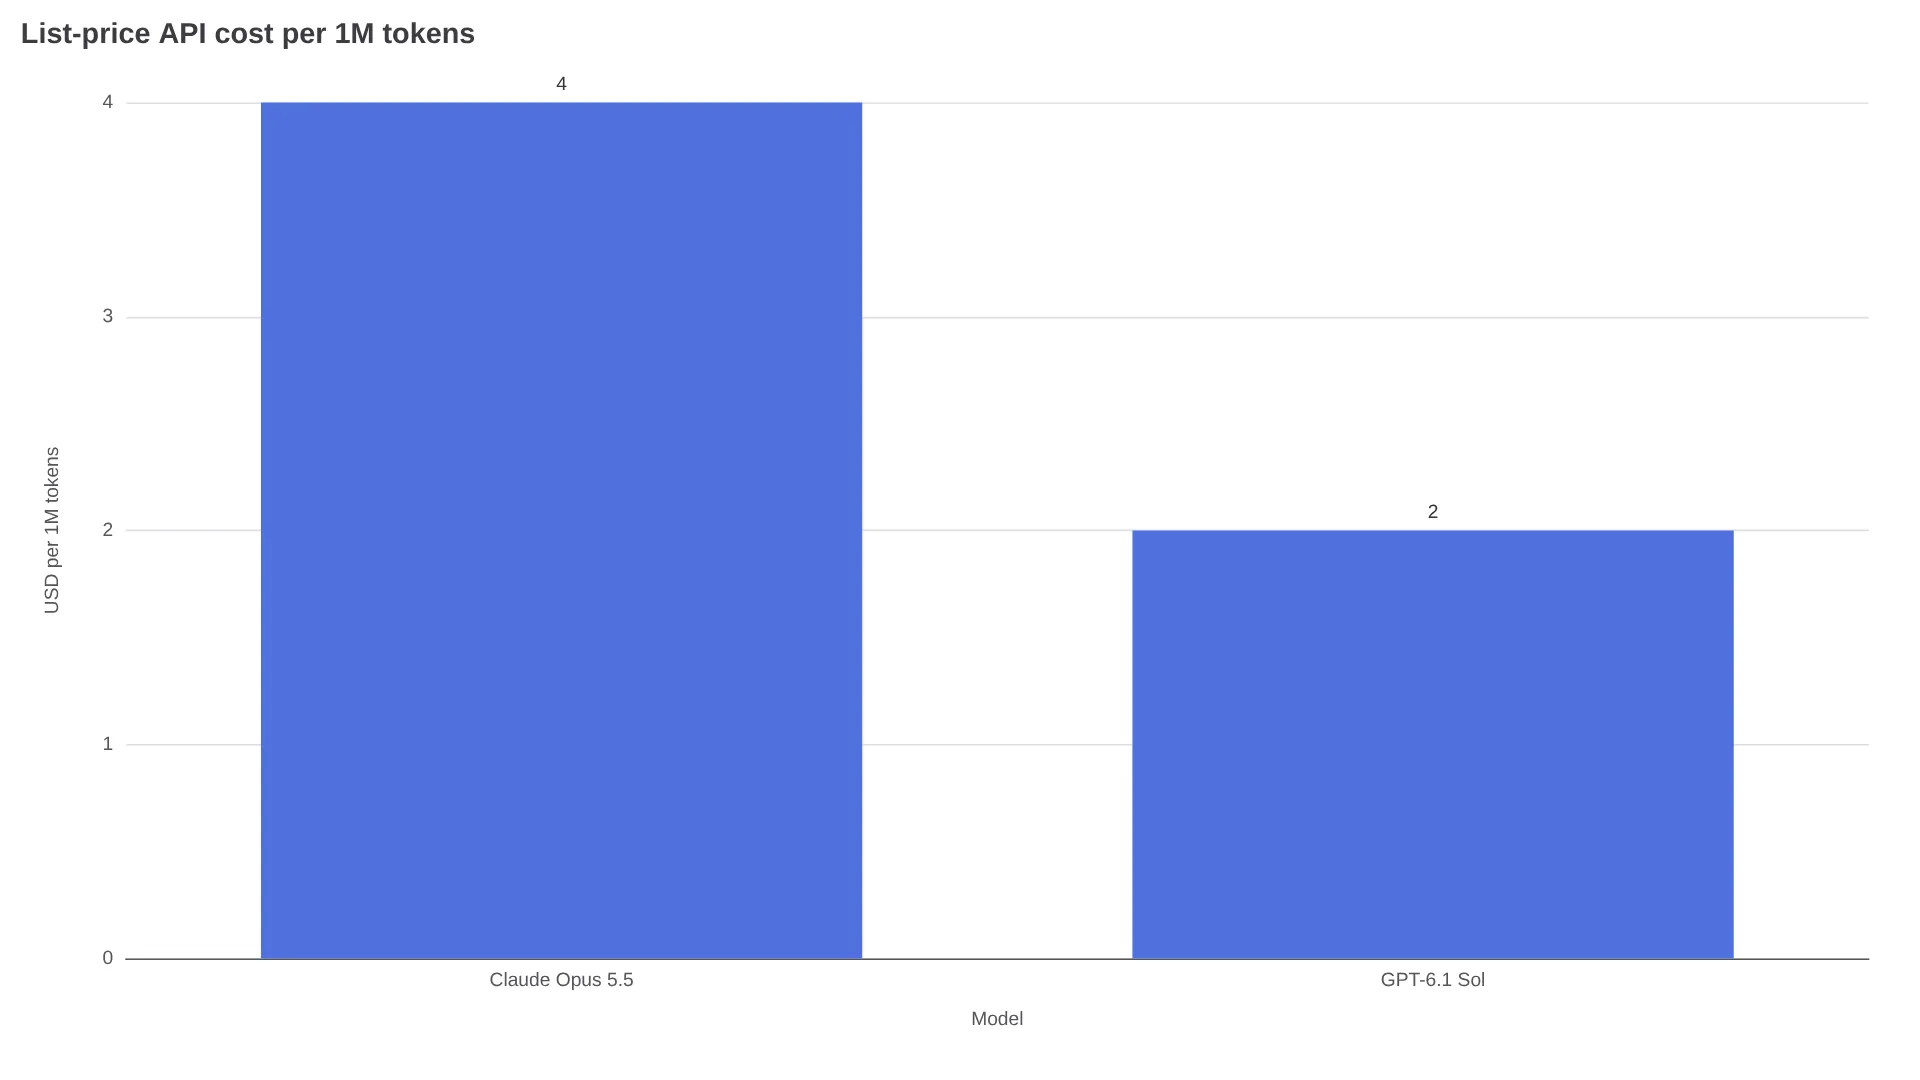
Sulla carta, il divario nelle specifiche è ridotto: contesto da 1M contro 1,05M token, 128K token massimi in output per entrambi e $4/$20 contro $2/$10 per milione di token di input/output. Sul piano pratico, invece, la differenza è più netta: Opus 5.5 ottiene risultati migliori nei benchmark di coding agentico (66.4% in Terminal-Bench 4.0, 54.4% in FrontierCode v1.1 e 57.8% in CursorBench 4.0), mentre Sol risponde con un prezzo di listino quasi dimezzato e una vittoria documentata in AutomationBench a un terzo del costo per attività. Per chi usa un abbonamento c’è però una complicazione: i test sulle quote pubblicati su Reddit indicano che Sol consuma il plafond più rapidamente di quanto farebbe pensare il prezzo API.
Prezzo, contesto e canali disponibili
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Provider | Anthropic | OpenAI |
| Data di rilascio | 22 settembre 2026 | 29 settembre 2026 |
| API ID | famiglia claude-opus-5-5 sulla maggior parte dei gateway | gpt-6.1-sol |
| Input / output per 1M | $4.00 / $20.00 | $2.00 / $10.00 |
| Lettura input in cache per 1M | $0.20 | $0.10 |
| Finestra di contesto | 1,000,000 token | 1,050,000 token |
| Output massimo | 128K token | 128K token |
| Livello veloce | Modalità Fast $8 / $40, fino a 2.5x di velocità | Ultrafast fino a 8x in Codex, circa 2x le tariffe di listino |
| Disponibile tramite | Claude Code, API, Bedrock, Vertex, Foundry, OpenRouter | Codex, ChatGPT Work, API, Azure, Bedrock, OpenRouter |
| Non disponibile in | — | Chat consumer standard al lancio |
Per passare dall’uno all’altro basta modificare la stringa del modello. AIReiter instrada entrambi dalla stessa console, senza dover gestire due chiavi di fornitori diversi.
Quanto si paga davvero sui carichi di lavoro reali
Le tariffe di listino fanno sembrare Sol più economico del 50%. Nei carichi reali, però, contano la dimensione di ogni richiesta e l’uso della cache.
La sovrattassa di OpenAI scatta per ogni richiesta oltre i 272K token di input: per l’intera richiesta, le tariffe di input e cache raddoppiano, mentre quella di output aumenta di 1.5x. Anthropic indica la finestra completa da 1M alle stesse tariffe, senza aver dichiarato una sovrattassa per singola richiesta. Le letture dalla cache costano $0.20 contro $0.10: nei loop che sfruttano molto la cache, Sol conserva quindi una parte del vantaggio.
| Carico di lavoro | Opus 5.5 | GPT-6.1 Sol | Differenza |
|---|---|---|---|
| Assistente bilanciato: 1M in / 250K out, richieste sotto 272K ciascuna | $9.00 | $4.50 | Sol costa il 50% in meno |
| Retrieval, richieste sotto 272K: 10M in / 1M out | $60 | $30 | Sol costa il 50% in meno |
| Retrieval, ogni richiesta oltre 272K: 10M in / 1M out | $60 | ~$55 | Sol costa solo ~8% in meno |
| Loop con forte uso della cache: prefisso da 100K scritto una volta, poi 1.000x (5K nuovi + 100K letti dalla cache + 1K out) | ~$60.50 | ~$30.25 | Sol costa ~50% in meno |
Si tratta di calcoli alle tariffe di listino, prima di considerare eventuali differenze tra tokenizer. Il vantaggio di Sol è massimo con richieste brevi e ad alto volume, mentre si riduce al minimo nei retrieval molto grandi eseguiti in un’unica richiesta.
Il conto degli abbonamenti è diverso da quello delle API. Un confronto condotto da un utente su 128 prompt, con GPT-6.1 Sol, GPT-6 Sol e Opus 5.5 sottoposti agli stessi prompt, ha rilevato un consumo dell’abbonamento della famiglia Sol superiore a quello suggerito dal prezzo dei token. Un commento successivo lo riassume senza troppi giri di parole:
"Il mio ChatGPT ha appena citato questo. Comunque, forse sul consumo sono comparabili, ma Opus è molto più veloce sul tempo reale e mi pento di aver cambiato questo mese." — u/ebrbrbr, thread di test sulle quote di r/ChatGPT
Un altro utente di Codex ha segnalato lo stesso problema:
"Non mi dispiacerebbe usare GPT 6.1 Sol se il consumo fosse ragionevole, ma accidenti: anche se è più efficiente, continua a prosciugarmi la quota. È incredibile." — u/Longjumping_Stop6269, r/codex
Regola pratica per il budget: se la richiesta mediana supera 272K, calcola la sovrattassa prima di migrare. Se utilizzi un piano da $20 o $100, misura la quota consumata per ogni PR integrata, non i token per dollaro.
Coding e agenti: benchmark e due test pratici
I test di terze parti riportati qui sotto sono indicativi: harness e livelli di ragionamento non sono sempre gli stessi. Fonti: Anthropic, OpenAI, test di build di DataCamp, throughput di OpenRouter, raccolta di benchmark di SpringPrompt.
| Benchmark | Opus 5.5 | GPT-6.1 Sol | Nota |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | non pubblicato | Eseguito da Anthropic, xhigh |
| FrontierCode v1.1 Main | 54.4% | alla pari con Fable 5.1, nessun numero | Reporter diversi |
| CursorBench 4.0 | 57.8% | non pubblicato | Eseguito da Anthropic |
| DeepSWE v1.1 | non pubblicato | alla pari con Astra, +6.4pp rispetto a GPT-6 Sol | Eseguito da OpenAI, effort massimo |
| AutomationBench (47 strumenti) | 40.0% | +2.2pp rispetto a Opus a livello medio, ~1/3 del costo | Eseguito indipendentemente, senza fallback, secondo il resoconto di Anthropic sul test Zapier |
| OSWorld 2.0 parziale | 81.8% | ~60.5% sul set offline | Sottoinsiemi diversi, test eseguiti dai fornitori |
| GDPval-AA v2.1 | 1,846 Elo | Sol supera Opus-con-fallback su GDP.pdf a meno della metà del costo | Confronto tra fornitori dichiarato da OpenAI |
Opus 5.5 dispone del set pubblicato più completo per il coding agentico; i risultati migliori documentati di Sol riguardano invece i workflow aziendali e l’analisi dei documenti, con un costo per attività inferiore. Anthropic precisa che i suoi punteggi sono stati ottenuti con le protezioni attive in produzione.
Due test di terze parti aiutano a completare il quadro:
- Build di Tetris in un singolo file (DataCamp, OpenCode, stesso prompt, effort alto, un solo tentativo). Entrambi hanno superato la logica difficile dell’inversione della gravità. Sol ha ottenuto 5.0 contro 4.3 per meccaniche, completezza e resa; Opus ha concluso in 3 turni e 2 chiamate agli strumenti contro i 6 turni e 9 chiamate di Sol, ma è costato $0.87 contro $0.26 dopo aver utilizzato 22.5K token di ragionamento, rispetto agli 8.1K di Sol.
- Test delle quote su 128 prompt (Reddit, prompt fissi, quote e tempi registrati). Sol ha consumato più quota dell’abbonamento rispetto a GPT-6 Sol sullo stesso carico di lavoro, mentre Opus ha terminato più rapidamente sul tempo reale.
Un aspetto ricorrente nei report degli utenti è la capacità di contenersi:
"Per me, il vantaggio principale di Opus 5.5 non è nemmeno la velocità pura nel coding, ma il fatto che non sovra-ingegnerizzi le correzioni semplici. I modelli precedenti riscrivevano 4 file quando chiedevi una patch da 3 righe; il 5.5 rispetta l’architettura esistente" — u/food_fatherr, r/ClaudeAI
Un report sull’over-generation estrema racconta però il contrario: uno sviluppatore ha riferito che Sol aveva scritto 30.000 test per una richiesta di precisione al pixel, cancellandone poi soltanto 25 quando gli è stato chiesto di ridurre il lavoro.
La velocità percepita contro quella dichiarata
Le schede tecniche favoriscono Opus nella decodifica: circa 96 contro 53 token/sec su Artificial Analysis tramite SpringPrompt, e 74 contro 29 di throughput mediano su OpenRouter. Secondo SpringPrompt, Sol è leggermente avanti nel tempo al primo token (1.71s contro 6.89s a effort basso). I report citati degli utenti Codex descrivono però uno scenario opposto sui tempi end-to-end, con attività semplici che richiedono diversi minuti e lavori su documenti lunghi.
Le due cose possono essere vere: i token al secondo misurano la decodifica dopo il primo blocco di output; il tempo totale include anche ragionamento, attese in coda e overhead dell’harness.
- La modalità Fast di Opus costa $8/$40 (2x) e offre fino a 2.5x di velocità; la modalità Ultrafast di Sol promette fino a 8x in Codex, a circa 2x le tariffe.
- I report citati su Codex e Work si concentrano sulla latenza, non sulla decodifica API. Un lavoro su un PDF durato 40 minuti ha utilizzato solo il 6% di una finestra di 5 ore in un singolo caso: non è una velocità tipica.
- Se il tuo loop è interattivo (Cursor, Claude Code, Codex CLI), prova tre ticket reali con ciascun modello prima di prendere una decisione.
Le impostazioni che determinano il costo
Le impostazioni predefinite contano più del nome del modello:
- Parti da Opus con Medium o High. I report degli utenti citati suggeriscono che Extra High e Max consumino quota senza offrire grandi vantaggi sulle patch ordinarie.
- I controlli sul ragionamento sono diversi. Il thinking di Opus non può essere disattivato, l’uso forzato degli strumenti viene rifiutato e il contesto modificato sui nuovi account può generare un errore 400 (note API di DataCamp). Sol va da
noneamaxe permette di cambiare effort durante la conversazione senza invalidare la cache (controlli sul ragionamento di DataCamp): una soluzione più adatta ai loop con budget limitato. - Le protezioni possono reindirizzare il lavoro. La maggior parte delle attività di cybersecurity su Opus viene reindirizzata a Opus 4.8 fuori dal Cyber Verification Program; per il lavoro biologico serve il programma Life Sciences (Anthropic). Su questi compiti bisogna quindi aspettarsi sorprese nella qualità e nelle quote a causa dei fallback.
Quale modello scegliere in base al lavoro
| Se devi fare… | Scegli… | Perché |
|---|---|---|
| Migrazione da 200K righe, audit su più repository, esecuzione agentica di 9 ore | Opus 5.5 | Punteggi agentici più alti, meno riscritture indesiderate, prezzo fisso per 1M |
| 10K ticket al giorno sotto 272K ciascuno, RAG con chunk piccoli | GPT-6.1 Sol | Metà del prezzo di listino, buoni risultati in AutomationBench e GDP.pdf in rapporto al costo |
| Retrieval gigantesco in un’unica richiesta oltre 272K | Opus 5.5 o Sol con richieste suddivise | La sovrattassa di Sol riduce il vantaggio a ~8% |
| Domande e risposte su PDF finanziari e legali | Prova prima Sol | Vittoria dichiarata su Opus-con-fallback a meno della metà del costo per attività; verifica sui tuoi documenti |
| Abbonato a un piano da $20, CLI interattiva | Prova entrambi; i report citati favoriscono Opus | Gli utenti riferiscono che Sol consuma più rapidamente del previsto e sembra più lento |
Non esiste un vincitore assoluto. Sol è la scelta dell’efficienza, Opus quella del controllo e dell’autonomia. Una divisione pratica consiste nell’usare Opus per pianificazione e revisione, lasciando a Sol l’esecuzione in massa.
Opus 5.5 vs GPT-6.1 Sol: domande frequenti
Qual è il più economico via API?
Sol alle tariffe di listino ($2/$10 contro $4/$20, $0.10 contro $0.20 per la cache). La differenza scende a ~8% quando ogni richiesta supera 272K token di input.
Qual è il migliore per gli agenti di coding?
Opus 5.5 è avanti nei benchmark pubblicati Terminal-Bench, FrontierCode e CursorBench; Sol risponde con la parità con Astra in DeepSWE e una vittoria in AutomationBench a un terzo del costo.
Qual è il più veloce nell’uso quotidiano?
La decodifica favorisce Opus (circa 74–96 tok/s contro ~29–53); il primo token favorisce leggermente Sol. I report di Codex dell’ottobre 2026 indicano tempi più lenti per Sol.
Quali sono gli ID dei modelli API?
gpt-6.1-sol e gli slug claude-opus-5-5 sulla maggior parte dei gateway.
GPT-6.1 Sol è disponibile nel normale ChatGPT?
Non al lancio del 29 settembre: prima su Work, Codex e API. Se l’accesso è importante, controlla il tuo piano.
Quale livello di effort bisogna usare?
Inizia con Opus 5.5 su Medium o High, non Max; con Sol parti da medium e aumenta il livello solo quando crescono i retry. I token di ragionamento vengono conteggiati nello stesso metro per token su entrambi (note sulla fatturazione di DataCamp).
Il compromesso che nessun prompt può risolvere
Opus 5.5 rispetta il repository, ma fa pagare il ragionamento; Sol sconta i token, però può sommergerti di lavoro da rivedere e farti aspettare più a lungo. Se un errore silenzioso può mandare in produzione un bug, paga per Opus. Se gli errori costano poco e il volume è la priorità, sfrutta il risparmio di Sol restando sotto 272K.
Per approfondire: recensione e prezzi di Claude Opus 5.5, recensione dei prezzi API di GPT-6.1 Sol.