 AIREITER
Un’API da $0.15/ora può costare $0.30 per un’ora di audio, mentre una da $0.36/ora fattura $0.36 per lo stesso file. È un dettaglio di tariffazione che incide sui budget STT più di qualsiasi classifica sull’accuratezza, ma spesso viene nascosto nei confronti.
La migliore API speech-to-text nel 2026 dipende da come vuoi lavorare: trascrivere file registrati oppure gestire un agente vocale in tempo reale. Per l’audio registrato a basso costo, il punto di partenza è AssemblyAI Universal-2 a $0.15/ora. Per gli agenti live, dove la gestione dei turni di parola è fondamentale, conviene iniziare da Deepgram Flux o Nova-3 in streaming. Se ti servono oltre 90 lingue e un supporto ampio alla diarizzazione, prova ElevenLabs Scribe v2 in batch a $0.22/ora. I prezzi riportati di seguito sono le tariffe pay-as-you-go dei modelli di punta, normalizzate per ora di audio e prima degli sconti sui volumi.
Batch e streaming sono prodotti diversi
Considera la trascrizione batch e quella in tempo reale come due acquisti separati. Le API batch fatturano spesso per ora di audio elaborata, con un flusso basato sul caricamento del file e successive verifiche dello stato. Le API streaming, invece, fanno pagare i minuti di sessione, compreso il tempo di inattività mentre il WebSocket resta aperto, e dipendono soprattutto dalla velocità con cui restituiscono i risultati parziali.
Latenza del primo risultato parziale, finalizzazione e rilevamento della fine del turno misurano momenti diversi: quando compaiono le prime parole, quando il testo smette di cambiare e quando il sistema decide che l’interlocutore ha finito. Mettere a confronto i fornitori usando definizioni così diverse può essere fuorviante, come avvertono anche i confronti sullo streaming pubblicati da Dexto e versusref.
La distinzione pratica è questa:
- Archivi di registrazioni, podcast, riunioni e log delle chiamate: ottimizza $/ora, accuratezza della diarizzazione, gestione dei file grandi e tempo necessario per le correzioni.
- Sottotitoli live o agenti telefonici: guarda soprattutto stabilità dei risultati parziali, rilevamento della fine del turno, gestione delle interruzioni e latenza end-to-end, inclusi LLM e TTS.
- Chiamate di contact center su AWS o GCP: acquisti e fatturazione per canale spesso contano più di una differenza di $0.05/ora nel prezzo di listino.
"Provate queste API su registrazioni reali dei clienti. Stanze rumorose. Accenti indiani. Code-switching hindi-inglese... Prima accuratezza, latenza e affidabilità. Il prezzo viene dopo." — @Aditya_Chawla20
Quel confronto metteva a paragone AssemblyAI a $0.21/ora, ElevenLabs Scribe v2 a $0.22/ora e Deepgram Nova-3 intorno a $0.26/ora, concludendo che la differenza di 5 centesimi conta meno della capacità del modello di reggere l’audio reale.
Quanto costa un’ora di audio
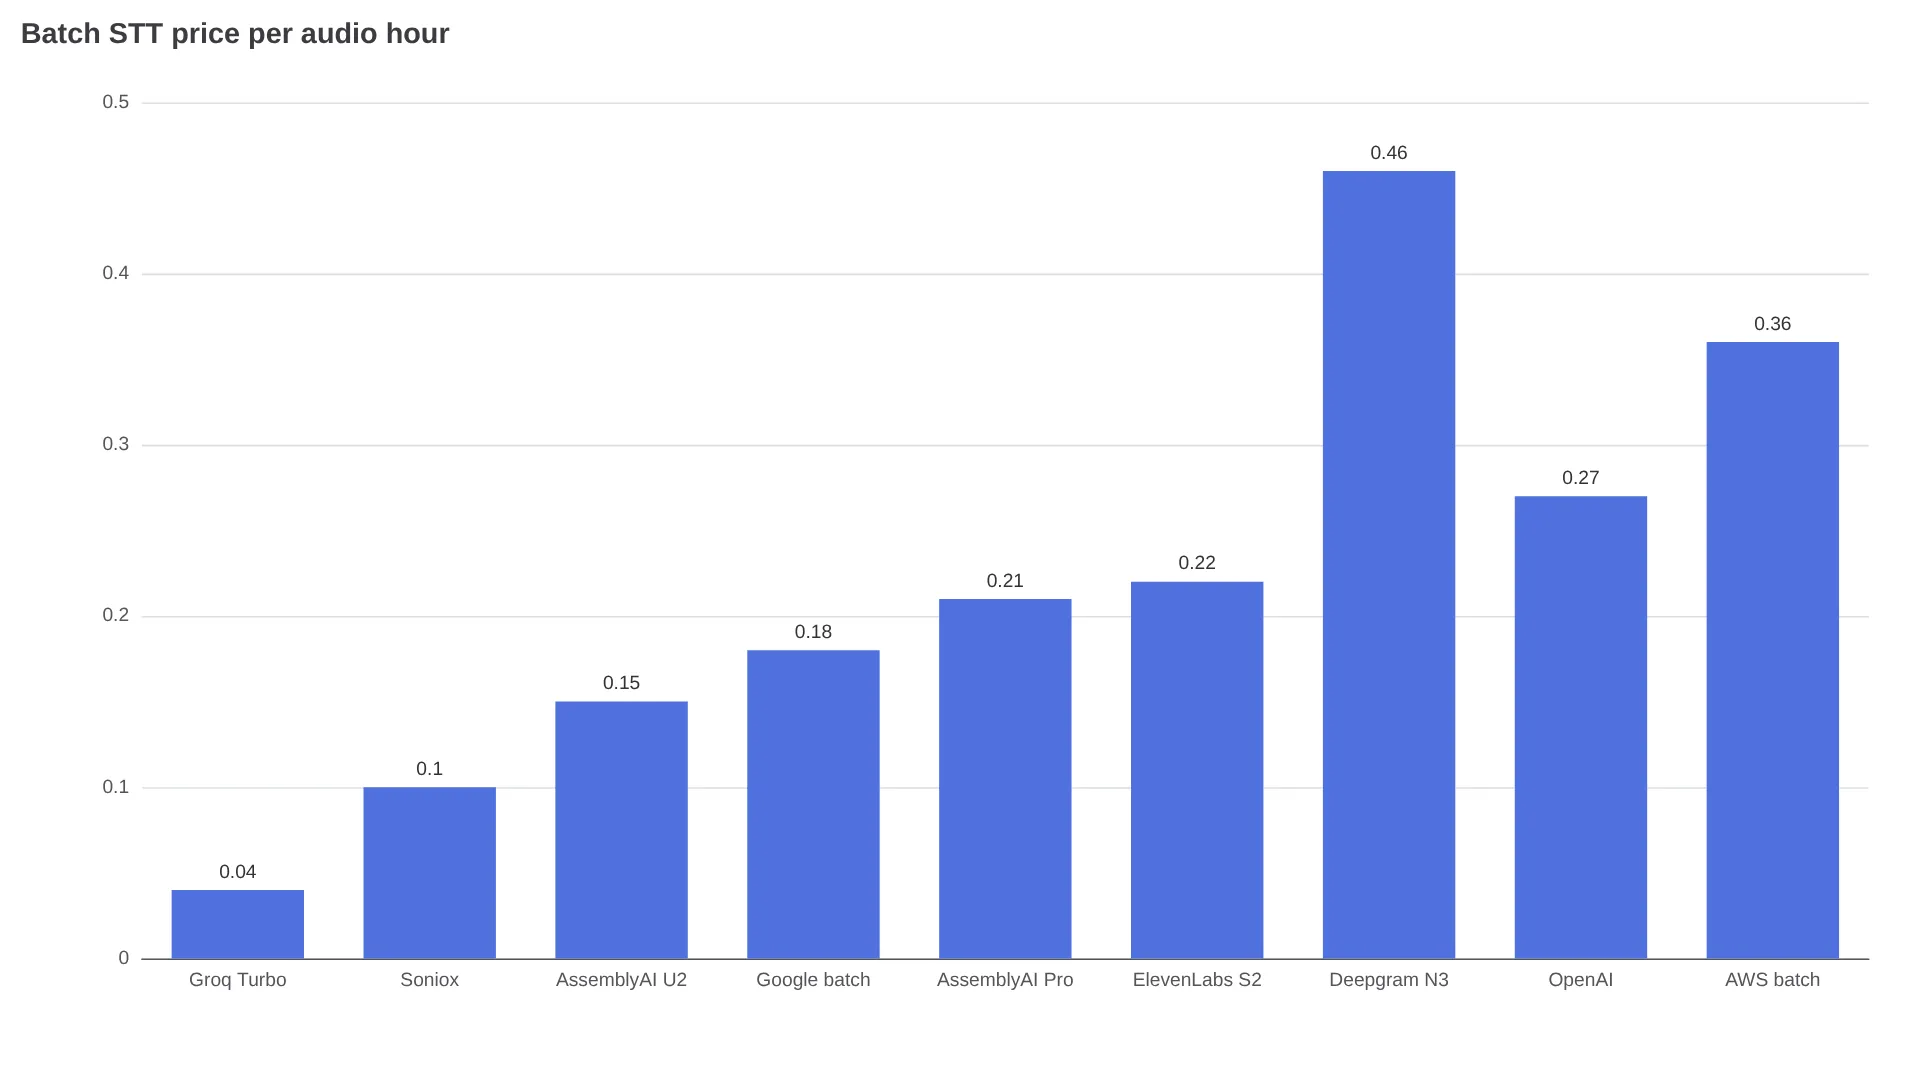
| Provider | Batch | Streaming / realtime | Lingue | Offerta gratuita iniziale |
|---|---|---|---|---|
| Groq Whisper | Large v3 Turbo $0.04/ora | Nessun endpoint streaming | Set multilingue di Whisper | Piano gratuito con limiti |
| Soniox | ~$0.10/ora asincrono | ~$0.12/ora realtime | Oltre 60 in un solo modello | Nessuna indicata |
| AssemblyAI | Universal-2 $0.15/ora; Universal-3.5 Pro $0.21/ora | Universal-Streaming $0.15/ora; Pro Realtime $0.45/ora | 99 su U2; 18 su 3.5 Pro | Credito di $50, senza carta |
| Google Cloud | Dynamic Batch $0.18/ora; Standard $0.96/ora | Standard $0.96/ora per i primi 500k minuti | 125+ impostazioni locali dichiarate | Credito Cloud di $300 |
| ElevenLabs Scribe | Scribe v2 $0.22/ora | Scribe v2 Realtime $0.39/ora | 90+ | ~4,5 ore con il piano gratuito |
| Deepgram | Nova-3 $0.26–$0.46/ora in base al livello (promo contro prezzo normale, monolingue) | Nova-3 in promo ~$0.29/ora; Flux English $0.39/ora ($0.0065/min) | 45+ | Credito di $200 |
| OpenAI | gpt-transcribe $0.27/ora ($0.0045/min) | gpt-live-transcribe $1.02/ora ($0.017/min) | Indicata per modello, Whisper 98 | Nessuna indicata |
| AWS Transcribe | $0.36/ora ($0.006/min) | $0.60/ora ($0.01/min) | Ampia, varia in base alla funzione | 60 min/mese per 12 mesi |
| Speechmatics | Melia 1 $0.24/ora base | Linden 1 $0.30/ora; Enhanced $0.80/ora | 55+ | Credito di $100 |
| Gladia | Solaria-3 €0.16/ora | €0.68/ora | 100+ su Solaria-1; 6 su Solaria-3 | Credito di €50, valido 1 anno |
La forbice di Deepgram riflette la differenza tra il prezzo promozionale e quello normale per l’audio preregistrato monolingue; prima di preparare il budget, verifica il livello attivo sulla pagina dei prezzi di Deepgram.
La trappola dei canali multipli
Un’ora di audio stereo non equivale sempre a un’ora fatturabile. AssemblyAI e Google conteggiano ogni canale separatamente: una chiamata di 60 minuti su due canali con Universal-2 costa quindi $0.15 x 2 = $0.30. La stessa chiamata con Google Standard costa $0.96 x 2 = $1.92. AWS Transcribe include fino a due canali nel calcolo della durata, quindi quella chiamata stereo resta intorno a $0.36 in batch nell’esempio ad alto volume per US East citato da CometAPI. Prima di confrontare due valori in $/ora, controlla sempre come vengono conteggiati i canali.
Gli extra possono ribaltare la classifica
La trascrizione di base è solo il punto di partenza. Secondo il dettaglio voce per voce di CometAPI, Deepgram Nova-3 monolingue preregistrato a $0.0077/min passa a $0.0097/min con la diarizzazione e a $0.0117/min con diarizzazione più redazione; il keyterm prompting aggiunge altri $0.0013/min. AssemblyAI addebita $0.02/ora per la diarizzazione delle registrazioni, ma $0.12/ora per quella in streaming. ElevenLabs aggiunge $0.08/ora per i keyterm realtime e $0.07/ora per il rilevamento delle entità.
Costo totale per trascrizione accettata = elaborazione API + funzioni a pagamento + retry + archiviazione/trasferimento + tempo di revisione umana. Nell’esempio di CometAPI, calcolato su un costo del revisore di $30/ora, una pipeline da $0.15/ora che richiedeva 8 minuti di correzioni arrivava a $4.15, mentre una da $0.60/ora con 3 minuti di correzioni si fermava a $2.10.
Se stai creando un agente vocale, prova prima la gestione dei turni
Gli agenti vocali falliscono soprattutto sulle interruzioni e sulle pause, non sul WER di un audio pulito. Metti a confronto meccanismo di gestione dei turni, controlli del contesto, prezzo realtime e principale limitazione.
| Provider | Gestione dei turni | Prezzo realtime | Limitazione |
|---|---|---|---|
| Deepgram Flux | Eventi EndOfTurn, soglia regolabile; modalità eager + TurnResumed; secondo la documentazione Deepgram citata da Dexto, eager può aumentare del 50–70% le chiamate all’LLM | Flux English $0.0065/min; Nova-3 streaming in promo ~$0.0048/min | Flux multilingue in 10 lingue; le promozioni scadono |
| AssemblyAI | Prompt + keyterm + 1.750 caratteri della risposta precedente dell’agente; rilevamento della fine basato sulla punteggiatura | Universal-Streaming $0.15/ora; Pro Realtime $0.45/ora | Il piano streaming economico è focalizzato sull’inglese; il tempo di inattività del socket viene fatturato |
| ElevenLabs Scribe | Latenza del modello dichiarata di ~150 ms; oltre 90 lingue; diarizzazione batch fino a 32 interlocutori | Scribe v2 Realtime $0.39/ora + $0.08/ora per i keyterm realtime | La diarizzazione realtime non è indicata; il dato del fornitore esclude rete e stack dell’agente |
| OpenAI | Deltas della trascrizione via WebSocket; nessun VAD lato server; il client conferma il turno; niente etichette degli interlocutori o timestamp delle parole in realtime | gpt-live-transcribe $0.017/min | Serve il rilevamento della fine lato client; è il prezzo realtime per ora più alto qui |
Misura anche la latenza delle chiamate agli strumenti e dell’LLM. Un costruttore di agenti per hotel ha riferito su X di 5–7 secondi di silenzio dopo una chiamata a uno strumento, nonostante uno STT rapido: @albertolco88. Questo ritardo end-to-end non compare mai nelle tabelle dedicate solo allo STT.
Per le registrazioni, valuta separatamente testo e diarizzazione
Un benchmark condiviso su r/speechtech ha analizzato una vera riunione in svedese di 2 ore e 22 minuti con sei interlocutori, usando come riferimento le annotazioni di pyannote. L’autore ha trovato Deepgram più rapido e più solido nella diarizzazione, ElevenLabs migliore nel testo della trascrizione svedese ma privo di due dei sei interlocutori, e AssemblyAI vicino per accuratezza ma molto più lento in quella pipeline. La conclusione non è stata scegliere un vincitore unico, bensì combinare più fornitori.
"Deepgram è il più forte dei tre e anche molto rapido." — u/DoctorNootNoot su r/speechrecognition
Tre verifiche specifiche per le registrazioni distinguono le API realmente utilizzabili da quelle frustranti:
- Code-switching nella stessa frase. Nella discussione sulle riunioni multilingue, alcuni sviluppatori riportano transizioni deformate quando gli interlocutori mescolano finlandese e inglese oppure spagnolo e inglese a metà frase. Universal-3.5 Pro indica il code-switching tra 18 lingue; Gladia e Speechmatics presentano il rilevamento multilingue come uno dei propri punti di forza. Nessun fornitore gestisce bene ogni coppia europea senza configurazioni aggiuntive: prova quindi le combinazioni che usi davvero.
- Diarizzazione su larga scala. Chiedi quanti interlocutori sono supportati (ElevenLabs indica 32 in batch, Azure ne indica 35, mentre Speechmatics realtime non dichiara un limite), se la diarizzazione realtime è disponibile e quanto aggiunge a prezzo e latenza. Lo stesso autore del benchmark svedese ha giudicato troppo lento il tempo di risposta di AssemblyAI per la propria pipeline di produzione, nonostante un’accuratezza del testo simile.
- File grandi. OpenAI limita a 25 MB i caricamenti audio, complicando la gestione delle registrazioni lunghe. Le API progettate per il batch accettano invece job basati su URL, file di più ore e polling asincrono persistente. Un utente della discussione sulla trascrizione batch ha riferito di non riuscire a "caricare file grandi" e di non capire l’elaborazione tramite URL: un ostacolo all’adozione che nessuna tabella WER riesce a mostrare.
Whisper large-v3 eseguito in proprio resta l’opzione offline. Nel test di Echosaw sullo stesso audio, condotto su 22,7 minuti di inglese letto e parlato in riunione, le API cloud hanno ottenuto un WER inferiore al 2,1% nei capitoli puliti, mentre una configurazione Whisper con due vCPU ha raggiunto il 10–17% con segmenti persi, oltre al 32,7% sull’audio della riunione a 0,5x della velocità reale. In produzione, il self-hosting usa normalmente una GPU con VAD e suddivisione in chunk per ottenere un throughput pratico.
Cloud, specialista o self-hosting
- Servizio nativo del cloud. Google Dynamic Batch a $0.18/ora è adatto a grandi archivi non urgenti già ospitati su GCP; Standard a $0.96/ora penalizza l’uso realtime. AWS Transcribe si integra bene con flussi S3/IAM e include due canali. Azure Speech fattura il batch intorno a $0.18/ora e il realtime intorno a $1.00/ora, con un piano gratuito realtime di 5 ore al mese. Considera separatamente costi di archiviazione, trasferimento e redazione.
- Batch gestito economico. Groq Whisper Turbo a $0.04/ora è più economico di tutte le API gestite per semplici trascrizioni batch, ma non offre streaming né una diarizzazione dichiarata. Soniox, intorno a $0.10/ora in asincrono, è il prezzo batch più basso della tabella tra quelli che includono oltre 60 lingue, diarizzazione e timestamp, anche se dispone di meno benchmark indipendenti.
- Pipeline ibrida. Usa ElevenLabs per il testo della trascrizione quando offre i risultati migliori, Deepgram per la diarizzazione se è il più efficace e Whisper o Groq per il batch a basso costo. Questa divisione aggiunge complessità di orchestrazione, ma quando nessun fornitore è al primo posto sia per il testo sia per le etichette degli interlocutori sul tuo audio, due chiamate economiche possono costare meno di un’unica lunga revisione manuale.
Nota sulla migrazione: OpenAI indica come deprecati whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe e gpt-4o-transcribe-diarize, con spegnimento previsto per il 26 febbraio 2027. I team che usano ancora questi modelli dovrebbero provare per tempo le alternative, soprattutto nei casi in cui cambiano il comportamento di timestamp delle parole e diarizzazione.
Organizza un test di 7 giorni sui tuoi audio
I valori WER dichiarati dai fornitori usano dataset, normalizzatori e versioni dei modelli diversi, quindi non sono confrontabili direttamente. Raccogli 30–50 turni di parola reali di chiamate o segmenti di riunioni con i tuoi accenti, rumori e vocaboli; trascrivi manualmente una volta il riferimento, poi invia lo stesso audio in streaming o in upload a due o tre fornitori, lasciando invariato il resto della pipeline.
Registra secondi di audio, numero di canali, funzioni attivate, versione del modello, latenza dei risultati parziali, ritardo di finalizzazione, latenza end-to-end dell’agente, tasso di errore della diarizzazione e minuti di correzione per ogni trascrizione accettata. Valuta separatamente i termini importanti per il business — nomi, email, importi e prodotti — rispetto al WER generico. Il percorso con il costo più basso per ora, ma che raddoppia la revisione umana, di solito perde quando si calcola il costo totale.
FAQ
Qual è l’API speech-to-text più economica nel 2026?
Soniox, intorno a $0.10/ora, e AssemblyAI Universal-2 a $0.15/ora sono i prezzi batch gestiti più bassi della tabella tra quelli che includono il supporto alla diarizzazione. Groq Whisper Turbo a $0.04/ora è ancora più economico per il batch puro, ma senza streaming o diarizzazione.
Quale API offre la latenza streaming più bassa?
Secondo la raccolta delle dichiarazioni dei fornitori di Dexto: ElevenLabs indica una latenza del modello di ~150 ms, Deepgram ~260 ms per la fine del turno e Speechmatics una finalizzazione media inferiore a 350 ms. Verifica comunque risultati parziali, finalizzazione e latenza end-to-end sulle tue chiamate.
Qual è la migliore API STT per gli agenti vocali?
Deepgram Flux per la gestione nativa dei turni, AssemblyAI per i prompt di contesto, ElevenLabs Realtime per un’ampia copertura linguistica all’interno di uno stack vocale ElevenLabs e trascrizione live di OpenAI per gli stack basati su OpenAI che possono implementare il rilevamento della fine lato client.
Quale gestisce meglio audio multilingue e con code-switching?
ElevenLabs (90+), AssemblyAI U2 (99; 3.5 Pro 18 con code-switching), Gladia Solaria-1 (100+) e Speechmatics (55+). Prova la coppia linguistica esatta che ti serve: il cambio di lingua a metà frase continua a deformare le transizioni.
Conviene usare un solo fornitore o combinare trascrizione e diarizzazione?
Se un provider è il migliore nel testo ma peggiore nelle etichette degli interlocutori sul tuo audio, come nel report svedese con sei persone citato sopra, combinare più fornitori può dare risultati migliori di qualsiasi singolo servizio. Metti a budget orchestrazione e doppia fatturazione, confrontandole con il tempo di correzione risparmiato.
OpenAI Whisper verrà dismesso?
OpenAI ha indicato come deprecati i vecchi modelli di trascrizione, tra cui whisper-1 e le varianti gpt-4o-transcribe, con spegnimento previsto per il 26 febbraio 2027. I percorsi attuali sono gpt-transcribe per i file e gpt-live-transcribe per l’audio live.
| Scenario | Da provare | Perché |
|---|---|---|
| Grande archivio di registrazioni | AssemblyAI U2 / Google Dynamic Batch / Groq Whisper | $ per ora più basso; Groq è il più economico quando la diarizzazione non serve |
| Agente vocale live | Deepgram Flux / AssemblyAI Realtime / ElevenLabs Realtime | Gestione dei turni, prompt di contesto e bassa latenza del modello |
| Riunioni multilingue | ElevenLabs Scribe v2 / Speechmatics / Gladia | Posizionamento su 90+/55+/100+ lingue e gestione del code-switching |
| AWS o GCP nativo | Transcribe / Cloud STT | IAM, archiviazione e acquisti contano più del prezzo di listino |
| Uso offline o residenza dei dati | Whisper self-hosted | L’audio non lascia il tuo hardware |
Approfondimenti correlati: Migliore API text-to-speech, Migliore API per il voice cloning nel 2026, Guida all’API Gemini 3.5 Transcribe.