 AIREITER
Scegli GLM-5.3-Flash per i flussi di lavoro visivi nativi; preferisci DeepSeek V4 Flash per testo e codice con molto caching. Alla fine contano più il workload e il percorso di fatturazione che un singolo benchmark.
Prima di tutto, chiariamo gli ID dei modelli
Il confronto riguarda GLM-5.3-Flash (glm-5.3-flash) e il modello API di produzione di DeepSeek deepseek-v4-flash, indicato nella pagina ufficiale dei prezzi come DeepSeek-V4-Flash-0731. DeepSeek V4 Pro e l’endpoint sperimentale separato deepseek-v4-flash-vision-exp non sono alternative al modello Flash principale preso in esame. Per l’identità Ox Alpha, i limiti hardware e le cautele legate all’anteprima, consulta la recensione di GLM-5.3-Flash su AIReiter.
La scelta rapida in base al workload
| Se la priorità è… | Scegli | Perché |
|---|---|---|
| Da screenshot a codice, analisi dell’interfaccia, video o file | GLM-5.3-Flash | Gestisce nativamente immagini, video e file nello stesso modello |
| Elaborazione massiva solo testuale con molti cache hit | DeepSeek V4 Flash | Prezzo ufficiale più basso per gli input in cache, soprattutto fuori dalle fasce di punta |
| Traffico con input freschi e molte risposte durante la promozione di GLM | GLM-5.3-Flash | Le tariffe promozionali per input e output sono inferiori alle tariffe ufficiali di DeepSeek per cache miss e output |
| Coding intensivo da terminale e scelta produttiva prudente | DeepSeek V4 Flash | Disponibilità in beta pubblica con versione identificata e risultati ufficiali sui test Flash |
| Agenti visivi per browser o computer use | GLM-5.3-Flash | Il feedback visivo resta all’interno del ciclo di coding o utilizzo degli strumenti |
| Un contesto testuale da 1 milione di token | Nessuno dei due per impostazione predefinita | Entrambi dichiarano un contesto nell’ordine di 1M; verifica il retrieval alla dimensione reale dei prompt |
| Un solo modello per testo, codice e immagini | GLM-5.3-Flash | Evita di dover usare un endpoint di visione separato per il percorso multimodale principale |
Cosa dicono davvero le specifiche ufficiali
La documentazione dei modelli Z.AI e la pagina dei prezzi Z.AI descrivono il modello GLM e il relativo sistema di fatturazione. La documentazione Models & Pricing di DeepSeek e il relativo changelog riportano invece la versione Flash e le funzionalità corrispondenti.
| Specifiche | GLM-5.3-Flash | DeepSeek V4 Flash |
|---|---|---|
| ID del modello API | glm-5.3-flash | deepseek-v4-flash |
| Versione pubblicata | GLM-5.3-Flash | DeepSeek-V4-Flash-0731 |
| Finestra di contesto | 1M token | 1M token |
| Output massimo indicato dalla documentazione ufficiale | 128K token | 384K token |
| Tipi di input principali | Testo, immagini, video e file | Testo e codice; la visione è affidata a un modello sperimentale separato |
| Output | Testo | Testo |
| Controllo del ragionamento | Thinking attivo; supporto a reasoning_effort | Modalità thinking e non-thinking; livelli di impegno low, high e max |
| Strumenti e output strutturato | Function calling, streaming, caching del contesto e output JSON | Tool call, output JSON, Responses API e compatibilità con Anthropic API |
| Pesi | Pesi open pubblicati dal provider | Pesi open pubblicati dal provider |
I 320B di parametri totali e i 18B di parametri attivi di GLM descrivono un’architettura a esperti sparsi, non un checkpoint locale da 18B; la pagina ufficiale dei prezzi di DeepSeek non pubblica un numero di parametri comparabile per la versione Flash.
GLM accetta input visivi direttamente nel percorso del modello principale; DeepSeek offre invece deepseek-v4-flash-vision-exp come modello separato, con conseguenze diverse su routing e test.
Coding e agenti: due prove molto diverse
Gli agenti da terminale mettono alla prova il lavoro su repository e strumenti; quelli visivi devono anche interpretare interfacce renderizzate e stati della GUI.
Terminale e repository
La tabella di lancio di Z.ai e l’aggiornamento ufficiale del 31 luglio di DeepSeek riportano questi risultati:
| Benchmark | GLM-5.3-Flash | DeepSeek V4 Flash | Stato delle prove |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 82.7 | Valutazioni separate riferite dai provider |
| DeepSWE | 63.4 | 54.4 | Valutazioni separate riferite dai provider |
| Toolathlon Verified | 78.4 | 70.3 | Valutazioni separate riferite dai provider |
| AutomationBench | 48.8 | 25.1 | Valutazioni separate riferite dai provider |
| Agents’ Last Exam | 26.3 | 25.2 | Valutazioni separate riferite dai provider |
Nei benchmark riportati dai provider GLM è davanti, ma gli harness non sono identici: questi numeri servono per selezionare i modelli da provare, non per prendere la decisione finale.
Le prove indipendenti rendono il quadro meno netto. Nel test del 27 agosto di Composio, basato su 30 task agentici composti da più passaggi, GLM-5.3-Flash ha completato 21/30 task e DeepSeek V4 Flash 20/30. DeepSeek è stato il più veloce in 19 task su 30, mentre il costo dichiarato per task completato con successo è stato di circa $0.028 per DeepSeek contro circa $0.06 per GLM. I dati provengono dal test di Composio, non dai due provider.
Per gli agenti che lavorano soprattutto da terminale, partirei da DeepSeek V4 Flash quando velocità, riproducibilità e un percorso iniziale facilmente difendibile sono i vincoli principali. GLM merita comunque un posto nel confronto se la qualità della prima riparazione o una gestione più ampia degli strumenti giustificano il test a fronte di un costo maggiore.
Strumenti, browser e feedback visivo
GLM è più adatto quando l’agente deve controllare ciò che ha prodotto il proprio codice. Z.ai descrive un ciclo in cui il modello legge screenshot o interfacce renderizzate, modifica l’implementazione e verifica nuovamente il risultato. È un approccio utile per passare da screenshot a codice, fare debugging frontend, usare il browser, lavorare con documenti e affrontare alcuni flussi 3D.
DeepSeek gestisce il lavoro agentico basato su testo e codice attraverso deepseek-v4-flash; per gli input visivi serve il percorso separato deepseek-v4-flash-vision-exp. Se la pipeline esistente dispone già di un routing per la visione, questa separazione può essere accettabile. Se invece l’agente deve passare dal codice sorgente a uno screenshot del browser e poi a un video senza cambiare endpoint, GLM è la soluzione più lineare. La guida all’API DeepSeek V4 Flash Vision Exp del sito tratta l’alternativa separata.
Cosa raccontano gli utenti dopo i benchmark
Le testimonianze della community indicano un compromesso, non un vincitore assoluto. Un report basato su due giorni di utilizzo descrive GLM come efficace con contesti più piccoli ma meno stabile quando il prompt cresce, riconoscendogli però il supporto alle immagini:
“Quando cresce, comincia a comportarsi in modo ansioso e pasticciato.” — @XBToshi, dopo due giorni di utilizzo intensivo di GLM-5.3-Flash in un confronto pubblicato
È una testimonianza aneddotica, non un tasso di errore. Però mette in luce un possibile problema che le tabelle dei benchmark non mostrano: una finestra di contesto ampia non garantisce automaticamente un comportamento stabile in conversazioni agentiche con molti turni.
Anche un piccolo esperimento con Ollama ha favorito DeepSeek in base alle unità di quota specifiche del provider, ma l’autore non ha equiparato quelle unità al costo in dollari dell’API.
Le prove su latenza e serving possono cambiare la scelta
Per questi modelli esatti non è stato pubblicato un confronto di latenza p50 o throughput eseguito con lo stesso harness; non trasferire quindi risultati ottenuti con i percorsi Pro, Vision-Exp o altri endpoint. Composio ha rilevato che DeepSeek è stato il più veloce in 19 task agentici su 30: è un segnale utile, ma non equivale a una misurazione del throughput. Per gli assistenti interattivi misura il tempo necessario per arrivare alla prima tool call utile; per i batch considera il tempo totale fino a un risultato accettato.
Il prezzo per token non coincide con il costo per task completato
I listini ufficiali restituiscono un quadro più sfumato del semplice “DeepSeek costa meno”. Z.AI indica una promozione del 50% su GLM-5.3-Flash fino al 9 settembre 2026 alle 24:00 UTC+8. DeepSeek distingue invece tra cache hit e cache miss, applicando tariffe diverse nelle fasce di punta e fuori punta.
Tutti i valori riportati qui sotto sono espressi in dollari statunitensi per 1 milione di token.
| Voce di fatturazione | Promozione GLM-5.3-Flash | Listino GLM-5.3-Flash | DeepSeek V4 Flash fuori punta | DeepSeek V4 Flash in punta |
|---|---|---|---|---|
| Input fresco/cache miss | $0.075 | $0.15 | $0.22 | $0.44 |
| Input in cache | $0.015 | $0.03 | $0.007 | $0.014 |
| Output | $0.25 | $0.50 | $0.66 | $1.32 |
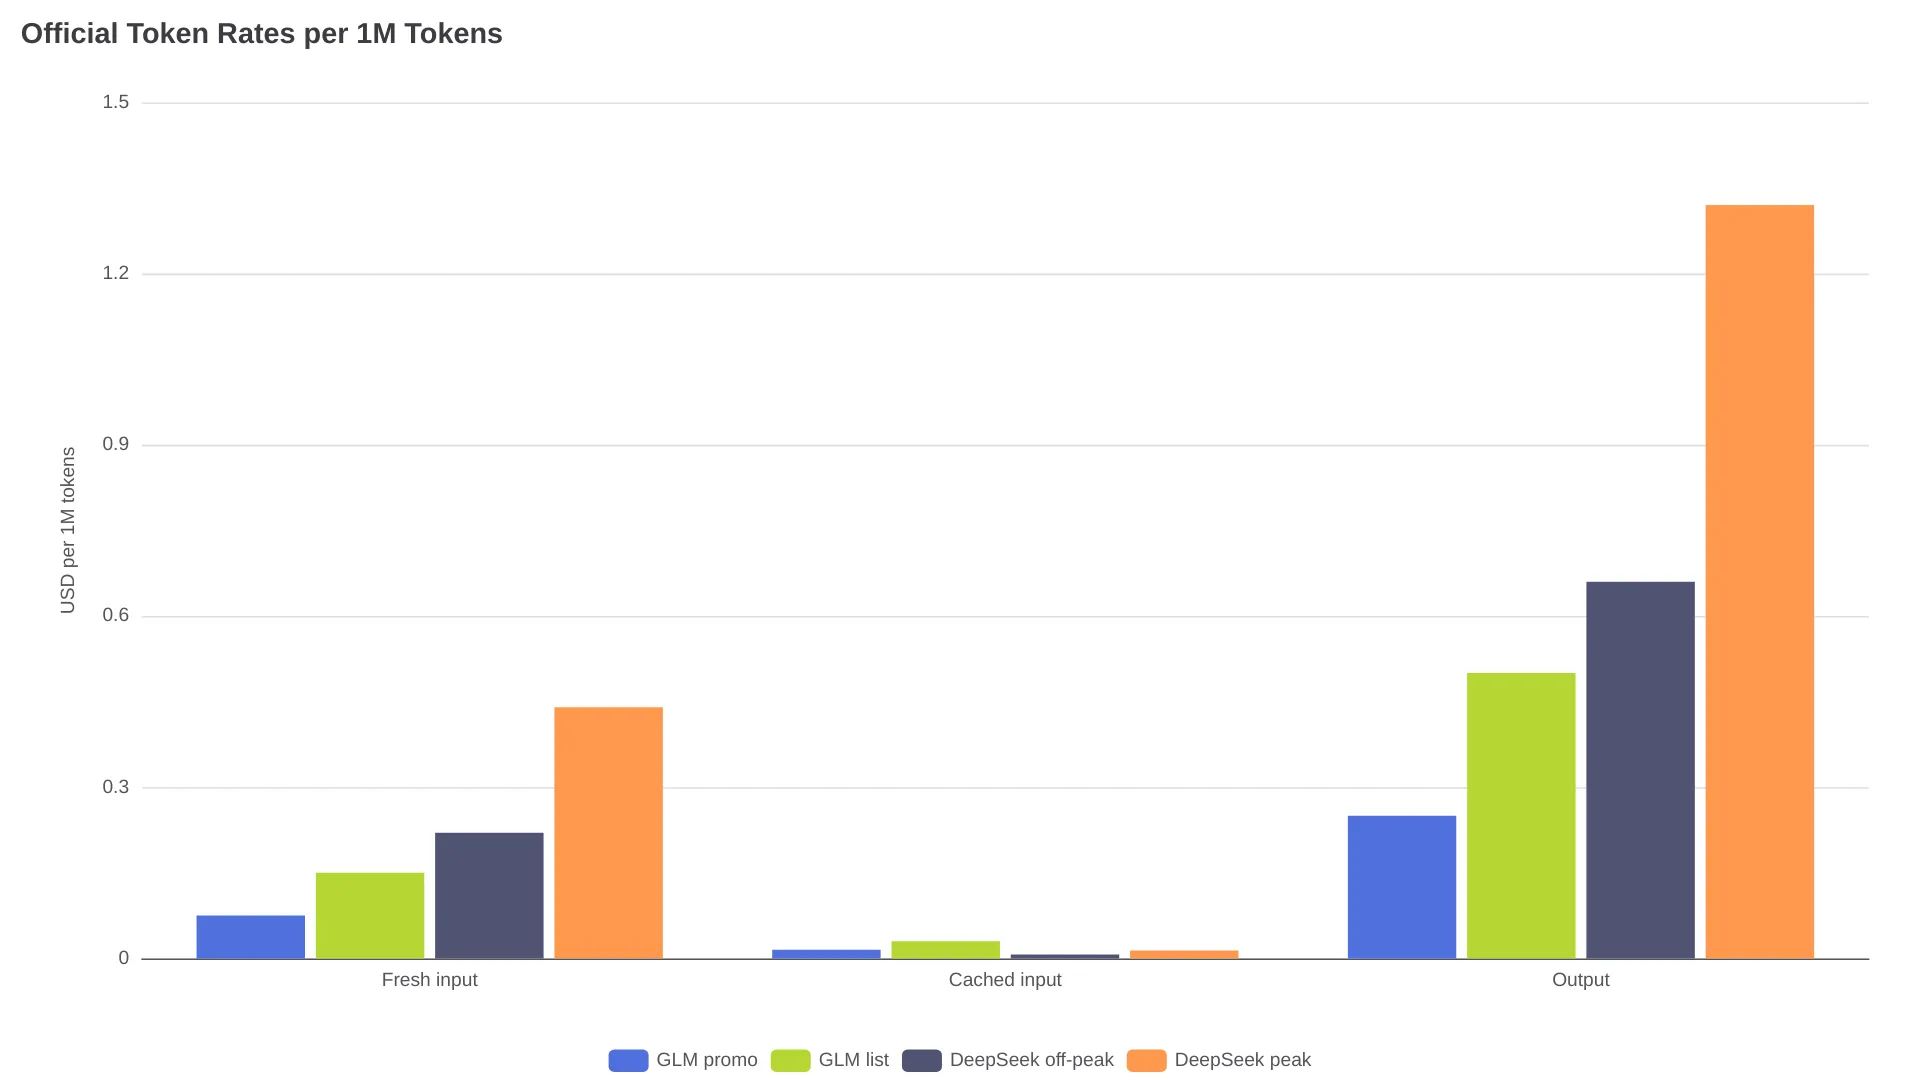
Le fasce di punta di DeepSeek sono 01:00–04:00 UTC e 06:00–10:00 UTC, dal lunedì al venerdì; tutti gli altri orari sono fuori punta. La tabella ufficiale indica inoltre una concorrenza di 2.500 per V4 Flash. La pagina dei prezzi di GLM segnala uno storage degli input in cache gratuito per un periodo limitato, ma non riporta in quella sede un numero di concorrenza universale.
- DeepSeek vince sul prezzo degli input in cache in ogni fascia corrispondente.
- La promozione di GLM vince su input freschi e output rispetto alle tariffe ufficiali di DeepSeek per cache miss e output.
- Terminata la promozione, le tariffe di listino di GLM per input freschi e output restano inferiori alle tariffe fuori punta indicate da DeepSeek.
- Il caso più favorevole a DeepSeek è rappresentato da traffico ricco di cache, dominato dagli input e con output brevi, soprattutto se pianificato fuori dalle fasce di punta.
Un esempio con 10M di input e 2M di output
Supponiamo di avere 10 milioni di token di input fresco e 2 milioni di token di output, senza costi per gli strumenti né retry:
| Modello e percorso di fatturazione | Calcolo | Totale |
|---|---|---|
| Promozione GLM | 10 × $0.075 + 2 × $0.25 | $1.25 |
| Listino GLM | 10 × $0.15 + 2 × $0.50 | $2.50 |
| DeepSeek fuori punta, cache miss | 10 × $0.22 + 2 × $0.66 | $3.52 |
| DeepSeek in punta, cache miss | 10 × $0.44 + 2 × $1.32 | $7.04 |
Se tutti i 10 milioni di token di input sono cache hit, il totale di DeepSeek fuori punta scende a $1.39 (10 × $0.007 + 2 × $0.66), mentre il totale promozionale di GLM diventa $0.65 (10 × $0.015 + 2 × $0.25). Il vantaggio del caching di DeepSeek diventa più rilevante quando il rapporto tra input e output è molto alto e l’output è breve.
Quando il conto più basso di DeepSeek fa davvero la differenza
Scegli DeepSeek V4 Flash quando la maggior parte delle richieste riutilizza un prefisso lungo e stabile, come quello del sistema o di un repository, produce risposte brevi e può essere eseguita fuori dalle ore di punta. Classificazione, estrazione, sintesi e automazione testuale ordinaria rientrano meglio in questo schema rispetto agli agenti guidati dagli screenshot.
Quando le capacità extra di GLM possono ridurre il costo totale
GLM può ridurre il costo della pipeline quando un’immagine, un documento o un video richiederebbero altrimenti una richiesta separata a un modello di visione. Anche la tariffa promozionale sull’output è importante per gli agenti che generano patch di codice lunghe. Verifica però l’ipotesi usando token fatturati, cicli di riparazione e percentuale di task accettati, senza dare per scontato un vantaggio universale sul costo per task.
Il contesto lungo indica la capacità, non garantisce la qualità
Entrambe le documentazioni ufficiali indicano una finestra di contesto da 1M token, quindi sul solo contesto la situazione è pari. DeepSeek indica un output massimo di 384K; la documentazione dei modelli Z.AI indica invece un output massimo di 128K per GLM-5.3-Flash. La differenza conta solo per le applicazioni che consentono generazioni insolitamente lunghe.
Z.ai dichiara una computazione dell’attenzione 3.01× inferiore e una dimensione della KV cache 4.44× inferiore rispetto a GLM-5.3, precisando però che la KV cache di GLM resta leggermente superiore a quella di DeepSeek V4 Flash. Queste dichiarazioni del provider non dimostrano un vantaggio in termini di latenza o qualità del retrieval rispetto a DeepSeek.
Verifica retrieval, completamento dei tool e percentuale di task accettati a 50K, 200K e alla dimensione massima effettiva dei tuoi prompt, applicando il criterio di accettazione descritto nel gate qui sotto.
Scegline uno come default oppure usa entrambi
| Workload | Primo modello da provare | Fallback o escalation |
|---|---|---|
| Classificazione ed estrazione solo testuale | DeepSeek V4 Flash | GLM se formattazione o qualità non sono sufficienti |
| Chat su repository con molto caching | DeepSeek V4 Flash | GLM per i passaggi di riparazione più difficili |
| Agente di coding da terminale | DeepSeek V4 Flash | GLM quando conta il completamento al primo tentativo |
| Da screenshot a codice | GLM-5.3-Flash | DeepSeek per i passaggi successivi solo testuali |
| Agente per browser o computer use | GLM-5.3-Flash | DeepSeek per le fasi di pianificazione non visiva |
| Analisi basata su video, immagini o file | GLM-5.3-Flash | DeepSeek Vision Exp se un percorso separato è accettabile |
| Testo lungo con output breve | DeepSeek V4 Flash | GLM se il retrieval peggiora |
| Generazione di codice lunga durante la promozione | GLM-5.3-Flash | DeepSeek quando l’economia dei cache hit è determinante |
Prima di spostare un workload in produzione, esegui un piccolo gate con lo stesso harness:
- Blocca gli ID esatti:
glm-5.3-flashedeepseek-v4-flash; impedisci al router di sostituire silenziosamente Pro o Vision-Exp. - Usa 20–50 task reali, includendo sia i lavori riusciti sia i problemi riscontrati di recente. Se il prodotto è agentico, inserisci almeno cinque task con utilizzo di strumenti.
- Registra tasso di successo, cicli di riparazione, tool call omesse, tempo alla prima azione utile, token totali di input/output e rapporto dei cache hit.
- Confronta il costo per task accettato, poi mantieni l’altro modello come fallback finché timeout e tassi di errore non risultano stabili.
La guida rapida di Z.AI e la guida di DeepSeek alla prima chiamata API documentano l’accesso compatibile con OpenAI; i controlli sul ragionamento, i percorsi visivi e le modalità di fatturazione non sono però identici.
Le domande che gli acquirenti fanno ancora
GLM-5.3-Flash è lo stesso modello di Ox Alpha?
Z.ai ha identificato ufficialmente GLM-5.3-Flash come il modello che aveva testato in forma anonima con il nome Ox Alpha. Routing, quote e comportamento degli endpoint in anteprima non devono essere considerati specifiche permanenti del modello pubblico.
Usa la tabella di routing, poi verifica il modello predefinito con ID bloccati, casi di errore reali e lo stesso harness. La recensione di GLM-5.3-Flash analizza identità e prove di distribuzione; la guida all’API DeepSeek V4 Flash Vision Exp tratta invece il percorso visivo separato.